

Python数据分析需要学到什么程度?Pandas与可视化库的掌握边界
深入解析Python数据分析的学习要求与技能边界,厘清Pandas与Matplotlib、Seaborn可视化库的核心必修范围与按需查阅领域,帮助学习者建立高效、实用的数据分析知识体系。
一、认识数据分析的学习深度:区分核心技能与按需查阅
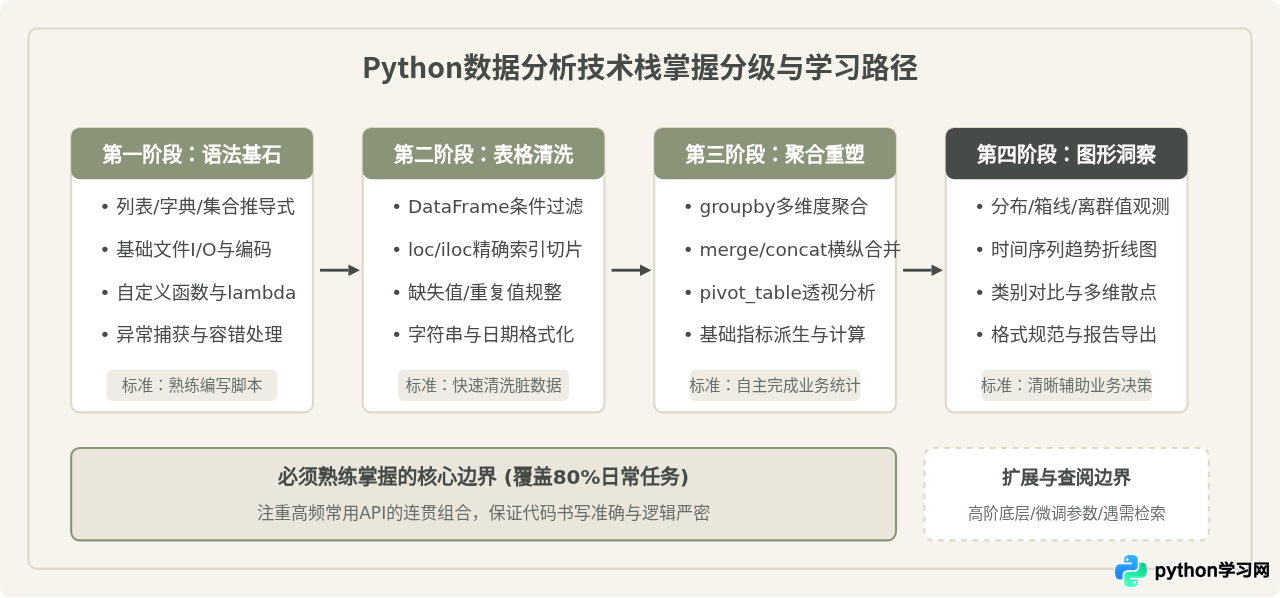
很多初学者在入门Python数据分析时容易陷入“工具死磕”的误区:试图背下Pandas官方文档中的所有参数,或者花费大量时间钻研复杂的层级多重索引(MultiIndex)运算与高度定制的交互式动画图表。这种学习方式不仅成本极高,而且在实际工作中极少用到。
数据分析的核心价值在于理解业务逻辑、发现数据异常、提出并验证分析假设。Python及其生态库本质上是实现这一目的的计算工具。一个成熟的数据分析人员,头脑中建立的是一个清晰的“分层技能树”:哪些操作必须形成肌肉记忆,哪些模块只需要知道其存在、在特定场景下查阅文档即可。
二、Pandas的掌握边界:聚焦高频操作,舍弃死记硬背
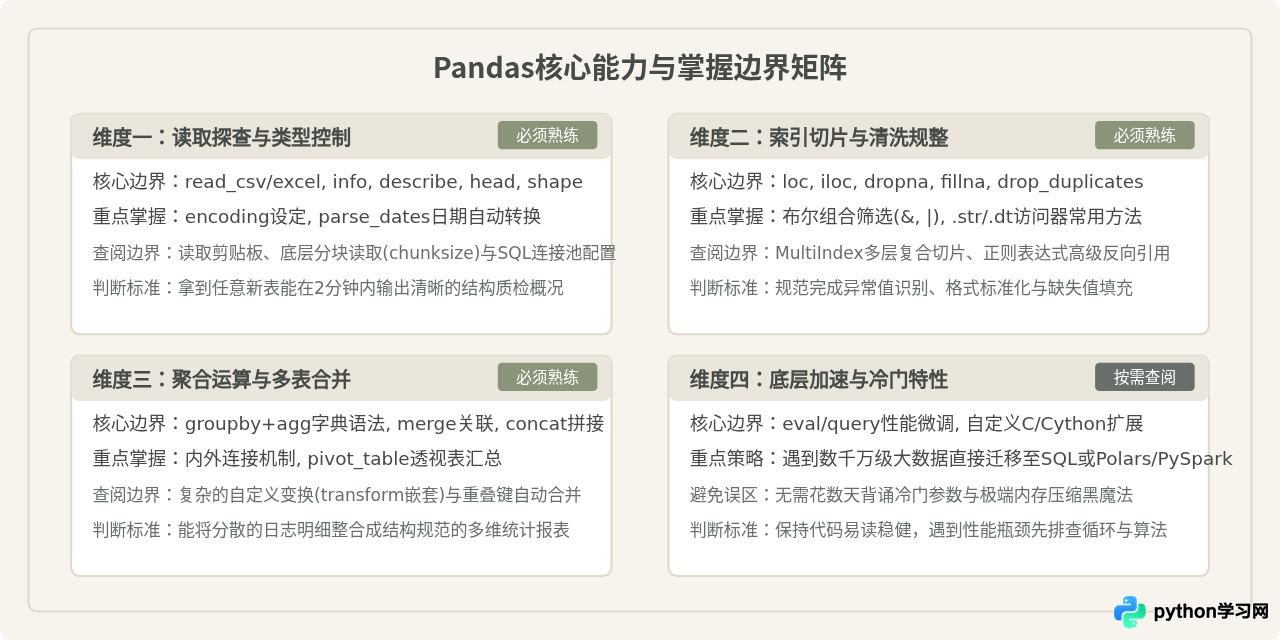
Pandas拥有极其庞大的API体系,同一数据操作往往有三到四种不同实现路径。初学者最容易产生的焦虑是:记不住各种边缘函数的参数。实际上,在绝大多数企业分析场景中,只要掌握以下四大知识板块即可应付自如:
1. 数据读取与探查感知
读取文件时,重点掌握 pd.read_csv() 和 pd.read_excel() 的核心参数:encoding(处理中文乱码常见如 utf-8 或 gbk)、parse_dates(解析日期字段)以及 dtype(指定列类型避免精度截断)。拿到数据集后,利用 df.info() 查看数据类型与非空计数,通过 df.describe() 查看数值列分布特征,利用 df.shape 与 df.head() 快速确认表格规模与样貌。
2. 精准定位与清洗过滤
放弃使用混淆不清的链式中括号索引,统一使用 loc(基于标签与布尔条件)和 iloc(基于整数位置)。多条件筛选时牢记括号优先级与位逻辑运算符(&、|、~)。清洗阶段聚焦四个动作:缺失值处理(isna()、fillna()、dropna())、重复值清理(drop_duplicates())、类型强转(astype())以及针对字符串和日期的向量化访问器(.str.replace()、.str.contains()、.dt.date 等)。
3. 数据重塑与聚合汇总
groupby() 配合 agg() 是数据汇总的核心。应当熟练使用字典语法为不同列分配聚合规则(如对金额求和、对用户数去重计数)。表关联方面,掌握 pd.merge() 的四种连接方式(inner, left, right, outer)以及明确指定连接键(on 或 left_on/right_on)。最后,使用 pivot_table() 制作类似Excel透视表的多维交叉表。
下面这段代码涵盖了数据读取、类型解析、异常值过滤与分组汇总的典型操作。掌握这种结构化流式写法,即可覆盖日常大部分处理需求:
import pandas as pd

# 1. 结构化读取与数据类型规范
df = pd.read_csv(
    "order_data.csv",
    encoding="utf-8",
    parse_dates=["order_time"]
)

# 2. 字段清洗与条件筛选 (必须使用规范的布尔索引)
valid_mask = (df["order_amount"] > 0) & (df["status"] != "cancelled")
clean_df = df.loc[valid_mask].copy()

# 3. 缺失值填充与类型安全转换
clean_df["discount_rate"] = clean_df["discount_rate"].fillna(0.0)
clean_df["user_id"] = clean_df["user_id"].astype(str)

# 4. 派生衍生特征 (利用向量化访问器提取月份)
clean_df["order_month"] = clean_df["order_time"].dt.to_period("M")

# 5. 分组聚合计算核心指标
monthly_report = clean_df.groupby("order_month").agg(
    total_sales=("order_amount", "sum"),
    active_users=("user_id", "nunique"),
    avg_order_value=("order_amount", "mean")
).reset_index()

# 示例输出:展示汇总报表前几行
print(monthly_report.head())
三、可视化库的掌握边界:聚焦业务表达,不做无谓调参
在Python数据可视化领域,Matplotlib和Seaborn是最常使用的两个工具。很多初学者常在这两个库中花费大量时间:反复调试像素级的边框距离、微调复杂坐标轴弧度、或者试图用代码绘制复杂的三维动态大屏。这同样违背了数据分析的实用原则。
1. Matplotlib:掌握“面向对象”结构,放弃全局指令流
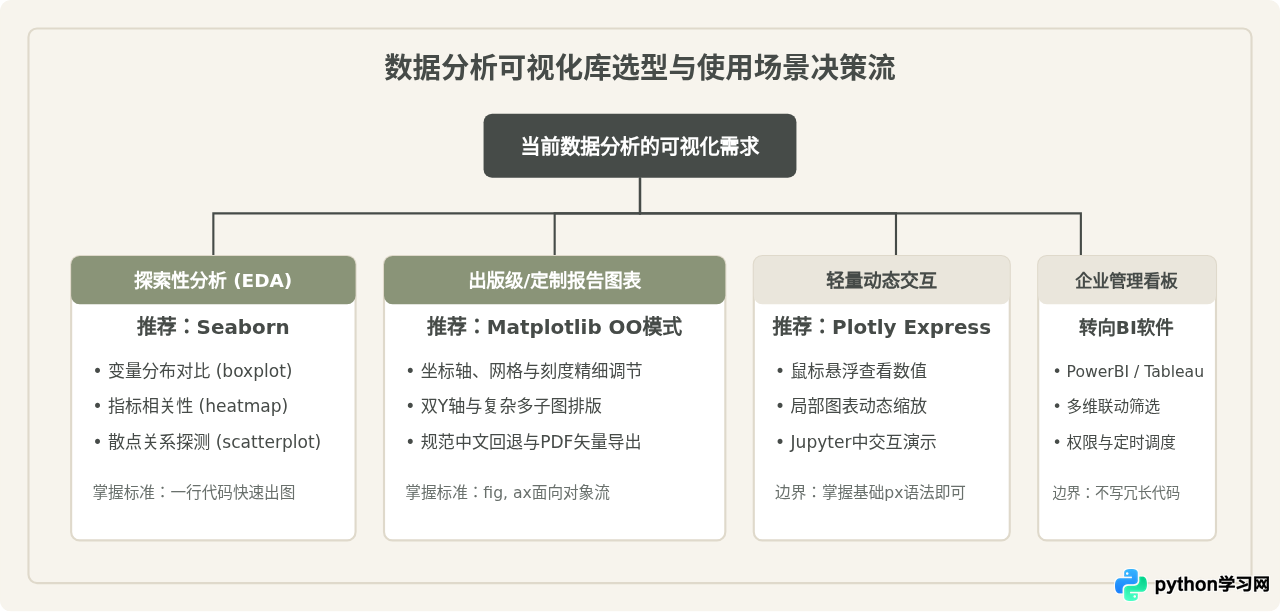
Matplotlib的掌握边界非常明确:只需掌握其面向对象接口(Object-Oriented API),即通过 fig, ax = plt.subplots() 显式创建画布(Figure)与子图(Axes)。掌握如何在 ax 对象上添加标题(set_title)、设置坐标轴标签(set_xlabel/set_ylabel)、调整刻度(set_xticks)以及控制网格线(grid)。不要浪费时间去记忆过时的 plt.xxx 混杂模式,那会导致多子图绘制时逻辑混乱。
2. Seaborn:探索性数据分析(EDA)的高效主力
Seaborn建立在Matplotlib之上,专门针对统计分析设计。在实际工作中,它承担了90%的探索性分析任务。掌握Seaborn的核心边界在于熟悉五种高频图表的使用场景:
- 直方图与核密度估计(histplot / kdeplot):用于观察单一数值变量的分布形态与偏度。
- 箱线图与小提琴图(boxplot / violinplot):用于对比不同类别下的指标分布差异及离群值。
- 散点图与气泡图(scatterplot):用于探索两个连续变量间的相关关系。
- 折线图(lineplot):带有自动置信区间计算,用于展示时间序列变化趋势。
- 热力图(heatmap):配合相关系数矩阵(
df.corr()),快速定位特征间的线性关系。
3. 可视化库与商业BI工具的分界点
什么时候该用Python可视化?什么时候该切换工具?这是一个关键的边界问题:
在探索性分析阶段,利用Seaborn几行代码快速出图验证假设,效率远高于其他工具;但在需要制作公司级管理看板、多部门交互筛选仪表板、或需要高频刷新汇报时,应当果断切换到PowerBI、Tableau或开源的Metabase等专业BI软件。不要尝试用纯Python编写上千行的复杂交互脚本来替代成熟的BI看板。
实际项目中推荐的标准范式是:用Matplotlib初始化Figure与Axes,随后将Axes对象传递给Seaborn进行绘制,最后通过Axes调整细节:
import matplotlib.pyplot as plt
import seaborn as sns

# 1. 设置系统字体与基础风格,防止中文乱码与负号显示异常
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False
sns.set_theme(style="whitegrid", font='PingFang SC')

# 2. 面向对象创建画布与子图
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 5))

# 3. 在子图1绘制类别分布箱线图 (Seaborn处理统计计算)
sns.boxplot(data=clean_df, x="category", y="order_amount", ax=ax1, palette="pastel")
ax1.set_title("各品类订单金额分布对比", fontsize=13, fontweight='bold')
ax1.set_xlabel("商品品类")
ax1.set_ylabel("订单金额 (元)")

# 4. 在子图2绘制趋势折线图
sns.lineplot(data=monthly_report, x="order_month", y="total_sales", marker="o", ax=ax2, color="#8A9478")
ax2.set_title("月度销售总额趋势", fontsize=13, fontweight='bold')
ax2.set_xlabel("月份")
ax2.set_ylabel("总销售额")
ax2.tick_params(axis='x', rotation=45)

# 5. 调整布局并导出
plt.tight_layout()
plt.savefig("business_report.png", dpi=300)
# plt.show() # 在分析交互环境中按需展示
四、容易混淆的认知与学习误区辨析
| 常见观点 | 为何看似合理 | 实际边界与修正认知 |
|---|---|---|
| “学数据分析必须精通SQL和Pandas的所有函数” | 两者都是处理表格数据的工具,功能重合度高。 | 分工明确:在数据库中完成前置过滤、关联与粗聚合(利用SQL的集群计算能力);在Pandas中进行复杂数据类型清洗、非结构化解析与统计检验。不要在Pandas中重复执行低效的全表过滤。 |
| “性能优化必须掌握向量化Cython与Numba” | 分析大文件时Python容易内存溢出或运行缓慢。 | 80/20法则:分析场景的性能瓶颈通常是滥用 for 循环或不恰当的 apply。改用内置向量化函数、规范数据类型(如将高基数字符串转为 category)即可解决大部分问题。更大规模数据应直接采用SQL或专有大数据引擎。 |
| “可视化图表越炫酷、动效越多越专业” | 复杂图表视觉冲击力强,展示效果华丽。 | 为决策服务:业务汇报最注重“一目了然”。滥用三维图、密集雷达图或卡顿的动画反而增加阅读者的认知负荷。清晰的柱状图、折线图与箱线图往往是传递信息最高效的形式。 |
五、数据分析工作闭环与学习总结
明确技术边界之后,学习Python数据分析就会变得目标明确且轻松很多。整个学习过程应当紧紧扣住“业务问题到数据结论”的闭环链路,而不是在工具库的细节中迷失方向:
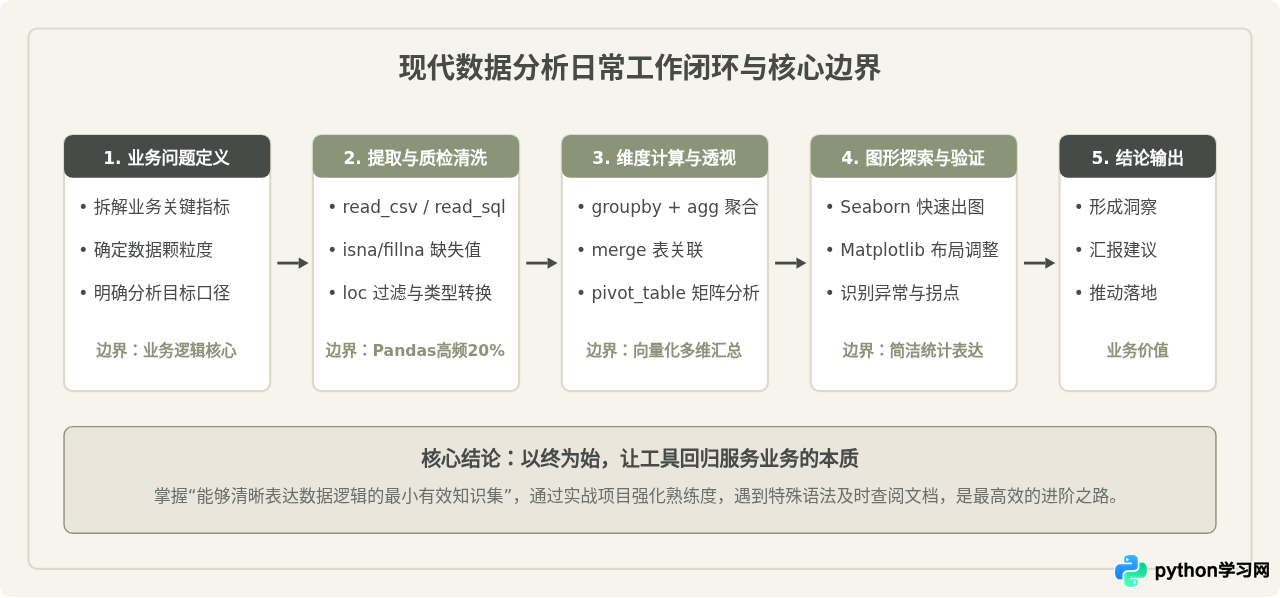
总而言之,判断Python数据分析是否“学到位”的标准,从来不是能否背诵整本API手册,而是面对一份未经处理的原始业务数据时,能否有条不紊地运用Pandas完成清洗和汇总,并借助Seaborn与Matplotlib清晰、准确地展示规律。守住这一边界,将更多精力投入到统计思维与业务敏锐度的培养上,才是成为优秀数据分析者的关键路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









