

Python 100例中的经典算法题解析:排序、查找与递归实现
深入解析Python 100例中最具代表性的三类基础算法:排序(冒泡与插入)、查找(顺序与二分)及递归(阶乘与斐波那契)。提供清晰的代码推导、边界处理技巧与完整的算法流程图解。
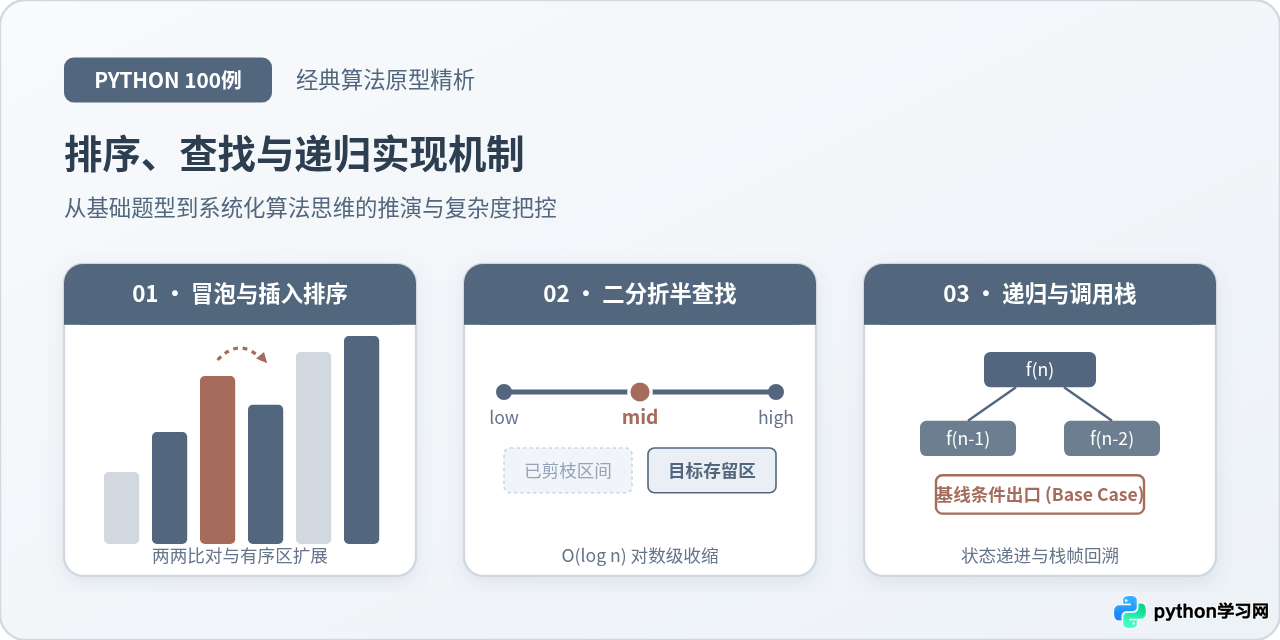
一、排序算法:从无序比对到有序区逐步构建
在“Python 100 例”中,诸如“三个数从小到大输出”(实例 5)、“对 10 个数进行排序”(实例 37)以及“向有序数组中插入一个数”(实例 39),构成了最基础的数据排列题型。很多初学者习惯直接使用 Python 内置的 sorted() 或 list.sort(),但在没有现成库函数或需要手写底层逻辑的场景下,理解相邻置换与有序区插入是掌握更高级算法(如快速排序、归并排序)的基石。
1. 冒泡排序(Bubble Sort)的实现与内层优化
冒泡排序的核心逻辑极为朴素:每一轮遍历列表,连续比较相邻的两个元素;若前一个元素大于后一个元素,则交换两者的位置。如此一来,经过一轮扫描,当前未排序区域中的最大数值便会像气泡浮上水面一样,被稳稳推移至末尾。
在最简写法中,内外两层循环是机械运行的。但如果列表已经基本有序,普通的冒泡排序依然会盲目执行完所有比较,白白消耗 $O(n^2)$ 的时间。在实际编码中,我们应当引入一个布尔标记 swapped:只要在某次内层遍历中没有发生任何元素交换,说明序列已整体处于有序状态,可以直接提前终止循环。
def bubble_sort(nums: list) -> list:
    """
    优化版冒泡排序
    时间复杂度:最好 O(n),最坏 O(n^2),平均 O(n^2)
    空间复杂度:O(1) 原地排序
    """
    arr = nums.copy()
    n = len(arr)

    for i in range(n - 1):
        swapped = False
        # 每一轮最后 i 个元素已处于确定位置,无需重复比对
        for j in range(0, n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True

        # 若本轮未发生任何交换,表明数据已经有序,提前退出
        if not swapped:
            break

    return arr

# 示例验证
sample_list = [5, 2, 8, 3, 1]
print("冒泡排序结果:", bubble_sort(sample_list))
# 输出示例: 冒泡排序结果: [1, 2, 3, 5, 8]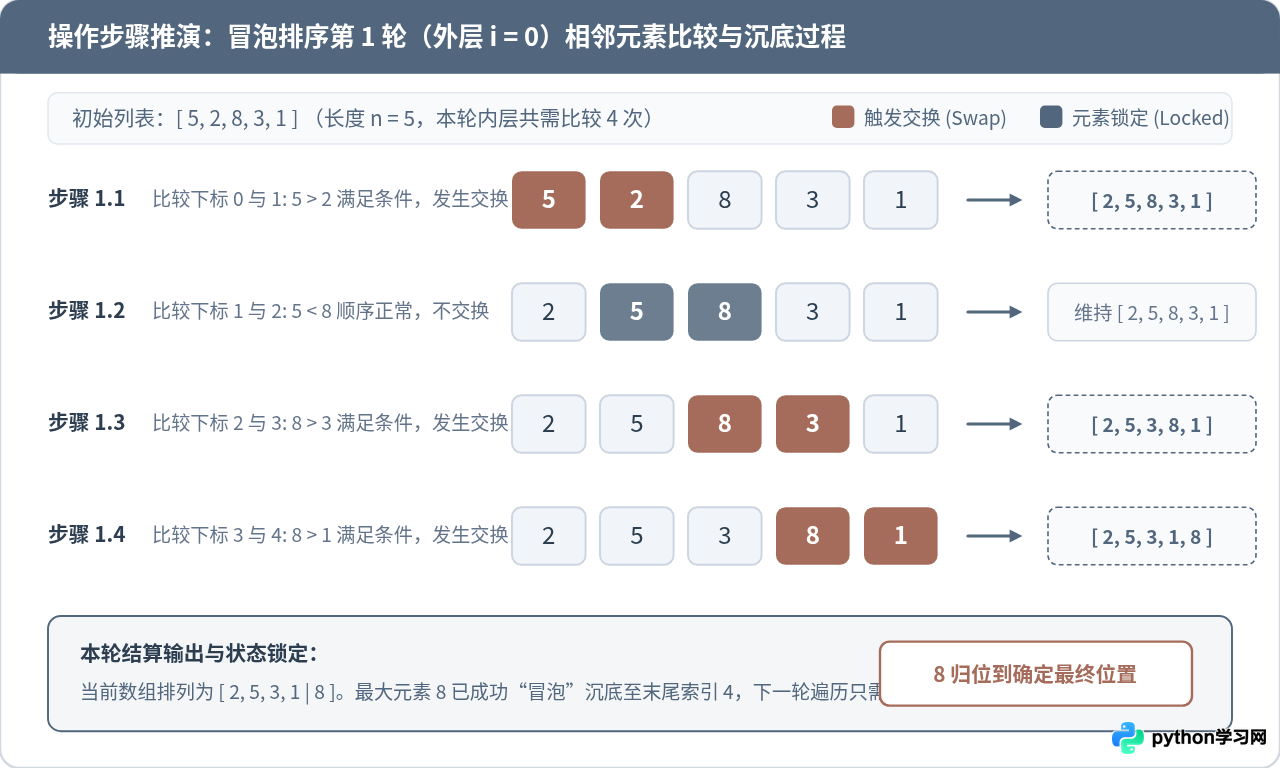
2. 插入排序(Insertion Sort)与“有序列表插入”原理解析
100 例中的实例 39 提出了一个经典问题:“有一个已经排好序的数组,现输入一个数,要求按原来的规律将它插入数组中”。这恰好是直接插入排序(Insertion Sort)的单步执行过程。
插入排序的思想是将列表在逻辑上划分为“已排序前缀”和“未排序后缀”。初始时假定第一个元素是有序的;随后依次取出后面的每个元素,将其从后向前与有序区中的元素对比,只要遇到比当前元素大的项,就将该项向后挪动一位,直到找到合适的空位落入。
def insertion_sort(nums: list) -> list:
    """
    直接插入排序
    时间复杂度:最好 O(n),最坏 O(n^2),平均 O(n^2)
    空间复杂度:O(1)
    """
    arr = nums.copy()
    for i in range(1, len(arr)):
        key = arr[i]
        j = i - 1
        # 将大于 key 的有序区元素逐个后移
        while j >= 0 and arr[j] > key:
            arr[j + 1] = arr[j]
            j -= 1
        # 将 key 放入腾出的空位
        arr[j + 1] = key
return arr二、查找算法:从全盘扫描到二分折半的跨越
在列表查找场景中,最直接的做法是使用 for item in nums: 进行遍历,这被称为顺序查找(Linear Search)。当列表包含 $n$ 个元素时,顺序查找最坏需要对比 $n$ 次,时间复杂度为 $O(n)$。如果待查数据规模扩张到数百万级,顺序遍历将带来不可接受的耗时。
在数据已经具备有序性的前提下,“折半查找”(Binary Search,即二分查找)能够带来对数级的性能跃升。每次通过比对待查目标与中间位置(mid)的数值,可以直接剔除一半的搜索范围。
1. 二分查找的双指针设计与边界细节
初学者在手写二分查找时,最常犯的错误集中在三个地方:
- 循环终止条件:是
while low < high还是while low <= high?如果搜索区间定义为双闭区间[low, high],当区间收缩到仅剩一个元素时(low == high),该元素仍须进行比对,因此必须使用low <= high。 - 中位索引计算:直接使用
(low + high) // 2在部分强类型语言中可能引起大整数溢出,在 Python 虽有高精度整数兜底,但养成low + (high - low) // 2的书写习惯在跨语言迁移时更为安全。 - 边界收缩偏移:当下标
mid的值不匹配时,新的边界不能直接设为mid,必须写成low = mid + 1或high = mid - 1,否则在区间长度为 2 且目标不存在时将陷入死循环。
def binary_search(nums: list, target: int) -> int:
    """
    标准二分查找实现(双闭区间)
    :param nums: 升序排列的整数列表
    :param target: 目标查找数值
    :return: 目标在列表中的索引;若未找到则返回 -1
    """
    low = 0
    high = len(nums) - 1

    while low <= high:
        # 取中间位置,整除规避浮点
        mid = low + (high - low) // 2

        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            # 目标在右半区,舍弃包括 mid 在内的左半区间
            low = mid + 1
        else:
            # 目标在左半区,舍弃包括 mid 在内的右半区间
            high = mid - 1

    return -1

# 示例验证
ordered_data = [12, 23, 34, 45, 56, 67, 78, 89, 90]
search_target = 67
result_index = binary_search(ordered_data, search_target)
print(f"查找数值 {search_target} 的索引位置为: {result_index}")
# 示例输出: 查找数值 67 的索引位置为: 5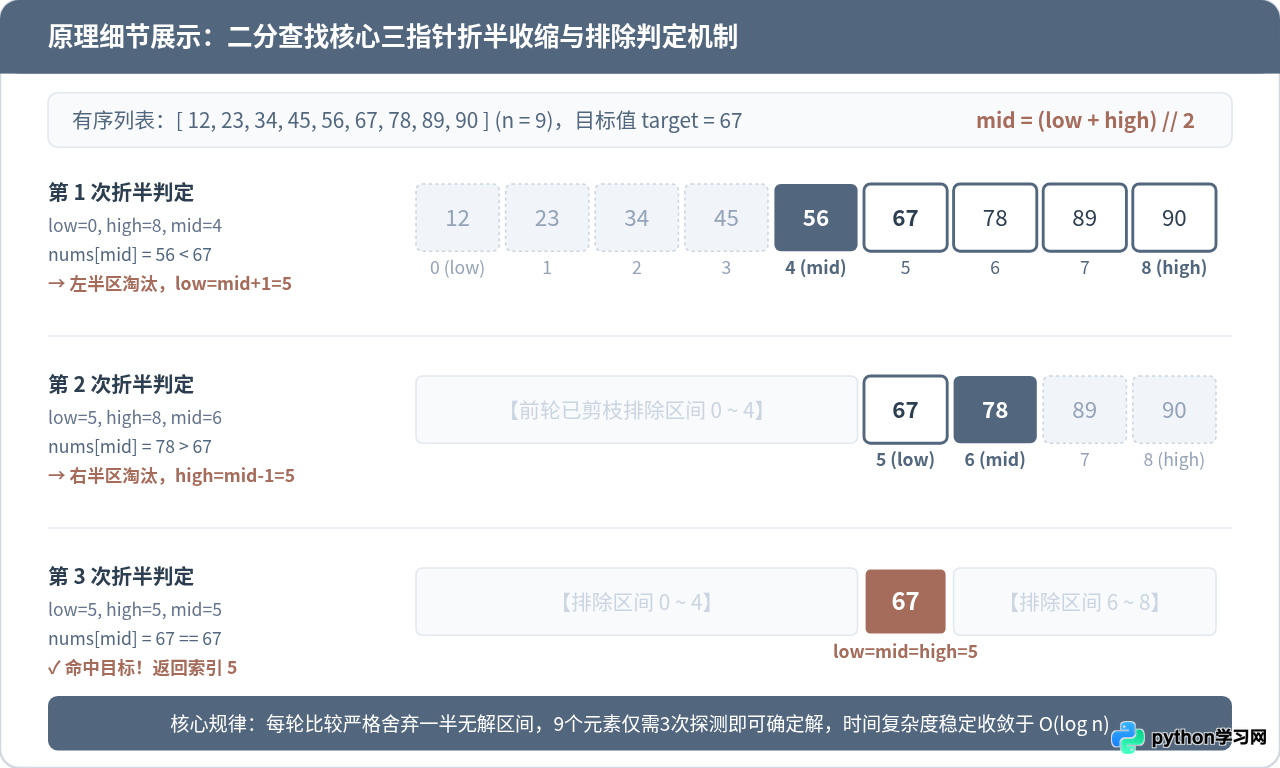
2. 顺序查找与二分查找的工程权衡
二分查找虽然拥有极高的 $O(\log n)$ 效率,但其成立具有严格的前置条件:数据必须存储在支持随机寻址($O(1)$ 下标访问)的连续内存中,且必须事先完成排序。
如果一份数据只被查找一次,为了使用二分查找而先执行一次耗时 $O(n \log n)$ 的快速排序,总体代价反而远高于直接使用 $O(n)$ 的顺序遍历。二分查找真正发挥威力的场景,是“一次排序、多次高频查询”的静态或半静态数据集。
三、递归算法:基线条件、状态递推与调用栈机制
在“Python 100 例”中,递归(Recursion)是出现频率极高的核心题型。例如“利用递归方法求 5!”(实例 26)、“利用递归函数调用方式将所输入的 5 个字符反向打印”(实例 27)、“问第 5 个人岁数”(实例 28)以及经典的“兔子繁衍 / 斐波那契数列”(实例 11)。
许多初学者对递归感到敬畏,主要是因为思维总是试图在脑海中模拟计算机展开所有层级的细节,导致思维过载。理解递归的本质,只需要把握两根支柱:
- 基线条件(Base Case):递归何时停止。必须有无须再递归即可直接返回明确常数结果的最底端边界,否则程序必然走向死循环。
- 递归递推关系(Recursive Step):如何把规模为 $n$ 的大问题,收缩等价为规模为 $n-1$ 或更小规模的同类子问题。
1. 递归求阶乘与系统调用栈(Call Stack)的真实轨迹
以实例 26 求 $n!$ 为例,数学定义本身就是典型的递推公式:$fact(n) = n imes fact(n-1)$,且 $fact(1) = 1$。
在 Python 底层,当一个函数调用自身时,操作系统会在内存的调用栈(Call Stack)中为这次调用分配一个全新的“栈帧”(Stack Frame)。栈帧中保存着当前调用的形参值、局部变量以及函数返回后的执行指令地址。当递归尚未触底前,每深入一层,就会往栈中压入(Push)一个新帧;一旦基线条件被触发,计算结果开始逐层向上返回,相应的栈帧才被依次弹出(Pop)销毁。
def factorial_recursive(n: int) -> int:
    """
    递归求解正整数阶乘 n!
    时间复杂度:O(n)
    空间复杂度:O(n) 栈深度
    """
    # 边界与防御式检查
    if n < 0:
        raise ValueError("阶乘运算仅支持非负整数")

    # 1. 基线条件(Base Case):递归触底终止
    if n <= 1:
        return 1

    # 2. 递归推进(Recursive Step):问题规模缩减
    return n * factorial_recursive(n - 1)

# 示例验证
n_val = 5
print(f"{n_val}! 的计算结果为: {factorial_recursive(n_val)}")
# 示例输出: 5! 的计算结果为: 120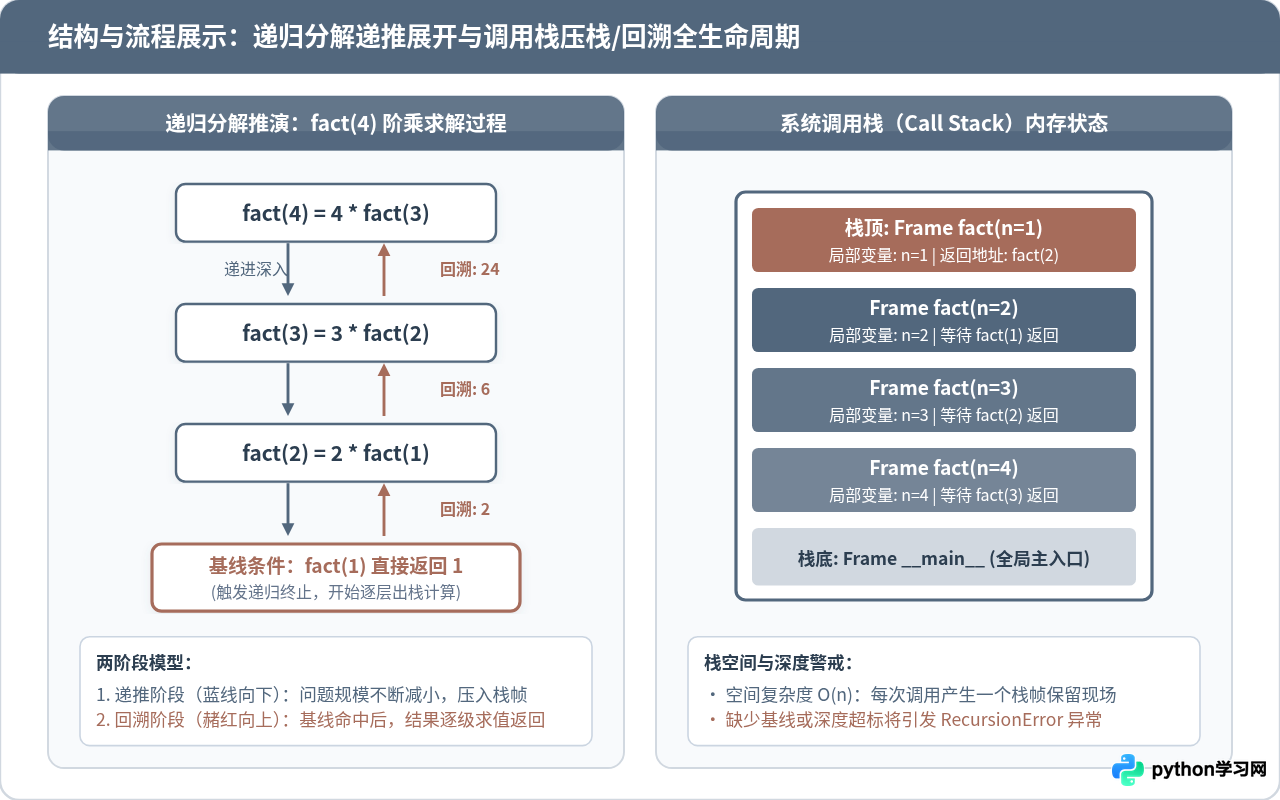
2. 树状递归的性能陷阱与记忆化优化
以 100 例中的斐波那契数列(实例 11)为例,递推式为 $F(n) = F(n-1) + F(n-2)$。如果直接写成双路递归,执行效率会产生灾难性的暴跌:
# 存在严重重复计算的朴素写法(不推荐在 n > 35 时执行)
def fib_naive(n: int) -> int:
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_naive(n - 1) + fib_naive(n - 2)
在上述代码中,计算 fib_naive(5) 会分别计算 fib(4) 和 fib(3);而在计算 fib(4) 时又会再次计算一遍 fib(3)。随着 $n$ 的增大,递归树的分支呈指数级爆炸,时间复杂度高达 $O(2^n)$。
针对这一问题,正确的工程处理方案有两种:一是改为自底向上的迭代循环(时间复杂度 $O(n)$,空间复杂度 $O(1)$);二是使用记忆化缓存(Memoization),利用字典或 Python 3 的 functools.lru_cache 记录已算出的中间结果。
from functools import lru_cache

@lru_cache(maxsize=None)
def fib_optimized(n: int) -> int:
    """
    基于记忆化缓存的斐波那契数列
    时间复杂度从 O(2^n) 骤降为 O(n)
    """
    if n <= 0:
        return 0
    if n == 1:
        return 1
    return fib_optimized(n - 1) + fib_optimized(n - 2)

# 示例验证
print("第 40 个斐波那契数:", fib_optimized(40))
# 示例输出: 第 40 个斐波那契数: 102334155import sys; sys.getrecursionlimit() 查看。当问题规模超过几千层时,必须将递归逻辑重构为显式 while 循环或使用基于堆栈的数据结构进行解耦。
四、三类算法特征对比与综合选用指南
回顾“Python 100 例”中涉及的排序、查找与递归题型,它们不仅是孤立的编程语法练习,更是算法设计思维演进的完整链条:
- 排序是构建数据有序性的手段:通过交换或插入操作,将原本无规则的集合梳理成有序序列,消除数据熵增。
- 查找是有序状态的价值兑现:一旦数据具备顺序,查找复杂度便能从逐一遍历的 $O(n)$ 飞跃至折半剪枝的 $O(\log n)$。
- 递归是化繁为简的分治载体:高阶排序算法(例如快速排序、归并排序)和树形结构检索,其本质都是依靠递归将整体问题分解为更小规模的子区间分别处理。
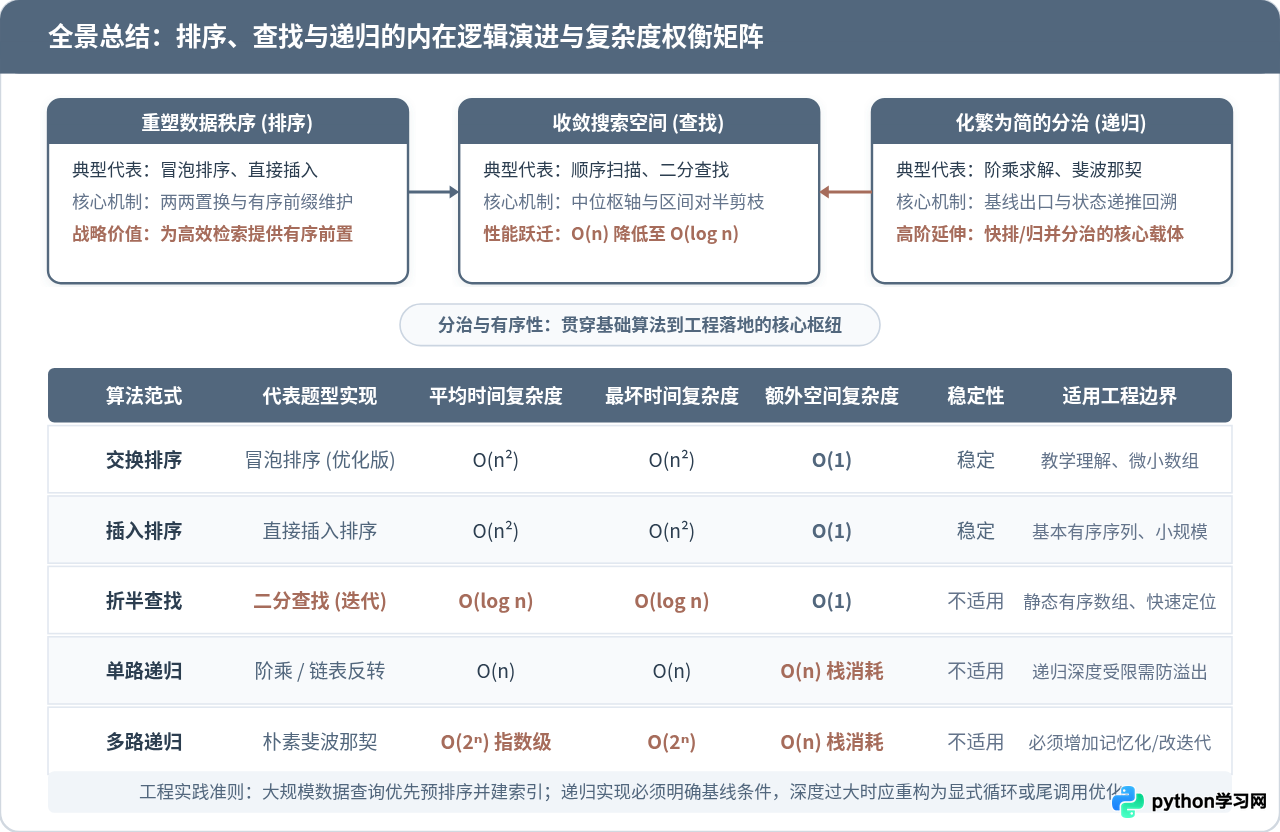
算法综合属性与技术指标对照表
| 算法实现 | 最好时间复杂度 | 最坏时间复杂度 | 空间复杂度 | 稳定性 | 核心适用场景与限制 |
|---|---|---|---|---|---|
| 冒泡排序 | O(n)(引入提前终止标志) | O(n²) | O(1) | 稳定 | 算法教学演示、数据量极小的场景。不适合工业级规模数据。 |
| 直接插入排序 | O(n) | O(n²) | O(1) | 稳定 | 对“基本有序”序列极度高效;常被作为高阶排序的分块末端优化手段。 |
| 二分查找 | O(1) | O(log n) | O(1) | 不适用 | 静态有序数组的高频查询。必须满足顺序存储与下标随机访问前置条件。 |
| 线性递归(阶乘) | O(n) | O(n) | O(n)(栈帧) | 不适用 | 适合数学归纳定义明确的单路下探;需警惕递归深度 1000 限制。 |
| 双路递归(斐波那契) | O(2ⁿ)(朴素版) | O(2ⁿ) | O(n)(栈帧) | 不适用 | 朴素版存在严重冗余分支;工业生产中必须附加记忆化缓存或改用迭代。 |
在解决实际业务问题或面对各类编程算法考察时,编写出能够跑出结果的代码只是第一步。明确理解算法的时间复杂度、额外内存占用、边界停止条件以及 Python 运行时的底层机理,才能在真实工程架构中写出既简洁优雅又健壮可靠的高性能程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









