

Python bisect模块用法:高效实现二分查找与插入
深入讲解Python内置bisect模块的原理与用法,涵盖二分查找、左右边界插入、key参数映射、区间分段及动态有序列表维护等实战技巧。
在一个包含数万甚至数百万条已排序数据的列表中查找某个特定数值的位置,或者希望插入一个新元素时依然维持列表的递增顺序,若使用内置的线性查找方法遍历比对,时间复杂度将达到 O(n)。当数据量庞大或查询极其频繁时,程序性能会急剧下降。Python 标准库自带的 bisect 模块基于经典二分查找算法(Binary Search),提供了一组极简而高效的函数,能够在 O(log n) 的时间复杂度内准确定位目标插入点或直接原位插入,是日常编写高性能算法与数据检索必不可少的基础工具。
一、二分查找定位原理与性能基准
二分查找的核心前提是目标序列必须是已排序的(通常为升序)。其工作原理是通过左右两个指针确定当前搜索区间,每次取区间中点值与目标数值比对,根据大小关系直接舍弃一半不可能包含目标的区间,直至区间收敛并定位到目标位置。
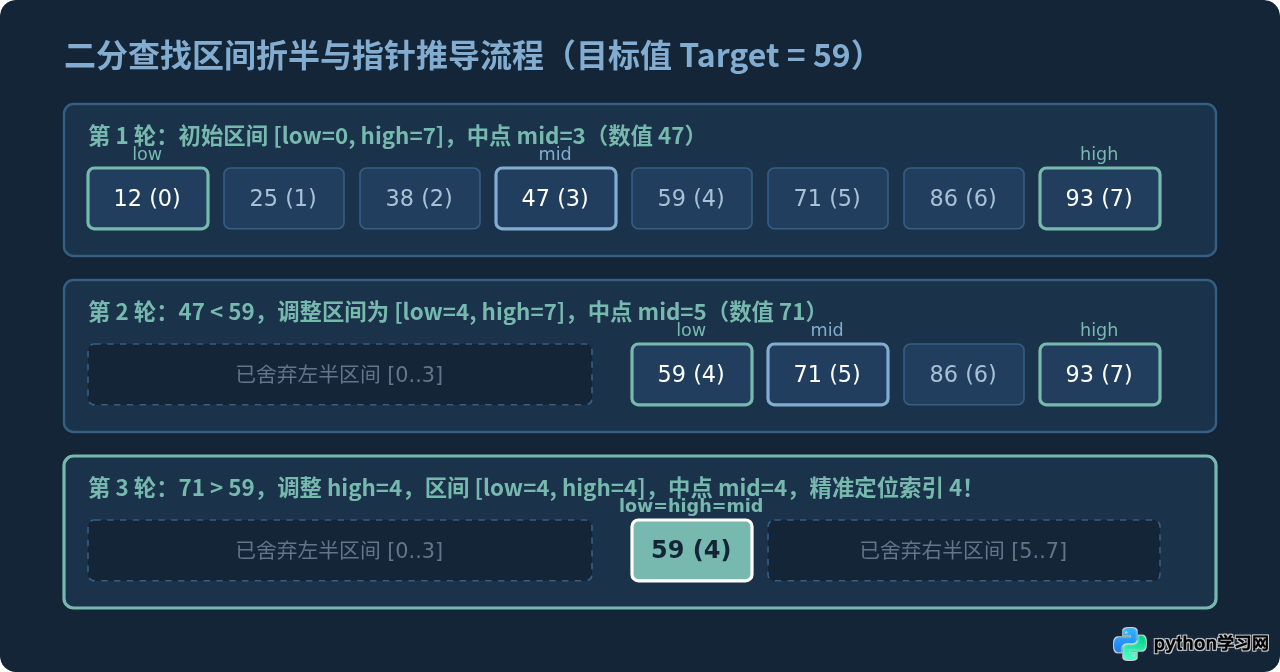
在 Python 中,如果手动编写二分查找,需要反复处理边界条件(例如 low <= high 还是 low < high,中点是否加一等),容易出现死循环或边界越界问题。bisect 模块底层采用 C 语言高度优化(在 CPython 下自动使用 C 扩展),既保证了极致的执行速度,又消除了手写逻辑的出错概率。
import bisect

data = [12, 25, 38, 47, 59, 71, 86, 93]

# 查找元素 59 应当放置的索引位置
idx = bisect.bisect(data, 59)
print("插入位置索引:", idx)  # 示例输出:插入位置索引: 5
二、左右分流:bisect_left 与 bisect_right 的边界差异
当列表中存在重复元素时,新元素到底插入在重复项的左侧(前面)还是右侧(后面)?这是 bisect 模块最关键的概念分野:
bisect_left(a, x, lo=0, hi=len(a)):如果序列中已存在与x相同的元素,返回的插入点位于最左侧重复项的左边。bisect_right(a, x, lo=0, hi=len(a)):如果序列中已存在与x相同的元素,返回的插入点位于最右侧重复项的右边。bisect.bisect:实际上是bisect_right的别名,默认采用右侧插入策略。
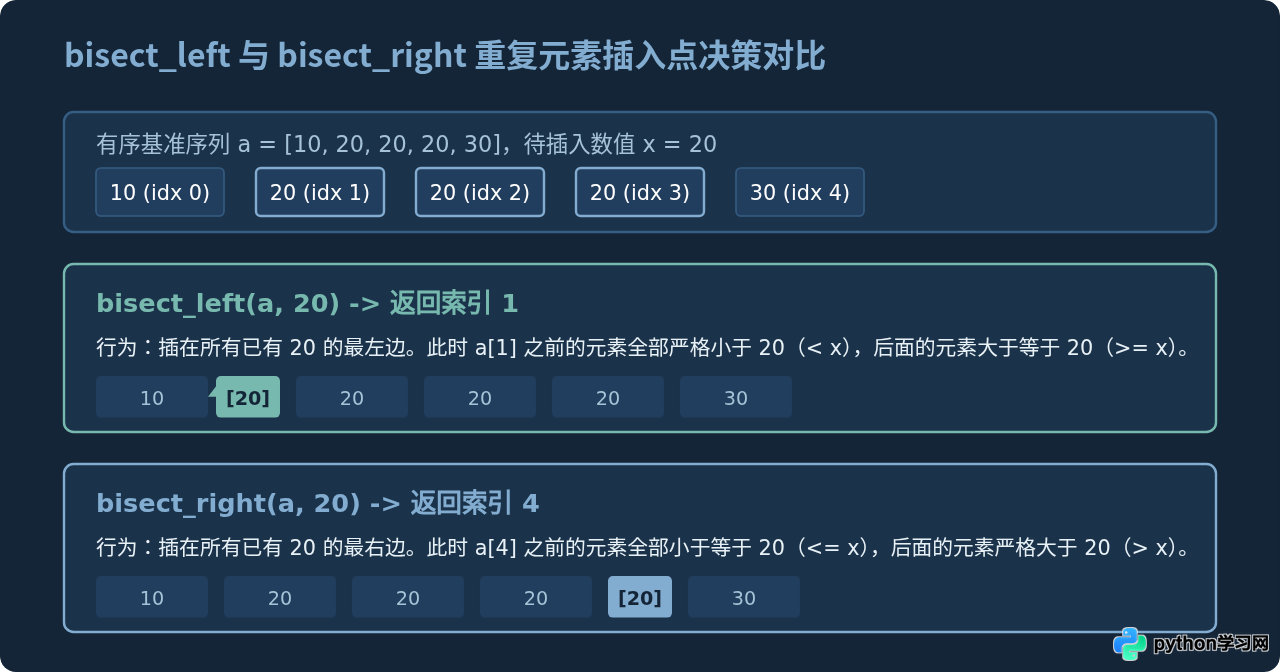
以下代码清晰演示了二者的差异以及如何利用它们判断元素是否真正存在于列表中:
import bisect

arr = [10, 20, 20, 20, 30]

pos_left = bisect.bisect_left(arr, 20)
pos_right = bisect.bisect_right(arr, 20)

print(f"bisect_left 结果: {pos_left}")    # 示例输出: 1
print(f"bisect_right 结果: {pos_right}")  # 示例输出: 4

# 判断元素是否存在的高效模式:
def contains(sorted_list, target):
    idx = bisect.bisect_left(sorted_list, target)
    return idx < len(sorted_list) and sorted_list[idx] == target

print(contains(arr, 20))  # 示例输出: True
print(contains(arr, 25))  # 示例输出: False
三、原地插入:insort 与 insort_left 的使用与代价
如果不仅需要找到索引,还希望直接把元素插入到列表中,可以直接调用 insort 系列函数:
insort_left(a, x, lo=0, hi=len(a)):等价于a.insert(bisect_left(a, x, lo, hi), x)。insort_right(a, x, lo=0, hi=len(a)):等价于a.insert(bisect_right(a, x, lo, hi), x)。bisect.insort:同样是insort_right的别名。
import bisect

scores = [60, 75, 88, 92]

# 原地插入 80,保持列表升序
bisect.insort(scores, 80)
print(scores) # 示例输出:[60, 75, 80, 88, 92]注意时间复杂度的陷阱:bisect 函数本身的查找步骤是 O(log n),但 Python 的内置 list 底层是动态连续数组。执行 list.insert 时,插入点之后的所有元素都需要在内存中向后移动一个位置,因此插入操作的时间复杂度依然是 O(n)。如果程序需要频繁向包含海量数据的列表中插入新项,单靠 insort 可能会成为性能瓶颈,此时应考虑平衡二叉树、跳表或 sortedcontainers 库中的 SortedList。
四、结构化数据处理:Python 3.10+ 中的 key 参数
在 Python 3.10 之前,如果列表中的元素不是单纯的数字,而是字典、元组或自定义对象,使用 bisect 会非常繁琐,通常需要单独维护一个平行的纯键值列表。从 Python 3.10 开始,bisect 模块的所有函数都新增了 key 参数,行为与 list.sort(key=...) 或 sorted(..., key=...) 完全一致。
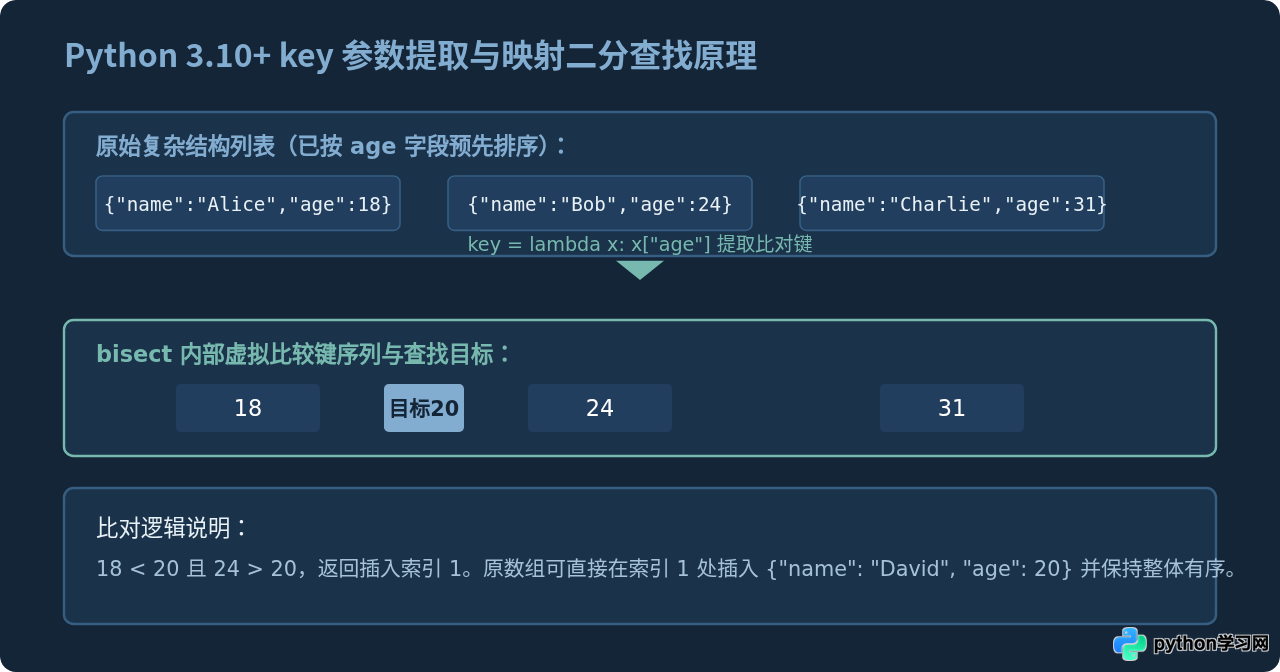
利用 key 参数,我们可以非常优雅地处理复合对象列表:
import bisect

users = [
    {"name": "Alice", "age": 18},
    {"name": "Bob", "age": 24},
    {"name": "Charlie", "age": 31}
]

# 在已按 age 排序的用户列表中查找 age=20 的插入位置
idx = bisect.bisect_left(users, 20, key=lambda u: u["age"])
print("插入位置索引:", idx)  # 示例输出:插入位置索引: 1

# 使用 insort 直接将新用户字典插入正确位置
new_user = {"name": "David", "age": 20}
bisect.insort_left(users, new_user, key=lambda u: u["age"])
print(users)
# 示例输出:[{'name': 'Alice', 'age': 18}, {'name': 'David', 'age': 20}, {'name': 'Bob', 'age': 24}, {'name': 'Charlie', 'age': 31}]
五、三大经典实战应用场景
场景 1:分段数值查表与等级评定
在日常业务中,经常需要根据连续数值匹配所属等级(例如学生考试分级、阶梯水电费分档、物流运费计费区间等)。传统写法往往是一长串冗长的 if-elif-else 语句,维护起来极易遗漏边界。借助 bisect 可以将分段断点与结果列表分离,实现极为优雅且高内聚的数值查表:
import bisect

def get_grade(score):
    # 分界断点:小于 60 为 F,60~69 为 D,70~79 为 C,80~89 为 B,90 及以上为 A
    breakpoints = [60, 70, 80, 90]
    grades = ['F', 'D', 'C', 'B', 'A']

    # bisect 使用 bisect_right,score 达到 60 时命中索引 1(即 'D')
    idx = bisect.bisect(breakpoints, score)
    return grades[idx]

print([get_grade(s) for s in [55, 60, 78, 89, 90, 100]])
# 示例输出:['F', 'D', 'C', 'B', 'A', 'A']
场景 2:流式数据动态有序聚合
当系统接收来自外部传感器或消息队列的乱序时间戳数据,但又必须在本地滑动窗口内始终保持按时间顺序处理时,无需每次收到新数据都执行一次全量 list.sort()(全量排序耗时 O(k log k)),使用 insort 可以将单次维护成本降至 O(k):
import bisect

stream_buffer = []

def add_event(timestamp, payload):
    # 动态插入并保持按时间戳升序
    bisect.insort(stream_buffer, (timestamp, payload))

add_event(1698000030, "Event C")
add_event(1698000010, "Event A")
add_event(1698000020, "Event B")

print([e[1] for e in stream_buffer])
# 示例输出:['Event A', 'Event B', 'Event C']
场景 3:查找最接近的邻近数值
二分查找不仅可以寻找完全相等的元素,当元素不存在时,bisect_left 返回的索引刚好位于目标数值的紧邻右侧,其左侧索引即为紧邻左侧。比较这两个候选者与目标的差值绝对值,即可在 O(log n) 内找到整个有序序列中与目标最接近的值:
import bisect

def find_closest(sorted_arr, target):
    idx = bisect.bisect_left(sorted_arr, target)
    if idx == 0:
        return sorted_arr[0]
    if idx == len(sorted_arr):
        return sorted_arr[-1]

    before = sorted_arr[idx - 1]
    after = sorted_arr[idx]
    if after - target < target - before:
        return after
    else:
        return before

timeline = [100, 250, 400, 600, 850]
print(find_closest(timeline, 380))  # 示例输出:400
print(find_closest(timeline, 50))   # 示例输出:100
六、bisect 模块使用场景与决策全景
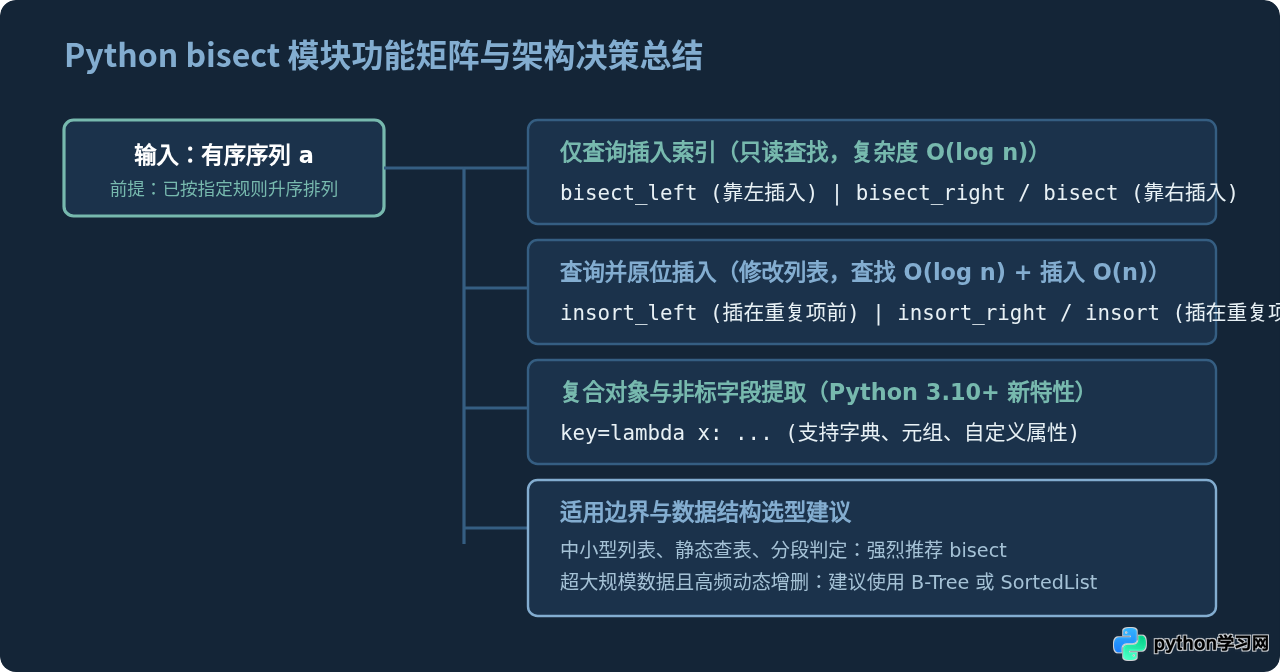
为了在实际架构与开发选型中迅速做出正确判断,下图对 bisect 模块的核心 API 职能、使用分支及适用边界进行了全景归纳:
七、核心要点总结
熟练运用 bisect 模块能够显著提升处理有序数据时的代码整洁度与运行效率。在实际编码中,请牢记以下三条黄金准则:
- 输入必先有序:
bisect不会在运行期检查列表是否有序;若传入未排序列表,二分查找会返回错误索引而不会抛出任何异常。 - 看清左右偏向:在处理去重或寻找特定分界点时,明确区分
bisect_left(小于区域与大于等于区域)与bisect_right(小于等于区域与大于区域)的语义区别。 - 善用 key 参数简化设计:升级至 Python 3.10 及以上环境后,充分利用
key参数直接对结构化数据进行有序查找与插入,避免额外维护辅助数据结构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









