

5个适合Python初学者的练手小项目实战
精选5个适合Python初学者上手的实战小项目,涵盖交互猜数字、命令行待办清单、批量文件整理工具、文本词频分析器与密码生成器,提供完整可运行源码、设计思路剖析及常见错误规避指南。
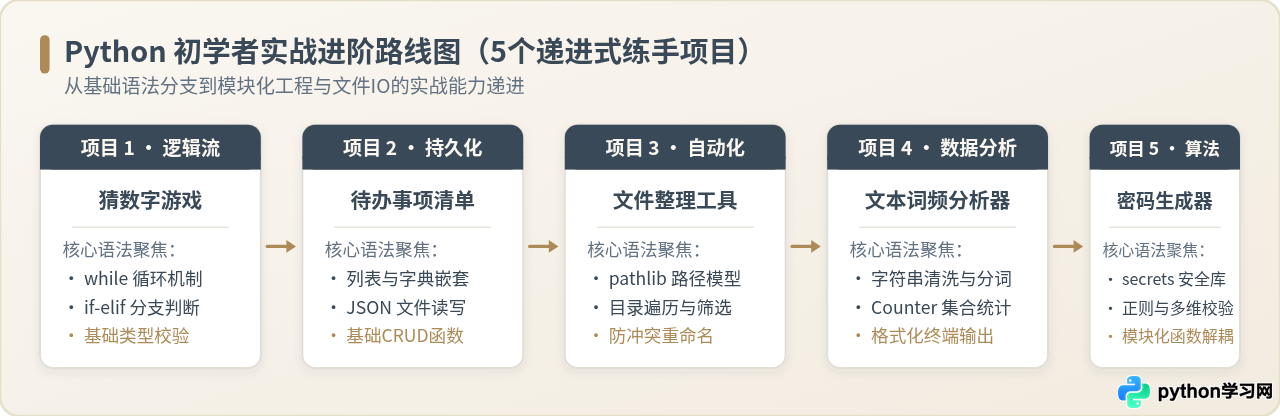
初学 Python 时,很多读者在掌握了基础语法后往往不知道该如何写出真正可运行的程序。本文挑选了 5 个梯度适中、不依赖复杂第三方框架的练手小项目:猜数字游戏、命令行待办清单、批量文件整理工具、文本词频分析器以及强密码生成与检测器。每个项目均提供可直接运行的完整源码、核心逻辑拆解与避坑指南,帮助读者将变量、循环、分支、文件读写与标准库转化为扎实的动手能力。
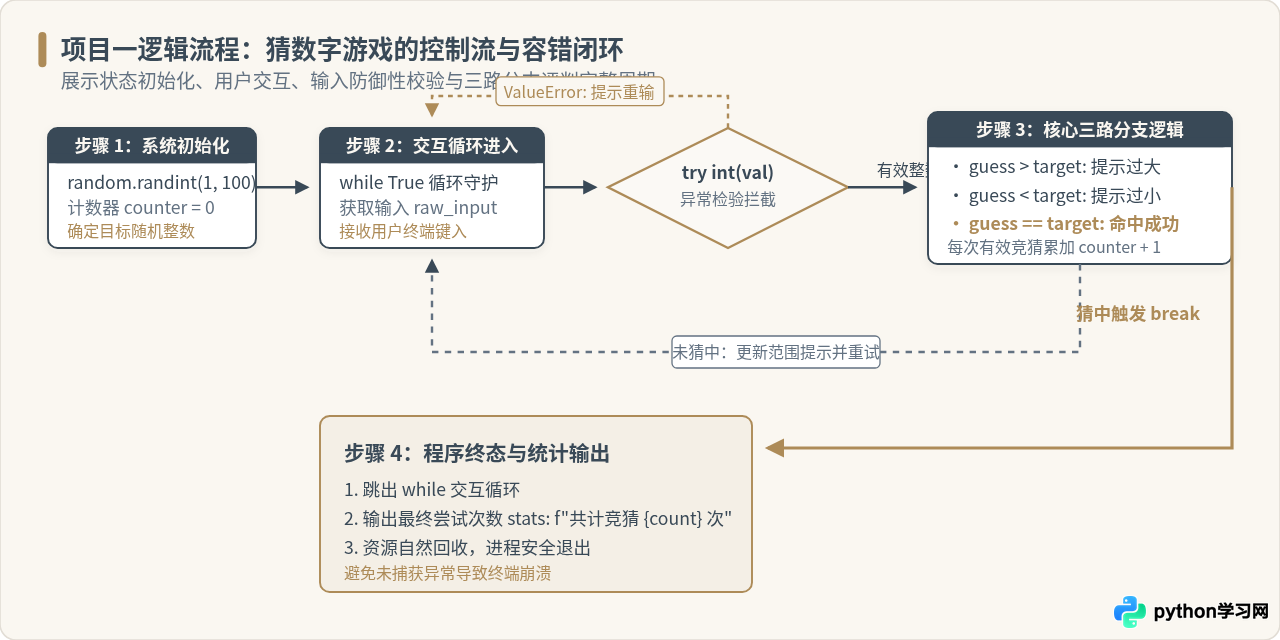
项目一:猜数字游戏(掌握控制流与异常防御)
很多初学者在编写简单交互程序时,最容易遇到的问题是程序缺乏容错能力:用户一旦输入非数字字符,程序就会直接报错崩溃退出。猜数字游戏虽然逻辑简单,但它是训练条件分支、无限循环与异常防御的最佳入门案例。
1. 完整实现代码
新建 guess_number.py 文件并写入以下代码。程序由系统在 1 到 100 之间随机选定一个整数,并根据用户每次猜测给出“偏大”或“偏小”的反馈,同时自动累计猜测次数:
# guess_number.py
import random

def play_guessing_game():
    target = random.randint(1, 100)
    attempts = 0
    print("=== 欢迎来到猜数字游戏 ===")
    print("系统已生成一个 1 到 100 之间的整数,请开始猜测。输入 'q' 可随时退出。")

    while True:
        user_input = input("请输入你猜的数字: ").strip()

        if user_input.lower() == 'q':
            print(f"游戏已提前退出,本次目标数字是: {target}")
            break

        # 防御性转换:拦截非数字输入
        try:
            guess = int(user_input)
        except ValueError:
            print("输入无效!请输入有效的整数或输入 'q' 退出。")
            continue

        attempts += 1

        if guess < 1 or guess > 100:
            print("提示:数字超出范围,请输入 1 到 100 之间的整数。")
            continue

        if guess > target:
            print("太大了,往小的猜猜看。")
        elif guess < target:
            print("太小了,往大的猜猜看。")
        else:
            print(f"恭喜你猜对了!目标数字正是 {target}。")
            print(f"本次一共尝试了 {attempts} 次。")
            break

if __name__ == "__main__":
    play_guessing_game()
2. 运行示例
- 不要直接
int(input()):如果用户误敲空格、字母或回车,未加保护的int()会抛出ValueError导致程序异常终止。必须使用try...except ValueError进行防护。 - 统计次数的位置:
attempts += 1必须放在输入合法性校验之后;如果用户输错了字母,不应该扣除或增加有效竞猜次数。
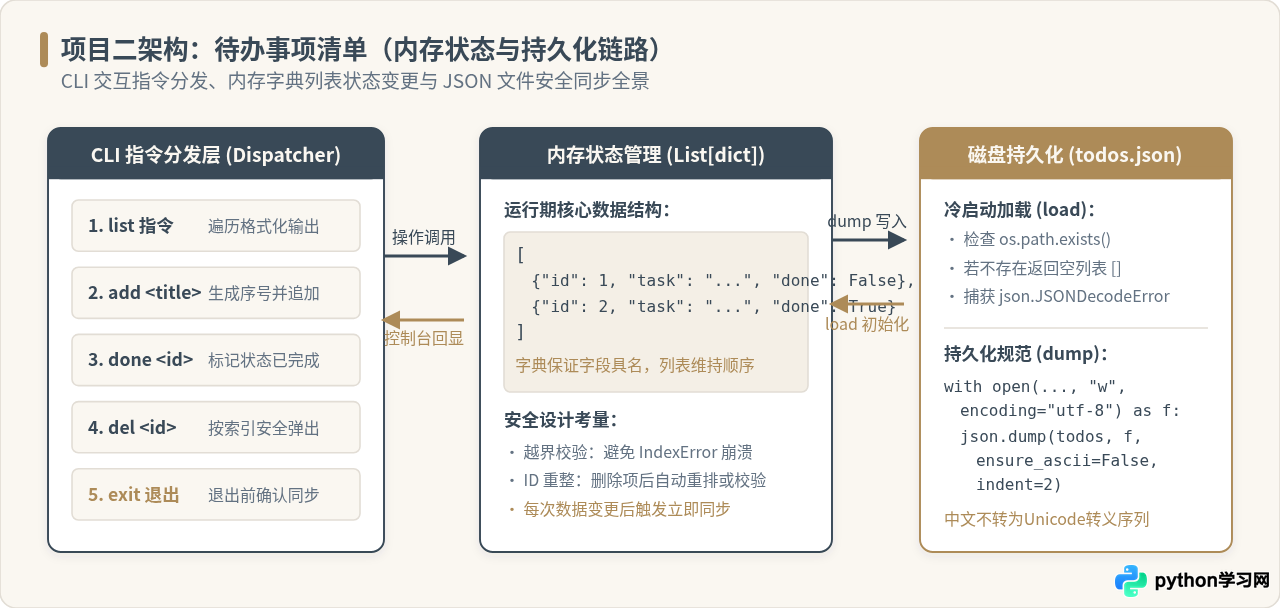
项目二:命令行待办事项清单(掌握复合数据结构与文件持久化)
许多初学者写的程序一旦关闭终端,之前输入的所有数据就全部消失了。通过编写一个命令行待办清单(Todo List),你可以学会如何在内存中使用列表和字典维护结构化数据,并借助标准库 json 实现断电不丢失的文件持久化。
1. 完整实现代码
新建 todo_manager.py 文件。代码包含了任务的新增、列出、完成标记、删除以及退出时自动同步磁盘的功能:
# todo_manager.py
import json
import os

DATA_FILE = "todos.json"

def load_todos():
    """从磁盘读取待办任务列表,若文件不存在则初始化空列表"""
    if not os.path.exists(DATA_FILE):
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, OSError):
        print("警告:数据文件解析异常,已重置为空列表。")
        return []

def save_todos(todos):
    """将待办任务安全写入磁盘文件"""
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        json.dump(todos, f, ensure_ascii=False, indent=2)

def list_todos(todos):
    """打印当前所有任务状态"""
    if not todos:
        print("当前没有任何待办任务!")
        return
    print("
--- 待办任务清单 ---")
    for idx, item in enumerate(todos, start=1):
        status = "✔ 已完成" if item["done"] else "○ 待完成"
        print(f"[{idx}] {status} | {item['title']}")
    print("-------------------")

def add_todo(todos, title):
    """添加一条新任务"""
    if not title:
        print("任务内容不能为空!")
        return
    todos.append({"title": title, "done": False})
    save_todos(todos)
    print(f"已添加任务: {title}")

def mark_done(todos, index):
    """按序号标记任务完成"""
    if 1 <= index <= len(todos):
        todos[index - 1]["done"] = True
        save_todos(todos)
        print(f"已将第 {index} 项任务标记为完成!")
    else:
        print("错误:任务序号超出有效范围。")

def delete_todo(todos, index):
    """按序号删除任务"""
    if 1 <= index <= len(todos):
        removed = todos.pop(index - 1)
        save_todos(todos)
        print(f"已删除任务: {removed['title']}")
    else:
        print("错误:任务序号超出有效范围。")

def main():
    todos = load_todos()
    print("=== 简易待办事项管理器 ===")
    print("支持指令: list | add <任务> | done <序号> | del <序号> | exit")

    while True:
        command_line = input("
请输入指令 > ").strip()
        if not command_line:
            continue

        parts = command_line.split(maxsplit=1)
        action = parts[0].lower()
        arg = parts[1] if len(parts) > 1 else ""

        if action == "list":
            list_todos(todos)
        elif action == "add":
            add_todo(todos, arg.strip())
        elif action == "done":
            if arg.isdigit():
                mark_done(todos, int(arg))
            else:
                print("请输入有效数字序号,例如: done 1")
        elif action == "del":
            if arg.isdigit():
                delete_todo(todos, int(arg))
            else:
                print("请输入有效数字序号,例如: del 1")
        elif action == "exit":
            print("数据已保存,程序退出。")
            break
        else:
            print("未知指令!支持的指令包括: list, add, done, del, exit")

if __name__ == "__main__":
    main()
2. 运行示例
- 编码格式必须设为 UTF-8:在 Windows 下打开文件默认可能会使用 GBK,读写中文时极易出现
UnicodeEncodeError。务必在open()中显式指定encoding="utf-8"。 - JSON 序列化中文保护:使用
json.dump()保存时,默认会将中文字符转为中文形式的 ASCII 转义串。加入ensure_ascii=False能保留原生可读的中文字符。
项目三:批量文件整理与重命名工具(掌握系统路径与自动化)
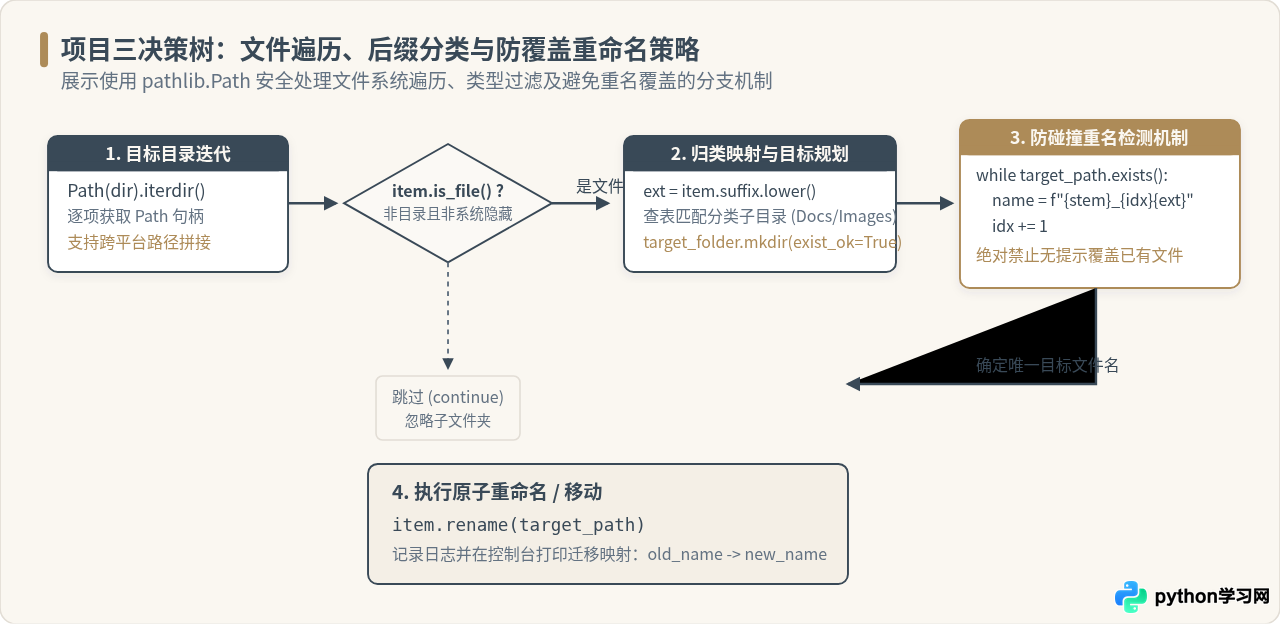
日常使用电脑时,下载文件夹中往往塞满了各类文档、图片、压缩包和安装包。编写一个文件整理脚本,可以让读者掌握现代 Python 推荐的面向对象路径库 pathlib,学会安全扫描目录、提取后缀并执行防覆盖的移动操作。
1. 完整实现代码
新建 file_organizer.py 文件。该脚本会遍历指定目录中的所有普通文件,根据后缀将其归档到对应的分类文件夹(如“文档”、“图片”、“压缩包”等)。若目标目录下存在同名文件,会自动追加数字序号以防止覆盖:
# file_organizer.py
from pathlib import Path

# 定义后缀与归档文件夹的映射规则
CATEGORY_MAPPING = {
    "文档": {".pdf", ".docx", ".doc", ".txt", ".xlsx", ".pptx", ".md"},
    "图片": {".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg"},
    "音频视频": {".mp3", ".wav", ".mp4", ".mkv", ".mov", ".flv"},
    "压缩包": {".zip", ".tar", ".gz", ".rar", ".7z"},
    "代码与脚本": {".py", ".html", ".css", ".js", ".json", ".sh"}
}

def get_category(suffix):
    """根据文件扩展名返回归档目录名称"""
    s = suffix.lower()
    for cat_name, extensions in CATEGORY_MAPPING.items():
        if s in extensions:
            return cat_name
    return "其他杂项"

def get_safe_target_path(target_dir, original_path):
    """计算安全的目标文件路径,若同名则追加计数序号,绝不静默覆盖"""
    stem = original_path.stem
    suffix = original_path.suffix
    new_path = target_dir / f"{stem}{suffix}"
    counter = 1

    while new_path.exists():
        new_path = target_dir / f"{stem}_{counter}{suffix}"
        counter += 1
    return new_path

def organize_directory(target_folder_path):
    base_dir = Path(target_folder_path).resolve()

    if not base_dir.exists() or not base_dir.is_dir():
        print(f"错误:指定的目标路径 {base_dir} 不是有效目录!")
        return

    print(f"开始整理目录: {base_dir}")
    moved_count = 0

    # 遍历当前目录下的所有条目
    for item in list(base_dir.iterdir()):
        # 仅处理普通文件,忽略子文件夹以及系统隐藏文件(以点开头)
        if not item.is_file() or item.name.startswith("."):
            continue

        cat_name = get_category(item.suffix)
        dest_dir = base_dir / cat_name
        dest_dir.mkdir(parents=True, exist_ok=True)

        dest_file = get_safe_target_path(dest_dir, item)
        item.rename(dest_file)
        print(f"[移动] {item.name} -> {cat_name}/{dest_file.name}")
        moved_count += 1

    print(f"整理完成!共计迁移并分类了 {moved_count} 个文件。")

if __name__ == "__main__":
    import sys
    # 默认整理当前工作目录,或从命令行接收目标参数
    target_path = sys.argv[1] if len(sys.argv) > 1 else "."
    organize_directory(target_path)
2. 运行示例
- 优先使用
pathlib.Path而非手写字符串拼接:用"folder/" + name会在跨平台(Windows 使用反斜杠\,Linux/macOS 使用正斜杠/)时出现路径不兼容问题;pathlib的/重载运算符会自动处理系统适配。 - 防碰撞死循环防范:移动文件前必须检查
dest_file.exists(),并按序号递增重命名;如果直接使用覆盖模式,可能会造成重要同名数据的不可逆丢失。
项目四:文本词频分析与统计器(掌握文件流、正则表达式与集合库)
当手头有一份英文电子书、日志文件或文章草稿时,如何快速分析出出现频次最高的关键词?这个项目不仅训练如何正确读取大段文本,更带领初学者接触 Python 标准库中的利器 collections.Counter 与 re 正则表达式分词。
1. 完整实现代码
新建 word_counter.py 文件。该程序读取文本文件,自动剥离标点符号并将所有字符转为小写,过滤掉无实际语义的高频停用词(如 a, the, of, in 等),最后以清晰的柱状图风格在控制台打印 Top 10 高频词:
# word_counter.py
import re
from collections import Counter
from pathlib import Path

# 常见英文虚词/停用词表,避免干扰核心分析
STOP_WORDS = {
    "the", "a", "an", "and", "or", "but", "in", "on", "at", "to",
    "for", "of", "with", "by", "from", "up", "about", "into", "over",
    "after", "is", "are", "was", "were", "be", "been", "being",
    "have", "has", "had", "do", "does", "did", "it", "its", "that", "this"
}

def analyze_word_frequency(file_path, top_n=10):
    path = Path(file_path)
    if not path.exists() or not path.is_file():
        print(f"错误:文件不存在 -> {file_path}")
        return

    try:
        with open(path, "r", encoding="utf-8") as f:
            content = f.read()
    except UnicodeDecodeError:
        print("错误:文件非 UTF-8 编码,请检查文件格式。")
        return

    # 使用正则只保留字母单词,自动剔除标点符号与数字
    raw_words = re.findall(r"[A-Za-z]+", content)
    total_words = len(raw_words)

    if total_words == 0:
        print("警告:文件中未检测到有效单词!")
        return

    # 归一化为小写,并过滤停用词
    cleaned_words = [
        w.lower() for w in raw_words
        if w.lower() not in STOP_WORDS and len(w) > 1
    ]

    # 利用 Counter 进行高频统计
    counter = Counter(cleaned_words)
    top_items = counter.most_common(top_n)

    print(f"
=== 文本词频统计报告 [{path.name}] ===")
    print(f"文章总词数: {total_words} | 过滤后有效词数: {len(cleaned_words)} | 独立词汇总数: {len(counter)}
")
    print(f"{'排名':<6}{'单词':<16}{'频次':<8}{'占比':<8}词频可视化")
    print("-" * 56)

    max_freq = top_items[0][1] if top_items else 1
    for rank, (word, freq) in enumerate(top_items, start=1):
        ratio = (freq / total_words) * 100
        # 按照最大值缩放打印字符柱状条
        bar_len = int((freq / max_freq) * 20)
        bar = "■" * bar_len
        print(f"{rank:<6}{word:<16}{freq:<8}{ratio:.2f}%   {bar}")
    print("-" * 56)

if __name__ == "__main__":
    import sys
    if len(sys.argv) > 1:
        analyze_word_frequency(sys.argv[1])
    else:
        # 若未提供参数,创建一个临时示例文件进行演示
        sample_path = Path("sample_text.txt")
        sample_path.write_text(
            "Python is an easy to learn, powerful programming language. "
            "Python has efficient high-level data structures and a simple but effective approach "
            "to object-oriented programming. Python elegant syntax and dynamic typing, "
            "together with its interpreted nature, make it an ideal language for scripting "
            "and rapid application development in many areas on most platforms.",
            encoding="utf-8"
        )
        analyze_word_frequency(sample_path)
2. 运行示例
- 不要使用
text.split(" ")进行文本分词:简单按空格切分会导致language.后面紧跟的句号一并计入单词,导致language与language.被判定为两个不同的词。使用正则表达式re.findall(r"[A-Za-z]+", content)可以干净利落地提取标准词元。 - 大小写归一化:统计前必须全部通过
.lower()转换;否则句首的大写Python与句中的python将无法累加。
项目五:安全密码生成与强度评估器(掌握标准安全库与函数封装)
很多初学者在需要随机生成验证码或密码时,习惯直接调用 random.choice()。然而在实际工程开发中,random 模块使用的是伪随机数生成算法(Mersenne Twister),其内部状态可以被逆向推导,不适合用于安全敏感场景。通过该项目,初学者将学会使用 Python 官方专为密码学设计的 secrets 模块,并掌握多维规则校验的设计思路。
1. 完整实现代码
新建 password_tool.py 文件。该工具包含两个独立解耦的函数:generate_password() 用于生成满足高熵值要求的随机密码,evaluate_strength() 用于对任意密码进行 5 维度安全评级:
# password_tool.py
import secrets
import string

def generate_password(length=14, use_symbols=True):
    """
    使用系统安全熵源生成强随机密码。
    强制要求至少包含1个大写、1个小写、1个数字和1个特殊符号(若开启)。
    """
    if length < 8:
        raise ValueError("安全建议:密码长度不应小于 8 位!")

    lower = string.ascii_lowercase
    upper = string.ascii_uppercase
    digits = string.digits
    symbols = "!@#$%^&*()-_=+[]{}<>?"

    # 1. 保证每一类必选字符集中至少抽中一个
    password_chars = [
        secrets.choice(lower),
        secrets.choice(upper),
        secrets.choice(digits)
    ]
    all_chars = lower + upper + digits

    if use_symbols:
        password_chars.append(secrets.choice(symbols))
        all_chars += symbols

    # 2. 剩余位通过全字符集安全填充
    remaining = length - len(password_chars)
    for _ in range(remaining):
        password_chars.append(secrets.choice(all_chars))

    # 3. 将固定次序的头部打乱,消除结构特征(使用 secrets 级别的 Fisher-Yates 洗牌)
    for i in range(len(password_chars) - 1, 0, -1):
        j = secrets.randbelow(i + 1)
        password_chars[i], password_chars[j] = password_chars[j], password_chars[i]

    return "".join(password_chars)

def evaluate_strength(password):
    """
    根据长度与字符多样性,输出密码安全评分(0-100分)及评级
    """
    score = 0
    feedback = []

    # 长度评分(最高 40 分)
    pw_len = len(password)
    if pw_len >= 14:
        score += 40
    elif pw_len >= 10:
        score += 25
    elif pw_len >= 8:
        score += 15
    else:
        feedback.append("密码长度低于 8 位,极易被暴力破解")

    # 字符多样性判定(每项 15 分,最高 60 分)
    has_lower = any(c.islower() for c in password)
    has_upper = any(c.isupper() for c in password)
    has_digit = any(c.isdigit() for c in password)
    has_symbol = any(c in string.punctuation for c in password)

    if has_lower:
        score += 15
    else:
        feedback.append("缺少小写英文字母")

    if has_upper:
        score += 15
    else:
        feedback.append("缺少大写英文字母")

    if has_digit:
        score += 15
    else:
        feedback.append("缺少数字")

    if has_symbol:
        score += 15
    else:
        feedback.append("缺少特殊标点符号")

    # 综合等级判定
    if score >= 85:
        level = "非常强 (Very Strong)"
    elif score >= 70:
        level = "强 (Strong)"
    elif score >= 50:
        level = "中等 (Medium)"
    else:
        level = "较弱 (Weak)"

    return {
        "score": score,
        "level": level,
        "feedback": feedback
    }

if __name__ == "__main__":
    print("=== 密码生成器与安全强度评估 ===")

    # 演示生成 3 个推荐强密码
    print("
[系统推荐生成的安全随机密码]:")
    for idx in range(1, 4):
        pwd = generate_password(length=14, use_symbols=True)
        res = evaluate_strength(pwd)
        print(f"候选 {idx}: {pwd}  [得分: {res['score']}分 | 评级: {res['level']}]")

    # 演示对用户输入密码的分析
    test_cases = ["123456", "admin2026", "MySecretP@ss99!"]
    print("
[常见密码强度测试对比]:")
    for sample in test_cases:
        res = evaluate_strength(sample)
        print(f"密码: '{sample}'")
        print(f"  - 得分: {res['score']} / 100")
        print(f"  - 等级: {res['level']}")
        if res["feedback"]:
            print(f"  - 改进建议: {', '.join(res['feedback'])}")
2. 运行示例
- 严禁使用
random模块生成账户密钥:标准库中的random属于确定性伪随机数生成器,如果攻击者搜集了部分序列,就能预测后续产物。凡是涉及密码、密钥、身份令牌或 Session ID 的场景,必须使用secrets模块。 - 防范洗牌泄露:如果先保证包含大写、小写、数字,然后直接把它们拼接在最前面,生成的密码将具有固定的前缀结构模式。因此在拼接完毕后,必须使用洗牌算法彻底打散。
实战进阶总结与学习建议
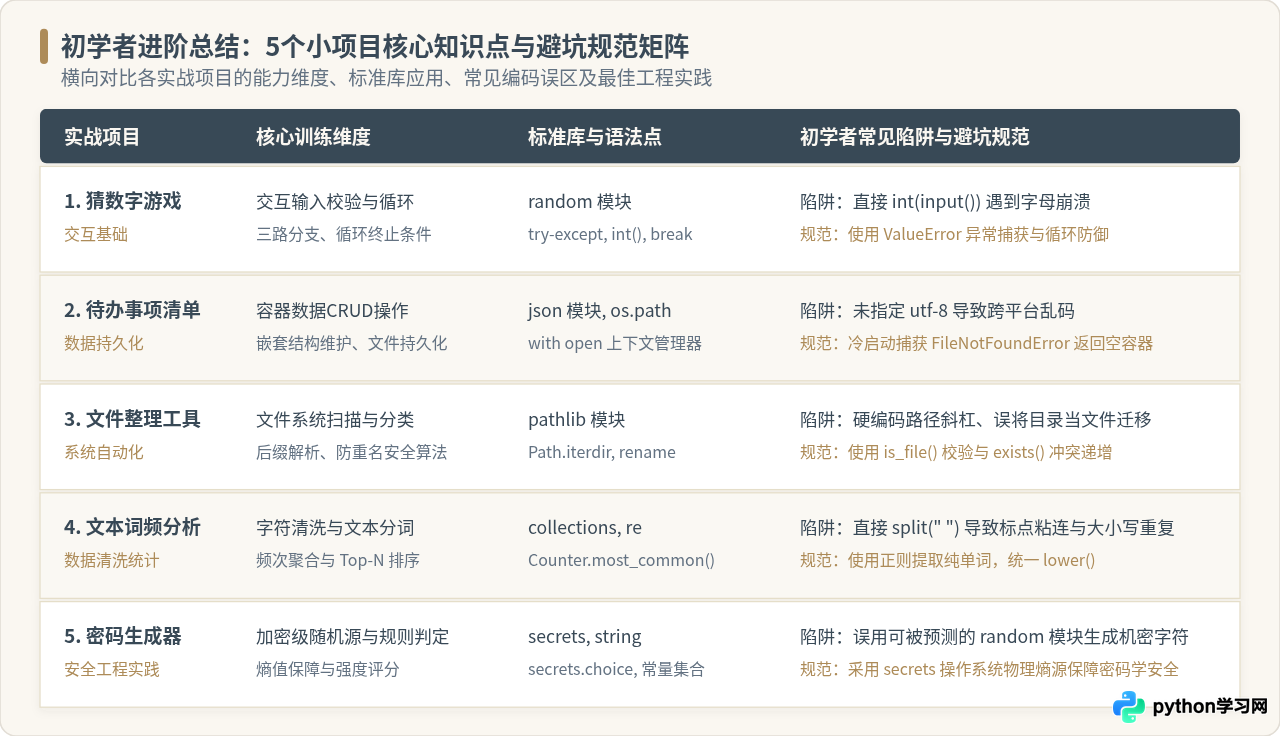
完成上述 5 个小项目后,初学者实际上已经经历了从基本语法走向实用脚本的关键跃升。各项目的知识重点、使用的核心库以及需要规避的高频陷阱汇总如下表所示:
后续拓展练习方向
- 为项目二(待办清单)增加分类标签与截止日期:在字典中新增
category与due_date字段,并支持按分类过滤展示。 - 为项目三(文件整理器)添加命令行参数支持:使用标准库
argparse代替sys.argv,提供--dry-run(预览移动结果而不实际改动磁盘)功能。 - 将项目四(词频分析器)升级为多文件聚合分析:结合
pathlib.Path.glob("*.txt")扫描整个文档目录,汇总统计词频并导出为 CSV 文件。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









