

Python数据结构常用操作:列表、字典、元组与集合语法
深入解析 Python 列表、字典、元组与集合四种核心内置数据结构的操作语法、内存存储机制、时间复杂度与实际选型决策指南。
一、底层存储架构与双轨分类机制
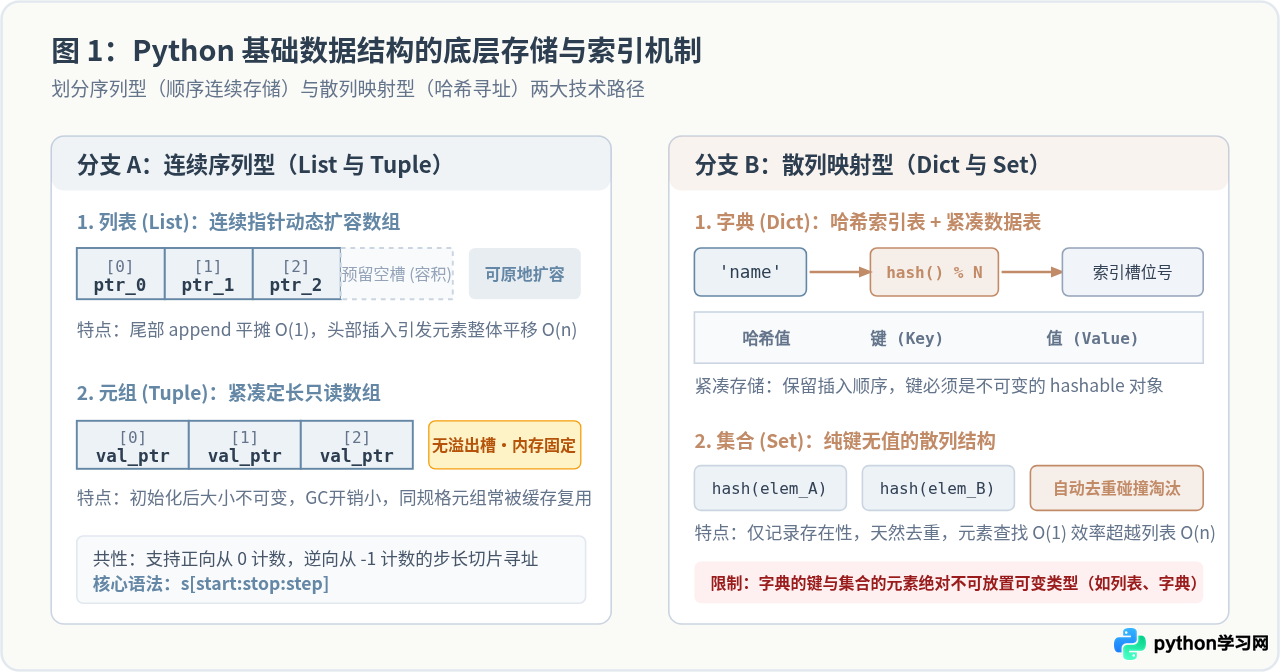
在深入具体语法前,理解 Python 数据结构的物理组织方式能有效避免低效编码。Python 的四种核心数据结构在底层由两种不同的实现机制支撑,分为“连续序列型”与“散列映射型”:
- 连续序列型(列表与元组):以连续内存块存储对象指针。列表(List)是动态扩容数组,通过预留空槽支持末尾常数时间的快速追加;元组(Tuple)则是定长只读数组,在初始化后其长度与指针槽位均被锁定,内存占用更紧凑。
- 散列映射型(字典与集合):依赖 Hash 函数建立由哈希值到槽位的直接寻址。字典(Dict)维护紧凑哈希表,实现键到值的常数级存取;集合(Set)本质上是仅保存键而省略值的散列表,专门用于元素存在性校验与去重。
二、列表(List):有序可变序列的常用语法
列表是 Python 中最常用的有序容器,元素可以随意修改、追加与替换。
1. 索引切片与赋值
列表切片遵循 s[start:stop:step] 规则,区间为左闭右开 [start, stop)。负索引从 -1 开始从尾部计数。
# 初始化序列
numbers = [10, 20, 30, 40, 50, 60]

# 基础切片与步长提取
subset = numbers[1:4]      # 示例输出: [20, 30, 40]
even_idx = numbers[::2]     # 示例输出: [10, 30, 50]
reversed_nums = numbers[::-1] # 逆序翻转,示例输出: [60, 50, 40, 30, 20, 10]

# 切片替换与批量更新
numbers[1:3] = [200, 300]
print(numbers)  # 示例输出: [10, 200, 300, 40, 50, 60]
2. 元素的追加、插入与删除
在列表尾部进行 append() 操作平摊时间复杂度为 $O(1)$;而在任意位置使用 insert() 则需要将后续所有元素后移,复杂度为 $O(n)$。
items = ["apple", "banana"]

# 1. 末尾单元素追加与批量扩展
items.append("cherry")       # items 变为: ['apple', 'banana', 'cherry']
items.extend(["date", "fig"]) # 合并迭代对象,不会嵌套

# 2. 指定位置插入(头部插入开销较大)
items.insert(0, "avocado")   # ['avocado', 'apple', ...]

# 3. 移除元素
removed_val = items.pop()    # 默认弹出末尾元素 'fig',时间复杂度 O(1)
head_val = items.pop(0)      # 弹出指定索引元素,复杂度 O(n)
items.remove("banana")       # 按值查找并删除首次出现的元素,值不存在时抛出 ValueError
3. 就地排序与全局排序
区分 list.sort() 与内置函数 sorted() 至关重要:list.sort() 为就地修改并返回 None,而 sorted() 返回全新的排序列表。
scores = [88, 62, 95, 78]

# 原地修改,节省内存分配
scores.sort(reverse=True)
print(scores)  # 示例输出: [95, 88, 78, 62]

# 产生新列表,原数据保持不变
words = ["python", "c", "javascript", "go"]
sorted_by_len = sorted(words, key=len)
print(sorted_by_len)  # 示例输出: ['c', 'go', 'python', 'javascript']
4. 列表推导式高效构建
# 过滤偶数并计算平方
raw_data = [1, 2, 3, 4, 5, 6, 7, 8]
evens_squared = [x ** 2 for x in raw_data if x % 2 == 0]
print(evens_squared)  # 示例输出: [4, 16, 36, 64]
三、字典(Dictionary):键值对映射的高效操作
字典是 Python 的核心支柱。自 Python 3.7 起,内置字典已在语言规范层级保证按元素的插入顺序迭代。
1. 安全读取与默认值回退
直接使用 d[key] 在键不存在时会直接引发 KeyError;在无法确保键存在时,应当优先使用 d.get() 或 setdefault()。
config = {"host": "127.0.0.1", "port": 8080}

# 安全读取
timeout = config.get("timeout", 30)  # 键不存在则回退至 30

# 取值并就地初始化
cache = {}
cache.setdefault("user_101", []).append("action_login")
print(cache)  # 示例输出: {'user_101': ['action_login']}
2. 字典更新与合并(支持 Python 3.9+ 新语法)
在现代 Python 中,合并字典除了传统的 update() 与解包操作外,还可以直接使用并集操作符 | 与就地赋值 |=。
base_opts = {"env": "prod", "debug": False, "workers": 4}
custom_opts = {"debug": True, "log_level": "DEBUG"}

# 使用 | 操作符合并两个字典,右侧键覆盖左侧
merged = base_opts | custom_opts
print(merged)
# 示例输出: {'env': 'prod', 'debug': True, 'workers': 4, 'log_level': 'DEBUG'}

# 原地更新
base_opts |= {"version": "1.2.0"}
3. 遍历与字典推导式
student_scores = {"Alice": 85, "Bob": 58, "Charlie": 92, "David": 45}

# 键值对解包遍历
for name, score in student_scores.items():
    if score >= 60:
        pass # 业务逻辑

# 字典推导式:过滤并调整数据
passed_students = {name: "Pass" for name, score in student_scores.items() if score >= 60}
print(passed_students)
# 示例输出: {'Alice': 'Pass', 'Charlie': 'Pass'}四、元组(Tuple):不可变有序序列与引用边界
元组与列表同样是有序序列,但核心区别在于元组是不可变(Immutable)的。一旦创建,无法追加元素或修改其长度。
1. 语法细节与解包操作
单元素元组必须带有尾随逗号,否则括号会被解析为普通的数学运算优先级符号。
# 单元素元组声明
not_a_tuple = ("hello")  # 实际类型为 str
real_tuple = ("hello",)   # 正确的 tuple 类型

# 基础解包与星号解包
point = (10, 20, 30, 40, 50)
x, y, *z = point
print(x, y, z)  # 示例输出: 10 20 [30, 40, 50]
2. 元组的不可变性边界(引用模型)
“元组不可变”所约束的是元组自身保存的对象内存地址(指针)不可变更。如果元组内部容纳了可变容器(如列表),通过列表的方法修改其内部数据是完全允许的,因为元组指向该列表对象的指针从未发生改变。
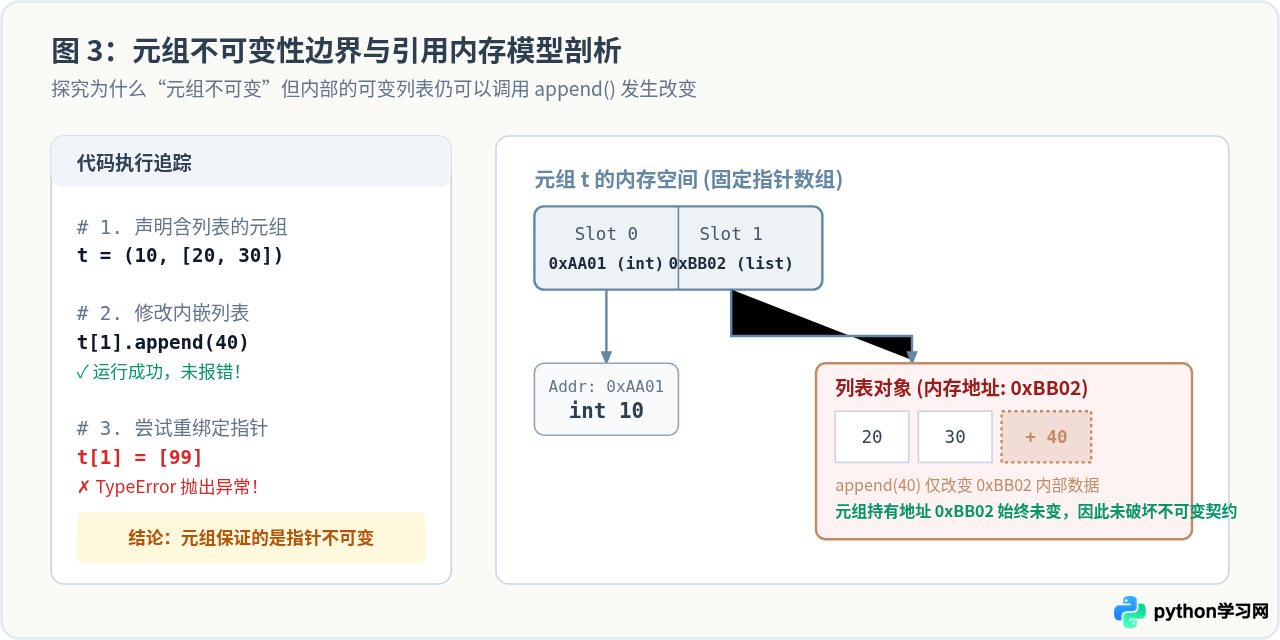
# 演示图 3 所示的引用修改
record = ("ID_001", [100, 200])

# 针对内嵌列表的原地操作生效
record[1].append(300)
print(record)  # 示例输出: ('ID_001', [100, 200, 300])

# 试图更改元组槽位的指针将触发异常
try:
    record[1] = [500]
except TypeError as e:
    print(f"抛出异常: {e}")  # 示例输出: 抛出异常: 'tuple' object does not support item assignment
五、集合(Set):去重、哈希与数学代数运算
集合是无序且元素互不重复的容器。由于底层依赖哈希散列寻址,集合的 in 成员查询时间复杂度为 $O(1)$,远快于列表的线性遍历 $O(n)$。
1. 创建与安全移除
空集合必须通过 set() 构建,因为 {} 语法默认会被 Python 解析为空字典。
# 初始化集合
unique_tags = {"python", "backend", "web"}
empty_s = set()  # 正确创建空集合

# 元素增删
unique_tags.add("cloud")

# 移除对比:remove vs discard
unique_tags.discard("not_found")  # 安全操作,元素不存在时不报错
try:
    unique_tags.remove("not_found")   # 元素不存在时抛出 KeyError
except KeyError:
    pass
2. 数学代数运算(交、并、差、对称差)
set_a = {1, 2, 3, 4}
set_b = {3, 4, 5, 6}

print(set_a & set_b)   # 交集: {3, 4}
print(set_a | set_b)   # 并集: {1, 2, 3, 4, 5, 6}
print(set_a - set_b)   # 差集 (属于A但不属于B): {1, 2}
print(set_a ^ set_b)   # 对称差集 (仅属于A或B其一): {1, 2, 5, 6}
六、四大数据结构选型决策与避坑指南
在工程实战中,应综合考虑业务模型是否有键值对应关系、是否需要维护顺序、是否要求唯一性,以及读写频次来决定容器类型。
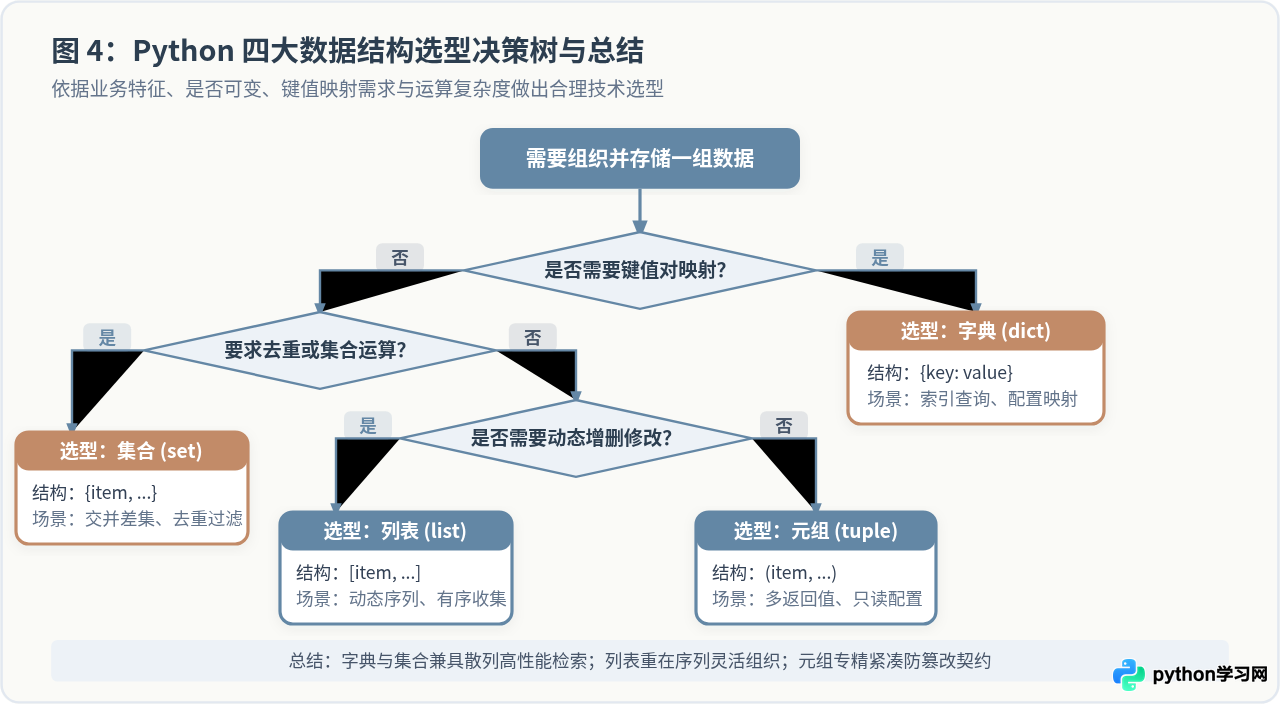
| 数据结构 | 主要语法定义 | 可变性 | 有序性 | 元素去重 | 查询复杂度 | 典型使用场景 |
|---|---|---|---|---|---|---|
| 列表 (List) | [1, 2, 3] |
可变 | 有序 | 否 | 按索引 $O(1)$,按值 $O(n)$ | 动态排列、收集处理结果序列 |
| 字典 (Dict) | {"k": "v"} |
可变 | 有序 (3.7+) | 键唯一 | 按键查询 $O(1)$ | 配置表、索引缓存、实体属性映射 |
| 元组 (Tuple) | (1, 2, 3) |
不可变 | 有序 | 否 | 按索引 $O(1)$,按值 $O(n)$ | 函数多返回值、常量配置、字典键 |
| 集合 (Set) | {1, 2, 3} |
可变 | 无序 | 是 | 成员判断 $O(1)$ | 去重过滤、白名单校验、集合代数 |
高频编码陷阱防范
- 切忌使用可变类型作为函数默认参数:例如
def append_item(val, container=[])中的container在模块加载时仅初始化一次,多次调用会导致状态残留。应当使用container=None并在函数内部执行if container is None: container = []。 - 避免在迭代序列时直接删除元素:在
for item in my_list:循环体内直接执行my_list.remove(item)会导致底层索引指针偏移,漏掉邻近元素。应对副本迭代for item in my_list[:]:或采用推导式生成新序列。 - 警惕列表的就地修改返回值:
list.sort()、list.reverse()、list.append()均原地生效并返回None。误写为res = my_list.sort()会导致变量被赋值为None。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









