

Python怎么高效读取超大Excel文件避免内存溢出
深入解析Python读取超大Excel文件导致内存溢出(OOM)的底层机理,提供基于openpyxl只读流式模式、Pandas分块生成器与calamine高性能引擎的三大实用解决方案,助您稳定高效处理海量表格数据。
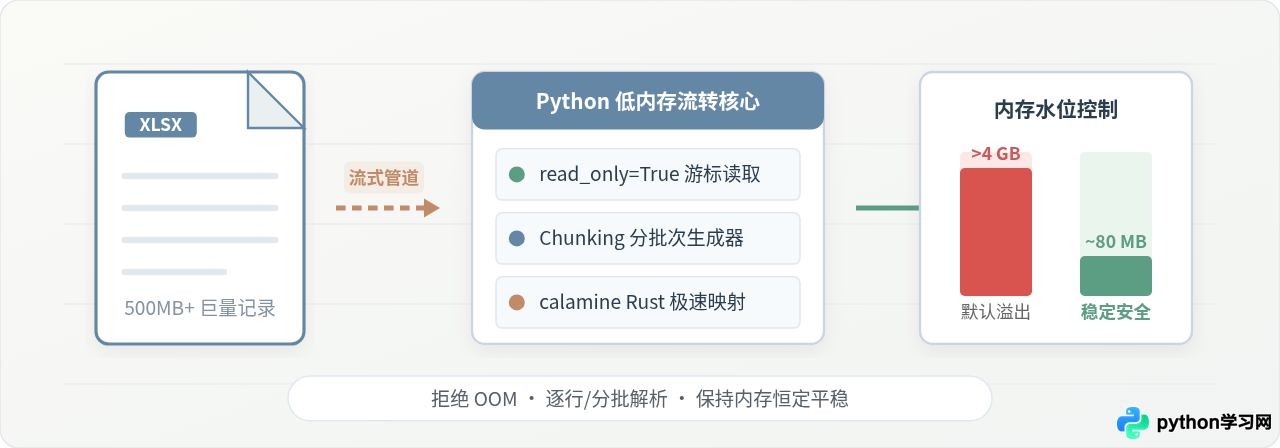
pandas.read_excel() 处理几十兆到上百兆的 Excel 文件时,进程往往会迅速耗尽数个吉字节(GB)的物理内存,甚至直接触发 MemoryError。这是因为 .xlsx 本质是压缩的 XML 包,默认解析引擎会建立完整的单元格树状模型(DOM),使内存产生数十倍的病态膨胀。解决该问题的关键是放弃一次性全量加载,改用流式解析(Streaming)与分块读取(Chunking):借助 openpyxl 的 read_only=True 逐行游标、构建 DataFrame 批处理生成器,或换用基于 Rust 的极速引擎 calamine,使内存平稳锁定在可控的安全区间。
一、为什么超大 Excel 极易导致内存溢出?
很多开发者在首次遇到内存溢出时都会产生疑问:“我的 .xlsx 文件在磁盘上只有 150MB,服务器有 16GB 内存,为什么调用 pd.read_excel('data.xlsx') 后瞬间报出 MemoryError 甚至导致进程被系统 OOM Killer 强行终止?”
要彻底解决这个问题,必须先理解 .xlsx 文件的底层组织形式以及常规解析库的运作方式:
- 高度压缩的 XML 归档包:
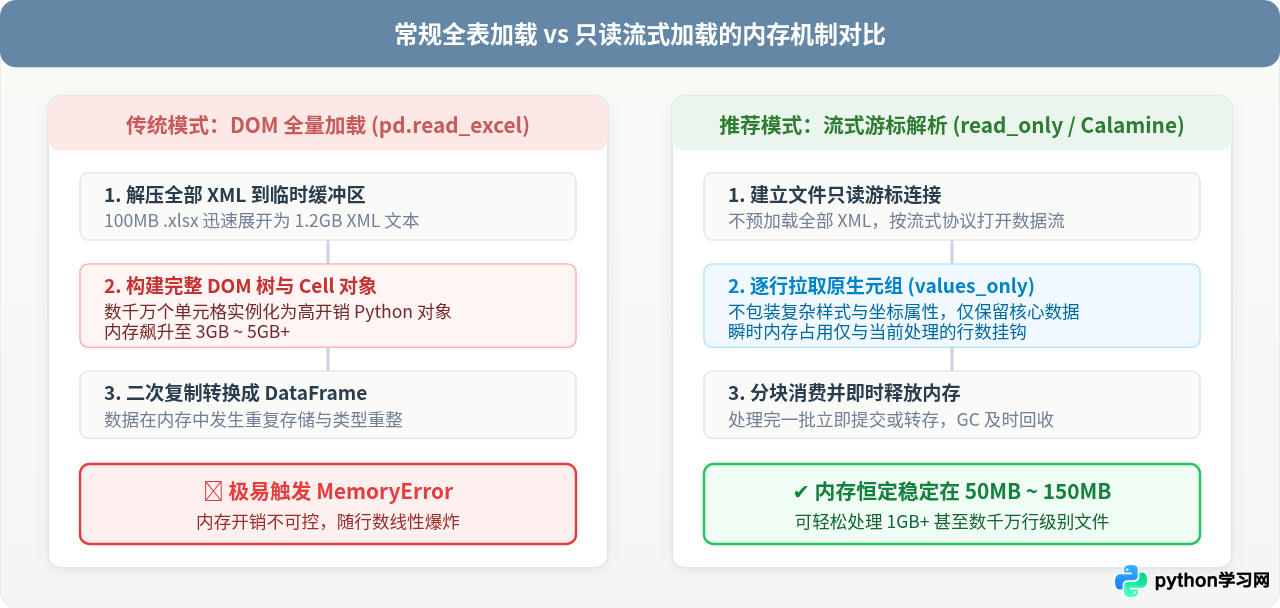
.xlsx格式并不是纯文本或二进制矩阵,而是一个符合 OpenXML 标准的 ZIP 压缩包。解压该文件后,核心数据存放在xl/worksheets/sheet1.xml以及用于去重的共享字符串表xl/sharedStrings.xml中。在磁盘上 100MB 的文件,解压后的纯文本 XML 体积通常会迅速膨胀到 1GB 至 2GB。 - 庞大的 Python 单元格对象开销:Pandas 默认的读取引擎是
openpyxl。在默认模式下,openpyxl会在内存中为整个工作表构建完整的文档对象模型(DOM Tree)。每一个单元格不仅仅是一个数值,而是一个完整的Cell实例,内部封装了行号、列号、数据类型、字体样式、单元格对齐及格式化规则。一个包含数百万行、几十列的数据集,在内存中会实例化数千万个 Python 对象,产生高达 20 至 40 倍的内存放大效应。 - 缺少内建的流式切片支持:与读取 CSV 时的
pd.read_csv(..., chunksize=10000)不同,Pandas 的pd.read_excel()并不能原生直接支持chunksize参数来进行分批惰性迭代。如果不改变读取策略,它必定会先在内存中构筑完整的中间结果。
二、方法一:使用 openpyxl 只读模式逐行流式解析
在不需要复杂统计计算、只需要遍历行做数据校验、入库或写出到其他文件的场景下,最轻量可靠的方式是直接使用 openpyxl 的 read_only=True 模式。
在开启 read_only=True 之后,openpyxl 会切换到底层 XML 流式拉取机制,避免在内存中构建工作表树,内存占用将从与总行数成正比降为与单行数据量成正比。
from openpyxl import load_workbook

def stream_large_excel(file_path, sheet_name=None):
    # 核心:开启 read_only=True 与 data_only=True
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)

    try:
        ws = wb[sheet_name] if sheet_name else wb.active

        # iter_rows(values_only=True) 直接生成纯 Python 元组,不构造 Cell 对象
        for row_idx, row_values in enumerate(ws.iter_rows(values_only=True), start=1):
            if row_idx == 1:
                header = row_values
                continue

            # 业务逻辑:例如过滤出金额大于 1000 的记录
            if row_values[0] is not None:
                yield dict(zip(header, row_values))
    finally:
        # 只读模式下必须显式调用 close(),释放底层解压文件句柄与网络/系统资源
        wb.close()

# 消费示例
for record in stream_large_excel("very_large_dataset.xlsx"):
    # 逐条写入数据库,内存全程保持平直
    insert_to_db(record)
关键参数细节:data_only=True 会直接提取公式计算后的缓存数值,而不是公式文本;values_only=True 会直接产出原生 Python 类型的元组(tuple),省去数百万次单元格对象的创建。需要特别注意:只读模式下的行迭代器是单向向前的,不支持随机切片或倒退访问。
三、方法二:封装 Excel 分块读取生成器(结合 Pandas 批处理)
多数实际业务既需要处理海量数据,又离不开 Pandas 强大的矢量化运算、数据清洗以及现成的 df.to_sql()。由于 pd.read_excel 缺乏原生的 chunksize 支持,我们可以通过 itertools.islice 搭配 openpyxl(read_only=True),自行封装一个生产级分块生成器。
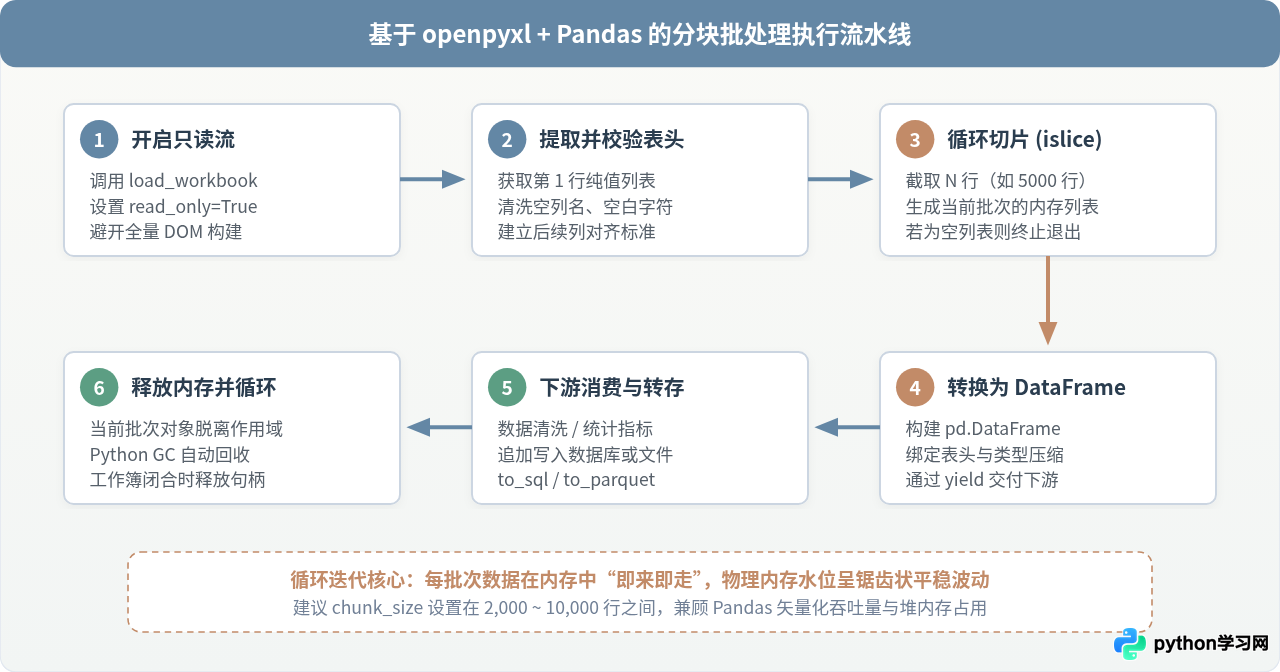
下面是封装完整的通用分块读取工具函数:
import itertools
import pandas as pd
from openpyxl import load_workbook

def read_excel_in_chunks(file_path, sheet_name=None, chunk_size=5000):
    """
    分块流式读取超大 Excel 文件,每次产出一个指定行数的 DataFrame。
    :param file_path: Excel 文件完整路径
    :param sheet_name: 工作表名称,默认为首个活动表
    :param chunk_size: 每个批次的行数(推荐 2000-10000)
    """
    # 建立只读工作簿流
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    ws = wb[sheet_name] if sheet_name else wb.active

    row_stream = ws.iter_rows(values_only=True)

    try:
        # 提取首行作为列名并规整化
        header_row = next(row_stream)
        headers = [
            str(col).strip() if col is not None else f"Unnamed_{i}"
            for i, col in enumerate(header_row)
        ]

        while True:
            # 使用 islice 截取 chunk_size 行数据
            batch = list(itertools.islice(row_stream, chunk_size))
            if not batch:
                break

            # 组装为轻量 DataFrame 产出
            df_chunk = pd.DataFrame(batch, columns=headers)
            yield df_chunk

    finally:
        wb.close()

# 生产调用方式:
if __name__ == "__main__":
    total_processed = 0
    for chunk in read_excel_in_chunks("million_rows_data.xlsx", chunk_size=5000):
        # 下游批处理操作(例如写入数据库表)
        chunk.to_sql("target_table", con=engine, if_exists="append", index=False)
        total_processed += len(chunk)
        print(f"已安全处理累计行数: {total_processed}")
效果说明:无论 Excel 文件包含 50 万行还是 200 万行,任何时刻停留在内存中的都只有当前批次的 5000 个元组和对应的单个临时 DataFrame。在 Python 垃圾回收机制下,内存水位始终呈现均匀的锯齿形态,彻底远离 MemoryError。
四、方法三:换用 Rust 编写的高性能引擎 calamine
如果服务器本身的物理内存还算宽裕,但希望依然一次性读入完整的 DataFrame,同时解决 Pandas 默认 openpyxl 引擎解析过慢、内存翻倍过于剧烈的问题,换用 calamine 引擎是最理想的方案。
calamine 是用 Rust 开发的极速 Excel 读写库,通过 python-calamine 提供 Python 绑定。从 Pandas 2.1.0 开始,官方正式将其收录为原生支持的解析引擎:
# 1. 终端安装支持库
pip install python-calamine

# 2. Python 代码中直接指定 engine="calamine"
import pandas as pd

df = pd.read_excel("large_data.xlsx", engine="calamine")
calamine 的优势来自 Rust 原生层面的内存连续分配与零拷贝反序列化,规避了 Python 虚拟机的对象分配开销。在实际测试中,针对 100MB~200MB 的 .xlsx 文件:
- 解析耗时:通常相比
openpyxl提速 3 到 6 倍; - 峰值内存:相比
openpyxl降低约 40% ~ 65%,有效降低了单表加载时的内存峰值压力。
五、超大 Excel 读取的关键优化与避坑指南
除了解析引擎与流式控制,以下四个细节也是避免生产环境内存溢出必须考虑的因素:
1. 仅加载必要列(Projection Filtering)
许多超大表格往往包含数十个甚至上百个字段,但业务实际只需要其中三四个字段。若全量载入,大量冗余列会平白吞噬宝贵内存。
- 在
pd.read_excel(..., usecols=["ID", "Amount", "Status"])中显式传入usecols; - 在自定义流式遍历中,通过获取目标列的索引位置,仅提取对应下标的值:
tuple(row[i] for i in needed_indices)。
2. DataFrame 字段类型降级(Downcasting)
Pandas 默认会将整型识别为 64 位的 int64,浮点型识别为 float64,字符串识别为 object。对数据类型进行合理瘦身,能将内存占用再压缩 50% 以上:
def optimize_dtypes(df):
    for col in df.columns:
        col_type = df[col].dtype
        if col_type == 'int64':
            df[col] = pd.to_numeric(df[col], downcast='integer')
        elif col_type == 'float64':
            df[col] = pd.to_numeric(df[col], downcast='float')
        elif col_type == 'object':
            # 若重复值较多,转为 category 类型
            if df[col].nunique() / len(df[col]) < 0.5:
                df[col] = df[col].astype('category')
    return df
3. 注意 Shared Strings 陷阱
如果某个超大 Excel 文件包含数百万行互不重复的散列字符串(如雪花算法生成的长订单号或 UUID),Excel 内部的 xl/sharedStrings.xml 文件体积可能会非常大。即便是只读模式,由于解析器需要维护一个全局字符串映射表,内存依然会有一定程度的基础消耗。
4. 架构源头建议:从格式设计上规避
Excel 格式的设计初衷是用于桌面办公人员的数据交互与报表审阅,而不是作为大数据量流水表的持久化介质。单表超过 100 万行会触及 Excel 的规范上限(1,048,576 行)。
如果系统需要频繁与上游系统交换数百万行数据,最根本的解决之道是协调上游直接导出 CSV、TSV,或面向分析的压缩列存格式 Parquet。
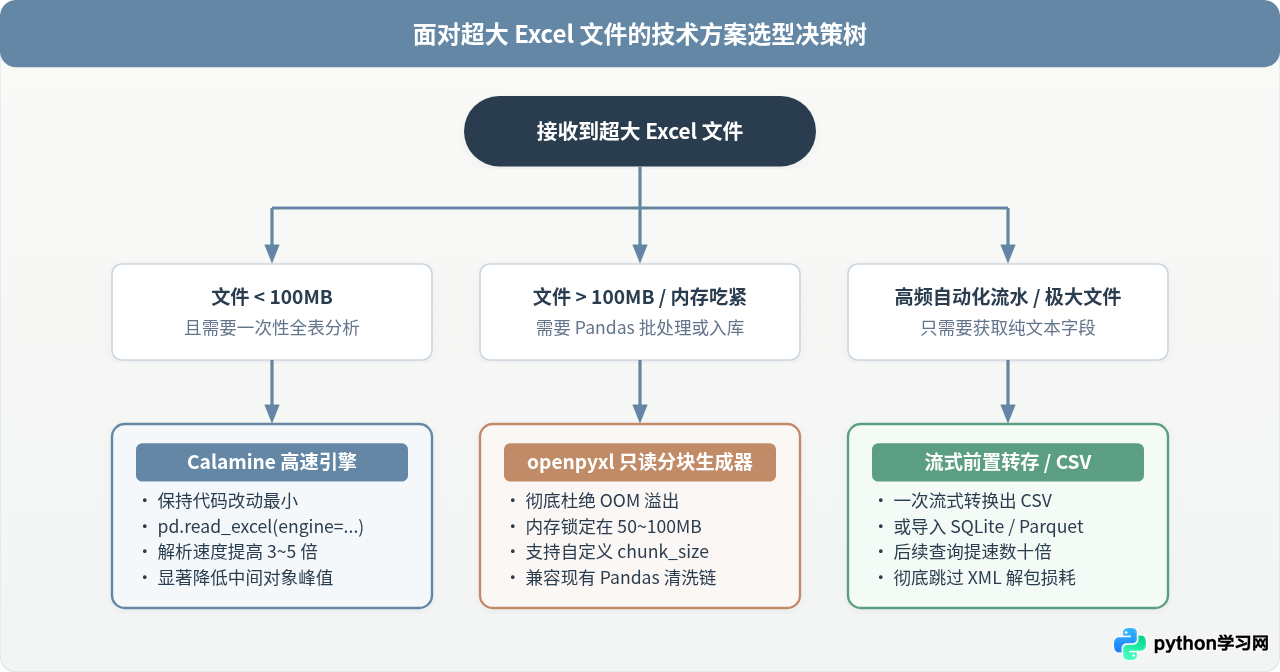
六、方案综合特性与选型总结
综合前文介绍的三种方案以及底层转存策略,它们的性能表现、内存压力及适配场景对比如下:
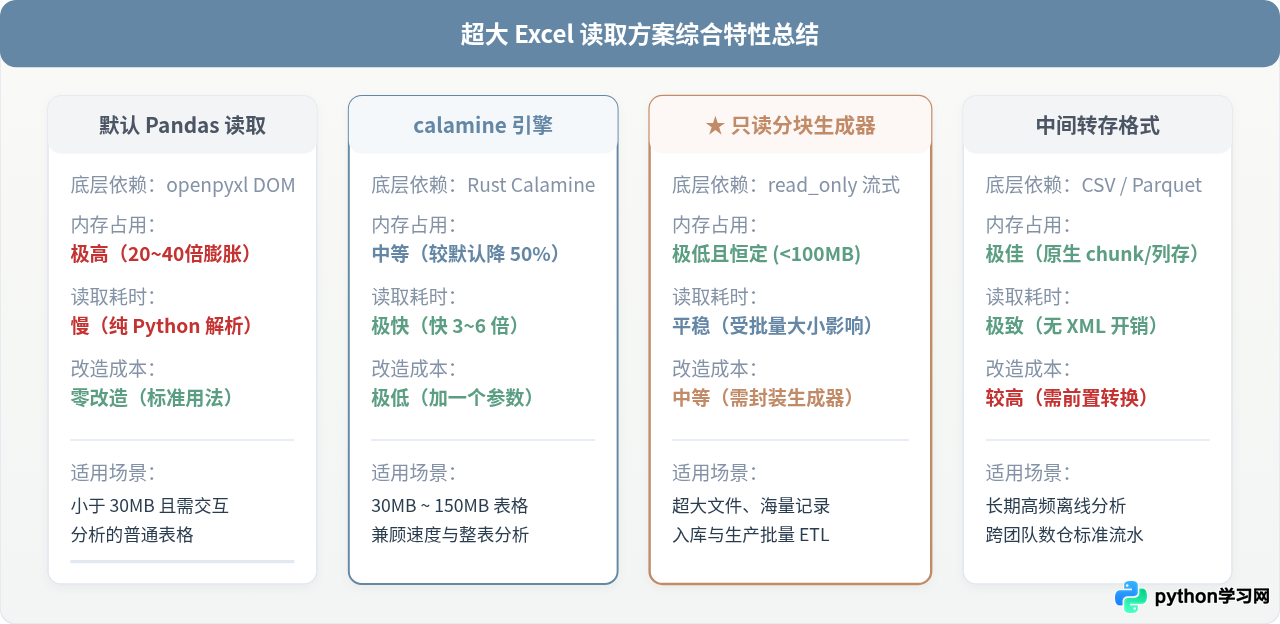
总结而言,避免 Python 读取超大 Excel 文件导致内存溢出的最优路径为:
- 对于常规大小(50MB~150MB)且需要整表交互的数据集,优先安装
python-calamine,直接通过engine="calamine"获取数倍的读取速度与显著的内存降低。 - 对于数百兆以上、百万级记录或受限的服务器环境,采用
openpyxl(read_only=True)结合生成器进行分块提取 是最标准、最稳定的做法,能以恒定几十兆的内存开销游刃有余地完成批处理与入库。 - 对于定期高频的数据流水,推动数据源流式转存为 CSV 或 Parquet,从根本上摆脱 OpenXML 协议复杂的解压与解析负担。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









