

Python bisect模块用法:高效实现有序列表二分查找

在 Python 中检索列表元素时,常用的 in 关键字或 list.index() 方法采用的是线性顺序扫描,时间复杂度为 \(O(n)\)。当数据规模达到数十万甚至数千万级别时,频繁的线性查找会成为系统性能的严重瓶颈。Python 标准库自带的 bisect 模块基于二分查找(Binary Search)算法实现,能够在 \(O(\log n)\) 的对数时间复杂度内,精确确定目标值在有序列表中的定位与插入索引。本文将从底层机制、核心函数辨析、实战应用范式到性能权衡展开具体讲解,帮助你在实际开发中规范运用该模块。
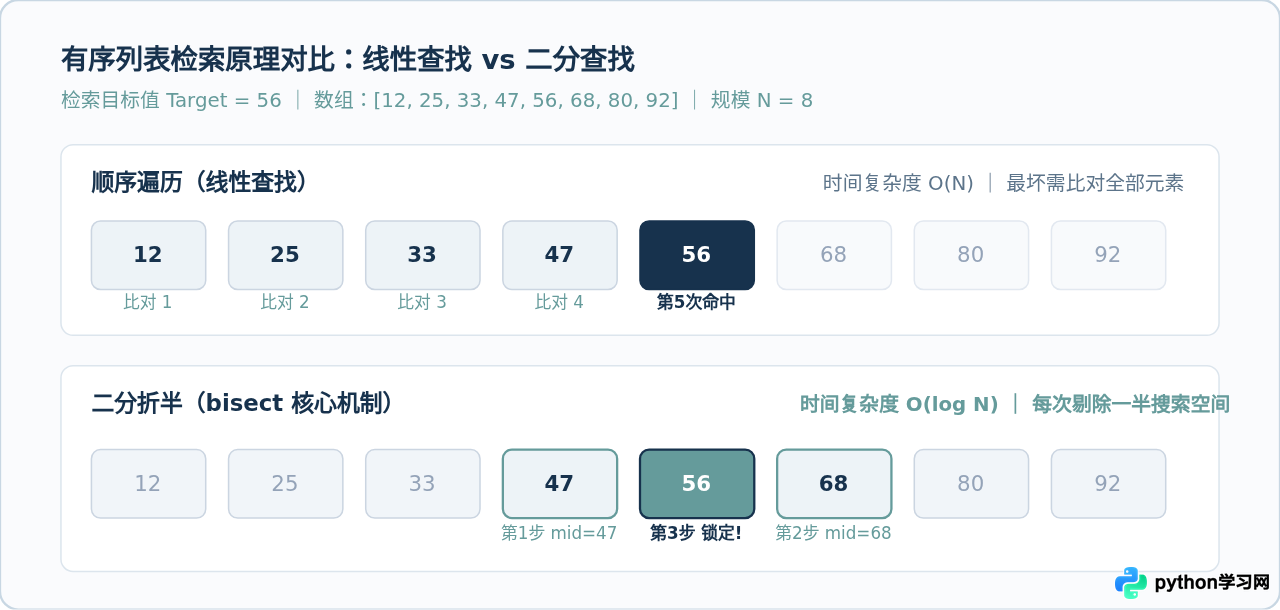
一、核心原理:线性查找与二分折半机制对比
二分查找的核心前提是:被检索的目标序列必须预先保持升序排列。在有序数组中,算法每次取区间中点元素(mid)与目标值比对,根据比对结果直接排除左半区或右半区,使得剩余的候选区间在每轮迭代中减半。对于包含 1,000,000 个元素的有序序列,线性查找最坏需要比较 1,000,000 次,而二分查找最多只需比较 20 次即可锁定位置。
二、核心函数辨析:bisect_left 与 bisect_right
在 Python 中引入该模块只需执行 import bisect。该模块最基础的两个定位函数是 bisect_left 与 bisect_right。当目标元素在列表中不存在时,两者的返回值完全相同,都表示该元素插入后仍能保持序列有序的位置索引;但当列表中存在重复的目标值时,两者表现出不同的边界行为:
- bisect_left(a, x):返回目标值 \(x\) 应当插入的最左侧索引。若序列中已有值等于 \(x\) 的元素,该索引位于所有现有重复值的左侧(即第一个相等元素的下标)。
- bisect_right(a, x)(别名 bisect(a, x)):返回目标值 \(x\) 应当插入的最右侧索引。若序列中已有值等于 \(x\) 的元素,该索引位于所有现有重复值的右侧(即最后一个相等元素下一个位置)。
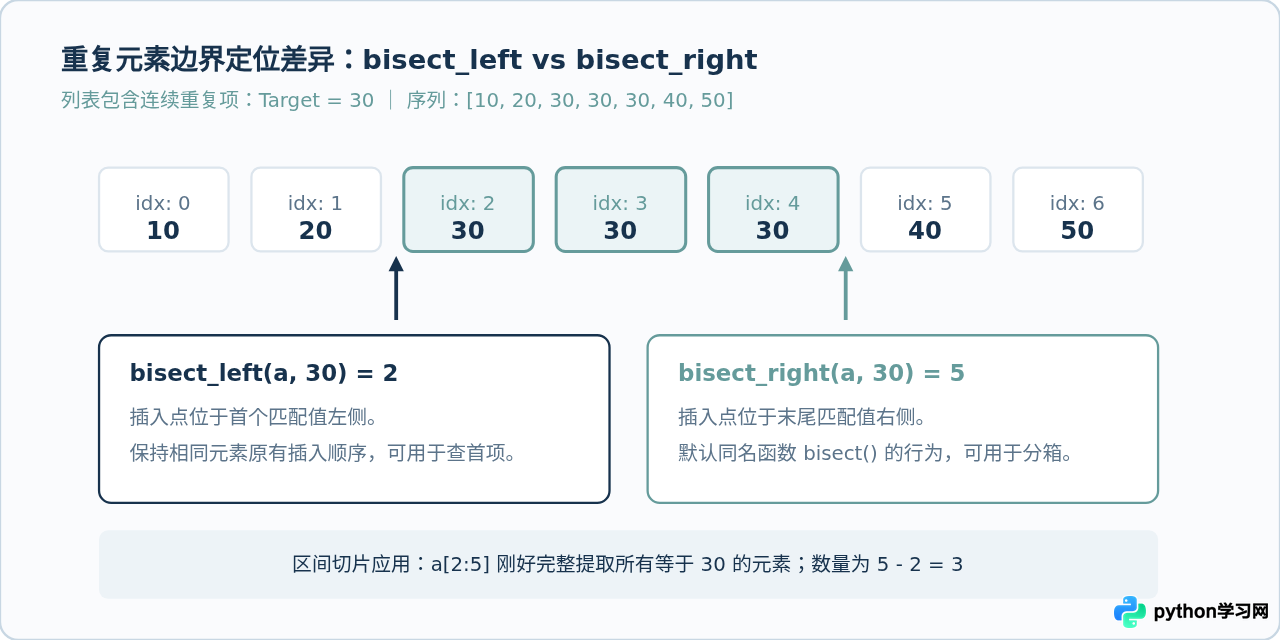
通过下方 Python 代码可以直观检验上述行为:
import bisect

data = [10, 20, 30, 30, 30, 40, 50]

# 查找左边界
left_idx = bisect.bisect_left(data, 30)
# 查找右边界(bisect 为 bisect_right 的别名)
right_idx = bisect.bisect_right(data, 30)

print(f"bisect_left 返回索引: {left_idx}")    # 示例输出: 2
print(f"bisect_right 返回索引: {right_idx}")  # 示例输出: 5
print(f"目标值出现次数: {right_idx - left_idx}") # 示例输出: 3
三、插入操作:insort_left 与 insort_right 及其性能特征
除了只读查询索引外,bisect 还提供了将元素实际插入列表的快捷方法:insort_left 与 insort_right(别名 insort)。它们内部执行的逻辑相当于两步:先通过 bisect_* 定位索引,紧接着调用 list.insert(index, item) 将元素插入。
import bisect

scores = [85, 90, 95]

# 插入 90,insort 默认使用 right 策略插入在已有 90 的右侧
bisect.insort(scores, 90)
print(scores) # 示例输出: [85, 90, 90, 95]insort 定位插入位置的时间复杂度是 \(O(\log n)\),但 Python 原生 list 是基于连续内存布局的动态数组。在数组中间执行 insert() 操作时,需要将插入点之后的所有元素向后内存拷贝搬移,此步骤的时间复杂度是 \(O(n)\)。因此,insort 的整体时间复杂度依然是 \(O(n)\)。如果在循环中向包含百万级元素的列表中频繁插入单个数据,整体性能会急剧退化;对于此类高频随机插入需求,建议优先考虑堆结构(heapq)或第三方平衡树(如 sortedcontainers.SortedList)。
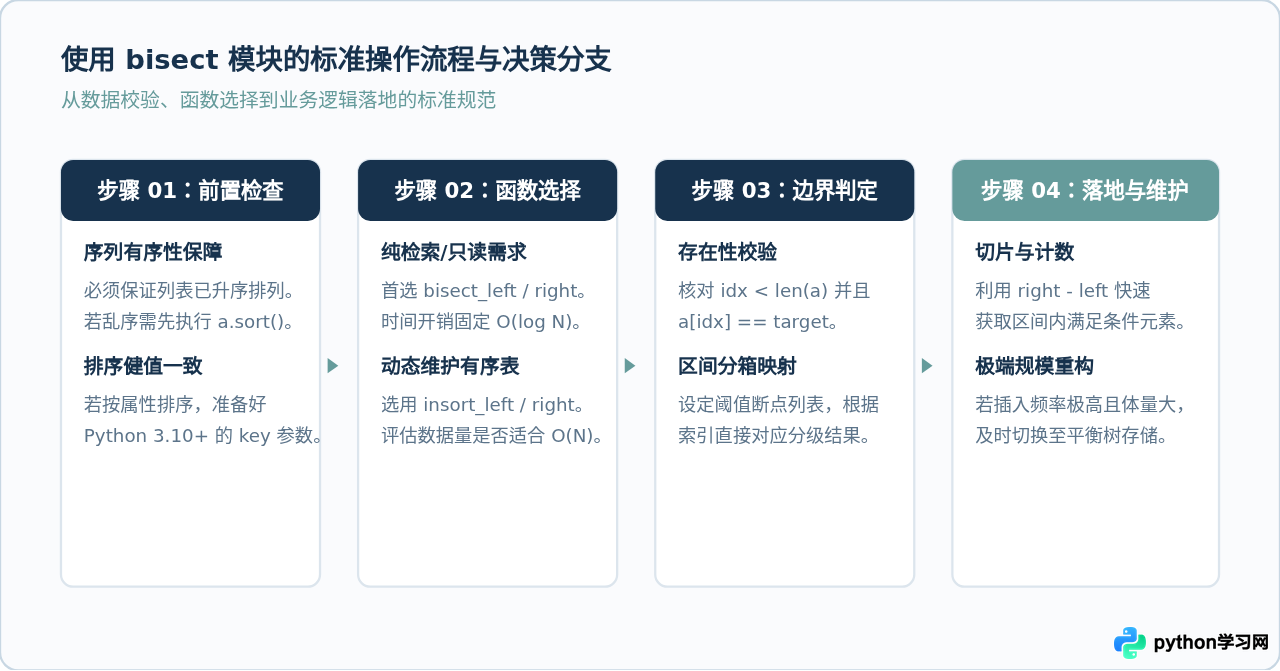
四、标准使用与决策工作流
在实际业务中应用 bisect 模块时,应遵循规范的前置校验与分支选择路径,以避免逻辑隐患。
五、三大典型实战场景与完整代码示例
场景 1:实现 O(log n) 的精确存在性查找
原生 bisect 返回的是“适合插入的位置”,哪怕元素不存在也不会抛出 ValueError。若需将其作为精确查找函数使用,只需额外比对对应下标的元素值:
import bisect

def binary_search_index(sorted_list, target):
    """
    在有序列表中查找目标元素,若存在返回其首个下标,不存在则返回 -1
    """
    idx = bisect.bisect_left(sorted_list, target)
    if idx < len(sorted_list) and sorted_list[idx] == target:
        return idx
    return -1

numbers = [15, 28, 42, 56, 73, 91]
print(binary_search_index(numbers, 42))  # 示例输出: 2
print(binary_search_index(numbers, 50))  # 示例输出: -1
场景 2:区间断点分箱(替代多层 if-elif 逻辑)
在积分等级换算、成绩评定、阶梯水电费等业务中,通常需要判断某个数值落在哪个区间。利用 bisect 可以在一行代码内优雅替代嵌套分支:
import bisect

def get_grade(score, breakpoints=(60, 70, 80, 90), grades=('F', 'D', 'C', 'B', 'A')):
    """
    根据分数分箱确定等级:
    < 60: F; [60, 70): D; [70, 80): C; [80, 90): B; >= 90: A
    """
    # bisect_right: 当正好达到断点(如 90)时,返回 4 对应 'A'
    idx = bisect.bisect_right(breakpoints, score)
    return grades[idx]

test_scores = [55, 60, 78, 89, 90, 100]
results = [get_grade(s) for s in test_scores]
print(results)  # 示例输出: ['F', 'D', 'C', 'B', 'A', 'A']
场景 3:Python 3.10+ 的 key 参数(复杂对象二分检索)
从 Python 3.10 开始,bisect 模块的所有函数均支持 key 关键字参数。这使得开发者无需提前单独解构出辅助列表,即可直接针对字典列表或类实例进行二分查找:
import bisect

# 包含字典对象的列表,已按 uid 严格升序排列
users = [
    {"uid": 1001, "name": "Alice"},
    {"uid": 1008, "name": "Bob"},
    {"uid": 1025, "name": "Charlie"},
    {"uid": 1050, "name": "David"}
]

# 在 Python 3.10+ 中直接指定 key 函数查找 uid=1025 的位置
target_uid = 1025
idx = bisect.bisect_left(users, target_uid, key=lambda user: user["uid"])

if idx < len(users) and users[idx]["uid"] == target_uid:
    print(f"匹配成功: {users[idx]['name']}")  # 示例输出: 匹配成功: Charlie
else:
    print("用户不存在")
六、关键注意事项与避坑指南
- 严禁在无序列表上使用 bisect:
bisect内部不会校验列表是否真正有序。如果在乱序列表上执行,函数不会报错,但会返回完全不可信的随机索引,造成严重的静默逻辑缺陷。 - 降序序列的检索方式:
bisect默认仅按递增(升序)规则比对。对于降序排列的列表,可以通过取相反数(如key=lambda x: -x)或借助反向切片进行处理。 - 列表切片与拷贝损耗:
bisect接受lo和hi参数来限制查找区间。需要限定检索范围时,应直接传递bisect.bisect_left(a, x, lo=2, hi=8),切勿写成bisect.bisect_left(a[2:8], x),因为切片会生成新列表导致额外 \(O(k)\) 的空间与时间开销。
七、总结
Python 的 bisect 模块是处理有序序列不可或缺的高效利器。在只读查询场景中,它能将传统线性扫描的耗时降低若干数量级,实现真正标准、低开销的 \(O(\log n)\) 折半检索;在复杂分段映射场景中,它提供了一种比冗长分支语句更加清晰紧凑的代码组织方式。理解 bisect_left 与 bisect_right 在面对重复值时的定位差异,并掌握原生动态数组在插入时的挪位开销,能帮助你在工程实践中做出更加严谨、高效的技术选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









