

Python实现冒泡排序与二分查找算法代码
详细讲解如何使用Python实现冒泡排序与二分查找两大基础算法,剖析算法原理、提供可直接运行的代码示例与优化方案,并展示从无序数据到高效检索的完整实践流程。
在算法学习中,冒泡排序与二分查找是两项非常基础且经常配合出现的算法技能。二分查找具备极高的查找效率,但它的使用前提是数据集必须处于有序状态;而冒泡排序作为直观易懂的交换排序方式,正好可以用来构建有序序列。本文将分别讲解两者的核心逻辑、给出规范完整的Python实现代码,并演示如何将两者串联以解决实际查找问题。
一、冒泡排序算法原理与Python实现
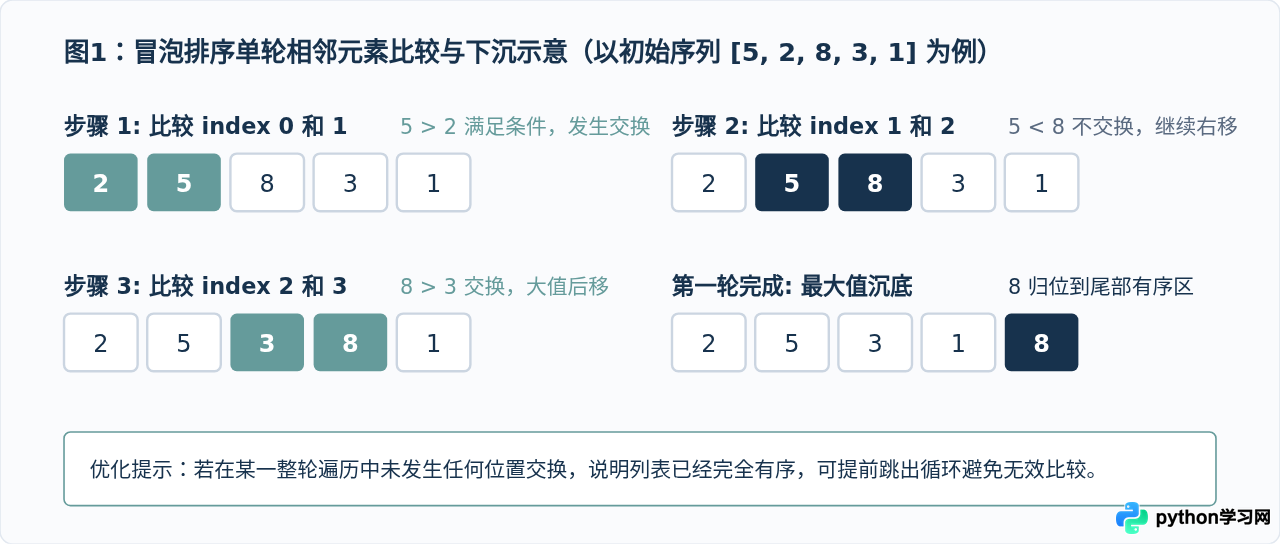
冒泡排序(Bubble Sort)的核心思想是:通过重复遍历待排序序列,依次比较相邻两项的值,如果前一项比后一项大,就交换两者的位置。每次遍历结束后,当前未排序区域中的最大数值就会“浮”到该区域的最右侧。重复该过程,直到整个列表完全有序。
1. 冒泡排序的基础与优化实现代码
常规冒泡排序无论列表最初状态如何,都会机械地完成 \(n-1\) 轮循环。我们可以在代码中加入一个 swapped 标志位进行优化。如果在某一轮循环中未发生任何交换,即可提前结束。
def bubble_sort(arr):
    """
    冒泡排序(带提前退出优化)
    :param arr: 待排序的数值列表
    :return: 原地排序后的列表
    """
    n = len(arr)
    # 外层循环控制需要执行的总轮数
    for i in range(n - 1):
        swapped = False
        # 内层循环比较相邻两个元素,尾部已排序的 i 个元素无需再比
        for j in range(0, n - 1 - i):
            if arr[j] > arr[j + 1]:
                # 交换相邻两个元素
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        # 如果本轮遍历没有发生任何交换,说明数组已经有序,提前结束
        if not swapped:
            break
    return arr

# 示例验证
sample_list = [64, 34, 25, 12, 22, 11, 90]
print("排序前:", sample_list)
sorted_list = bubble_sort(sample_list)
print("排序后:", sorted_list)
排序前: [64, 34, 25, 12, 22, 11, 90]排序后: [11, 12, 22, 25, 34, 64, 90]
二、二分查找算法原理与Python实现
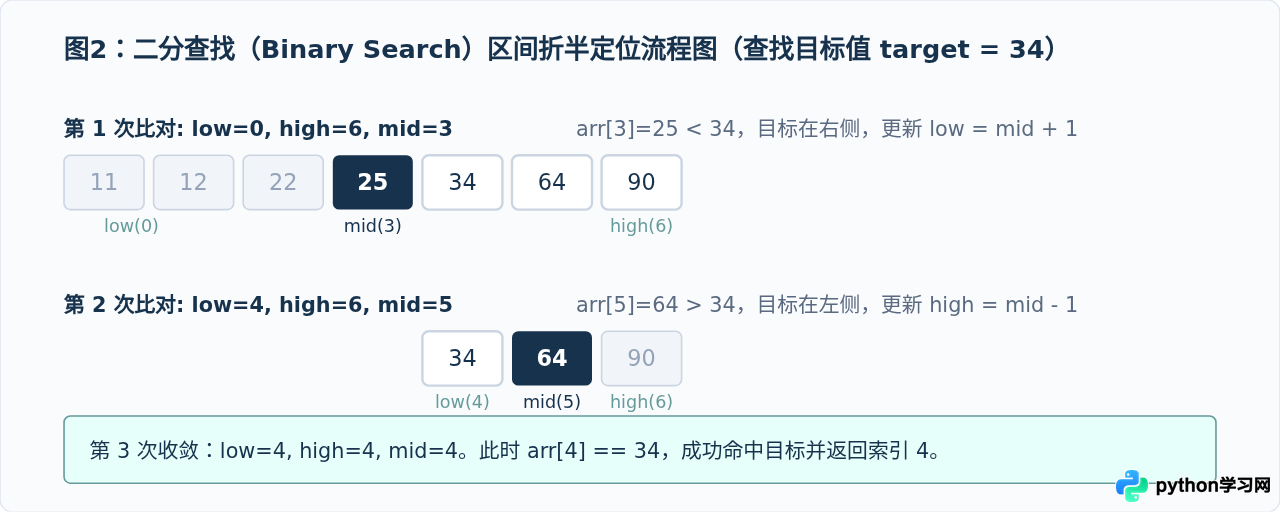
二分查找(Binary Search),又称折半查找。它的基本前提是:被查找的目标列表必须是有序的。算法通过将目标值与列表正中间的元素进行比对,若目标值小于中间值,则下一轮只需在左半区间搜索;若目标值大于中间值,则转向右半区间搜索。每次比对都可以排除一半的数据量,使得查找效率提升到对数级别。
1. 二分查找的循环实现代码
在工程实践中,通常优先使用迭代(循环)方式实现二分查找,相比递归方式具有更高的空间效率,避免了调用栈额外开销。
def binary_search(arr, target):
    """
    二分查找(迭代实现)
    :param arr: 升序排列的列表
    :param target: 待查找的目标数值
    :return: 目标在列表中的索引;若不存在则返回 -1
    """
    low = 0
    high = len(arr) - 1

    # 循环条件必须包含等于号,因为 low == high 时区间仍有一个元素需要判断
    while low <= high:
        # 计算中间索引,使用整除防止浮点转换
        mid = (low + high) // 2
        mid_val = arr[mid]

        if mid_val == target:
            return mid
        elif mid_val > target:
            # 目标在左半区,调整右边界
            high = mid - 1
        else:
            # 目标在右半区,调整左边界
            low = mid + 1

    # 循环退出仍未找到目标值
    return -1

# 示例验证(输入必须是有序列表)
sorted_demo = [11, 12, 22, 25, 34, 64, 90]
target_value = 34
result_idx = binary_search(sorted_demo, target_value)
print(f"查找目标 {target_value} 的结果索引: {result_idx}")
查找目标 34 的结果索引: 4
- 循环边界: 必须使用
low <= high,如果错写成low < high,当目标元素恰好位于边界或列表仅剩单一元素时,该元素将被遗漏跳过。 - 边界收缩: 更新时必须使用
mid - 1或mid + 1。如果直接写成high = mid,在特定输入下会导致死循环。
三、算法串联:先排序后查找的综合流水线
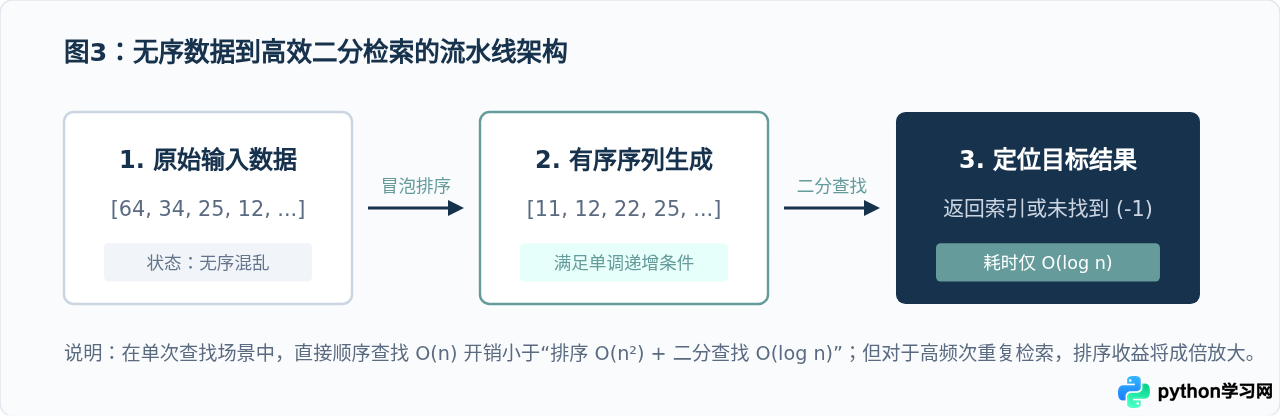
真实场景下接收到的业务数据往往是无序列表。如果直接对无序列表执行二分查找,会导致区间折半逻辑失效并产生错误判断。规范的做法是先对原始无序数据执行排序,再通过二分查找定位目标值。
1. 协同运行完整示例代码
以下代码展示了一个完整的业务逻辑:输入无序列表,先对其执行冒泡排序,随后通过二分查找检索多个目标值。
def bubble_sort(arr):
    n = len(arr)
    for i in range(n - 1):
        swapped = False
        for j in range(0, n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        if not swapped:
            break
    return arr


def binary_search(arr, target):
    low = 0
    high = len(arr) - 1

    while low <= high:
        mid = (low + high) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] > target:
            high = mid - 1
        else:
            low = mid + 1

    return -1


def search_in_unsorted_array(numbers, target):
    """
    针对无序数组的完整查找流水线
    """
    print(f"原始待处理列表: {numbers}")
    # 步骤 1:先使用冒泡排序进行升序排列
    sorted_numbers = bubble_sort(numbers)
    print(f"排序完成列表: {sorted_numbers}")

    # 步骤 2:对有序列表进行二分查找
    index = binary_search(sorted_numbers, target)
    if index != -1:
        print(f"成功找到目标 {target},位于有序列表索引: {index}")
    else:
        print(f"目标值 {target} 不存在于该列表中")
    return index


# 执行全流程测试
if __name__ == "__main__":
    dataset = [89, 45, 68, 90, 29, 34, 17]
    search_in_unsorted_array(dataset, target=29)
    print("-" * 40)
    search_in_unsorted_array(dataset, target=100)
原始待处理列表: [89, 45, 68, 90, 29, 34, 17]排序完成列表: [17, 29, 34, 45, 68, 89, 90]成功找到目标 29,位于有序列表索引: 1----------------------------------------原始待处理列表: [17, 29, 34, 45, 68, 89, 90]排序完成列表: [17, 29, 34, 45, 68, 89, 90]目标值 100 不存在于该列表中
四、算法特性对比与选型总结
为了加深对这两种经典算法的理解,我们将其时间复杂度、空间复杂度与典型适用场景整理归纳如下:
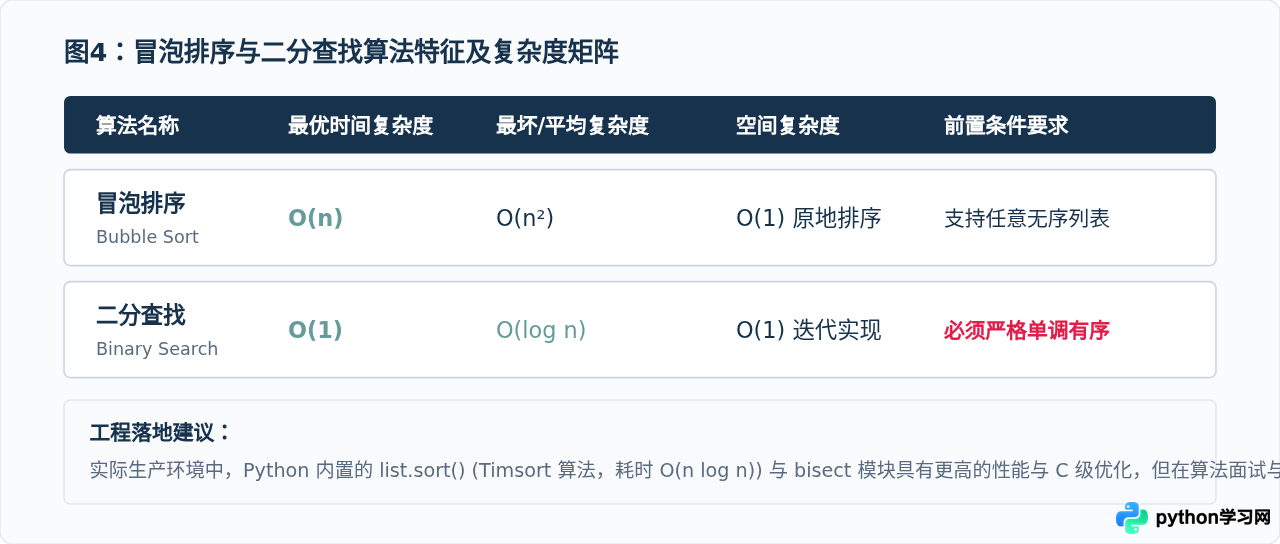
| 考量维度 | 冒泡排序(Bubble Sort) | 二分查找(Binary Search) |
|---|---|---|
| 核心目标 | 调整列表元素顺序,使其呈现递增或递减 | 在有序集合中快速定位目标值的元素索引 |
| 平均时间复杂度 | \(O(n^2)\) | \(O(\log n)\) |
| 空间复杂度 | \(O(1)\),仅需几个临时指针变量 | \(O(1)\)(迭代版本) / \(O(\log n)\)(递归调用栈) |
| 常见编写隐患 | 内层循环范围未减去已归位的 \(i\) 项导致多余计算 | 循环边界漏写等号,或中点指针未做偏移导致死循环 |
| 标准库对应工具 | list.sort() 或 sorted() |
标准库 bisect 模块(如 bisect_left) |
通过本文的推导、图示与代码实现,可以看出基础算法虽然结构简单,但对边界条件的把控要求极高。先利用排序算法将无序数据整理为有序结构,再通过对数复杂度的二分检索完成查询,是计算思维中最基础也是最实用的组合范式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









