

Python random.seed()的作用:怎么固定随机数序列以便复现
深入解析Python内置random.seed()函数的作用机制,详细讲解如何通过设置随机数种子固定生成序列以实现数据分析与自动化测试的可复现性,并涵盖独立实例与工程避坑指南。
random 生成的随机数并非来自物理世界的不确定性,而是由确定性数学算法推导出的“伪随机数”。random.seed() 的核心作用,就是为底层的伪随机数生成器指定一个固定的初始状态值(即种子)。只要种子相同、算法版本不变且调用顺序一致,随后产生的随机数序列就会分毫不差地完全重现。本文将具体阐明其工作原理、标准操作步骤、模块隔离技巧与关键注意事项。
一、random.seed() 为什么能固定随机序列:原理解析
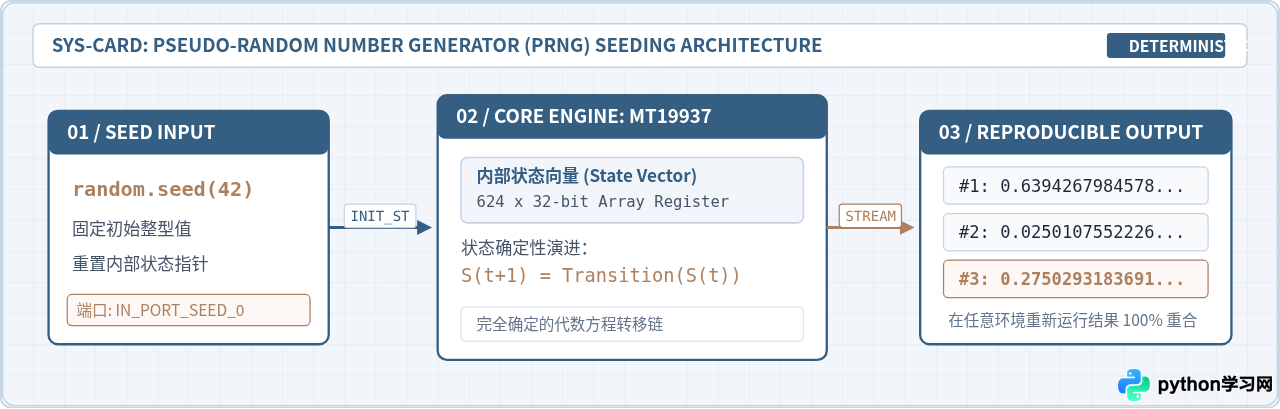
在深入掌握使用方法前,需要先厘清一个事实:Python 标准库 random 产生的数据不是真正意义上的不可预测物理随机,而是伪随机数(Pseudo-Random Number Generator, PRNG)。
Python 采用的是经典的 梅森旋转算法(Mersenne Twister, MT19937)。该算法的核心是一个包含 624 个 32 位无符号整数的状态向量(State Vector)和一个当前索引指针。
- 状态转移:每一次调用
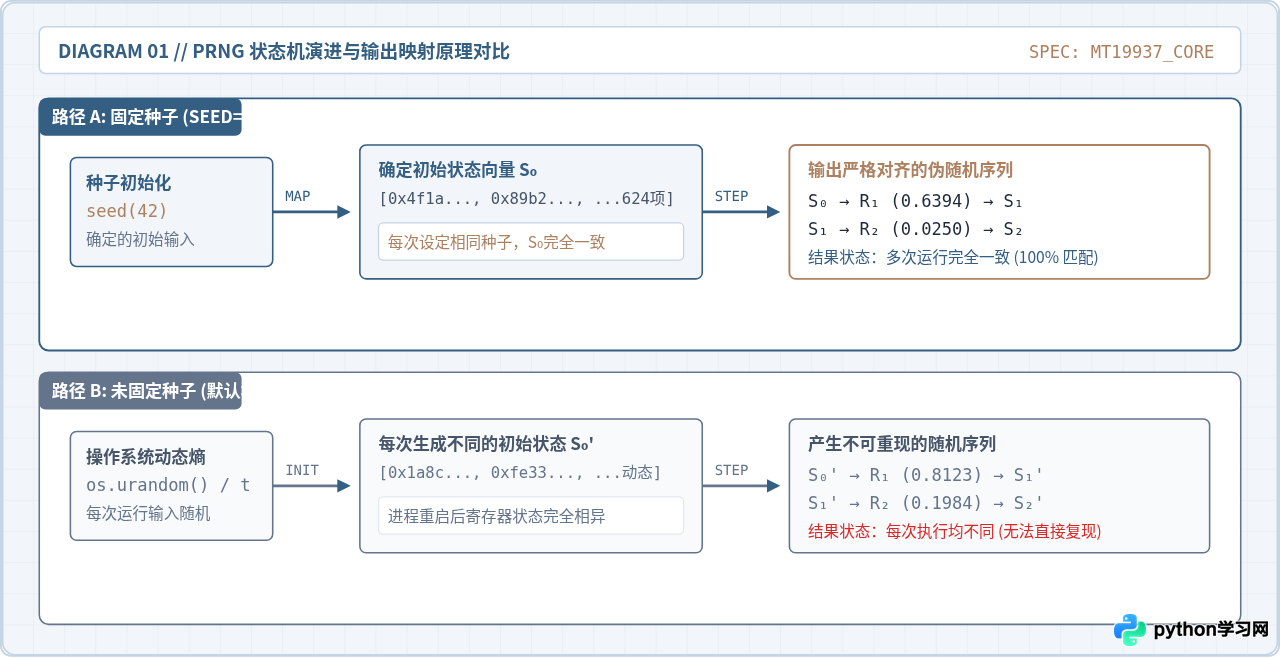
random.random()或random.randint(),生成器都会提取当前状态计算出一个随机数,同时通过固定的矩阵变换方程更新状态数组,并将指针移向下一个位置。 - 种子的角色:
random.seed(x)的作用,就是将给定的值(通常为整数)经过特定散列运算,映射并填满这 624 个内部状态寄存器。 - 如果不设种子:Python 在首次导入
random模块或调用未显式种子的随机函数时,默认会读取操作系统提供的熵源(如os.urandom())或高精度系统时间戳作为初始种子,因此每次启动程序产生的序列都不相同。
二、固定随机数序列的标准操作步骤与代码验证
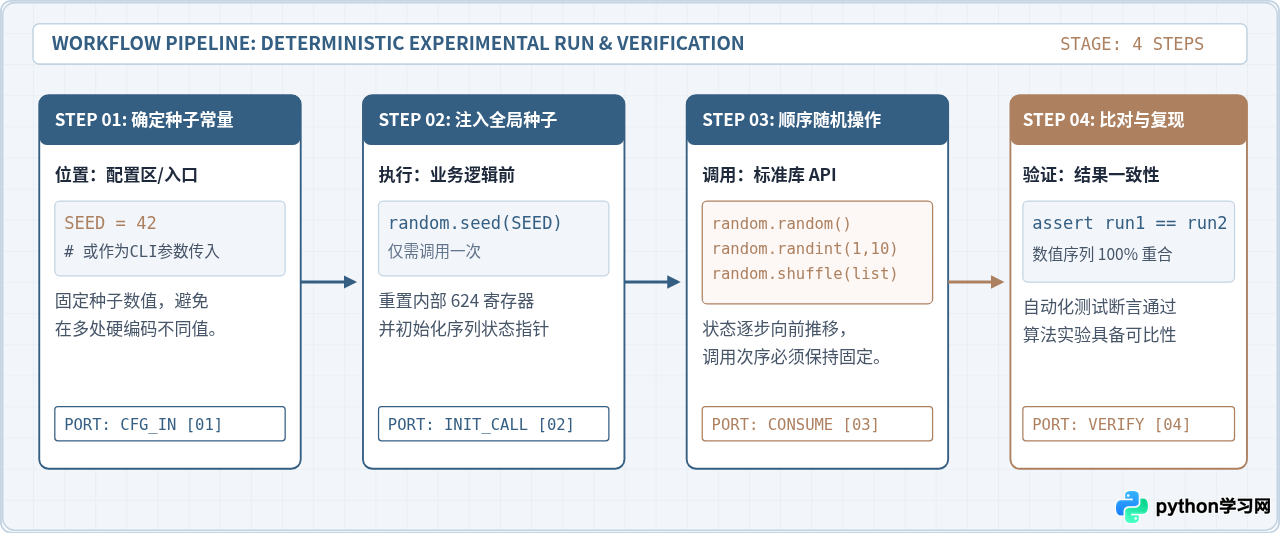
要实现结果可复现,必须在程序启动、实验开始或随机任务执行的最前端调用 random.seed()。以下是标准的操作闭环与验证流程:
完整代码示例:序列重现测试
以下脚本展示了如何使用 random.seed() 生成两轮完全相同的随机测试数据,包含浮点数、整型抽样以及列表乱序(shuffle):
import random

def generate_random_dataset():
    """按固定顺序调用一组随机操作,模拟数据生成流程"""
    numbers = [random.randint(10, 99) for _ in range(3)]
    floats = [round(random.random(), 4) for _ in range(2)]
    cards = ["A", "B", "C", "D", "E"]
    random.shuffle(cards)
    return {
        "numbers": numbers,
        "floats": floats,
        "shuffled_cards": cards
    }

# ----------------- 第一轮测试 -----------------
SEED_VALUE = 2026
print(f"--- 设定种子 SEED = {SEED_VALUE} ---")
random.seed(SEED_VALUE)
result_run_1 = generate_random_dataset()
print("Run 1 结果:", result_run_1)

# ----------------- 第二轮测试 -----------------
# 重新注入相同的种子,将 PRNG 内部状态指针复位到起点
print(f"\n--- 重新设定种子 SEED = {SEED_VALUE} ---")
random.seed(SEED_VALUE)
result_run_2 = generate_random_dataset()
print("Run 2 结果:", result_run_2)

# ----------------- 结果核验 -----------------
assert result_run_1 == result_run_2, "错误:两轮序列不匹配!"
print("\n[验证通过] 两次执行产生的数据结构与序列完全一致,实验成功复现。")Run 1 结果: {'numbers': [85, 34, 11], 'floats': [0.5517, 0.4495], 'shuffled_cards': ['D', 'E', 'B', 'A', 'C']}
--- 重新设定种子 SEED = 2026 ---
Run 2 结果: {'numbers': [85, 34, 11], 'floats': [0.5517, 0.4495], 'shuffled_cards': ['D', 'E', 'B', 'A', 'C']}
[验证通过] 两次执行产生的数据结构与序列完全一致,实验成功复现。
三、多模块与大型项目:避免全局单例状态污染
在简单的单文件脚本中,直接调用 random.seed() 非常便捷。但必须注意:random.seed() 修改的是 Python 进程中唯一的全局 Random 实例。
在大型项目、微服务或多线程程序中,如果另一个第三方库(例如日志轮询、重试退避算法等)在后台也调用了 random.randint(),它就会推移全局生成器的内部状态指针。这会导致你原本设计好的随机序列发生“错位”,使实验无法复现。
工程推荐做法:使用面向对象机制,创建私有的 random.Random 实例。
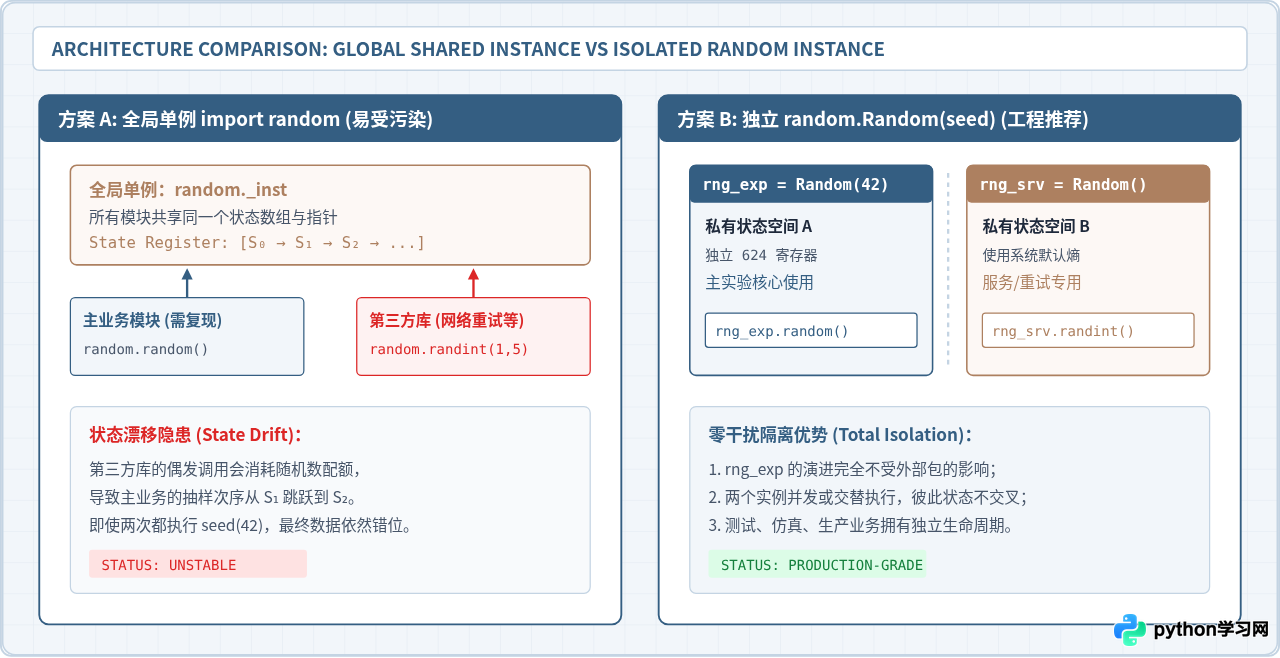
独立 Random 实例的实现代码
import random

# 创建独立的生成器实例,并传入指定种子
my_rng = random.Random(42)

# 所有随机操作通过该实例的方法完成
sample_1 = [my_rng.randint(1, 100) for _ in range(3)]
print("独立实例首次运行结果:", sample_1)

# 重置该实例的种子,状态复位
my_rng.seed(42)
sample_2 = [my_rng.randint(1, 100) for _ in range(3)]
print("独立实例二次运行结果:", sample_2)

assert sample_1 == sample_2
print("独立实例验证成功,不受全局 random 状态影响。")
四、常见误区与工程实践注意事项
在实际工程落地与调试过程中,以下几个高频误区极易造成非预期结果或严重的安全性问题:
1. 误在循环体内频繁调用 seed()
初学者容易将 random.seed(42) 写在循环体内部,本意是“让每次循环都可复现”,结果却导致每次循环生成的数字完全相同:
# 错误示范:每次循环重设相同的种子
bad_results = []
for _ in range(3):
    random.seed(42)
    bad_results.append(random.random())
# 输出将是 [0.6394, 0.6394, 0.6394],完全失去了随机分散性!

# 正确做法:在循环开始前设置一次种子
random.seed(42)
good_results = [random.random() for _ in range(3)]
# 输出是预期的 [0.6394, 0.0250, 0.2750],且多次运行整体可复现
2. 原生 random.seed() 无法控制第三方库(NumPy / PyTorch)
Python 标准库的 random.seed() 仅对内置 random 模块生效,完全无法影响 numpy.random 或 torch.manual_seed。
- 若涉及科学计算:需调用
numpy.random.seed(42) - 若涉及深度学习:需调用
torch.manual_seed(42),并在使用 GPU 时配置torch.cuda.manual_seed_all(42)
因为 Mersenne Twister 是确定性代数算法,在观察到 624 个连续生成的 32 位随机数输出后,攻击者可以通过逆向算法完全推导出内部全部 624 个寄存器的当前状态,从而预测未来产生的所有随机数。对于密码重置 Token、会话 Session ID、API 密钥等安全场景,必须使用 Python 标准库专门提供的 secrets 模块(如 secrets.token_hex())或 os.urandom()。
五、快速决策与应用策略总结
为了帮助你在不同的业务需求中快速做出正确的架构选型,可以参考下述的技术选型决策图谱:
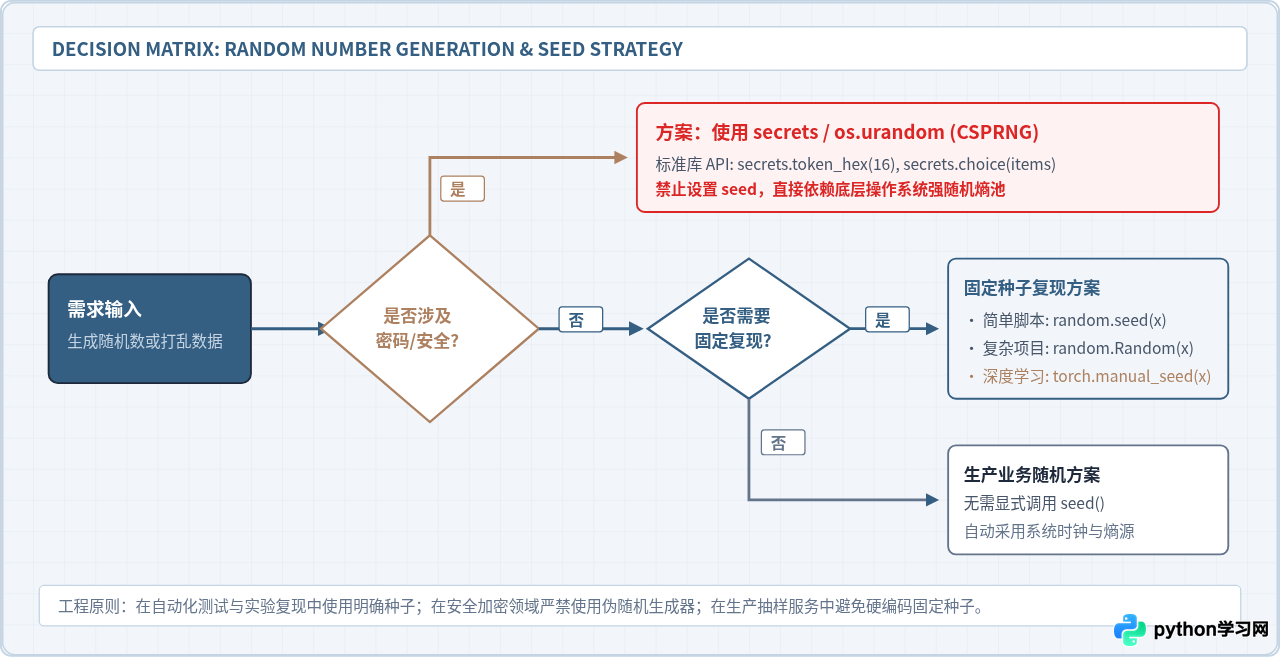
核心总结对照表
| 应用场景 | 推荐做法 | 核心目的 | 注意事项 |
|---|---|---|---|
| 单脚本算法实验 / 练习 | 在文件最顶部调用 random.seed(常量) |
锁定算法输出,便于多次比对分析 | 切勿把 seed 写入循环体内 |
| 单元测试 / CI 流程 | 为测试用例注入固定种子 | 确保随机输入下的断言百分百稳定 | 测试失败时可直接按该种子排查 Bug |
| 大型多模块工程 / 并发框架 | 实例化独立 random.Random(种子) |
避免被第三方库的随机调用污染内部状态 | 各工作线程或组件持有专属实例 |
| NumPy / PyTorch 数据流水线 | 分别调用对应库的专属 seed 函数 | 控制多维矩阵运算与神经网络权重初始化 | 标准库 random.seed() 对其不生效 |
| 密码、Token、支付鉴权 | 使用 secrets 模块,严禁使用 random |
防止内部状态寄存器被逆向还原与预测 | 物理安全熵,绝不可设置固定种子 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









