

Python random模块常用函数及用法详解

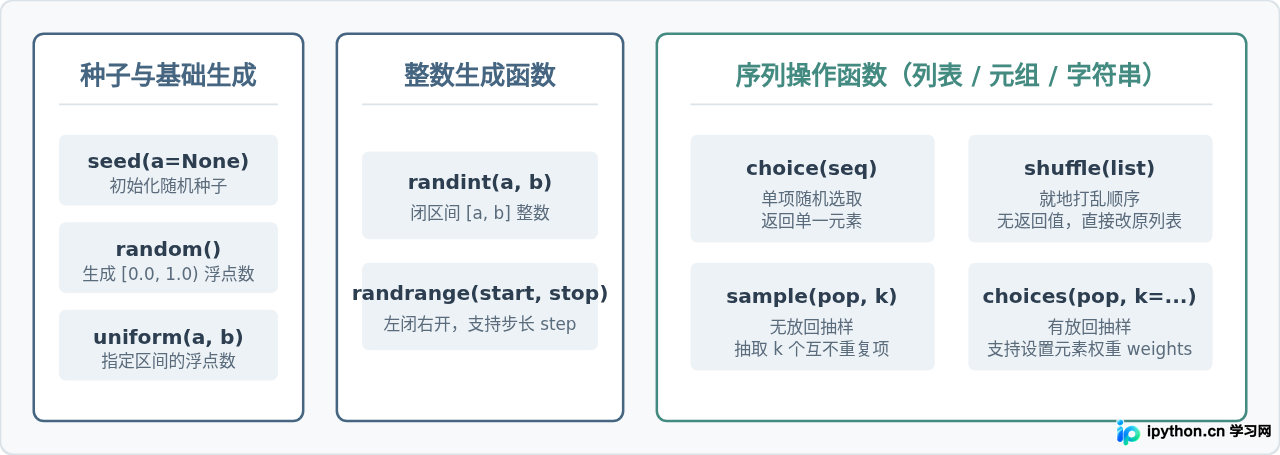
Python的内置random模块基于梅森旋转算法(Mersenne Twister)实现,提供了生成随机整数、随机浮点数以及对序列进行随机选取和乱序的一整套工具。本文将梳理该模块中最常用的核心函数,解释它们各自的参数边界与使用场景,并说明如何通过随机种子控制测试结果,以及在密码学与敏感数据场景下的安全限制。
一、伪随机数机制与 random.seed()
计算机生成的随机数绝大多数属于“伪随机数”(Pseudo-random Numbers)。其底层是通过特定的数学算法(Python 使用的是 19937 周期的梅森旋转算法)依据一个初始值连续推导出的数值序列。这个初始值被称为“随机种子”(Seed)。
如果种子固定,算法后续生成的每一步随机数序列都是完全确定的。默认情况下,Python 会在加载模块时使用操作系统的熵源(或当前系统时间戳)初始化种子,因此每次启动程序时生成的数值都不相同。
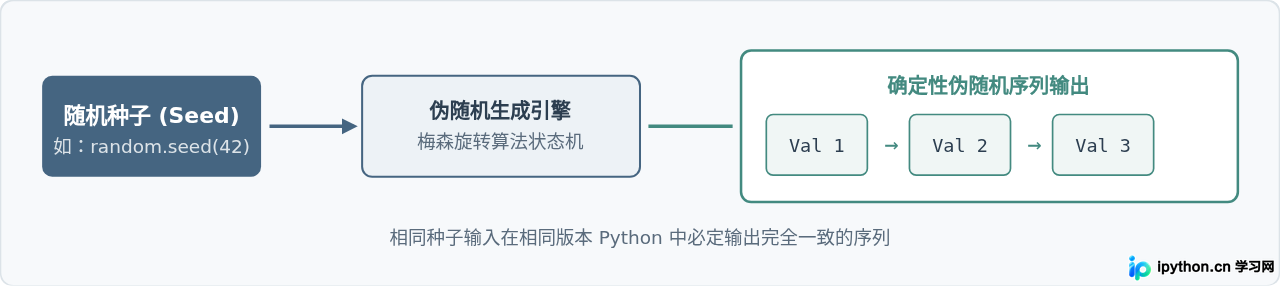
在单元测试、算法调试或数据科学实验中,固定随机种子能确保每次运行代码得到完全相同的输出结果,便于问题复现与验证:
import random

# 设置固定种子
random.seed(2026)
val_a = random.randint(1, 100)

random.seed(2026)
val_b = random.randint(1, 100)

print(val_a == val_b)  # 输出为 True,两次生成的整数完全一致
二、生成随机数字(浮点数与整数)
1. random.random() 与 random.uniform(a, b)
random.random() 是该模块的基础底层函数,不接受任何参数,返回一个在半开区间 [0.0, 1.0) 内的随机浮点数(包含 0.0,但不包含 1.0)。
random.uniform(a, b) 用于获取指定范围内的浮点数。其边界遵循算式 a + (b - a) * random(),这意味着结果始终落在 [a, b](或 [b, a])之间。在浮点舍入精度边界上,终点 b 理论上有可能被取到。
import random

# 生成 0 到 1 之间的概率值
rate = random.random()
print("基础浮点:", rate)  # 示例输出: 0.742819283719

# 生成指定区间的浮点数(支持倒序输入)
temp = random.uniform(18.5, 26.0)
print("随机温度:", temp)  # 示例输出: 23.4182910293
2. random.randint(a, b) 与 random.randrange()
生成随机整数时,最容易产生混淆的是 randint 与 randrange 在边界定义上的不同:
random.randint(a, b):闭区间。生成的整数满足a <= N <= b,两端参数均可被取到。内部直接调用了randrange(a, b + 1)。random.randrange([start,] stop[, step]):左闭右开区间。行为与 Python 内置的range()完全一致,生成的数值严格小于stop。支持通过step指定步长。
import random

# 模拟掷骰子(1 到 6 均可能出现)
dice = random.randint(1, 6)
print("骰子点数:", dice)

# 生成 0 到 99 之间的偶数(右侧开区间,步长为 2)
even_num = random.randrange(0, 100, 2)
print("随机偶数:", even_num)
编写索引访问代码时(如通过随机数获取列表下标),推荐使用 randrange(len(lst)) 而非 randint(0, len(lst)),后者会导致 IndexError: list index out of range。
三、序列操作函数(选取、抽样与打乱)
1. 单项选取:random.choice(seq)
choice 从非空序列(列表、元组、字符串)中随机返回一个元素。若传入的序列为空,将直接抛出 IndexError。
import random

fruits = ["苹果", "香蕉", "橙子", "西瓜"]
picked = random.choice(fruits)
print("今天吃:", picked)
2. 多项抽样:sample() 与 choices()
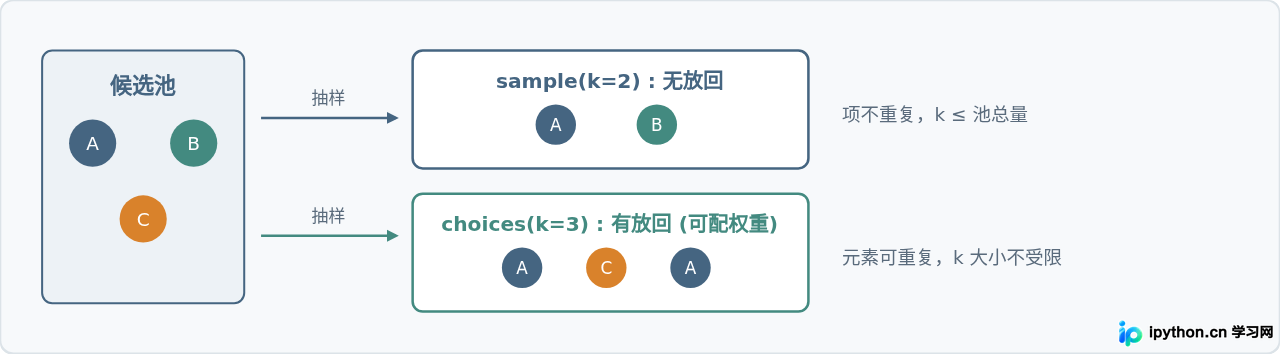
当需要从序列中抽取多个元素时,必须区分是“无放回抽样”还是“有放回抽样”:
random.sample(population, k):无放回抽样。每次选出的元素不会放回池中,抽取的k个结果互不重复。若k大于样本池总长度,会抛出ValueError。原序列不会受到任何修改。random.choices(population, weights=None, k=1):有放回抽样。抽出的元素可能被再次抽中。该函数支持通过weights(相对权重)或cum_weights(累加权重)为每个元素指定被抽中的概率。
import random

cards = ["A", "B", "C", "D", "E"]

# 抽 3 张不重复牌
hand = random.sample(cards, 3)
print("抽卡结果:", hand)  # 示例: ['C', 'A', 'E']

# 抽奖机制:金奖概率 5%,银奖 15%,铜奖 80%
prizes = ["金奖", "银奖", "铜奖"]
weights = [5, 15, 80]
draw_results = random.choices(prizes, weights=weights, k=5)
print("抽奖5次结果:", draw_results)
3. 序列乱序:random.shuffle(list)
random.shuffle(x) 将可变序列(如列表)中的元素原地(in-place)随机打乱次序。需要特别注意:
- 该函数返回值为
None,不可写成new_lst = random.shuffle(old_lst)。 - 参数必须是支持修改的可变序列。若传入元组或字符串,会引发
TypeError。若需要打乱不可变序列,应使用random.sample(seq, len(seq))生成乱序副本。
import random

deck = [1, 2, 3, 4, 5]
random.shuffle(deck)
print("打乱后的列表:", deck)  # 原列表被修改,示例: [3, 1, 5, 2, 4]
四、常用函数特性速查与选型
为便于开发时快速确定具体函数,下表总结了各函数在传参、取值边界及返回类型上的核心差异:
| 函数名称 | 核心功能 | 区间 / 行为特征 | 返回类型 |
|---|---|---|---|
random() |
生成基础浮点数 | [0.0, 1.0) 左闭右开 |
float |
uniform(a, b) |
生成指定范围浮点数 | [a, b] 闭区间(含浮点舍入) |
float |
randint(a, b) |
生成指定范围整数 | [a, b] 双端均包含 |
int |
randrange(a, b, step) |
按步长生成整数 | [a, b) 左闭右开,支持步长 |
int |
choice(seq) |
单项序列选取 | 序列非空,等概率返回 1 项 | 元素类型 |
sample(pop, k) |
多项无放回抽样 | 抽取 k 个不同项,原序列不变 |
list |
choices(pop, k) |
多项有放回抽样 | 元素可重复,支持自定义权重 weights |
list |
shuffle(x) |
原地打乱序列 | 直接修改传入的列表,无返回值 | None |
五、安全场景警告:何时使用 secrets 模块
random 模块完全基于梅森旋转算法,该算法属于非加密安全的伪随机数生成器(PRNG)。其内部状态由 624 个 32 位整数组成,任何攻击者在观察到连续的 624 次输出后,均可通过数学推导完全预测未来的所有随机数。
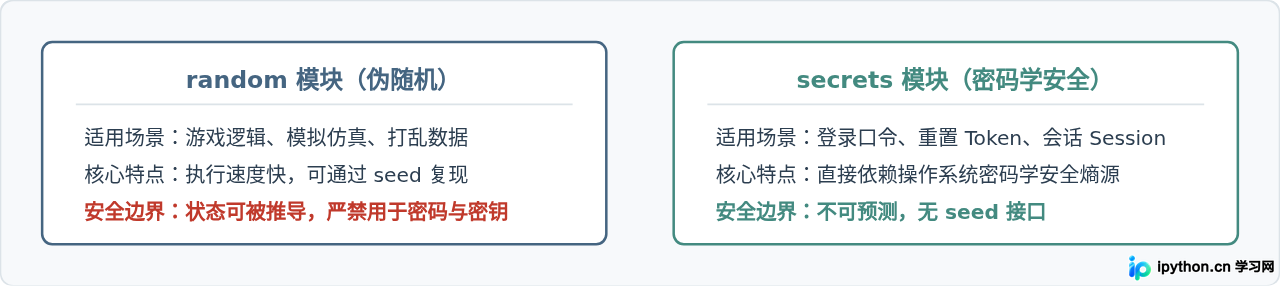
在涉及敏感业务(例如生成用户密码、邮箱验证码、重置凭据 Token、API 鉴权密钥)时,应直接使用 Python 3.6 引入的 secrets 模块替代 random:
import secrets

# 生成密码学安全的随机 Token
auth_token = secrets.token_hex(16)
print("安全Token:", auth_token)

# 生成密码学安全的区间整数(满足 0 <= n < 100)
secure_code = secrets.randbelow(1000000)
print("6位验证码:", f"{secure_code:06d}")
熟练掌握各函数区间的闭合逻辑以及抽样时的放回规则,能够避免开发中绝大多数随机数相关的边界错误;在明确业务是否涉及安全凭证后做出正确的模块选型,则是保证系统稳定与安全的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









