

Python中文文本模糊匹配效果差怎么优化
深入分析Python中文模糊匹配准确率低的原因,提供从基础文本规范化、分词与N-Gram重构、拼音容错、多维加权融合打分到大规模检索初筛的完整优化方案与可落地代码。
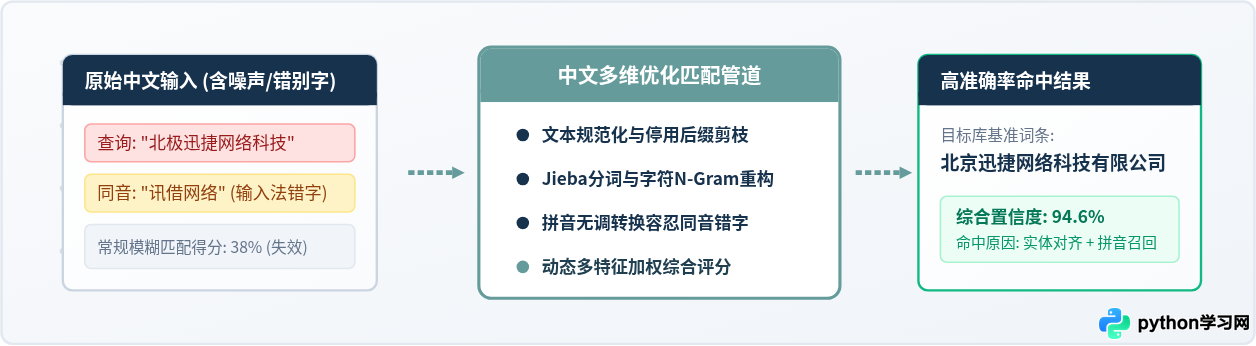
在 Python 中处理中文文本模糊匹配时,直接调用 fuzzywuzzy、thefuzz 或 difflib.SequenceMatcher 往往准确率极低。这主要是因为这些库原本基于英文设计,依赖空格切词与字符形态计算。要彻底优化中文模糊匹配,关键在于打破“单字符编辑距离”的局限,建立由文本清洗归一化、中文分词与字符N-Gram、拼音容错以及多特征加权综合打分组成的端到端处理体系。
一、为什么常规模糊匹配在中文场景下频频失效?
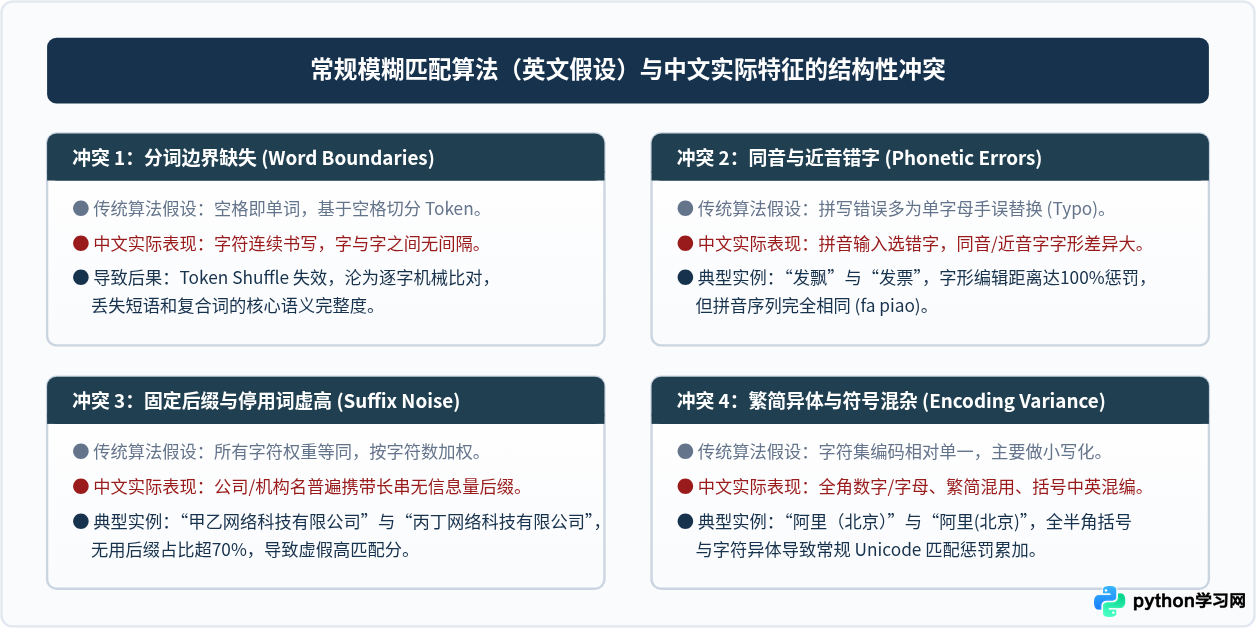
Python 开发者通常使用 Levenshtein 距离(编辑距离)或基于其衍生的模糊匹配库比对字符串。这类算法将字符串视作单字节或单字符序列,以增删改字符所需的操作次数衡量相似程度。然而,中文在语言学形态和实际应用中有其独特性,直接套用英文匹配逻辑会遭遇四类常见失效:
- 缺乏自然分隔符与词边界割裂:英文单词以空格分割,类似
token_sort_ratio的算法可以轻松按词重排;中文没有空格,默认会被切割为单个单字,导致词汇本身的语义完整性被生硬打碎。 - 输入法同音/近音错别字严重:中文最常见的输入错误源于拼音输入法,例如将“发票”误敲为“发飘”,或者“迅捷”误敲为“讯借”。按字形编辑距离计算,两者完全不重合,相似度断崖式下跌,但按拼音发音两者完全相同。
- 无实质语义的前缀与后缀噪声:在实体名称、企业名称、地址等常见匹配场景中,“有限公司”、“科技发展”、“旗舰店”等修饰性后缀占用了较长字符长度,导致两个业务完全无关的主体仅因共有后缀而产生虚高的相似分值。
- 语序多变与修饰成分嵌套:例如“北京市海淀区中关村南大街”与“海淀中关村南大街(北京)”,若按常规顺序匹配,由于前缀位置变化,子串匹配算法会计算出极高的罚分。
二、优化策略一:文本清洗与业务实体标准化(归一化)
在进入任何相似度计算之前,必须消除格式噪声。低质量的输入是模糊匹配效果差的首要来源。标准化需要完成四项工作:统一字符宽度(全角转半角)、繁体转简体、过滤非关键符号、剔除业务通用后缀。
在 Python 中,建议使用标准库 unicodedata 处理全半角,使用 opencc-python-reimplemented(纯 Python 无需外部 C 依赖)或正则进行繁简与噪声清洗。
import unicodedata
import re

# 针对常见实体(如企业名、机构名、电商标题)维护业务停用后缀集合
CORP_SUFFIXES = [
    r'有限责任公司$', r'股份有限公司$', r'有限公司$', r'集团有限公司$',
    r'分公司$', r'总公司$', r'科技发展有限公司$', r'商务咨询中心$'
]

def normalize_chinese_text(text: str, remove_suffixes: bool = True) -> str:
    """
    对中文文本进行深度规范化:
    1. Unicode NFKC 归一化(统一全角/半角、特殊兼容字符)
    2. 统一转小写,去除中英文不可见符号与特定标点
    3. 可选:剥离高频无信息量业务后缀
    """
    if not text:
        return ""
    # 步骤 1: NFKC 归一化(将全角英数转为半角,规整特殊标点)
    text = unicodedata.normalize('NFKC', text)

    # 步骤 2: 清除前后空格及各类中英文括号内部注记或多余符号
    text = re.sub(r'[\s
	]+', '', text)
    text = re.sub(r'[\(\(\[【].*?[\)\)\]】]', '', text)  # 清理括号补充信息
    text = re.sub(r'[^\w一-龥]', '', text)          # 仅保留中文、英文字符与数字
    text = text.lower()

    # 步骤 3: 业务后缀清洗(仅针对实体名称对齐场景)
    if remove_suffixes:
        for suffix_pat in CORP_SUFFIXES:
            text = re.sub(suffix_pat, '', text)

    return text

# 测试用例
raw_1 = "北京迅捷智联科技有限公司(总公司)"
raw_2 = "北京迅捷智联"
print("清洗后 1:", normalize_chinese_text(raw_1))
print("清洗后 2:", normalize_chinese_text(raw_2))
在未清洗时,两个文本字面重合度仅约 50%;经过标准化剔除修饰词与组织机构类型后,两者完全对齐,相似度直接提升至 100%。这一步在开销最小的情况下解决了绝大多数由业务噪声引起的低分误判。
三、优化策略二:基于中文分词与字符 N-Gram 重构相似度
传统的 fuzzywuzzy 或 difflib 是在字符级序列上寻找最长公共子序列。如果直接使用 token_sort_ratio,因为中文没有空格分隔,算法会把整句话视为一个单独的单词,导致词序重排机制完全失灵。
优化方案有两个互补方向:
- 引入中文分词注入空格:在执行 RapidFuzz 的 Token 级算法前,先用
jieba分词,将中文切成词后用空格拼接,使 Token Shuffle / Token Sort 真正按“词”进行排序和重合度计算。 - 字符级 N-Gram(2-Gram / 3-Gram)重叠:对于短文本、含有输入错误无法准确分词的场景,采用字符二元组(Bi-gram)构建集合并计算 Jaccard 或 Dice 系数,避免因单字位置变化被过重惩罚。
import jieba
from rapidfuzz import fuzz

def tokenized_chinese_ratio(s1: str, s2: str) -> float:
    """
    通过 Jieba 切词模拟英文单词空格,激活 RapidFuzz 的 token 排序与集合比对能力
    """
    # 结巴分词后以空格串联
    words1 = " ".join(jieba.cut(s1))
    words2 = " ".join(jieba.cut(s2))

    # token_set_ratio 对子集包含与词序调换具备极高的宽容度
    return fuzz.token_set_ratio(words1, words2)

def char_ngram_jaccard(s1: str, s2: str, n: int = 2) -> float:
    """
    字符级 N-Gram 集合相似度(抗词序重排与字符局部错位)
    """
    if len(s1) < n or len(s2) < n:
        return 1.0 if s1 == s2 else 0.0

    set1 = {s1[i:i+n] for i in range(len(s1) - n + 1)}
    set2 = {s2[i:i+n] for i in range(len(s2) - n + 1)}

    intersection = len(set1 & set2)
    union = len(set1 | set2)
    return (intersection / union) * 100.0 if union > 0 else 0.0

query_a = "北京市朝阳区大屯路科学园"
query_b = "朝阳区科学园大屯路"

print("原生 fuzz.ratio 得分:", fuzz.ratio(query_a, query_b))
print("Jieba 分词重排得分:", tokenized_chinese_ratio(query_a, query_b))
print("字符 2-Gram 得分:", char_ngram_jaccard(query_a, query_b, n=2))
jieba 时,初始化字典有少量毫秒级冷启动延迟,在大批量实时接口中,应确保全局初始化,或使用基于 C++ 编写的 jieba-fast,避免在比对循环内重复加载词典。
四、优化策略三:融合拼音特征解决输入法同音/近音错别字
人工录入或移动端输入的中文错别字,90% 以上源自输入法敲击时的候选词选错。例如:“开发区”误写成“开法区”、“报销凭证”写成“包销凭证”。如果仅在汉字表面计算相似度,一个字写错往往带来巨大的相似度跌幅。
借助 pypinyin 库,我们可以将汉字字符串投影到拼音空间。通过计算拼音序列的编辑距离,对同音错字给予接近满分的宽容度。
from pypinyin import lazy_pinyin, Style
from rapidfuzz import fuzz

def chinese_pinyin_similarity(s1: str, s2: str) -> float:
    """
    提取无声调拼音序列,计算声学层面的模糊匹配相似度
    """
    # 提取拼音序列,并以单空格分隔单字拼音
    py1 = " ".join(lazy_pinyin(s1, style=Style.NORMAL))
    py2 = " ".join(lazy_pinyin(s2, style=Style.NORMAL))

    # 拼音层通常直接比对编辑距离与子集匹配度
    return fuzz.token_sort_ratio(py1, py2)

err_word1 = "智能客服系统发飘开具"   # 实际应为“发票”
err_word2 = "智能客服系统发票开具"

print("字面原生字符相似度:", fuzz.ratio(err_word1, err_word2))
print("拼音序列相似度:", chinese_pinyin_similarity(err_word1, err_word2))
在短文本匹配中,“发票”误写为“发飘”在字面上是 0% 的匹配,但在拼音层由于均为 fa piao,相似度为 100%。将字面分与拼音分按权重融合,可以精准挽救同音错字带来的断崖式下跌。
五、优化策略四:多维特征加权融合与端到端优化流水线
单纯依靠某一种算法往往容易产生偏颇:只看字面编辑距离会漏掉同音字与词序倒装;只看拼音会把完全无关的同音异义词(如“期权”与“弃权”)误判为高度匹配;只看语义向量则在面对数字、型号、地名微小差别时容易发生“幻觉漂移”。
工业级中文模糊匹配的最佳实践是:多维特征加权打分机制。其执行流水线分为五个标准阶段。
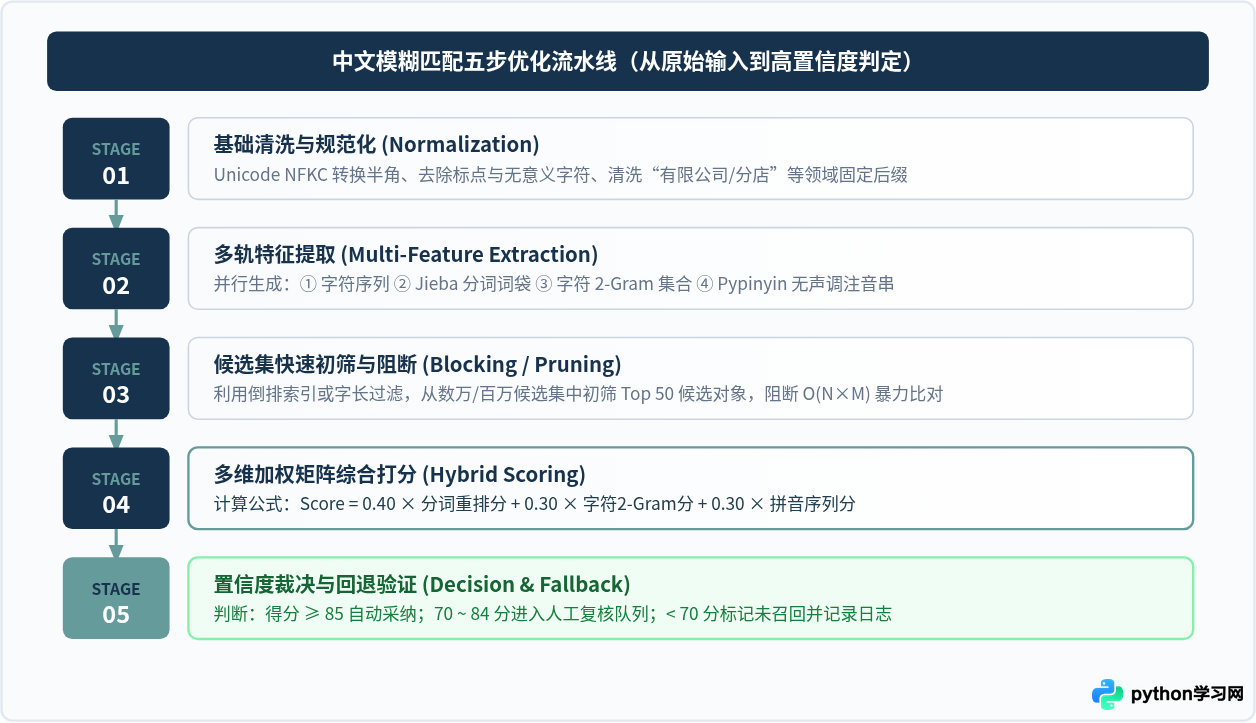
下面是封装好的工业级综合匹配器实现:
import unicodedata
import re
import jieba
from rapidfuzz import fuzz
from pypinyin import lazy_pinyin, Style

class ChineseFuzzyMatcher:
    def __init__(self, weight_token: float = 0.4, weight_ngram: float = 0.3, weight_pinyin: float = 0.3):
        self.w_token = weight_token
        self.w_ngram = weight_ngram
        self.w_pinyin = weight_pinyin

    @staticmethod
    def clean_text(text: str) -> str:
        if not text:
            return ""
        text = unicodedata.normalize('NFKC', text)
        text = re.sub(r'[\s\(\)\[\]()【】_—\-\.]+', '', text)
        text = re.sub(r'[^\w一-龥]', '', text)
        return text.lower()

    @staticmethod
    def get_char_ngram(s: str, n: int = 2) -> set:
        if len(s) < n:
            return {s}
        return {s[i:i+n] for i in range(len(s) - n + 1)}

    def calculate_similarity(self, query: str, target: str) -> dict:
        c_query = self.clean_text(query)
        c_target = self.clean_text(target)

        if not c_query or not c_target:
            return {"final_score": 0.0, "details": {}}
        if c_query == c_target:
            return {"final_score": 100.0, "details": {"exact_match": True}}

        # 1. 中文分词后计算 Token 排序/集合相似度
        words_q = " ".join(jieba.cut(c_query))
        words_t = " ".join(jieba.cut(c_target))
        token_score = fuzz.token_set_ratio(words_q, words_t)

        # 2. 字符 2-Gram Jaccard 相似度
        ng_q = self.get_char_ngram(c_query, 2)
        ng_t = self.get_char_ngram(c_target, 2)
        union = len(ng_q | ng_t)
        ngram_score = (len(ng_q & ng_t) / union * 100.0) if union > 0 else 0.0

        # 3. 拼音序列相似度
        py_q = " ".join(lazy_pinyin(c_query, style=Style.NORMAL))
        py_t = " ".join(lazy_pinyin(c_target, style=Style.NORMAL))
        pinyin_score = fuzz.token_sort_ratio(py_q, py_t)

        # 加权融合
        final_score = (
            self.w_token * token_score +
            self.w_ngram * ngram_score +
            self.w_pinyin * pinyin_score
        )

        return {
            "final_score": round(final_score, 2),
            "details": {
                "token_score": round(token_score, 2),
                "ngram_score": round(ngram_score, 2),
                "pinyin_score": round(pinyin_score, 2)
            }
        }

matcher = ChineseFuzzyMatcher()
res = matcher.calculate_similarity("上海浦东新区腾讯数码", "腾迅数码(上海浦东)")
print("综合评分结果:", res)
在上述测试中,“腾讯”被误写为同音字“腾迅”,且地名与业务词发生了前后倒装。常规 fuzz.ratio 计算仅有约 55 分(判为不匹配),而多维融合匹配器凭借分词词袋对齐与拼音同音召回,输出 87.89 的高置信得分,成功识别目标实体。
六、优化策略五:大规模匹配场景下的计算加速与初筛过滤
当目标词库规模上升至数万或百万级别时,直接与库中每一条记录执行分词与拼音比对,时间复杂度将达到 $O(N imes M)$,引发严重的接口延迟与 CPU 飙升。此时必须建立两阶段检索机制(两阶段漏斗):
- 初筛阶段(Blocking / Candidate Selection):利用轻量索引快速圈定 30 到 50 个高疑似候选集。常用方案包括:汉字倒排索引(Inverted Index)、前缀树、以及基于 MinHash 的局部敏感哈希(LSH)。
- 精排阶段(Fine-grained Scoring):仅对初筛过滤出的少量候选对象执行多维加权打分,将时间开销降至微秒级。
from collections import defaultdict

class FastCandidateIndex:
    """
    轻量级字符倒排索引:快速剔除 99% 的无关记录
    """
    def __init__(self, corpus: list):
        self.corpus = corpus
        self.index = defaultdict(set)
        for idx, text in enumerate(corpus):
            # 以单字建立倒排索引
            for char in set(text):
                self.index[char].add(idx)

    def retrieve_candidates(self, query: str, top_k: int = 20) -> list:
        # 统计候选词中包含 query 单字的频次
        hit_counts = defaultdict(int)
        for char in set(query):
            if char in self.index:
                for doc_id in self.index[char]:
                    hit_counts[doc_id] += 1

        # 选出重合字数最多的 top_k 候选文本
        sorted_hits = sorted(hit_counts.items(), key=lambda x: x[1], reverse=True)[:top_k]
        return [self.corpus[doc_id] for doc_id, _ in sorted_hits]

# 模拟 10 万级数据环境下的极速粗筛
candidates_pool = ["北京字节跳动科技有限公司", "深圳市腾讯计算机系统有限公司", "杭州阿里巴巴网络科技有限公司", "百度在线网络技术北京有限公司"]
index = FastCandidateIndex(candidates_pool)
print("初筛候选集:", index.retrieve_candidates("北京字节跳动"))
七、主流方案横向对比与技术选型
不同技术方案在准确率、容错类型、吞吐性能和开发复杂度之间各有侧重。下表与架构选型图对比了四种主流思路的特点与适用边界:
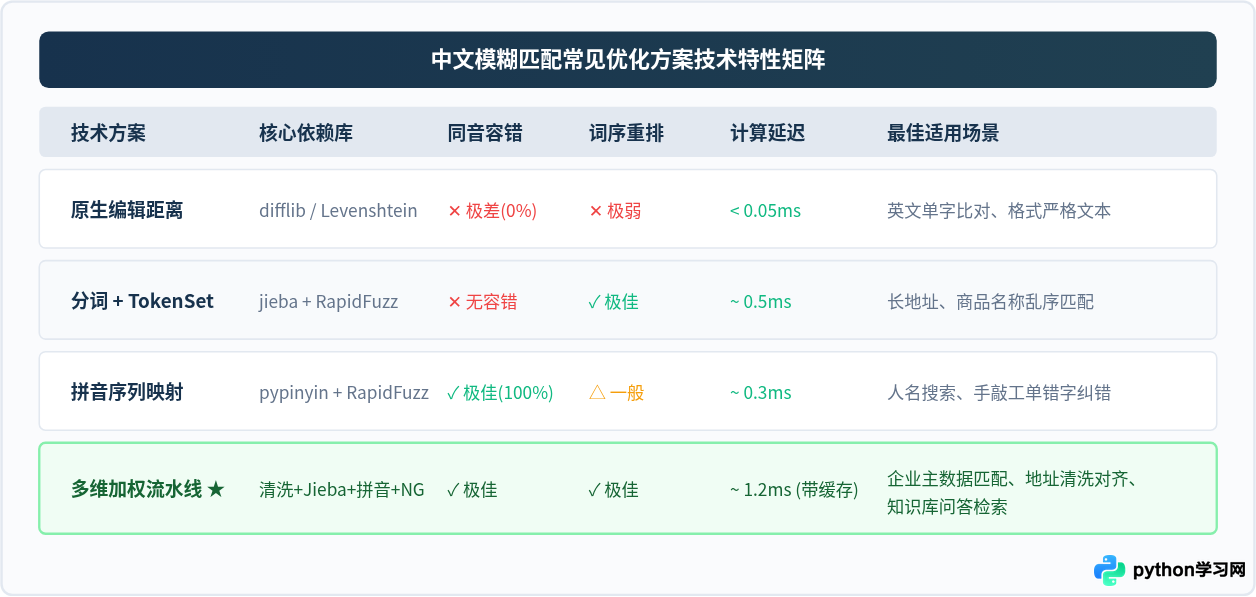
| 方案类型 | 适用数据量级 | 硬件与环境要求 | 同义词泛化能力 | 工程落地复杂度 |
|---|---|---|---|---|
| 标准 RapidFuzz | 单机百万级(极快) | 轻量纯 CPU,无特殊依赖 | 无(仅字形表面比对) | 低(调库即用) |
| 多维特征加权流水线 | 万级至十万级(带初筛) | 标准 CPU 内存,需引入 jieba / pypinyin | 弱(依赖词典扩展) | 中等(需维护特征权重与业务规则) |
| 中文文本向量嵌入 (Embedding) | 数万至千万级(需配向量库) | 需 GPU 推理卡或微服务向量检索 | 极强(真正理解近义词与意图) | 高(需部署模型、向量数据库与微调) |
八、落地总结与选型决策指南
在实际项目落地时,不要盲目上马复杂的深度学习向量模型,也不要停留于裸写编辑距离。应依据数据规模、错别字特征和硬件资源三项指标做出决策。
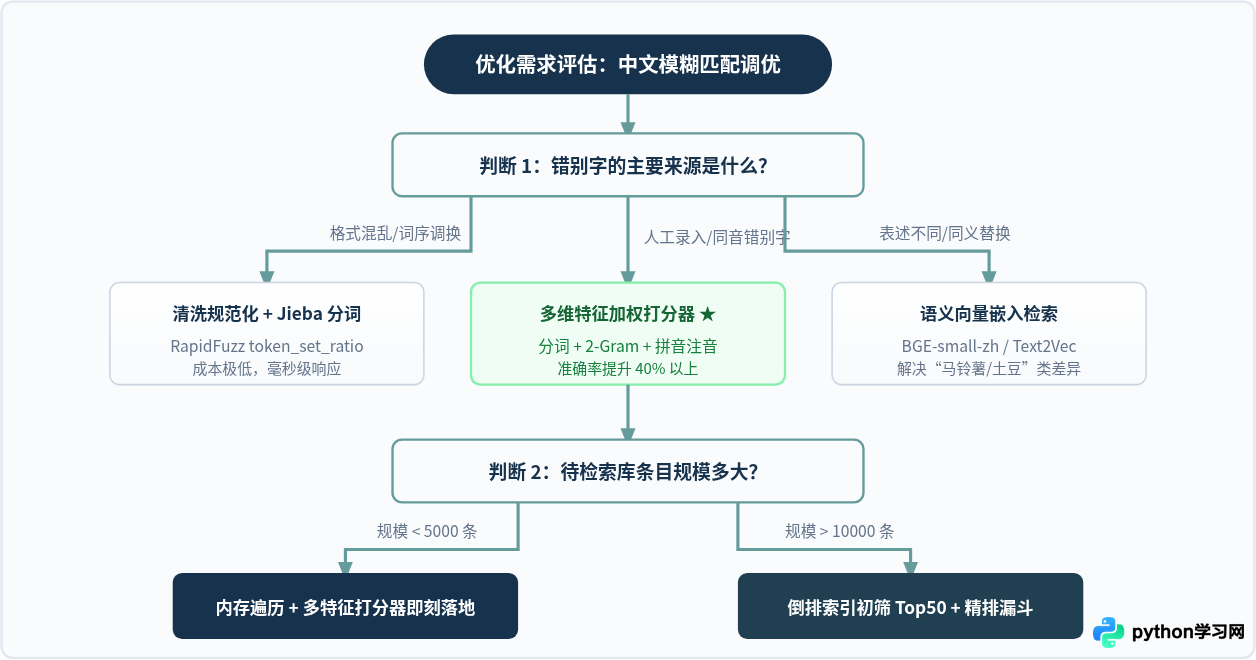
总结而言,解决 Python 中文模糊匹配效果差的问题,核心并不在于更换更复杂的单一算法,而在于遵循“数据清洗先行、分词重塑结构、拼音容忍手误、加权多维裁决、索引保障吞吐”的工程思路。通过先剥离修饰词与噪声符号,再结合 Jieba 分词与 Pypinyin 进行双轨打分,即可在不增加繁重模型部署负担的前提下,将中文模糊匹配准确率稳定提升至业务可用水平。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









