

Python生成随机数:random模块常用函数与用法

random 模块基于成熟的梅森旋转算法(Mersenne Twister),提供了覆盖整数、浮点数以及列表序列抽样的一整套实用函数。本文系统梳理 random 模块的核心原理、常用接口、边界特性与选型边界,帮助读者快速掌握并在实际工程中正确运用。
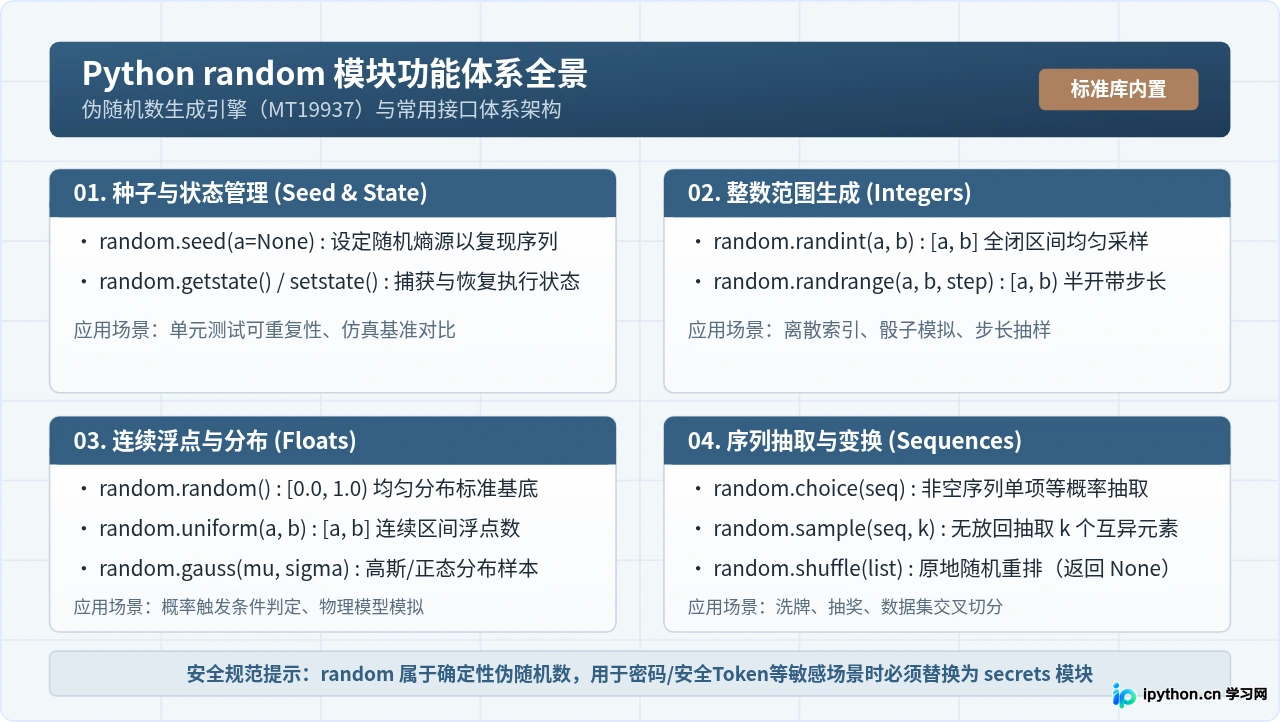
一、伪随机数机制与种子控制:random.seed()
计算机本身是确定性的机器,无法在没有外部物理熵源的情况下生成纯粹意义上的绝对随机数。Python 标准库的 random 模块实现的是伪随机数生成器(PRNG),其底层采用的是经典的 梅森旋转算法(Mersenne Twister,MT19937)。该算法具有长达 219937 - 1 的巨大周期,在统计学上拥有优异的均匀分布特性。
伪随机数的核心特征在于:给定相同的初始种子(Seed),算法将推演出完全一致的数字序列。在默认情况下,如果不显式指定种子,Python 会自动读取操作系统的系统时间或系统随机熵(如 /dev/urandom)作为种子,因此每次执行程序都会得到看似不可预测的结果。
import random

# 1. 显式设置随机种子
random.seed(42)
print("种子 42 首次输出:", random.random())
print("种子 42 第二次输出:", random.randint(1, 100))

# 2. 重新初始化为相同的种子
random.seed(42)
print("重置种子 42 后再次输出:", random.random())
print("重置种子 42 后再次输出:", random.randint(1, 100))
示例运行输出:
# 种子 42 首次输出: 0.6394267984578837
# 种子 42 第二次输出: 82
# 重置种子 42 后再次输出: 0.6394267984578837
# 重置种子 42 后再次输出: 82
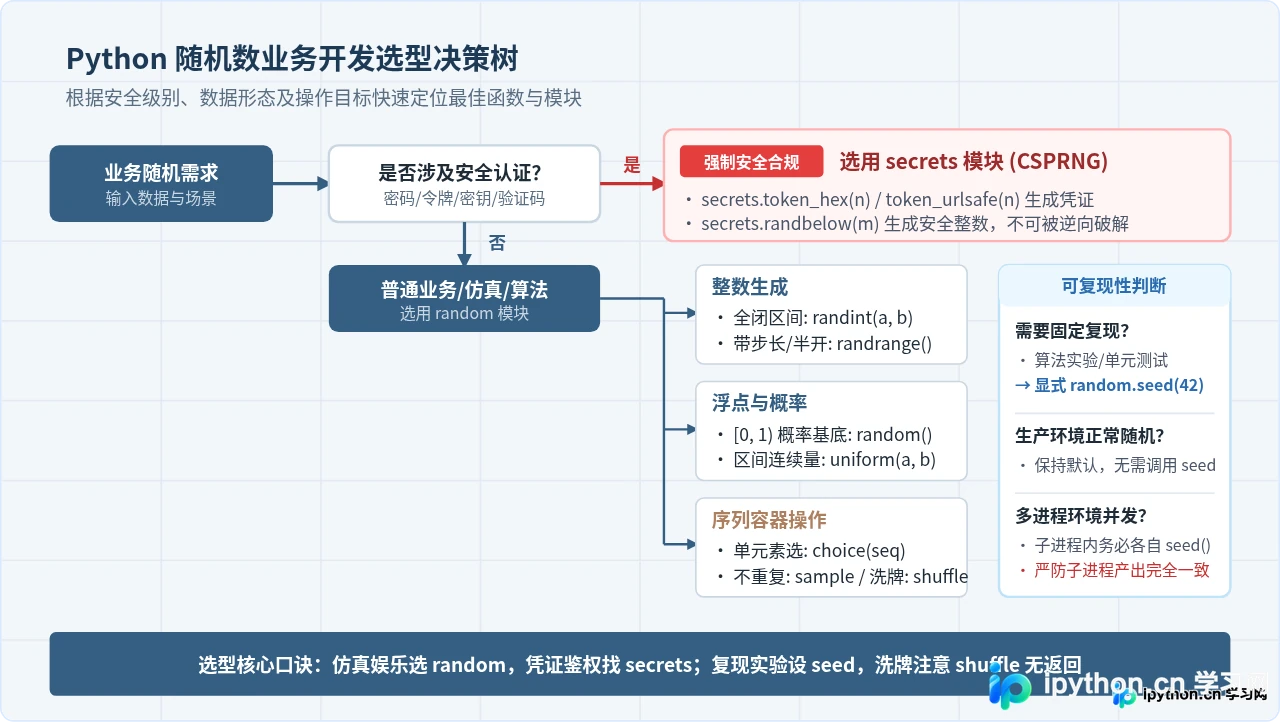
可以看到,在重置 random.seed(42) 后,生成的浮点数与整数与前次完全相同。在工程实践中,显式设定种子常用于算法调试、单元测试基准对比以及数据分析实验的可复现性保障。而在生产环境的常规随机需求中,则应保留默认行为,避免固定种子导致输出失去多样性。
二、生成整数随机数:randint 与 randrange
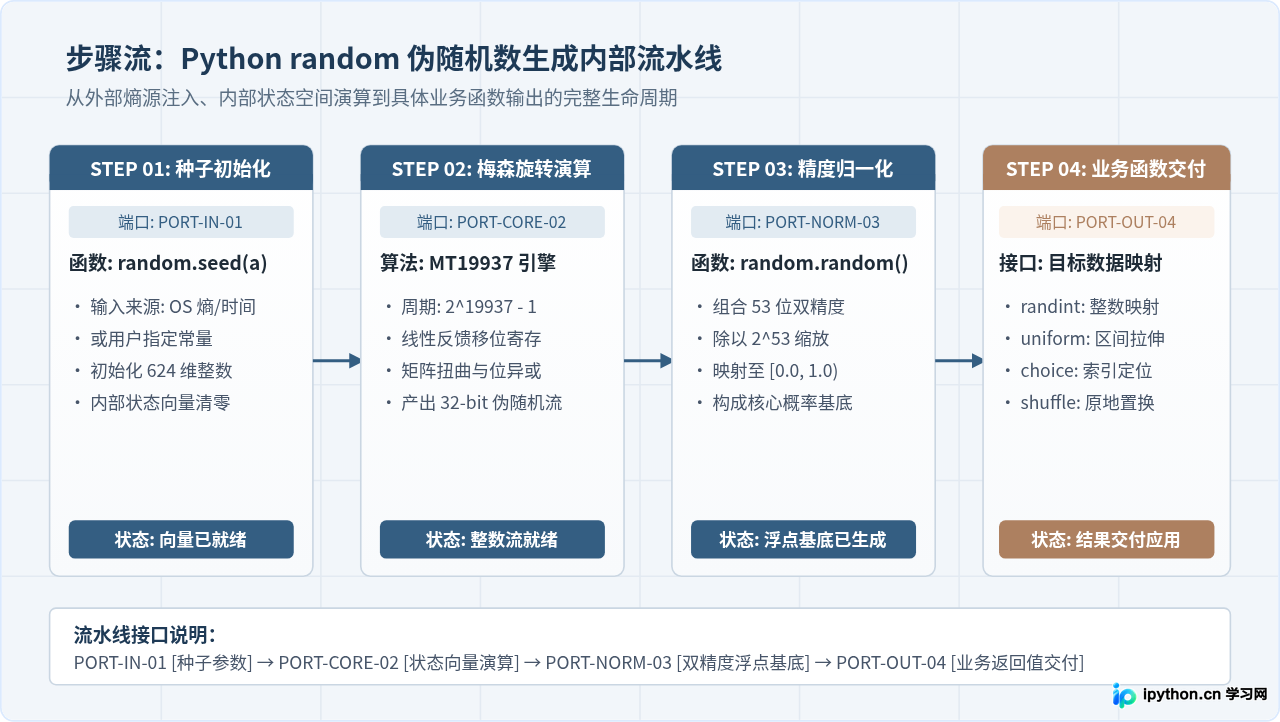
在需要获取离散整数时,random 模块提供了两个最为核心的函数:randint(a, b) 和 randrange(start, stop[, step])。理解它们在边界开闭上的差异,是避免“差一错误(Off-by-one Error)”的关键。
1. random.randint(a, b)
randint(a, b) 用于生成一个满足 a <= N <= b 的随机整数 N。它的突出特点是全闭区间,两端端点 a 和 b 均有可能被返回。
import random

# 模拟投掷一颗 6 面骰子,结果在 1 到 6 之间(包含 1 和 6)
dice_result = random.randint(1, 6)
print(f"掷骰子点数: {dice_result}")

# 生成 4 位短信随机数字验证码(仅示例非安全业务场景)
code = random.randint(1000, 9999)
print(f"生成的四位数: {code}")
2. random.randrange(start, stop[, step])
randrange 的行为与 Python 内置的 range() 语法完全保持一致,生成范围属于左闭右开区间 [start, stop)。它不会返回 stop 本身,同时支持设定步长 step。
import random

# 生成 0 到 9 之间的索引整数(包含 0,不包含 10)
index = random.randrange(0, 10)
print(f"有效索引: {index}")

# 生成 0 到 100 之间的偶数(包含 0,步长为 2,不包含 100)
even_num = random.randrange(0, 100, 2)
print(f"随机偶数: {even_num}")

# 生成 1 到 99 之间的奇数(步长为 2)
odd_num = random.randrange(1, 100, 2)
print(f"随机奇数: {odd_num}")
randint(a, b) 实际上就是 randrange(a, b + 1) 的便捷包装。当在处理列表下标或与 len(my_list) 对接时,直接使用 randrange(0, len(my_list)) 更加安全自然;而在模拟掷骰子、点数等自然数问题时,使用 randint(1, 6) 则更符合思维直觉。
三、生成浮点随机数:random、uniform 与概率分布
处理连续数值空间、概率计算与物理仿真时,主要依赖浮点数生成函数。
1. random.random()
random.random() 是整个模块最基础的源泉函数。它不接收任何参数,直接返回一个范围在 [0.0, 1.0) 的均匀分布浮点数。由于其结果属于标准概率区间,常用于概率触发条件:
import random

val = random.random()
print(f"基础浮点值: {val:.6f}")

# 实现 25% 暴击率的判断逻辑
if random.random() < 0.25:
    print("触发暴击!")
else:
    print("普通攻击")
2. random.uniform(a, b)
uniform(a, b) 用于获取指定区间内的均匀分布浮点数。无论 a < b 还是 a > b,该函数均能正常工作,其计算公式为 a + (b - a) * random()。在理论上,端点包含性取决于浮点数舍入计算。
import random

# 模拟采集 20.0 到 35.0 摄氏度之间的室内环境温度
temp = random.uniform(20.0, 35.0)
print(f"模拟传感器温度: {temp:.2f} ℃")
四、序列操作:choice、sample 与 shuffle
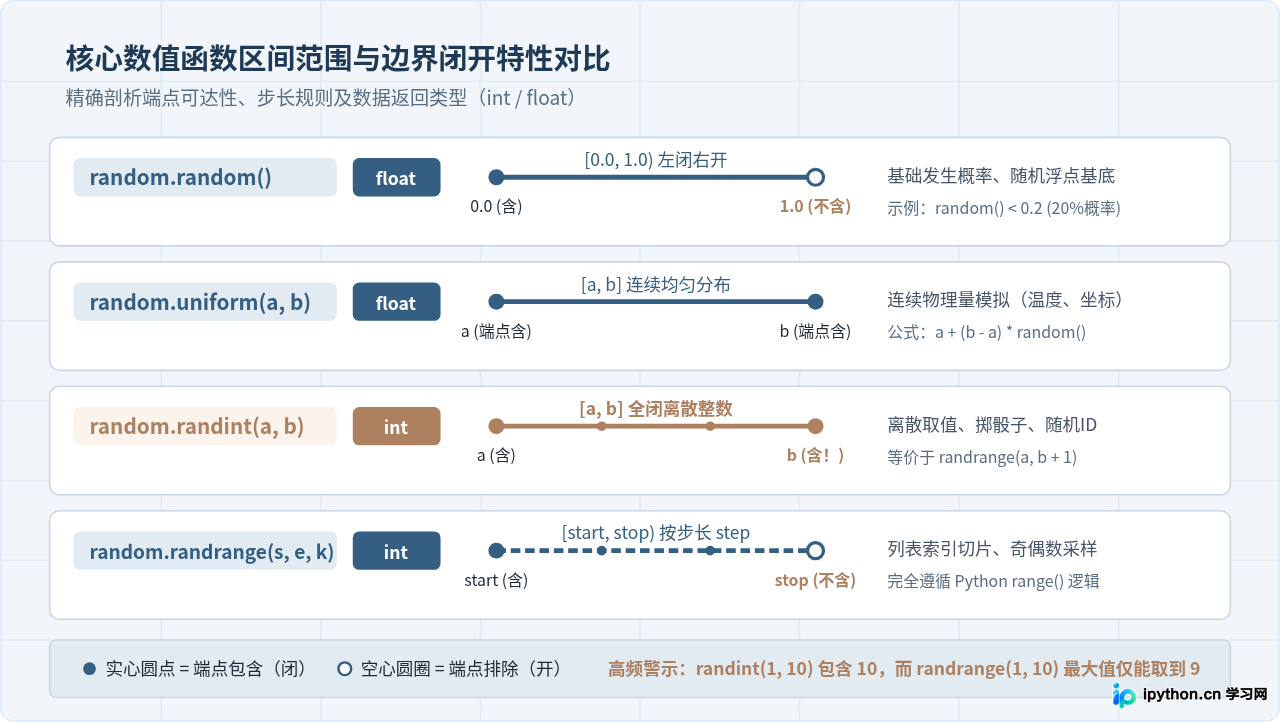
当数据存在于列表、元组等序列结构中时,编写手动的随机索引不仅冗长,而且容易出错。random 模块提供了高度封装的序列操作函数:
| 函数名 | 操作目标 | 抽样方式 | 返回值类型 | 是否修改原序列 |
|---|---|---|---|---|
choice(seq) |
非空序列 | 单次单项 | 元素本身 | 否 |
sample(seq, k) |
总体序列/集合 | 无放回抽样(元素互异) | 新列表(list) |
否 |
choices(seq, k, weights) |
序列总体 | 有放回抽样(允许重复) | 新列表(list) |
否 |
shuffle(x) |
可变序列(如列表) | 原地随机重排 | None |
是(直接修改原对象) |
import random

fruits = ["苹果", "香蕉", "樱桃", "葡萄", "芒果"]

# 1. choice:单选一个元素
selected = random.choice(fruits)
print("随机选中水果:", selected)

# 2. sample:无放回抽取 3 个互不相同的水果
lucky_draw = random.sample(fruits, 3)
print("抽取奖品组 (互异):", lucky_draw)

# 3. choices:带权重有放回抽取 4 次
# 苹果权重为 70%,其余各占 10%
weighted_result = random.choices(fruits, weights=[0.7, 0.1, 0.1, 0.05, 0.05], k=4)
print("权重抽样 (可重复):", weighted_result)

# 4. shuffle:就地打乱列表顺序
cards = [1, 2, 3, 4, 5]
random.shuffle(cards)
print("洗牌后的列表:", cards)
random.shuffle(my_list)是就地操作,它的返回值为None。初学者常写出my_list = random.shuffle(my_list),这会导致my_list被直接赋值为None,造成数据丢失!random.shuffle()仅支持可变序列。如果传入元组tuple或字符串str,将抛出TypeError。random.sample(seq, k)中的k不能大于序列总长度,否则会抛出ValueError: Sample larger than population。
五、工程实践与安全边界:random 与 secrets 的选型
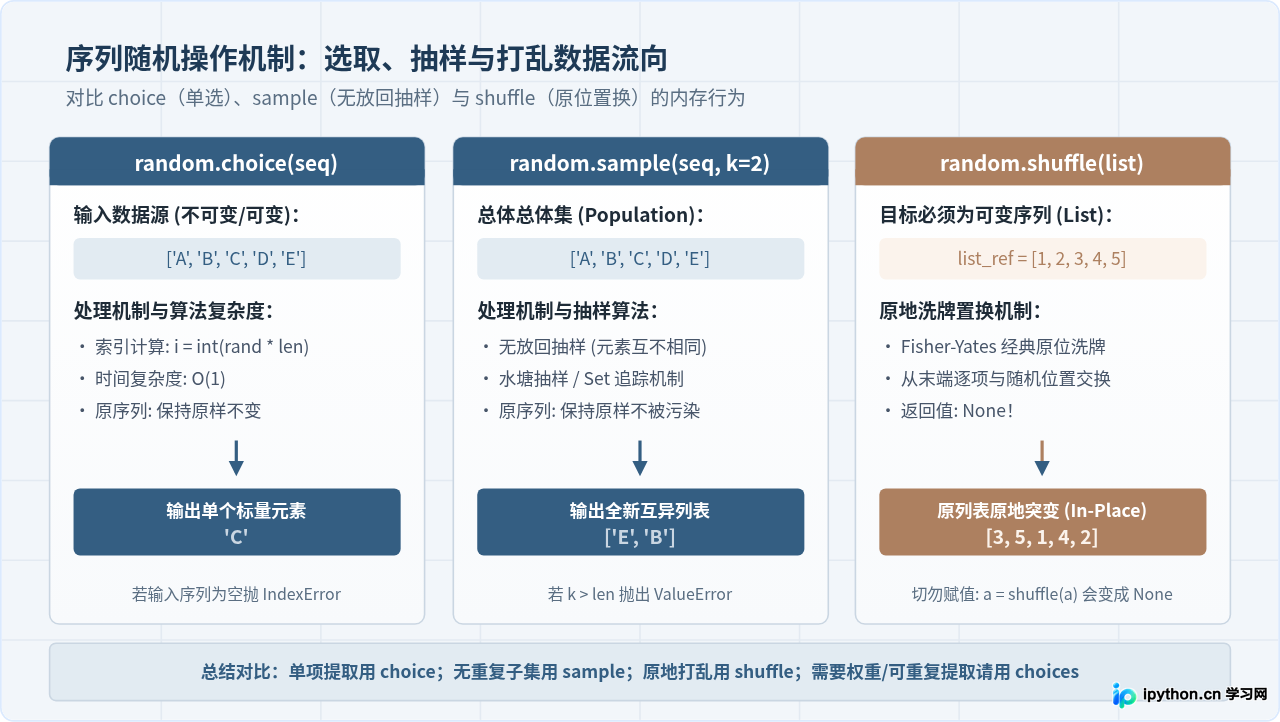
在实际工程开发中,一个至关重要的架构认知是:绝对不要将 random 模块用于安全敏感场景。
1. 为什么 random 不能用于密码学安全?
梅森旋转算法的设计初衷是统计学均匀性与极高的执行速度,而非密码学抗攻击性。该算法的内部状态完全由 624 个 32 位整数(共 19937 个二进制位)决定。如果攻击者连续观察到梅森旋转算法输出的 624 个随机数,便可以通过解线性方程组在毫秒级时间内完整推导还原出内部状态,进而精确预测后续生成的所有随机数,甚至反推历史输出。
2. 安全场景的唯一正确解:secrets 模块
从 Python 3.6 开始,标准库提供了专用的加密安全伪随机数生成器(CSPRNG)模块:secrets。该模块直接对接操作系统的最高安全级别熵源(如 Linux 的 getrandom() 系统调用、Windows 的 BCryptGenRandom),具备不可预测性。
import secrets

# 1. 生成加密安全的随机十六进制 Token(如用于 Session ID、重置密码令牌)
token = secrets.token_hex(16)
print("安全 Hex Token:", token)

# 2. 生成安全的 URL 安全 Base64 字符串
url_token = secrets.token_urlsafe(16)
print("URL 安全 Token:", url_token)

# 3. 生成密码学安全的随机数范围(如生成 6 位短信安全验证码)
secure_code = secrets.randbelow(900000) + 100000
print("安全验证码:", secure_code)

# 4. 从字符集中安全选取单个元素
secure_char = secrets.choice("abcdefghijklmnopqrstuvwxyz0123456789")
print("安全随机字符:", secure_char)
六、高频问题与工程避坑指南
在实际编写与维护 Python 代码时,以下是开发者容易遇到的典型问题及规范解决方式:
1. 多进程(multiprocessing)中子进程生成相同随机序列
在 Linux 等 POSIX 操作系统中,multiprocessing 默认采用 fork 创建子进程。子进程会完全继承父进程的内存空间状态,包括 random 模块当前的内部状态向量。如果在父进程中已经初始化了随机数,那么所有 fork 出来的子进程将产生完全一模一样的随机数序列。
解决方案:在子进程的工作函数开始执行时,显式调用一次无参的 random.seed(),使各个子进程重新从操作系统熵源获取独立的初始状态。
2. choice 与 sample 处理空序列报错
调用 random.choice([]) 会抛出 IndexError: Cannot choose from an empty sequence;而当抽取数量 k > len(population) 时,random.sample() 会抛出 ValueError。在编写业务代码前,必须增加非空校验或前置边界防御判断。
3. random 模块的线程安全性
Python 标准库中 random 模块的单例实例是线程安全的,底层操作具备锁保护。但在高并发多线程场景下,多个线程争抢同一个全局锁可能会产生细微的性能竞争。若对吞吐量有极致要求,可以通过 random.Random() 为每个工作线程创建独立的随机实例。
七、总结回顾
Python 的 random 模块为日常编程提供了极其高效、方便的伪随机数工具集合:
- 控制可复现性:使用
random.seed(a)锁定随机起点,保障调试与实验的一致性。 - 离散整数生成:需要包含两端端点时使用
randint(a, b);需要与索引对其或指定步长时使用randrange(start, stop, step)。 - 连续浮点生成:利用
random()生成 [0.0, 1.0) 基础概率值;利用uniform(a, b)生成指定区间的连续数值。 - 容器序列处理:抽取单个元素用
choice();提取互异子集用sample();打乱原列表用shuffle()(切记不可接收其返回值)。 - 安全边界防护:遇到用户密码、API Token、支付凭证等敏感信息时,严格切换为
secrets模块。
掌握这些核心函数及其底层边界,能够帮助开发者在游戏开发、数据模拟及日常脚本编写中游刃有余、稳健编码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









