

Python设置随机种子以复现随机小数序列
详细讲解在Python中如何通过设置随机种子(random.seed)精准复现随机小数序列,涵盖伪随机数原理、标准库与NumPy的具体操作步骤、实例对比以及常见避坑要点。
在 Python 中,计算机生成的随机数本质上是由数学递推公式计算得出的“伪随机数”。要复现完全相同的随机小数序列,核心方法是在调用任何随机函数之前,通过 random.seed(value) 注入一个固定的整数种子。只要种子数值相同、生成算法未变且调用的随机方法与先后顺序严格一致,Python 就能精确重现出每一次生成的浮点数值。本文将详解伪随机数的工作机制、标准库与 NumPy 的操作步骤、验证方法以及确保序列可复现的边界约束。
一、为什么设置随机种子能够复现小数序列
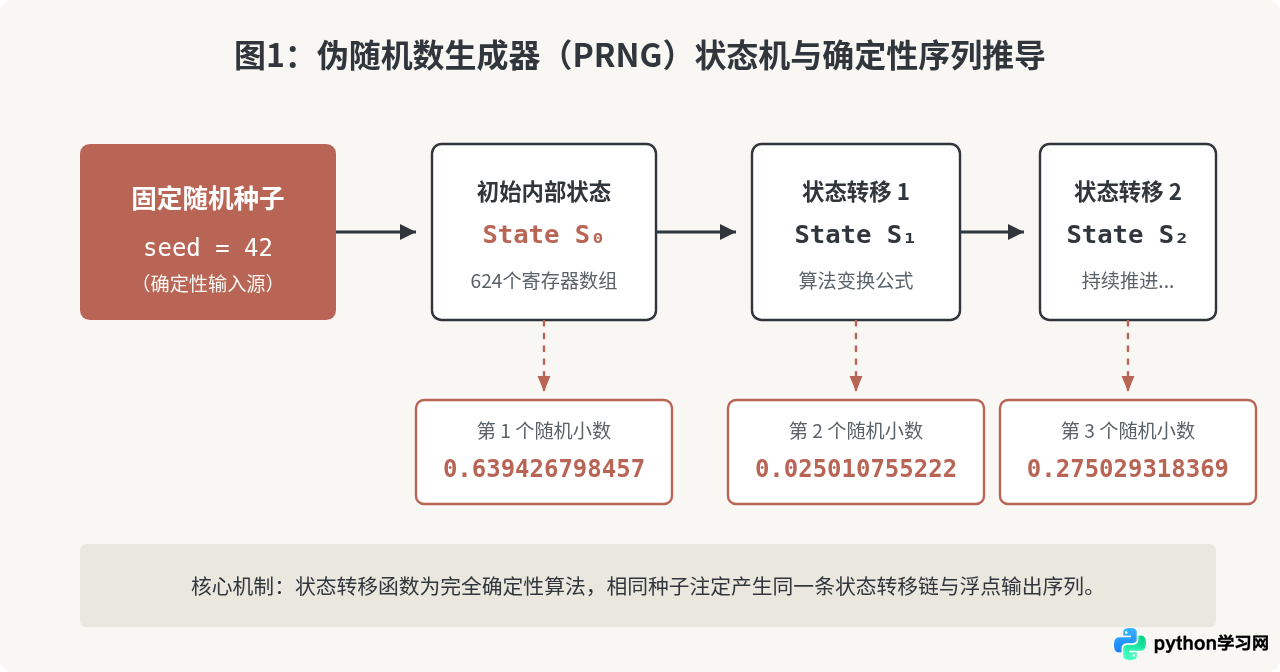
计算机本身无法产生真正不可预测的自然物理随机量。Python 内部使用的是伪随机数生成器(Pseudo-Random Number Generator, PRNG),其默认核心算法为梅森旋转算法(Mersenne Twister, MT19937)。
这种生成器本质上是一个具备确定性转换逻辑的有限状态机:
- 种子(Seed)是初始状态的钥匙:传入一个确定的整数作为种子,生成器就会依据该整数初始化其内部维护的一个长达 624 个 32 位整型数构成的状态数组。
- 状态转移与数值映射:每当程序调用一次如
random.random()获取一个[0.0, 1.0)范围内的浮点数时,生成器便执行一次确定的数学变换,将内部状态递推到下一个位置,并将对应的状态位转化为标准精度的 IEEE 754 浮点小数。 - 确定性输出链条:若不指定种子,Python 默认会使用操作系统的熵源(如
/dev/urandom或系统当前高精度时钟)作为种子,导致每次运行初始状态不同;而一旦显式固定了种子,状态序列的起点就完全固定,后续生成的所有浮点数序列自然完全一致。
二、使用 Python 标准库 random 复现小数序列
Python 标准库自带的 random 模块是最直接也是最常用的随机数发生模块。生成随机小数主要涉及以下两个常用函数:
random.random():生成一个区间在[0.0, 1.0)之间的半开半闭区间浮点数。random.uniform(a, b):生成一个区间在[a, b]之间的均匀分布浮点数。
完整复现步骤与代码示例
要复现一组包含 5 个随机小数的序列,分为“设定种子生成第一组”、“中途重设相同种子”、“验证第二组完全相同”三个阶段:
import random

def generate_float_sequence(count=5):
    """连续生成指定数量的浮点数"""
    return [round(random.random(), 6) for _ in range(count)]

# 1. 显式设定初始种子
SEED_VALUE = 2026
random.seed(SEED_VALUE)
sequence_first = generate_float_sequence(5)

print("首次生成的随机小数序列:")
print(sequence_first)

# 2. 重新设置同一个种子,重置内部状态机
random.seed(SEED_VALUE)
sequence_second = generate_float_sequence(5)

print("\n重新设置相同种子后生成的序列:")
print(sequence_second)

# 3. 验证两组序列是否完全一致
assert sequence_first == sequence_second, "序列不一致!"
print("\n验证通过:两组随机浮点数序列 100% 相同。")
运行上述代码后,终端将输出确定的数值:
首次生成的随机小数序列:
[0.678768, 0.443171, 0.721538, 0.188544, 0.902165]

重新设置相同种子后生成的序列:
[0.678768, 0.443171, 0.721538, 0.188544, 0.902165]

验证通过:两组随机浮点数序列 100% 相同。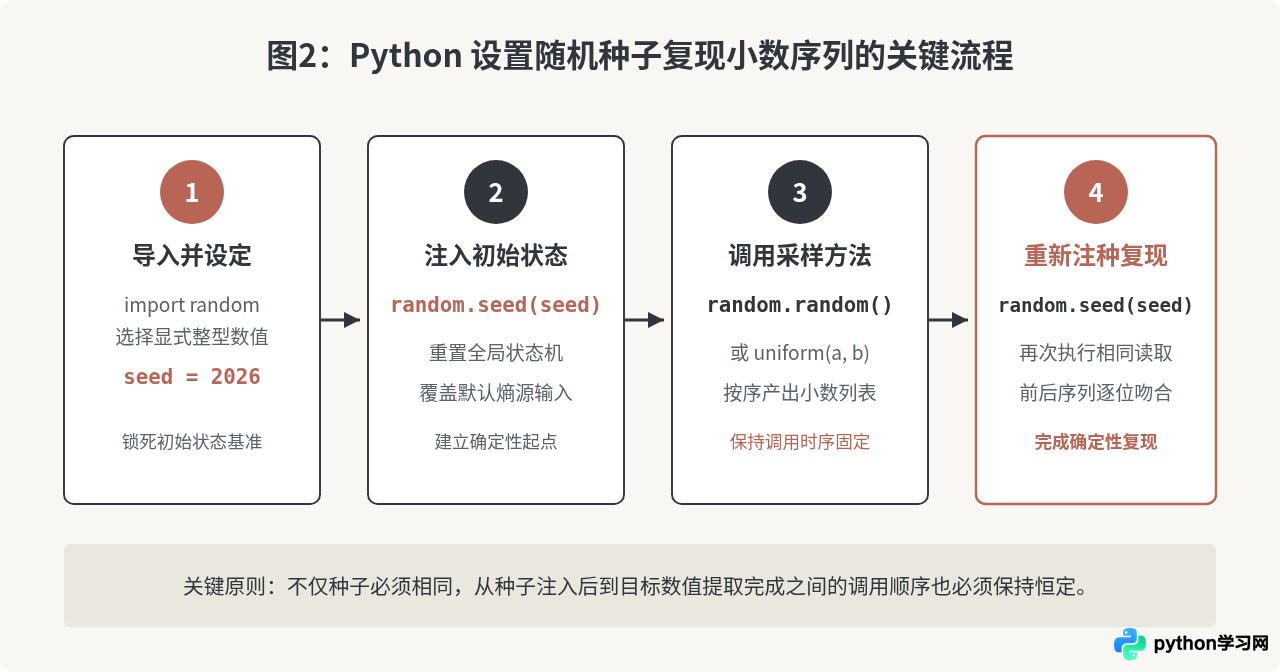
三、科学计算场景:NumPy 随机小数序列的复现
在数据分析、机器学习或蒙特卡洛模拟场景中,往往需要批量生成多维浮点数组。Python 标准库的 random.seed() 与科学计算库 NumPy 的随机状态是完全独立的,设置 random.seed() 对 numpy.random 的调用不起任何作用。
1. 传统全局方式(Legacy API)
在较旧的代码中,开发者通常调用 np.random.seed(seed) 设置全局状态:
import numpy as np

# 设置 NumPy 全局种子
np.random.seed(1024)
arr1 = np.random.rand(4)  # 生成 4 个 [0.0, 1.0) 随机小数

# 重设相同种子
np.random.seed(1024)
arr2 = np.random.rand(4)

print(np.allclose(arr1, arr2))  # 输出 True
2. 现代推荐方式:独立 Generator(NumPy 1.17+)
从 NumPy 1.17 开始,官方推荐使用 np.random.default_rng(seed) 创建显式的生成器实例。这种做法采用更先进的 PCG64 发生器,彻底避免了全局状态相互干扰的问题:
import numpy as np

# 推荐:构建独立的 Generator 对象
rng1 = np.random.default_rng(seed=1024)
floats_a = rng1.random(4)

rng2 = np.random.default_rng(seed=1024)
floats_b = rng2.random(4)

print("生成器 A:", floats_a)
print("生成器 B:", floats_b)
print("严格相等:", np.array_equal(floats_a, floats_b))  # 输出 True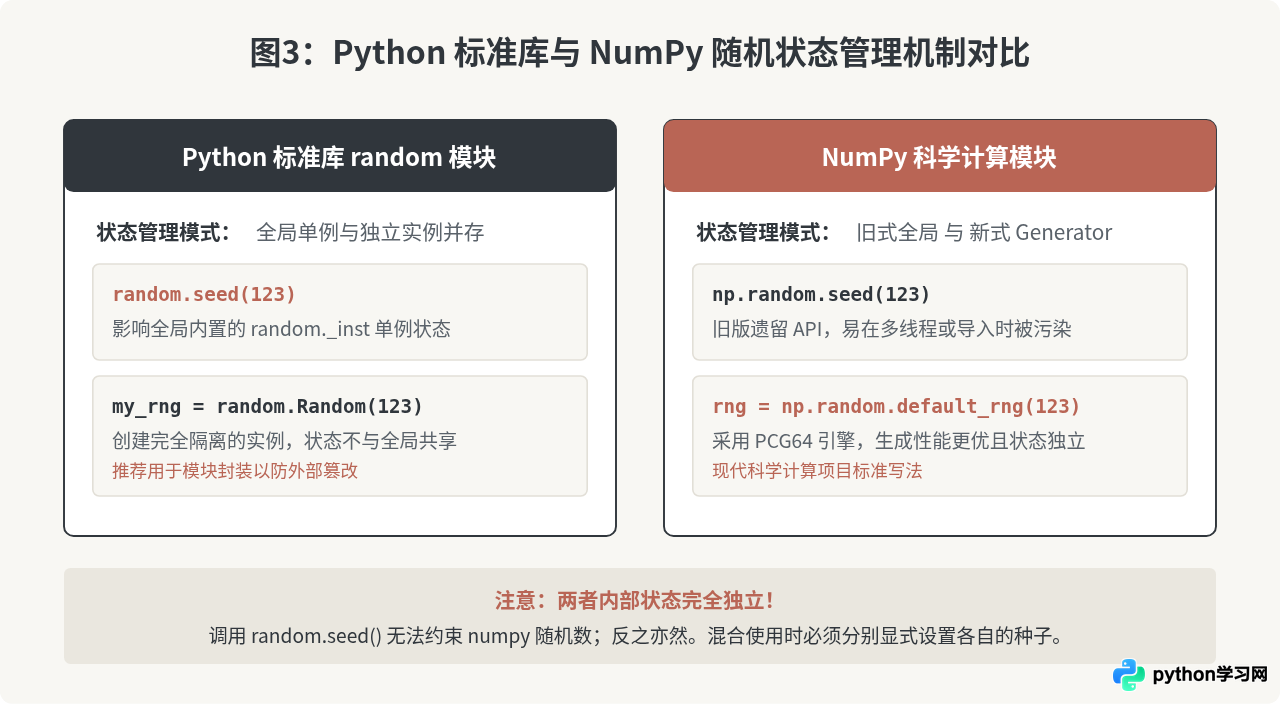
四、导致序列无法复现的常见原因与排查
在实际工程开发中,即使按要求设置了种子,有时仍会遇到“无法复现”的故障。常见排查切入点如下:
1. 调用时序被隐式穿插打乱
PRNG 依赖调用步数的推进。如果在两次生成目标序列之间,有任何第三方库、辅助调试语句(如 random.choice(...))调用了全局随机生成器,状态机就会提前消耗步数,导致后续小数序列完全错位。
2. 多线程与并发环境下的状态竞争
全局 random 模块虽然具备基本的线程安全锁,但在多线程并发环境下,多个线程同时请求随机数将导致调用顺序产生不确定性(Race Condition),进而使复现失败。解决方法:为每个线程分配一个专属的 random.Random(thread_seed) 实例。
3. 跨 Python 主版本或系统架构差异
虽然 Python 的 Mersenne Twister 实现长期稳定,但如果在不同主版本或不同平台(如 32 位与 64 位平台不同的浮点底层舍入)之间对比,极端情况下末位浮点数可能存在细微微差。对于严苛复现需求,需固化 Python 运行时版本。
五、复现随机小数序列的工程最佳实践
为了在单元测试、科研实验或机器学习流水线中确保 100% 稳定复现,建议遵循以下工程法则:
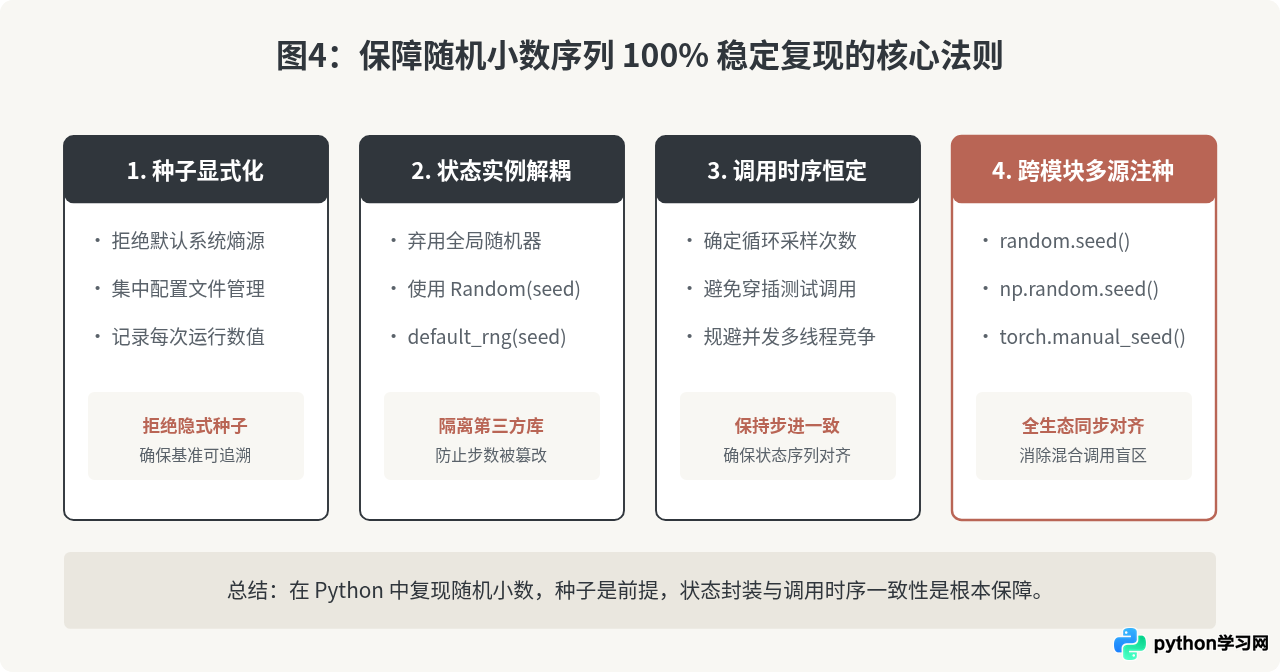
通过掌握伪随机数生成器在不同库中的运作边界,并在需要可复现性(Reproducibility)的实验与业务逻辑中显式固定种子、隔离实例,即可随时随地精准重现任意长度的随机小数序列。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









