

Python random模块生成随机浮点数的基础用法

random 提供了完备的随机数工具,其中最基础且最常用的是 random.random() 与 random.uniform(a, b)。本文将系统梳理这两个函数的基础语法、区间映射数学原理、边界端点特性以及常见的使用误区,帮助读者在具体场景中写出准确、规范的代码。
一、单位区间基础随机数:random.random()
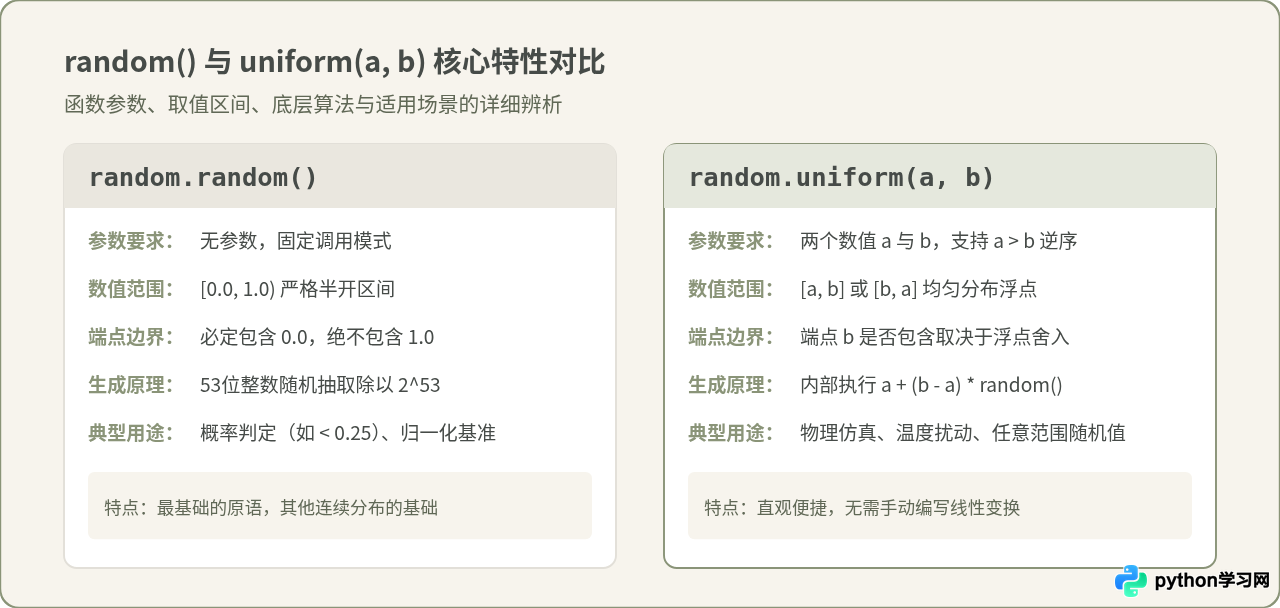
在 random 模块中,最核心的浮点数生成函数是 random.random()。该函数不需要传入任何参数,调用后会返回一个位于半开区间 [0.0, 1.0) 范围内的伪随机浮点数。
这里的“半开区间”具有严格的数学含义:返回的值可能等于 0.0,但严格小于 1.0。下面是其基本调用方式:
import random

# 生成 [0.0, 1.0) 区间内的随机浮点数
val = random.random()
print(f"生成的随机浮点数: {val}")

# 示例输出:
# 生成的随机浮点数: 0.7348128562719284
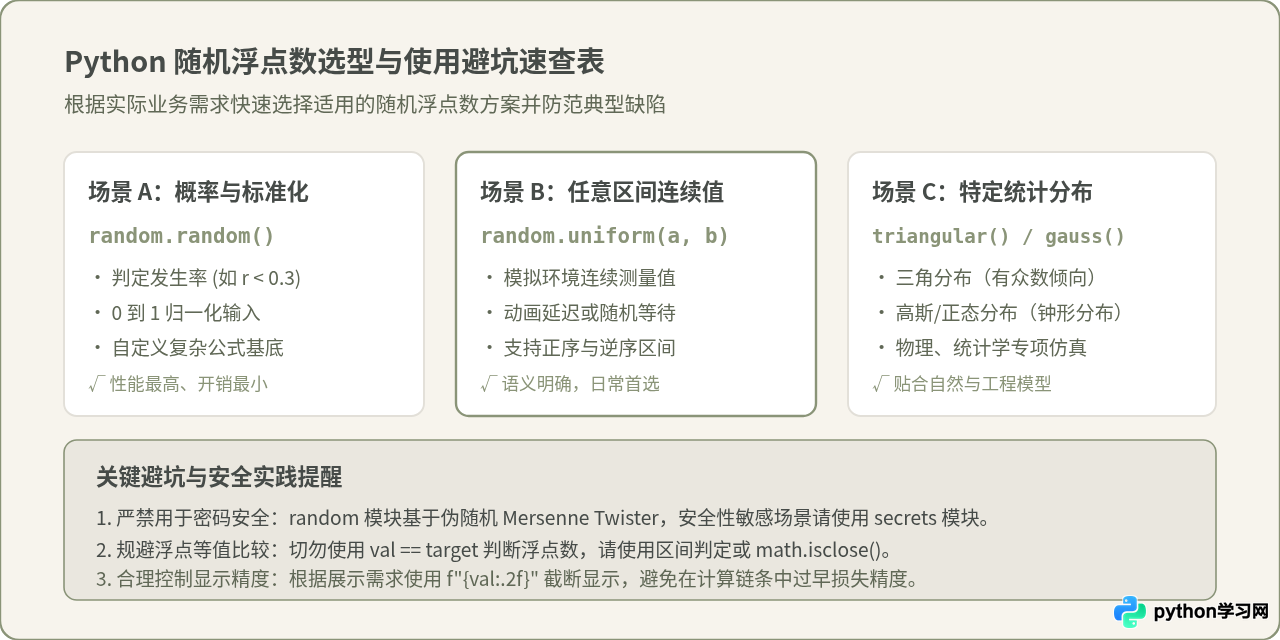
由于 random.random() 的输出严格规范在 0 到 1 之间,因此它经常被用作“命中率判定”的基准。例如需要实现一个发生概率为 30% 的事件时,只需判断 random.random() < 0.3 是否成立即可。
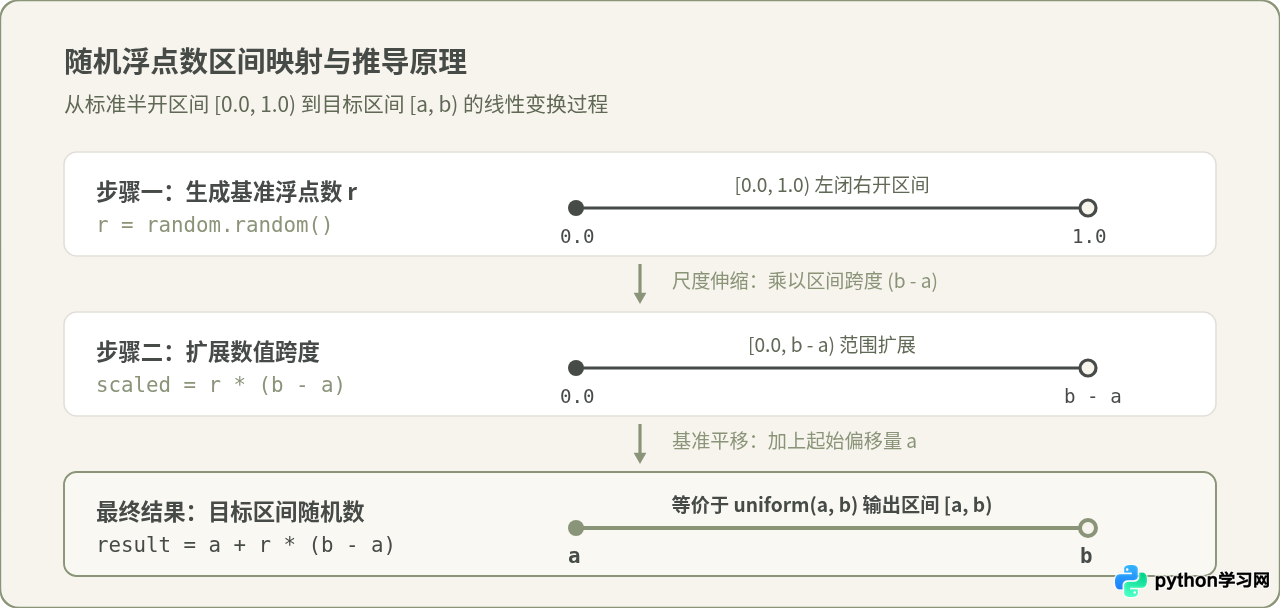
此外,任何任意范围 [a, b) 的随机浮点数,在数学本质上都可以通过对 random.random() 的返回值进行线性变换推导得出。
二、指定任意范围浮点数:random.uniform(a, b)
虽然我们可以手动通过 a + (b - a) * random.random() 计算任意区间的浮点数,但 random 模块已经封装了直接实现该逻辑的函数:random.uniform(a, b)。
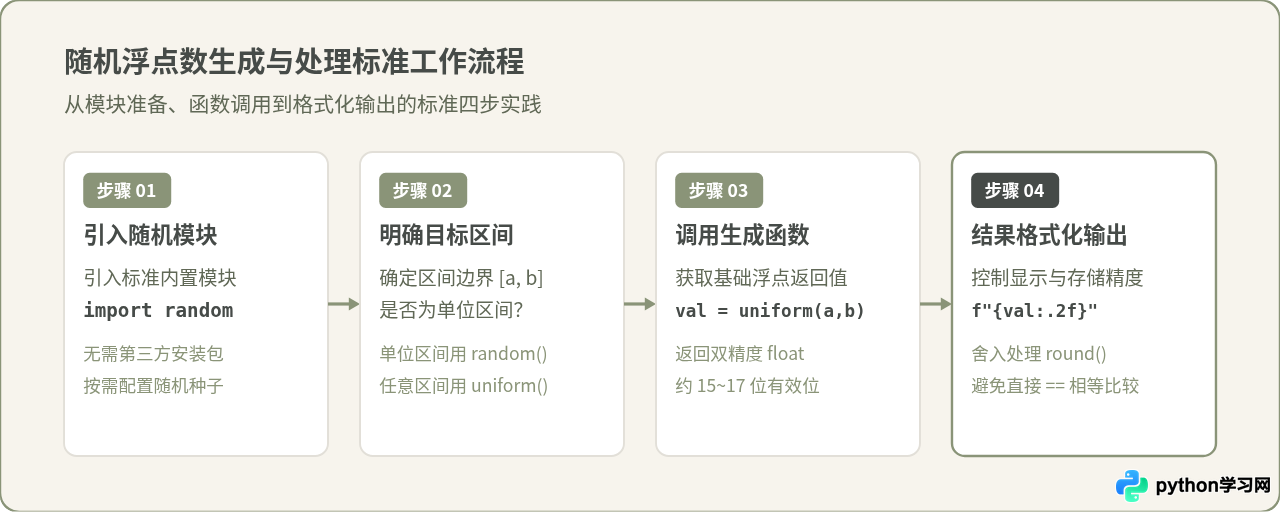
random.uniform(a, b) 接收两个数值参数 a 和 b,返回两者之间的均匀分布随机浮点数。
import random

# 生成 [10.0, 20.0] 范围内的随机浮点数
temp = random.uniform(10.0, 20.0)
print(f"生成的随机温度值: {temp:.2f}")

# 示例输出:
# 生成的随机温度值: 16.48
uniform(a, b) 的一个便利特性是参数顺序没有强制大小限制:
- 当
a < b时,返回在[a, b]区间内的数值; - 当
a > b时,例如random.uniform(20.0, 10.0),函数能够正常执行并返回同样在 10.0 到 20.0 之间的数值; - 当
a == b时,函数将确定性地直接返回参数a本身。
三、底层机制与边界辨析:能否取到端点?
在初学随机浮点数时,经常会遇到关于边界端点是否能被精确取到的疑问。我们需要从底层实现原理来理解这一问题。
1. random.random() 的严格边界
CPython 中的 random 模块使用梅森旋转算法(Mersenne Twister)作为核心生成器。为了生成 64 位双精度浮点数,底层实现会取出 53 位随机整数组装为分子 $k$(因为 IEEE 754 双精度的有效数字位正好是 53 位),并计算:
k * 2**-53 # 其中整数 k 满足 0 <= k < 2**53
因为 $k$ 的上限是 $2^{53} - 1$,所以分子永远严格小于分母 $2^{53}$。这意味着:random.random() 绝不可能返回 1.0,其理论取值严格保持在 [0.0, 1.0)。
2. random.uniform(a, b) 的端点舍入效应
与 random() 不同,Python 官方文档中对 uniform(a, b) 的范围描述为:
a <= b 时 a <= N <= b,当 b < a 时 b <= N <= a。终点 b 是否可能包含在区间内取决于浮点舍入方程 a + (b - a) * random()。”
在大多数情况下,由于 random() 不包含 1.0,计算得到的浮点数不会等于 b;但在极少数极端数值运算或特定舍入规则下,浮点运算的舍入误差理论上有极小概率将结果向上舍入为端点 b。因此在工程编程中,不应当假设端点 b 一定会出现,也不应当假设它绝对不会出现。
四、实际应用技巧与精度控制
1. 控制小数位数
由于 Python 的 float 类型为双精度浮点数,直接输出通常包含十多位小数。在展示或存储时,经常需要限制显示精度。建议通过格式化字符串进行展示控制:
import random

raw_val = random.uniform(1.0, 100.0)

# 方式一:格式化字符串(推荐用于展示)
formatted_str = f"{raw_val:.2f}"
print(f"字符串格式化 (保留2位): {formatted_str}")

# 方式二:round() 函数(用于需要数值参与后续运算)
rounded_val = round(raw_val, 2)
print(f"数值四舍五入 (保留2位): {rounded_val}")round() 会导致累积截断误差。
2. 使用 random.seed() 保证结果可复现
在进行算法调试、单元测试或教学演示时,经常希望每次运行程序时生成的随机数序列完全一致。此时可以使用 random.seed() 设置随机数种子:
import random

# 固定种子
random.seed(42)
print(random.uniform(1.0, 5.0))  # 每次在相同种子下首次执行时结果固定

random.seed(42)
print(random.uniform(1.0, 5.0))  # 输出将与上方完全一致
五、选型指南与安全边界
除了均匀分布外,标准库还提供了面向统计需求的扩展浮点函数:
random.triangular(low, high, mode):生成指定上下界及众数(峰值)的三角分布浮点数,适合模拟工期估算等非均匀分布。random.gauss(mu, sigma):生成均值为mu、标准差为sigma的高斯(正态)分布浮点数。
六、必须掌握的避坑清单
-
不要对随机浮点数使用
==进行精确等值比较:由于计算机底层 IEEE 754 浮点数表示特性的限制,连续浮点数极难精准命中某一个离散浮点值。应始终使用区间判断(例如low <= val < high)或math.isclose(a, b)进行容差比较。 -
不要在每次生成随机数前重复调用
seed():如果在循环体内每次调用random.seed()(尤其是在基于时间戳重置种子时),会导致伪随机序列被反复重置,进而生成大量重复或高度关联的“虚假随机数”。种子通常只应在程序初始化时配置一次。 -
注意伪随机性与安全边界:
random模块生成的所有随机数均为伪随机数(PRNG),其内部状态在获取一定样本后可被完全预测。涉及密钥、Token、密码重置验证码等安全敏感业务时,必须换用 Python 3.6+ 内置的secrets模块。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









