

Python字典添加数据时怎么避免覆盖原有值
详细讲解在Python字典中添加数据时避免覆盖原有值的多种方案。涵盖保留首次写入值、一对多列表归集、数值计数累加、多字典安全合并以及主动抛错防御式编程等完整实用指南。
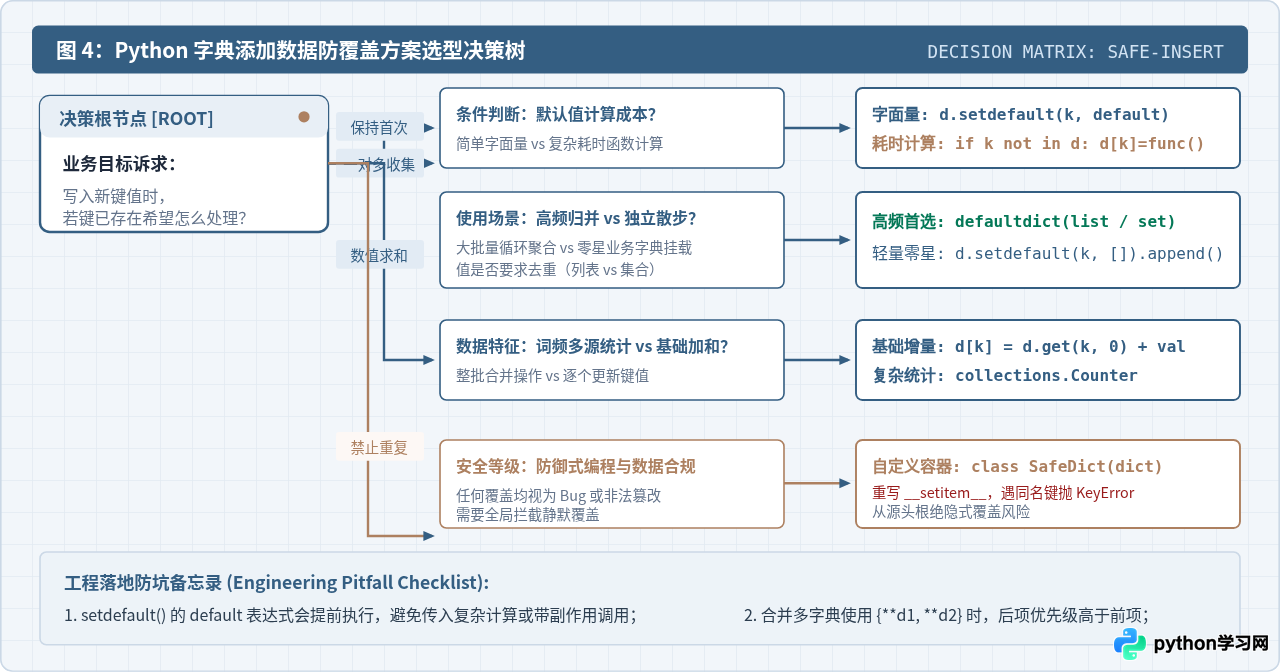
d[key] = value 赋值时,如果该键已经存在,原有值会被新值无条件替换。避免覆盖的解决路径取决于具体业务需求:若要求“已存在则忽略新数据”,可采用 if key not in d 显式检查或 dict.setdefault();若要求“保留全部历史数据”,应将值结构升级为列表或集合,配合 collections.defaultdict(list) 归集;若属于“统计与增量累加”,可借助 dict.get() 默认值或 Counter;若属于“防御脏数据篡改”,则需通过自定义字典或判断主动抛出异常阻断。
一、为什么直接赋值会导致覆盖?
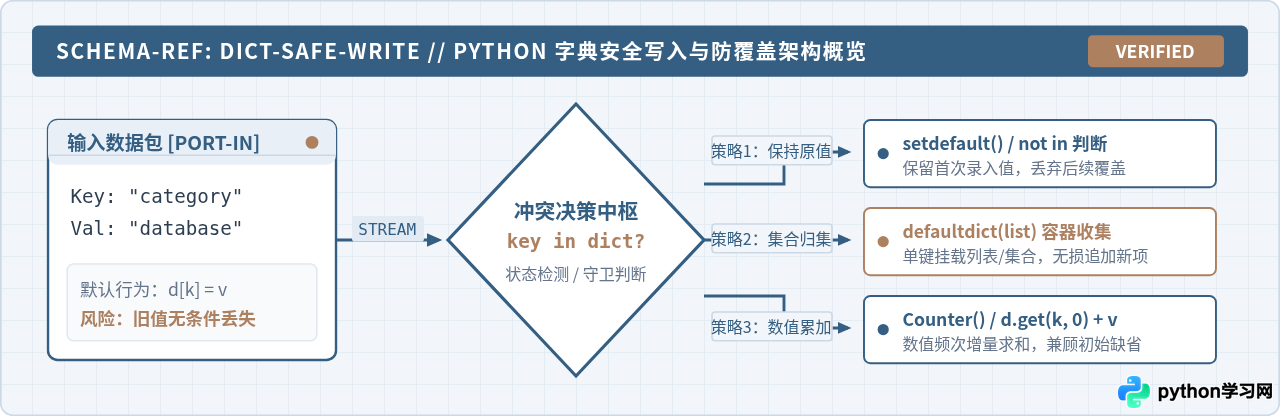
Python 字典的底层是基于哈希表(Hash Table)实现的紧凑数组结构。字典的一个基本契约是“键的唯一性”(Key Uniqueness)。在执行 d[key] = new_value 操作时,解释器首先计算 hash(key) 并定位对应的哈希槽位(Bucket)。
如果该槽位中尚未记录当前键,解释器会创建新的索引映射,完成正常插入;但如果该键已存在,解释器的默认行为是直接将旧值的对象引用指针替换为新值的引用指针。此时原有的旧值对象解除与该键的绑定,若外部没有其他变量引用该旧值,它便会进入垃圾回收(GC),造成不可逆的数据丢失。
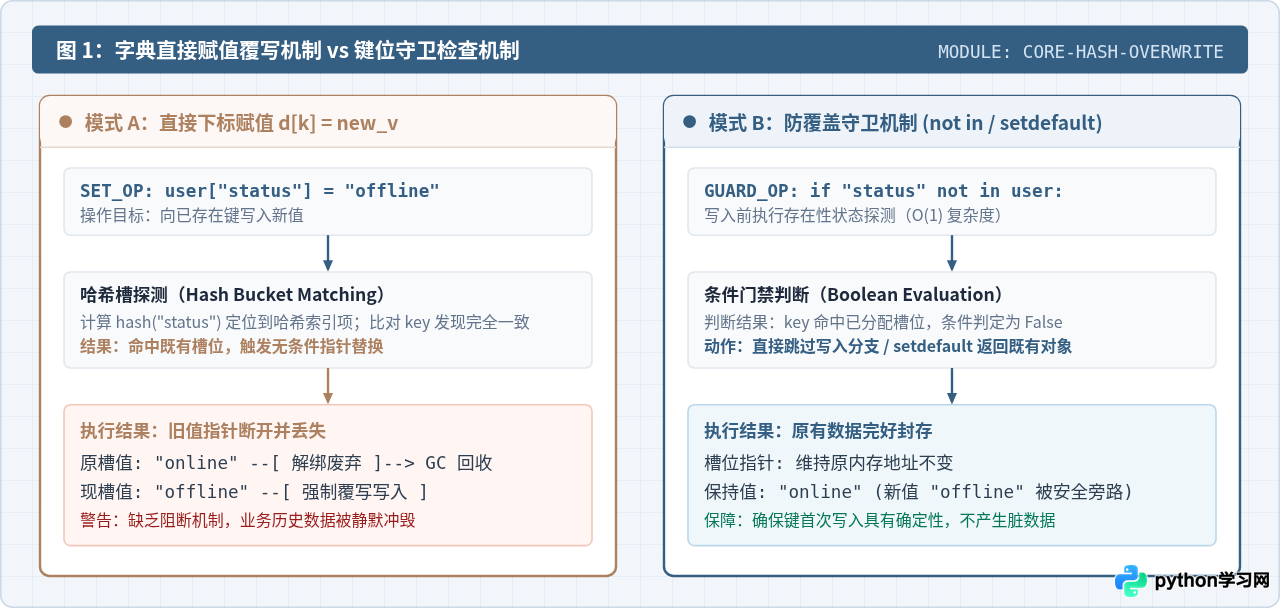
要打破这一静默覆盖的行为,核心在于在赋值发生前引入判断守卫,或者改变字典存储单值的模式。下面按照不同业务场景给出具体可执行的代码模式与注意事项。
二、场景一:已存在则忽略,仅在键不存在时写入
当字典用于保存初始配置、首次注册信息或首次观测状态时,通常要求“先到先得”,后续传入的同名键数据必须自动丢弃,保持首次写入的值不变。
方法 1:使用 if key not in dict 显式检查(推荐)
这是语义最清晰、执行最可控的方法。通过 in 关键字对键的存在性进行检查,时间复杂度为 \(O(1)\)。
# 环境:Python 3.7+
user_status = {"alice": "active"}

new_key = "alice"
new_value = "offline"

# 显式安全检查:不存在才执行赋值
if new_key not in user_status:
    user_status[new_key] = new_value
else:
    print(f"提示:键 '{new_key}' 原有值 '{user_status[new_key]}' 保留,写入已跳过。")

print("当前字典内容:", user_status)提示:键 'alice' 原有值 'active' 保留,写入已跳过。
当前字典内容: {'alice': 'active'}
if key not in dict。这样在键已存在时,新值的生成逻辑根本不会被触发,能够有效避免无谓的性能损耗。
方法 2:使用 dict.setdefault(key, default)
Python 字典内置了 setdefault() 方法。它的行为是:如果键不在字典中,则插入键并设置值为默认值;如果键已在字典中,则不作修改,并直接返回该键已有的值。
config = {"timeout": 30}

# "timeout" 已存在,返回原值 30,不会被 60 覆盖
res1 = config.setdefault("timeout", 60)

# "retries" 不存在,插入键值对 ("retries", 3) 并返回 3
res2 = config.setdefault("retries", 3)

print("config:", config)
print("res1:", res1, "| res2:", res2)config: {'timeout': 30, 'retries': 3}
res1: 30 | res2: 3
config.setdefault("timeout", calculate_heavy_data()) 时,即使 "timeout" 已经存在,calculate_heavy_data() 依然会被执行,只是其返回值会被丢弃。若参数计算开销大,请坚持使用方法 1。
三、场景二:键重复时全部保留(一对多列表/集合归集)
在日志分析、商品分类或标签聚合等场景中,一个键往往对应多个数据项。避免覆盖的正确方式不是替换值,而是将值存储为列表(List)或集合(Set,用于自动去重)容器。
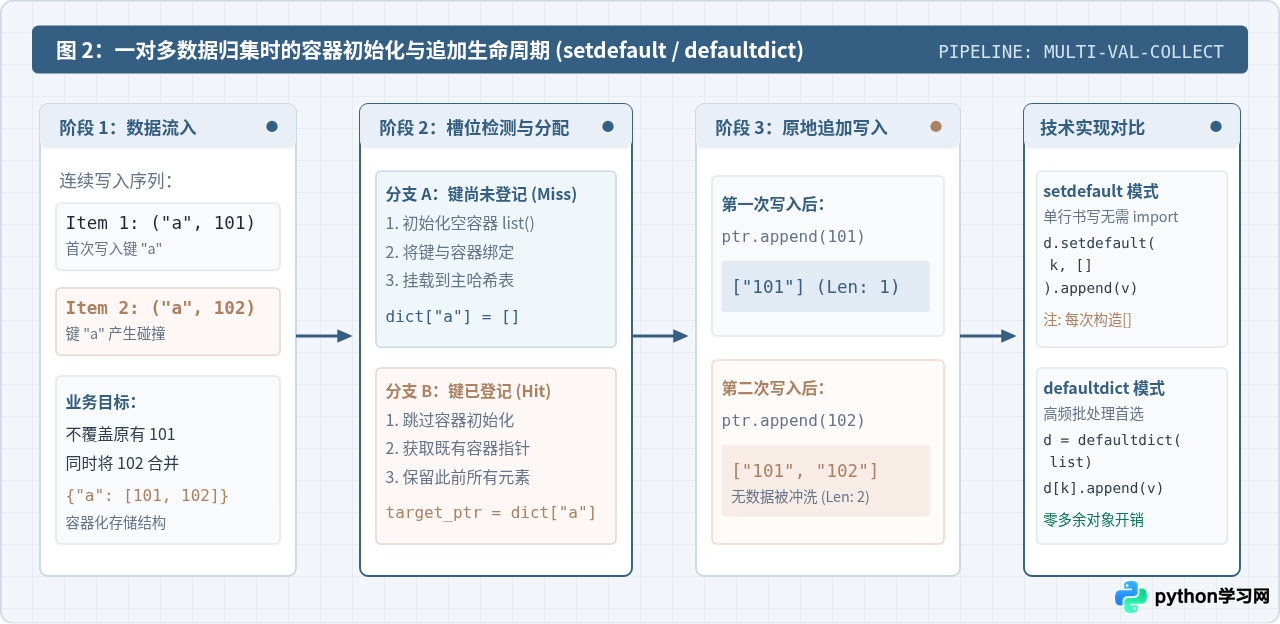
方法 1:使用 setdefault 初始化列表并追加
利用 setdefault 返回当前容器引用的特性,在单行内完成“不存在则创建新列表,存在则复用既有列表并追加”。
book_catalog = {}

records = [
    ("Python", "流畅的Python"),
    ("Database", "MySQL高性能实战"),
    ("Python", "编写高质量Python代码")
]

for category, book_name in records:
    # 若 category 不存在,初始化为 [];若存在,返回既有列表,并调用 .append()
    book_catalog.setdefault(category, []).append(book_name)

print(book_catalog){'Python': ['流畅的Python', '编写高质量Python代码'], 'Database': ['MySQL高性能实战']}
方法 2:使用 collections.defaultdict(高频写入最优实践)
如果需要在循环中持续写入大量数据,标准库的 collections.defaultdict 性能更优。它通过传入工厂函数(如 list 或 set),在键缺失时自动调用工厂创建默认容器,代码极度凝练且免去了重复构建临时对象的开销。
from collections import defaultdict

# 工厂函数传入 list;若要求值互不相同,可传入 set 并使用 .add()
tag_indexer = defaultdict(list)

logs = [
    ("error", "磁盘IO超时"),
    ("info", "系统正常启动"),
    ("error", "连接池耗尽")
]

for level, msg in logs:
    tag_indexer[level].append(msg)

# 转为普通 dict 输出
print(dict(tag_indexer)){'error': ['磁盘IO超时', '连接池耗尽'], 'info': ['系统正常启动']}
四、场景三:数值统计场景下的累加防覆盖
在统计词频、点击量或库存变动时,新添加的数据通常不是替代旧数值,而是在原数值上叠加。如果直接执行 d[k] = val,前序累计数值将被完全抹除。
方法 1:利用 dict.get(key, 0) 赋默认值累加
inventory = {"apple": 10, "banana": 5}
new_shipment = [("apple", 15), ("orange", 8), ("banana", 2)]

for fruit, quantity in new_shipment:
    # 若 fruit 不存在,get 返回 0,再加上 quantity,写回原键
    inventory[fruit] = inventory.get(fruit, 0) + quantity

print(inventory){'apple': 25, 'banana': 7, 'orange': 8}
方法 2:使用 collections.Counter 原生计数器
标准库 Counter 是专门针对累加统计设计的字典子类,支持使用加法运算符 + 或 update() 方法直接合并数据,完全避免覆盖。
from collections import Counter

c_exist = Counter({"cpu_alert": 3, "mem_alert": 1})
c_new = Counter({"cpu_alert": 2, "disk_alert": 4})

# 相加自动合并同名键的数值,不存在覆盖问题
total_alerts = c_exist + c_new
print(total_alerts)Counter({'cpu_alert': 5, 'disk_alert': 4, 'mem_alert': 1})
五、场景四:多字典批量合并时防止键覆盖
在日常开发中,合并两个字典是引发键覆盖的重灾区。Python 3.9+ 提供了字典合并运算符 d1 | d2,在解包语法 {**d1, **d2} 中,规则均为右侧字典的值无条件覆盖左侧字典的值。
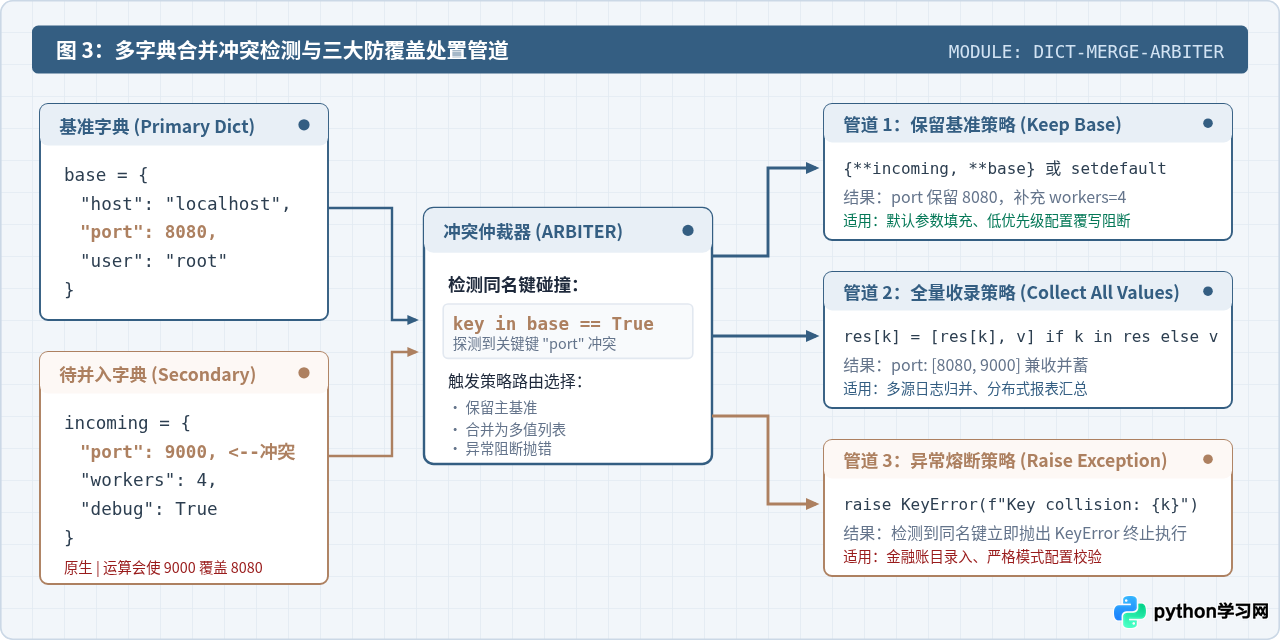
当需要确保基础字典中的原有值不被新字典篡改时,可以通过调整解包顺序,或编写受控的合并管道函数:
base_settings = {"host": "127.0.0.1", "port": 8080, "auth": True}
user_input = {"port": 9000, "debug": True}

# 策略 A:调整解包顺序,使 base_settings 放在右侧,保持原有配置不被 user_input 冲掉
safe_defaults_applied = {**user_input, **base_settings}
print("策略A (保持base已有值):", safe_defaults_applied)

# 策略 B:编写函数显式处理冲突,可选择保留原值、抛错或合并为列表
def merge_dicts_safely(primary: dict, incoming: dict, mode: str = "keep_primary") -> dict:
    merged = primary.copy()
    for k, v in incoming.items():
        if k in merged:
            if mode == "keep_primary":
                continue  # 遇到已有键,保留原有值,跳过新值
            elif mode == "raise_error":
                raise KeyError(f"合并键冲突阻断:键 '{k}' 已在主字典中存在!")
            elif mode == "collect_list":
                if not isinstance(merged[k], list):
                    merged[k] = [merged[k]]
                merged[k].append(v)
        else:
            merged[k] = v
    return merged

res_collected = merge_dicts_safely(base_settings, user_input, mode="collect_list")
print("策略B (归集全部冲突):", res_collected)策略A (保持base已有值): {'port': 8080, 'debug': True, 'host': '127.0.0.1', 'auth': True}
策略B (归集全部冲突): {'host': '127.0.0.1', 'port': [8080, 9000], 'auth': True, 'debug': True}
六、场景五:防御式编程——出现覆盖时主动抛出异常
在财务计算、权限控制或核心配置文件加载等严格数据场景中,任何同名键的出现都代表上游数据源存在逻辑错误。与其静默覆盖或容忍冲突,最好的防御手段是主动抛出 KeyError 异常终止程序。
我们可以继承原生 dict 并重写 __setitem__ 方法,实现一个全局防覆盖的安全字典类:
class StrictSafeDict(dict):
    """遇到同名键写入时主动抛出异常的防覆盖字典类"""
    def __setitem__(self, key, value):
        if key in self:
            raise KeyError(f"禁止覆盖安全违规:键 '{key}' 已存在,其当前值为 {self[key]!r}")
        super().__setitem__(key, value)

account_balances = StrictSafeDict()
account_balances["ACC-1001"] = 5000.00

try:
    # 尝试对已有账户做误操作写入
    account_balances["ACC-1001"] = 1200.00
except KeyError as e:
    print(f"捕获防御异常: {e}")

print("账户最终安全数据:", account_balances)捕获防御异常: "禁止覆盖安全违规:键 'ACC-1001' 已存在,其当前值为 5000.0"
账户最终安全数据: {'ACC-1001': 5000.0}
七、方案选型矩阵与核心决策树
为便于在实际工程中快速决策,下表归纳了不同防覆盖方案的语法形态、性能特征及典型适用场景:
| 场景诉求 | 典型实现语法 | 冲突时行为 | 时间复杂度 | 优选建议 |
|---|---|---|---|---|
| 已存在则保留 | if k not in d: d[k]=v |
丢弃新值,保留原值 | \(O(1)\) | 新值计算耗时时首选 |
| 简单值首次写入 | d.setdefault(k, default) |
返回已有值,不修改 | \(O(1)\) | default 仅为常量字面量时可用 |
| 高频一对多归集 | defaultdict(list)[k].append(v) |
将新值追加进列表/集合 | \(O(1)\) | 循环批量聚类、多标签处理首选 |
| 轻量一对多追加 | d.setdefault(k, []).append(v) |
初始化空列表并追加 | \(O(1)\) | 无需 import collections 时的单行写法 |
| 数值计数增量 | d[k] = d.get(k, 0) + val |
基数累加,不覆盖 | \(O(1)\) | 词频、库存、指标递增统计 |
| 严格防御式校验 | 继承 dict 重写 __setitem__ |
抛出 KeyError 阻断 | \(O(1)\) | 核心财务、身份认证、权限配置系统 |
八、总结与操作排查检查单
在 Python 字典操作中彻底避免意外覆盖,请在编码和代码评审(Code Review)中遵循以下三条核心准则:
- 明确数据映射关系:在动手编码前,判断业务中该键与值是一对一还是“一对多”。若为一对多,在一开始就应将字典初始化为
defaultdict(list)或defaultdict(set),从结构根源上杜绝单值覆写。 - 警惕 setdefault 的参数预计算:在只需要“不存在才设值”且默认值计算代价较高时,不要为了写单行代码而盲目套用
setdefault,应回归到标准的if key not in dict:结构。 - 字典合并检查右侧覆盖:使用
{**a, **b}或a | b时,务必清楚右侧对象优先级更高。若要保护已有键不被冲掉,必须将基准字典置于右侧,或采用显式比对的受控循环。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









