

Python字典实战:怎么用字典进行数据计数与分组
深入讲解在Python中如何使用字典高效进行数据计数与分组,详细解析基础dict、dict.get、setdefault、collections.defaultdict以及collections.Counter的核心实现、性能差异与避坑指南。
在数据处理、业务报表统计和日志解析过程中,统计某项离散元素出现的频次(计数)以及将特定属性相同的记录归集到一起(分组),是最基础且高频的操作需求。Python 的核心内置数据结构字典(dict)基于哈希表实现,具备平均 O(1) 的查找与插入效率,是执行数据计数与分组的首选载体。本文将从基础字典语法出发,循序渐进地讲解 dict.get()、setdefault()、collections.defaultdict 以及专门的 collections.Counter 的具体用法与工程考量,帮助读者根据不同的业务场景选择最适宜、最高效的代码实现方式。
一、数据计数的四种常见实现方式与对比
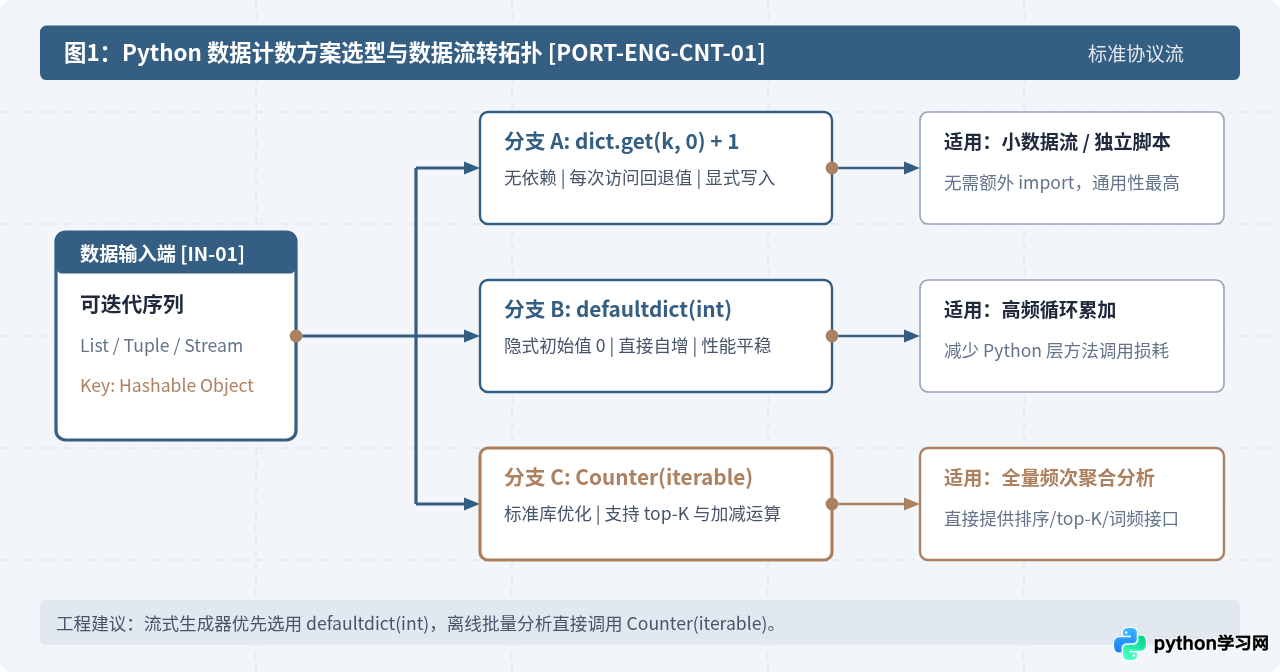
计数的本质是将待统计的目标值作为字典的键(Key),将累计出现的次数作为字典的值(Value)。在遍历数据集合时,若键尚不存在,需要先将其初始化为基础计数;若键已存在,则在原有数值上递增。针对键的初次初始化与递增过程,Python 提供了四种典型的处理方式。
1. 方式一:显式成员检查(if key not in dict)
这是最符合直觉的入门写法:在每次更新前,使用 in 关键字显式检查键是否已存在于字典中。若不存在则初始化为 0,随后无条件执行累加。
# 示例输入:访问日志中的模块标识
modules = ["auth", "payment", "auth", "order", "payment", "auth"]

count_dict = {}
for mod in modules:
    if mod not in count_dict:
        count_dict[mod] = 0
    count_dict[mod] += 1

# 示例输出:{'auth': 3, 'payment': 2, 'order': 1}
print(count_dict)
这种写法语义明确,逻辑毫无隐式分支,但在每一次循环中都会涉及成员判断和二次索引查找,代码稍显冗长。
2. 方式二:使用 dict.get() 设定备用初值
Python 字典的 get(key, default) 方法允许我们在查询键时指定回退值。若键不存在,则返回指定的默认值而不抛出 KeyError。借助这一特性,可将判断与自增合并为一行:
count_dict = {}
for mod in modules:
    count_dict[mod] = count_dict.get(mod, 0) + 1

# 示例输出:{'auth': 3, 'payment': 2, 'order': 1}
print(count_dict)
此方法无需导入任何外部模块,语法极其精简,是编写通用无依赖脚本时的常用手段。
3. 方式三:使用 collections.defaultdict(int)
当字典被频繁写入、且默认初始值固定时,标准库 collections 提供的 defaultdict 是更优的工程选择。向其传入工厂函数 int,当访问不存在的键时,它会自动调用 int() 生成初始整数 0 并存入字典,调用方可以直接进行 += 1 操作。
from collections import defaultdict

count_dict = defaultdict(int)
for mod in modules:
    count_dict[mod] += 1

# 示例输出:defaultdict(<class 'int'>, {'auth': 3, 'payment': 2, 'order': 1})
print(dict(count_dict))
4. 方式四:使用开箱即用的 collections.Counter
如果手头的数据已经是现成的可迭代对象(如列表、字符串、元组),且目的只是统计整体频次,collections.Counter 是最为高效的高层抽象。它内部以 C 级别的高速循环完成了元素统计,并封装了诸如 most_common() 等常用方法。
from collections import Counter

# 一行代码完成全部计数统计
module_counter = Counter(modules)

# 获取频次前两名的模块
print(module_counter.most_common(2))
# 示例输出:[('auth', 3), ('payment', 2)]
二、数据分组的进阶实战:从简单分类到多级聚合
与计数不同,数据分组(Group by)的目标是把相同特征的元素汇聚到同一个容器内(通常是列表 list 或集合 set)。分组字典的键是分组标识(Group Key),值则是归属于该组的实体集合。
1. 方式一:利用基础 dict 配合成员判定
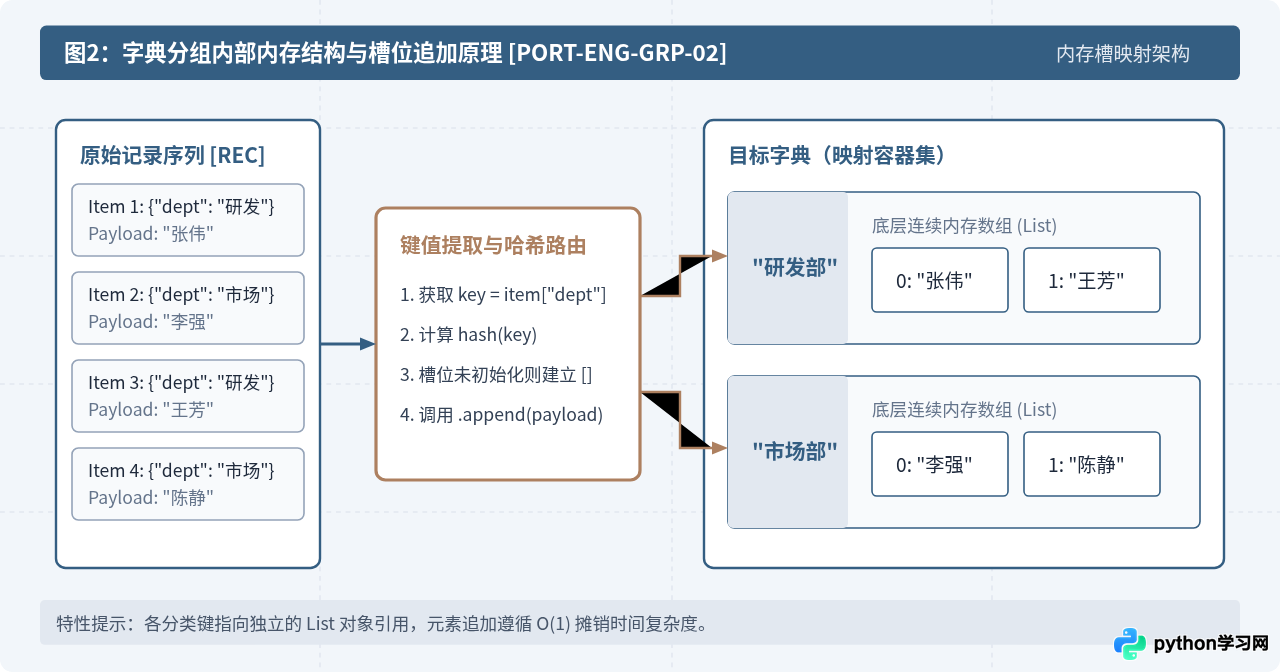
最严谨的基础写法依然是判断键是否存在,若首次遇到新分类,则先初始化一个空列表,再通过 append() 将当前项追加进去:
# 示例员工列表数据
employees = [
    {"dept": "研发部", "name": "张伟", "salary": 18000},
    {"dept": "市场部", "name": "李强", "salary": 12000},
    {"dept": "研发部", "name": "王芳", "salary": 22000},
    {"dept": "运营部", "name": "刘敏", "salary": 11000},
    {"dept": "市场部", "name": "陈静", "salary": 15000},
]

grouped = {}
for emp in employees:
    dept = emp["dept"]
    if dept not in grouped:
        grouped[dept] = []
    grouped[dept].append(emp)

# 打印研发部的分组名单
print([e["name"] for e in grouped["研发部"]])
# 示例输出:['张伟', '王芳']
2. 方式二:使用 dict.setdefault()
内置方法 dict.setdefault(key, default) 在键不存在时插入键并将默认值关联给它,随后无论键是新创建还是已存在,该方法都会返回当前键所对应的值。因此可以写出紧凑的分组语句:
grouped = {}
for emp in employees:
    grouped.setdefault(emp["dept"], []).append(emp)
注意 setdefault 的开销细节:在每次调用 grouped.setdefault(emp["dept"], []) 时,Python 都会在执行参数传递之前在内存中新建一个空的 [] 列表对象。如果键已经存在,这个刚刚新建的空列表会被立刻丢弃并触发垃圾回收。在面对数百万条规模的数据循环时,这种无效的对象创建与销毁会产生额外的性能开销。
3. 方式三:使用 collections.defaultdict(list)(推荐实践)
在工程实践中,数据分组的最优解通常是 defaultdict(list)。与 int 类似,传入 list 作为工厂函数后,一旦遇到未见过的分组键,它会在首次索引时才延迟调用 list() 创建容器,既消除了显式判断,也避免了无谓的空列表频繁实例化。
from collections import defaultdict

grouped = defaultdict(list)
for emp in employees:
    grouped[emp["dept"]].append(emp["name"])

# 示例输出:{'研发部': ['张伟', '王芳'], '市场部': ['李强', '陈静'], '运营部': ['刘敏']}
print(dict(grouped))
三、计数与分组的组合场景:频次统计后的业务分组
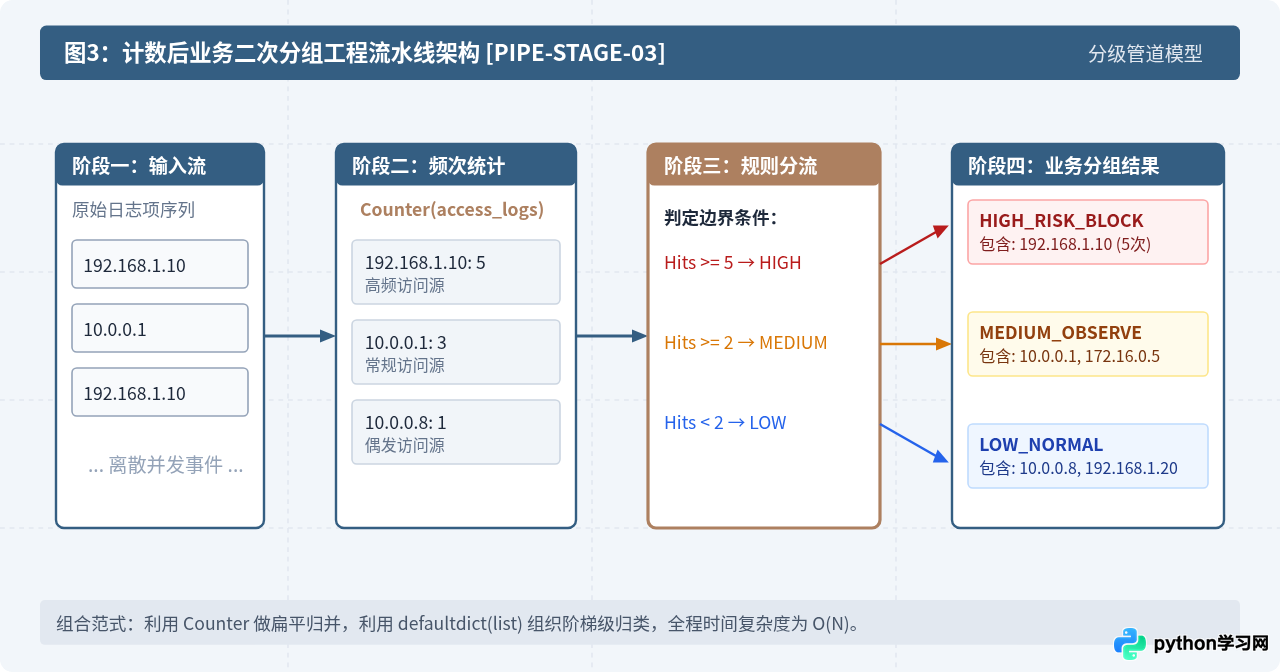
在实际系统开发中,计数与分组往往是前后衔接的阶段任务。例如在服务端接口安全防护中,需要实时解析访问日志:第一阶段统计各个 IP 的访问请求频次;第二阶段根据访问量阈值,将 IP 归类到不同的风控风险等级分组中,以便分发给后续的处置服务。
下面是一个完整的可执行实战代码示例:
from collections import Counter, defaultdict

# 模拟 Web 访问日志序列(含多个客户端 IP)
access_logs = [
    "192.168.1.10", "10.0.0.1", "192.168.1.10", "172.16.0.5",
    "192.168.1.10", "10.0.0.1", "192.168.1.10", "192.168.1.10",
    "10.0.0.8", "172.16.0.5", "10.0.0.1", "192.168.1.20"
]

# 第一步:数据计数(统计每个 IP 的独立访问次数)
ip_counts = Counter(access_logs)

# 第二步:依据计数结果进行风控层级分组
# 规则:访问量 >= 5 归为高危封禁组;>= 2 归为观察组;其余归为正常组
risk_grouped = defaultdict(list)

for ip, count in ip_counts.items():
    if count >= 5:
        risk_level = "HIGH_RISK_BLOCK"
    elif count >= 2:
        risk_level = "MEDIUM_RISK_OBSERVE"
    else:
        risk_level = "LOW_RISK_NORMAL"

    # 将包含频次元数据的字典追加至对应风险组
    risk_grouped[risk_level].append({"ip": ip, "total_hits": count})

# 输出各分组的整理结果
for level, items in risk_grouped.items():
    print(f"[{level}] 共计 {len(items)} 个 IP:")
    for item in items:
        print(f"  - IP: {item['ip']}, 访问次数: {item['total_hits']}")
控制台示例输出结果如下:
[HIGH_RISK_BLOCK] 共计 1 个 IP:
  - IP: 192.168.1.10, 访问次数: 5
[MEDIUM_RISK_OBSERVE] 共计 2 个 IP:
  - IP: 10.0.0.1, 访问次数: 3
  - IP: 172.16.0.5, 访问次数: 2
[LOW_RISK_NORMAL] 共计 2 个 IP:
  - IP: 10.0.0.8, 访问次数: 1
  - IP: 192.168.1.20, 访问次数: 1
四、关键注意事项与避坑指南
在运用字典进行数据处理时,一些隐蔽的语法行为若未加留神,容易导致意外的内存泄漏或逻辑错误。以下是需要重点把控的要点:
1. defaultdict 的自动建键副作用(查询陷阱)
defaultdict 的主要优势在于“按需自建”,但这一机制在只读查询时同样生效。如果使用方直接通过 d[unknown_key] 检查某个键的内容,即使该键先前未曾录入,defaultdict 也会强制在底层创建它,并赋予默认初始值(例如 0 或 [])。
from collections import defaultdict
grouped = defaultdict(list)

# 仅做检查,本意是看其是否存在
if grouped["unknown_dept"]:
    pass

# 此时 grouped 中已经被隐式插入了键值对: {'unknown_dept': []}
print(dict(grouped))
避坑做法:在完成分组逻辑进入只读阶段后,建议通过 dict(grouped) 转换为普通字典;或者在只读查询时依然使用 in 关键字进行前置检查(in 操作不会触发默认值的创建)。
2. 嵌套多级分组的实现与控制
在面对“先按省份分组、再按城市分组”等多维聚合场景时,可以嵌套定义 defaultdict:
from collections import defaultdict

# 定义嵌套工厂:外层找不到键时,生成内层 defaultdict(list)
tree_grouped = defaultdict(lambda: defaultdict(list))

tree_grouped["广东"]["广州"].append("天河区")
tree_grouped["广东"]["深圳"].append("南山区")

# 转换外层内层为常规 dict 输出
plain_result = {k: dict(v) for k, v in tree_grouped.items()}
print(plain_result)
# 示例输出:{'广东': {'广州': ['天河区'], '深圳': ['南山区']}}
3. 分组键的可哈希性约束(Hashable)
字典的键必须是可哈希对象。列表 list、字典 dict 和集合 set 均属于可变对象,不能直接充当键。若需要根据复合字段进行分组,应当将其组合为不可变的元组(tuple):
# 错误示范:grouped[["2026-10", "A1"]] = ... -> 报 TypeError: unhashable type: 'list'
# 正确做法:使用元组作为复合分组键
composite_key = ("2026-10", "A1")
grouped = defaultdict(list)
grouped[composite_key].append(record_id)
五、总结
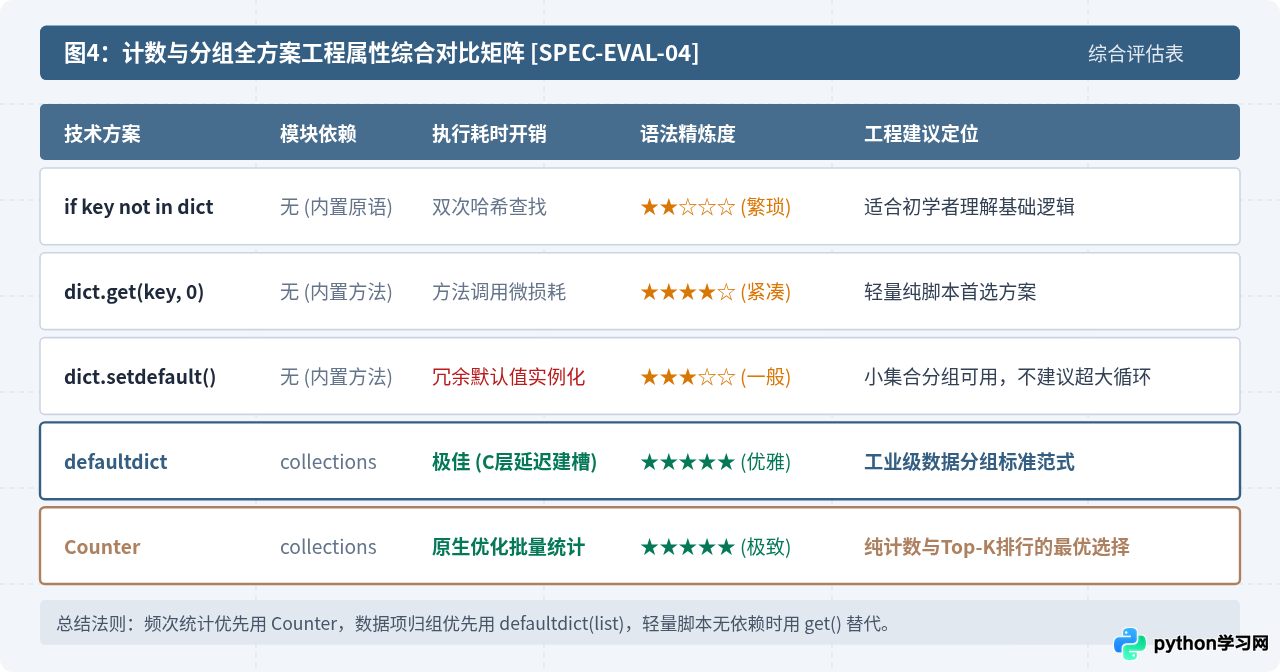
在 Python 中利用字典进行数据计数与分组,关键在于根据业务数据形态和工程要求选取最合适的工具:
- 数据计数场景:如果是对一个现成的序列做词频或指标频次统计,直接使用
collections.Counter是最为精炼且运行最高效的方案;若是在复杂的外部循环或数据流监听中不断累加,collections.defaultdict(int)能够提供整洁的代码并规避分支判断;而在没有第三方依赖要求的独立短脚本中,dict.get(key, 0) + 1依然是轻便顺手的利器。 - 数据分组场景:
collections.defaultdict(list)是承接列表归集的核心标准解法,它具备延迟初始化的特性,不会在迭代中产生无效对象;在使用普通字典的setdefault()时需注意默认参数预先求值的内存影响。
掌握这些基础与标准库工具的运作机制,能够帮助开发者写出执行速度快、内存开销可控且意图清晰的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









