

Python字典添加键值对时怎么避免覆盖原有数据

d[key] = value 会直接覆盖已有键所对应的原始数据。要避免意外覆盖原有数据,核心做法主要有三类:写入前显式检查键是否存在、使用字典内置的 setdefault() 方法,以及将值存储为列表或集合等容器(如使用 defaultdict)来聚合多个同键值。
一、为什么字典默认会覆盖数据
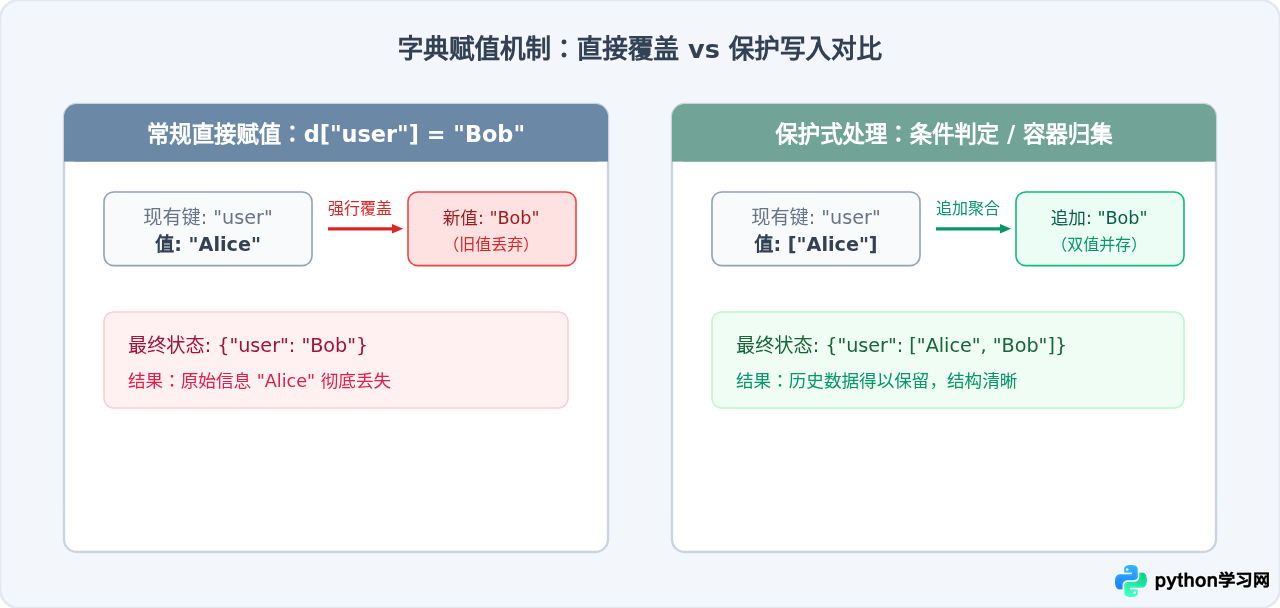
Python 字典在底层通过键的哈希值查找存储槽位。当程序执行 d[key] = new_value 时,Python 会计算该键的哈希值并定位位置。如果该键尚未存在,则新建键值对;如果该键已经存在,字典会直接替换对应槽位中的值对象引用,而不会抛出任何提示或异常。
这种设计保证了字典更新操作的高效性,但在数据采集、日志归集或多源数据汇总等场景下,直接赋值极容易导致前面的数据被悄无声息地冲掉。理解直接赋值与防护赋值的底层差异,是写出健壮代码的第一步。
二、方法一:使用 in 关键字做前置检查
最直接且逻辑最明确的方式,是在向字典写入数据前,使用 in 成员操作符检查键是否已经存在。
1. 仅当键不存在时才写入
如果你希望“以首次出现的数据为准”,后续出现同名键直接忽略,可以使用 if key not in d:
info = {"name": "张三", "city": "北京"}
new_key = "city"
new_value = "上海"

if new_key not in info:
    info[new_key] = new_value
else:
    print(f"键 '{new_key}' 已存在,当前值保留为 '{info[new_key]}',跳过写入。")

print("最终字典:", info)键 'city' 已存在,当前值保留为 '北京',跳过写入。
最终字典: {'name': '张三', 'city': '北京'}
2. 键存在时抛出异常或重命名
在严格的数据校验流程中,遇到重复键往往意味着入参异常。此时可在分支中主动抛出 KeyError 或 ValueError,避免脏数据写入:
def safe_insert(target_dict, key, value):
    if key in target_dict:
        raise ValueError(f"禁止覆盖已有键: '{key}',原值为: {target_dict[key]}")
    target_dict[key] = value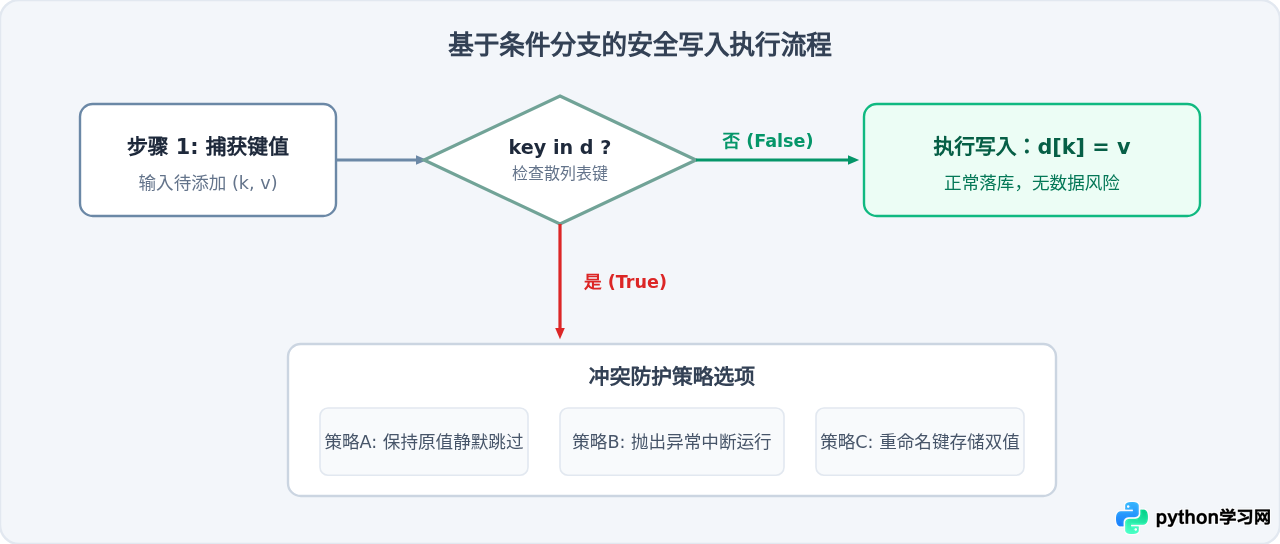
三、方法二:利用 setdefault() 优雅设置默认值
Python 字典内置了 setdefault(key, default) 方法。该方法的作用是:
- 如果键
key已经存在于字典中,不会修改原数据,直接返回原有的值; - 如果键
key不在字典中,则向字典插入该键,其值设置为default,并返回该默认值。
scores = {"math": 95}

# 尝试为 math 设置默认值 60(已存在,原数据不会被覆盖)
res1 = scores.setdefault("math", 60)
print(f"math 当前值: {res1}, 字典内容: {scores}")

# 为 english 设置默认值 80(不存在,成功新增)
res2 = scores.setdefault("english", 80)
print(f"english 当前值: {res2}, 字典内容: {scores}")math 当前值: 95, 字典内容: {'math': 95}
english 当前值: 80, 字典内容: {'math': 95, 'english': 80}
setdefault() 仅适用于“若存在则不变更”的基础赋值;如果需要对数据做增量运算或特殊校验,建议配合后续的多值容器方案。
四、方法三:将值设为容器以聚合多条数据
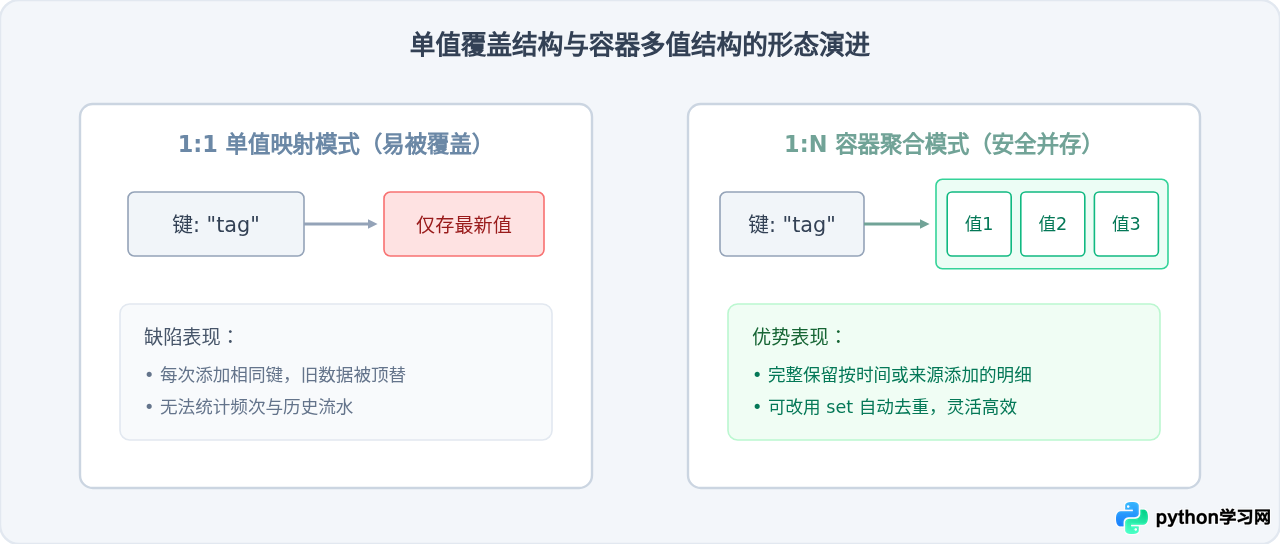
在很多实际业务场景中,“避免覆盖”的真实需求并不是丢掉新数据,而是将同一个键下的新旧数据全部保留下来。此时的最佳实践是将字典的值设计为 list(允许重复)或 set(自动去重)。
1. setdefault + append 组合
在不引入外部库的情况下,可以使用 setdefault(key, []).append(value)。如果键不存在,初始化为空列表并追加元素;若键已存在,直接获取现有列表并追加:
log_records = {}

def add_log(module, message):
    # 确保每个模块对应一个列表,不覆盖之前的日志
    log_records.setdefault(module, []).append(message)

add_log("auth", "用户登录成功: UID 1001")
add_log("database", "连接池就绪")
add_log("auth", "用户登出: UID 1001")

import pprint
pprint.pprint(log_records){'auth': ['用户登录成功: UID 1001', '用户登出: UID 1001'],
'database': ['连接池就绪']}
2. 使用 collections.defaultdict 彻底杜绝样板代码
Python 标准库的 collections.defaultdict 是处理“键可能重复并需要保留全部内容”的终极利器。它在初始化时接受一个工厂函数(如 list、set 或 int),只要访问不存在的键就会自动创建默认结构:
from collections import defaultdict

# 声明值为 list 类型的默认字典
tags_map = defaultdict(list)

records = [
    ("Python", "编程语言"),
    ("Python", "动态类型"),
    ("Rust", "系统级语言"),
    ("Python", "胶水语言")
]

for subject, tag in records:
    # 直接 append,永远不会覆盖同名 subject 的旧数据
    tags_map[subject].append(tag)

for k, v in tags_map.items():
print(f"{k} -> {v}")Python -> ['编程语言', '动态类型', '胶水语言']
Rust -> ['系统级语言']
五、方法四:合并字典时的防覆盖策略
在 Python 3.9 及以上版本中,提供了字典合并运算符 | 与更新运算符 |=。但需要特别警惕的是,默认合并规则始终是右侧字典覆盖左侧字典:
dict_a = {"port": 80, "timeout": 30}
dict_b = {"port": 8080, "env": "prod"}

# 默认规则:dict_b 的 port 会无情覆盖 dict_a 的 port
merged = dict_a | dict_b
print("直接合并结果:", merged)直接合并结果: {'port': 8080, 'timeout': 30, 'env': 'prod'}
如果希望在合并过程中保护已有配置不被覆盖,可以通过顺序调换,或者编写防护合并函数:
def safe_merge(base_dict, new_data):
    """安全合并:只写入 base_dict 中不存在的键"""
    result = base_dict.copy()
    for k, v in new_data.items():
        if k not in result:
            result[k] = v
        else:
            # 也可以在这里记录日志或执行聚合策略
            pass
    return result

safe_result = safe_merge(dict_a, dict_b)
print("安全合并结果:", safe_result)安全合并结果: {'port': 80, 'timeout': 30, 'env': 'prod'}
六、方案选型与总结
不同业务场景对“已有数据”的态度不同。选择最适合的处理方案可以极大提升程序的健壮性:
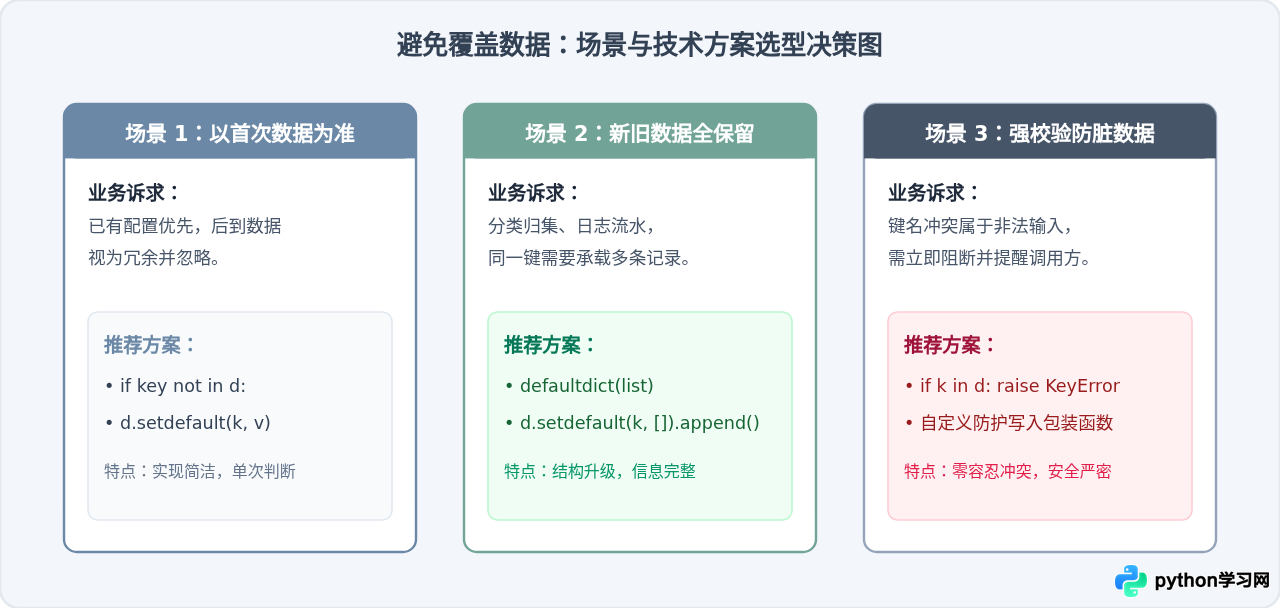
在编写日常 Python 代码时,应根据数据源的可靠程度与业务目标选择策略:对于普通可选参数设置,setdefault 足以胜任;对于数据管道归类,defaultdict(list) 是效率与可读性的平衡点;而对于关键配置加载,务必使用显式的 in 检查配合预警机制,从而杜绝原有数据被无意覆盖带来的隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









