

Python字典怎么批量添加元素?update方法使用详解
本文详细讲解Python字典批量添加元素的核心方法dict.update(),深入剖析其原地修改机制、键冲突覆盖规则,演示传入字典、键值对序列与关键字参数的三种用法及工程实战避坑指南。
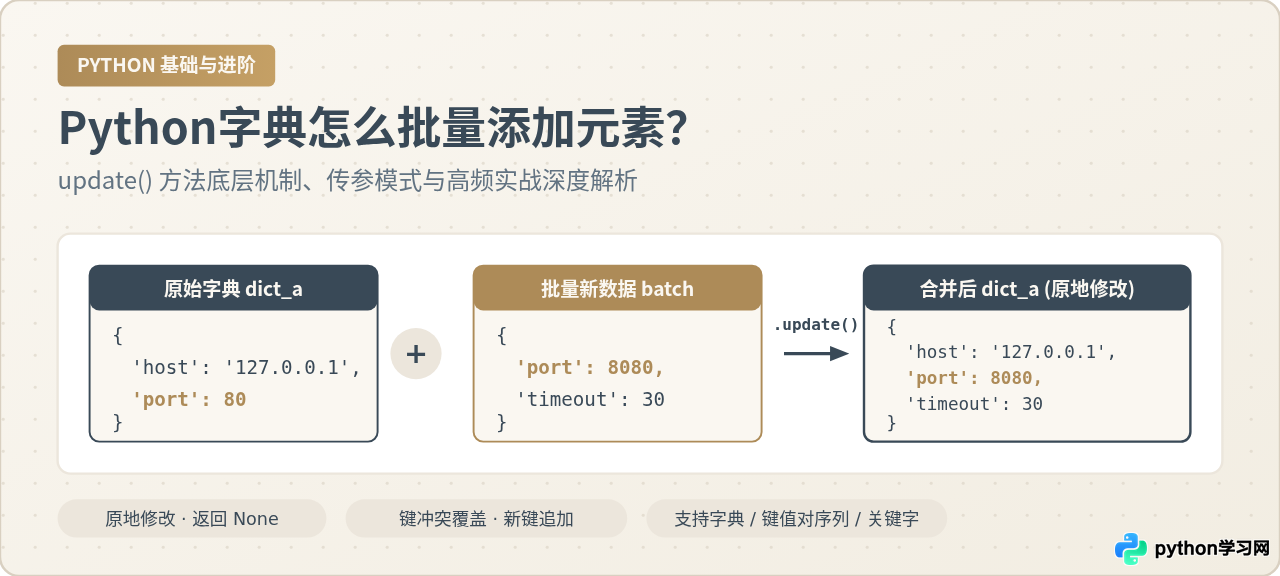
在 Python 中,为字典批量添加或合并键值对最直接、最标准的原生方式是使用内置方法 dict.update()。该方法属于就地修改(In-Place Modification)操作,直接在原字典内存空间中吸收新增或变动数据,执行完成后返回值为 None。它同时支持传入另一个字典、键值对序列以及关键字参数,遇到已存在键时自动以新值覆盖,遇到新键时则顺次追加。
一、update() 方法的核心机制与底层逻辑
字典(Dictionary)在 Python 底层基于高度优化的散列表(Hash Table)实现。在日常业务中,如果我们只添加单个元素,通常直接使用下标赋值 d[key] = value;但当面对由多个键值对组成的批量数据(例如 API 接口返回的扩展属性、外部配置项表)时,逐个循环赋值不仅代码冗长,而且效率较低。
Python 官方提供的 update() 方法就是为了解决批量键值对的合并与导入问题。其官方签名形式如下:
dict.update([other], **kwargs) -> None
理解 update() 的工作过程,必须掌握其两条最为关键的核心特性:
- 特性一:就地修改与无返回值:
update()直接在调用字典的原内存地址上进行插入和变动,不会创建并返回一个新字典。因此,它的返回值永远是None。 - 特性二:存在覆盖,不存在追加:传入的批数据在进入目标字典时,若某键在原字典中已存在,原有的旧值会被传入的新值直接替换(覆盖更新);若该键在原字典中不存在,则会在哈希表中申请新槽位完成插入。
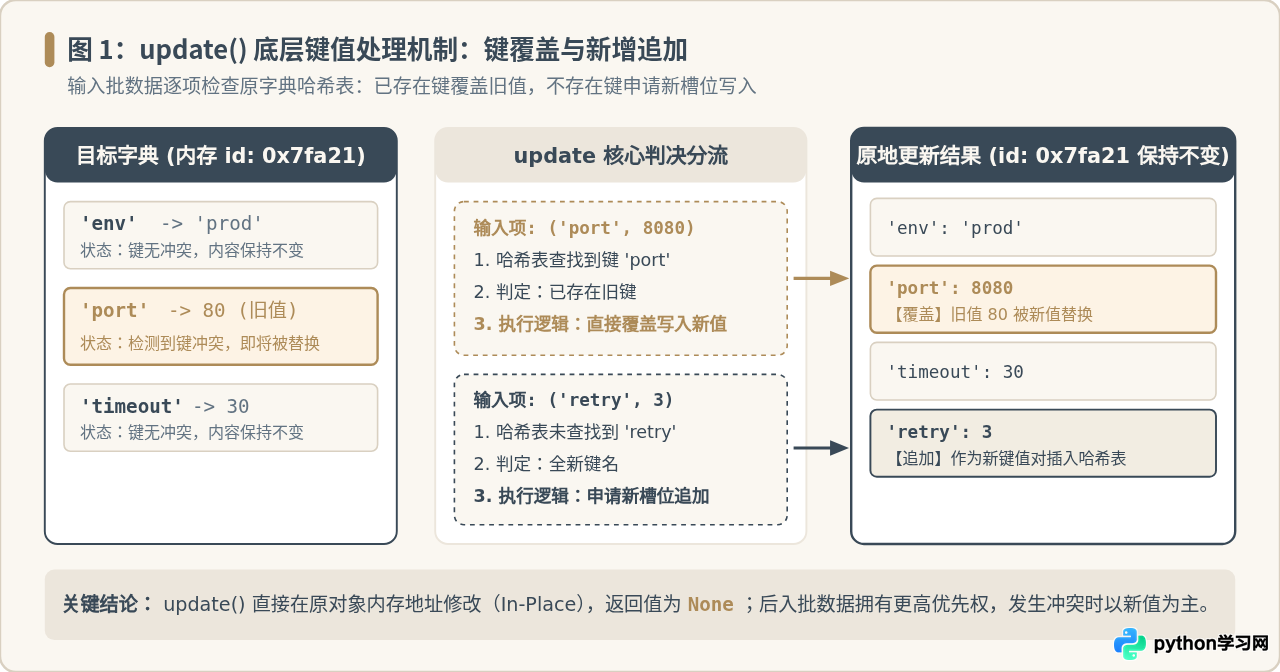
通过上方图 1 可以清晰看到,当批量数据 {'port': 8080, 'retry': 3} 合并入原字典时,原有 'port': 80 槽位发生哈希命中,直接更新为 8080;而全新的 'retry' 键则在末尾开辟槽位写入。同时,原字典在内存中的对象 ID(id(dict_obj))在更新前后完全一致。
二、update() 批量添加元素的 3 种典型传参形态
update() 的强大之处在于其入参的高度灵活性。根据数据来源和结构的不同,开发者可以在以下三种调用形式中自由选择:
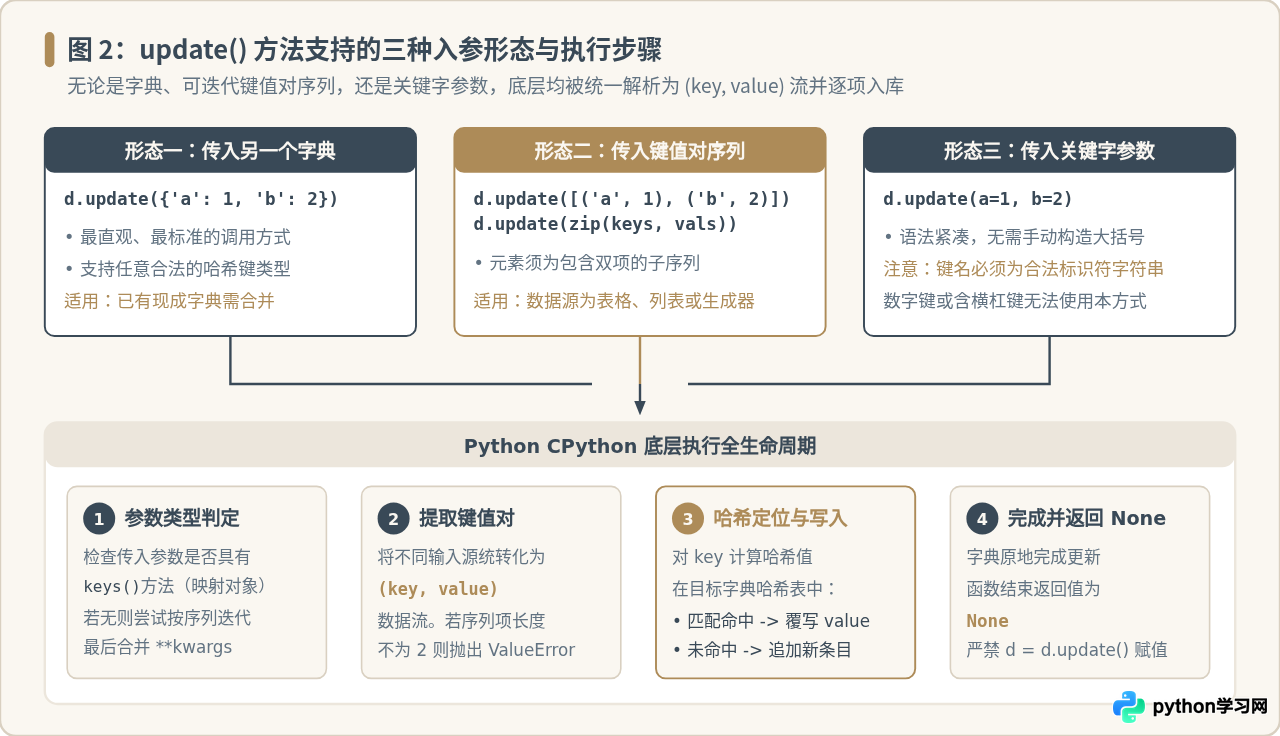
1. 方式一:传入另一个字典对象(最常见形式)
这是最直观且使用频率最高的方式。直接将包含批量数据的第二个字典作为位置参数传入。
# 示例:传入字典对象批量合并
server_config = {'host': '127.0.0.1', 'port': 80}
batch_updates = {'port': 8080, 'workers': 4, 'debug': True}

# 执行批量添加
server_config.update(batch_updates)

print(server_config)
可以看到,'port' 由旧值 80 覆盖为 8080,而 'workers' 与 'debug' 两个新键则被完整添加至字典中。
2. 方式二:传入包含键值对的可迭代序列(列表嵌套元组、zip生成器等)
如果你的批量数据并非天然以字典形态存在,而是存在于二维列表、元组序列,或是由两个独立的列表(字段名列表与数值列表)组成,那么无需先耗费内存转换为临时字典,可以直接将双元素迭代对象传给 update():
# 示例 2.1:传入包含二元元组的列表
user_profile = {'id': 1001}
extra_info = [('name', '张三'), ('department', '技术部'), ('level', 'P7')]

user_profile.update(extra_info)
print(user_profile)# 示例 2.2:利用 zip() 动态组合字段与数值并直接批量添加
keys = ['cpu_cores', 'memory_gb', 'disk_tb']
values = [16, 64, 2]
node_status = {'node_id': 'k8s-worker-01'}
node_status.update(zip(keys, values))
print(node_status)(key, value) 形式)。如果子元素包含1个或3个元素,Python 将立即抛出 ValueError: dictionary update sequence element #N has length X; 2 is required 异常。
3. 方式三:使用关键字参数(kwargs)批量注入
在键名确定且均为合法 Python 标识符(合法的变量名形式)的前提下,你可以直接通过关键字参数传递键值,省去打引号和写大括号的繁琐:
# 示例:通过关键字参数快速添加
client_session = {'ip': '192.168.1.50'}

client_session.update(status='active', timeout=300, role='admin')
print(client_session)
注意:关键字参数的形式虽然精简,但键名会自动成为字符串,且不能包含减号、空格等非标识符字符,更无法将整数作为键名。例如 d.update(123='error') 或 d.update(max-count=10) 会在词法解析阶段报 SyntaxError。
三、典型工程实战场景分析
update() 在 Python 生产代码中应用广泛,以下整理了三种最具代表性的业务场景:
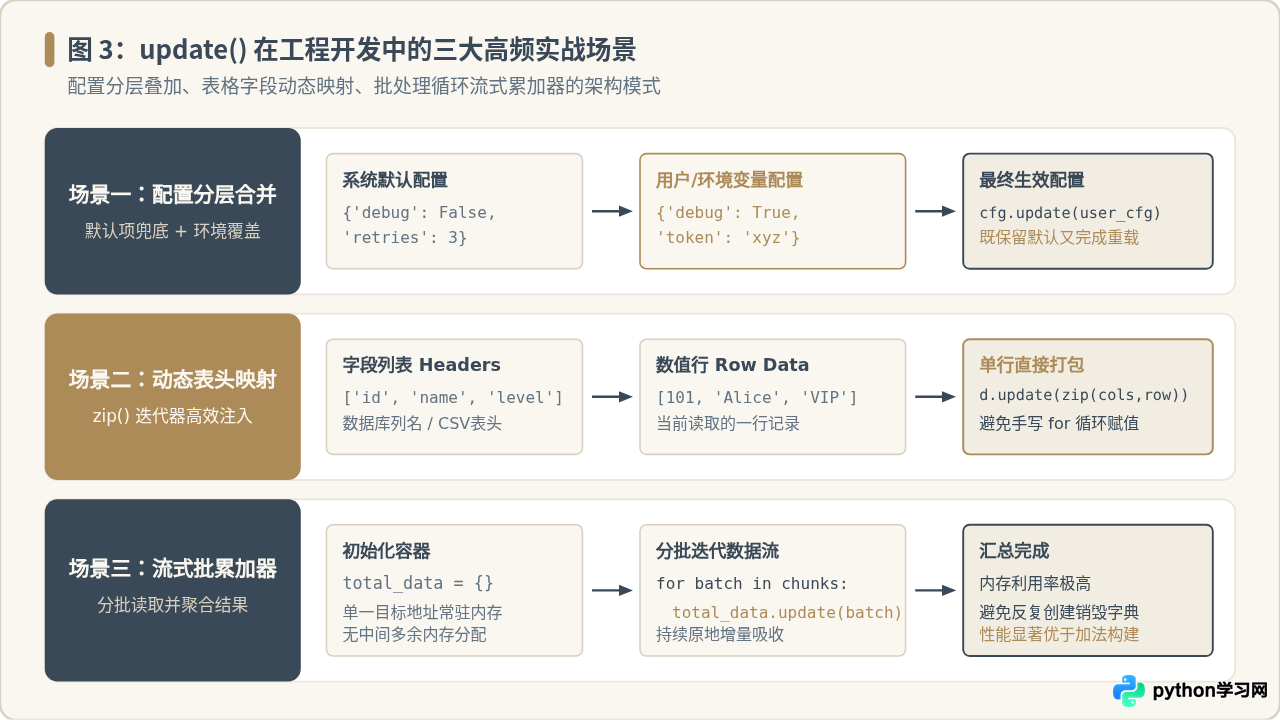
场景 1:分层配置加载与默认值覆盖
在编写应用框架、CLI 工具或后端服务时,通常会维护一份兜底的“默认配置”,并允许从环境变量或外部 YAML/JSON 文件中加载用户自定义配置。使用 update() 可以优雅地完成分层叠加:
# 1. 定义安全默认配置
DEFAULT_SETTINGS = {
    'theme': 'light',
    'show_sidebar': True,
    'auto_save_interval': 60,
    'log_level': 'INFO'
}

# 2. 运行时用户自定义配置(通常来自文件解析)
user_settings = {
    'theme': 'dark',              # 覆盖默认项
    'auto_save_interval': 30,     # 覆盖默认项
    'custom_font': 'JetBrains'    # 新增扩展项
}

# 3. 复制默认配置并就地吸收用户配置
app_config = DEFAULT_SETTINGS.copy()
app_config.update(user_settings)

print(app_config)场景 2:数据库/CSV 表格数据流转化为实体字典
当从数据库游标或 CSV 读取二维行数据时,行对象通常为元组或列表。结合 zip() 和 update(),只需一行即可将列名与单元格数据绑合:
columns = ['order_id', 'user_id', 'amount', 'status']
db_row = ['ORD_20261102', 88021, 399.00, 'PAID']

order_record = {'channel': 'WeChat_Pay'}
order_record.update(zip(columns, db_row))

print(order_record)场景 3:大数据分批读取中的增量字典累加器
在批量处理大容量数据流时,如果每次合并都产生新字典,会频繁触发 Python 的垃圾回收(GC)机制并耗费大量堆内存。采用 update() 原地累加,可以实现恒定低内存开销:
# 模拟从分批 API 或分页流中读取数据
batch_stream = [
    {'metric_cpu': 0.45, 'metric_mem': 0.72},
    {'metric_disk': 0.31, 'metric_network': 0.18},
    {'metric_gpu': 0.89}
]

global_metrics = {}
for chunk in batch_stream:
    global_metrics.update(chunk)  # 原地快速注入,性能最优

print("累计采集指标项数量:", len(global_metrics))四、避坑指南:初学者高频错误与注意事项
update() 当作有返回值的纯函数来写:my_dict = my_dict.update(new_items) # 错误!my_dict 会彻底变成 None正确做法:直接单起一行调用
my_dict.update(new_items),切勿用变量接收其返回值。
1. 注意浅拷贝特性(Shallow Copy)
update() 在添加或覆盖值时,执行的是对象引用的赋值,而非深拷贝(Deepcopy)。如果传入的值包含列表、字典等嵌套可变对象,目标字典与源字典将引用同一块内存。修改其中一方,另一方会随之被联动修改。
# 浅拷贝风险演示
source = {'tags': ['python', 'backend']}
target = {'title': '入门指南'}

target.update(source)
# 尝试修改 source 中的 tags
source['tags'].append('database')

# target 中的 tags 同样被串改!
print(target['tags'])
解决方案:如果要求完全隔离,在调用前可使用 copy.deepcopy() 进行深拷贝后再执行 update()。
五、横向对比:update() 与合并运算符(|、|=)的选型考量
自 Python 3.9 起(PEP 584),Python 正式引入了字典合并运算符 | 与原地合并赋值运算符 |=。许多开发者对何时用 update()、何时用运算符感到困惑。下表和决策图为不同场景提供了清晰的选型标准:
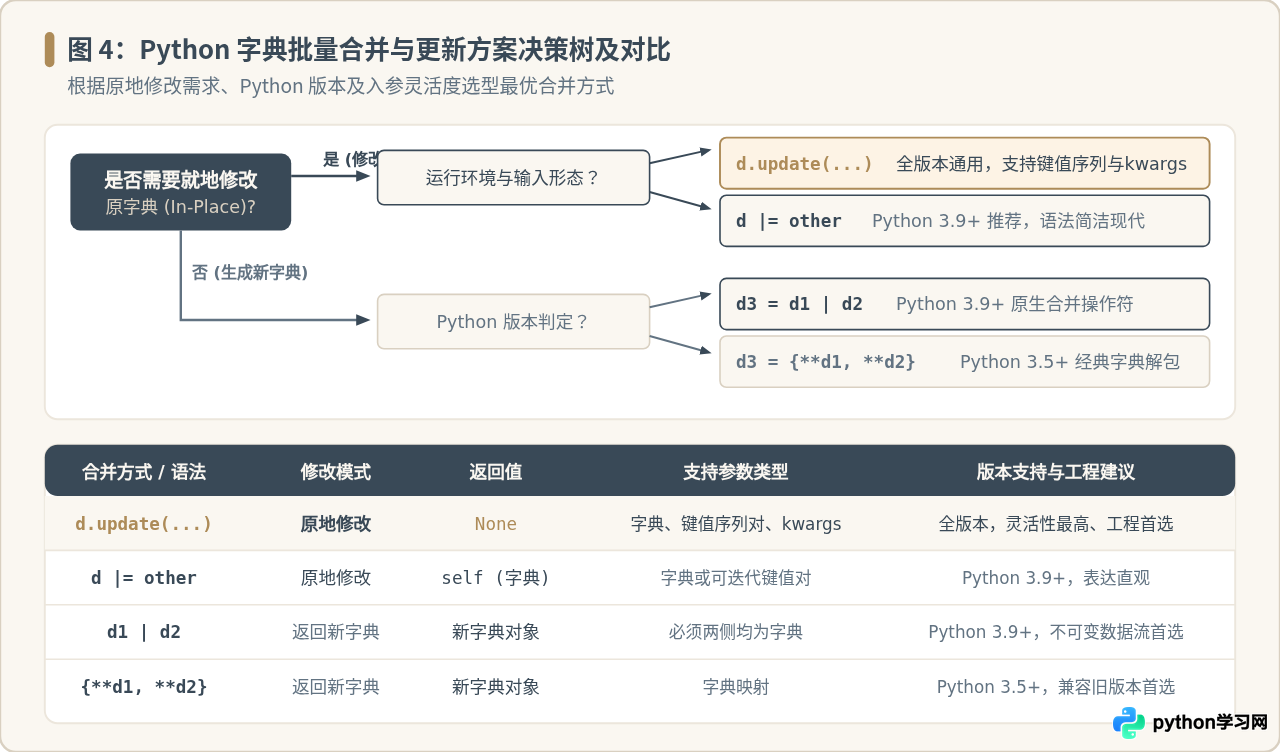
| 方案语法 | 修改行为 | 返回值 | 入参类型兼容度 | 适用环境与场景建议 |
|---|---|---|---|---|
d.update(...) |
原地修改(In-Place) | None |
高(字典、键值序列、kwargs) | 所有 Python 版本,数据源多样或需要原地修改时的标准选择 |
d |= other |
原地修改(In-Place) | self |
中(字典或二元序列) | Python 3.9+,代码追求简短优雅,语义同 update() |
d3 = d1 | d2 |
生成新字典 | 新字典对象 | 低(必须两边均为字典) | Python 3.9+,函数式编程、不希望污染原字典的场景 |
d3 = {**d1, **d2} |
生成新字典 | 新字典对象 | 中(字典映射解包) | Python 3.5+,兼容旧版本 Python 且需要创建新字典时首选 |
六、全文总结
本文全面阐述了 Python 字典批量添加元素的核心工具 dict.update() 的工作原理与实践细节。在实际编码中,请牢记以下要点:
- 核心定位:
update()是就地修改(In-place)的原生方法,执行效率高,返回值为None,严禁写成d = d.update(...)。 - 冲突规则:字典键具有唯一性,批量添加时遵循“相同键覆盖新值、不同键顺序追加”的原则。
- 输入多态:无论是字典、二元列表元组、还是
zip()迭代器或关键字参数,均可无缝送入update()消化。 - 现代选型:在 Python 3.9+ 现代化代码中,可根据是否需要保留原字典在
update() / |=与|之间按需选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









