

Python用statistics模块计算中位数
详细讲解如何在Python中使用内置statistics模块计算中位数,包括median、median_low与median_high的核心差异、奇偶样本运算机制、多种数值类型支持与异常防御最佳实践。
一、statistics.median 的基本用法与奇偶样本机制
中位数(Median)是统计学中用于描述数据集中心趋势的核心指标,代表将一组数值按大小顺序排列后处于正正中间位置的值。相比算术平均数,中位数的最大优势在于对极端离群值(Outliers)极不敏感。例如,在一组收入数据中混入极高的极端值时,平均数会被大幅拉高,而中位数能真实反映中等水平。
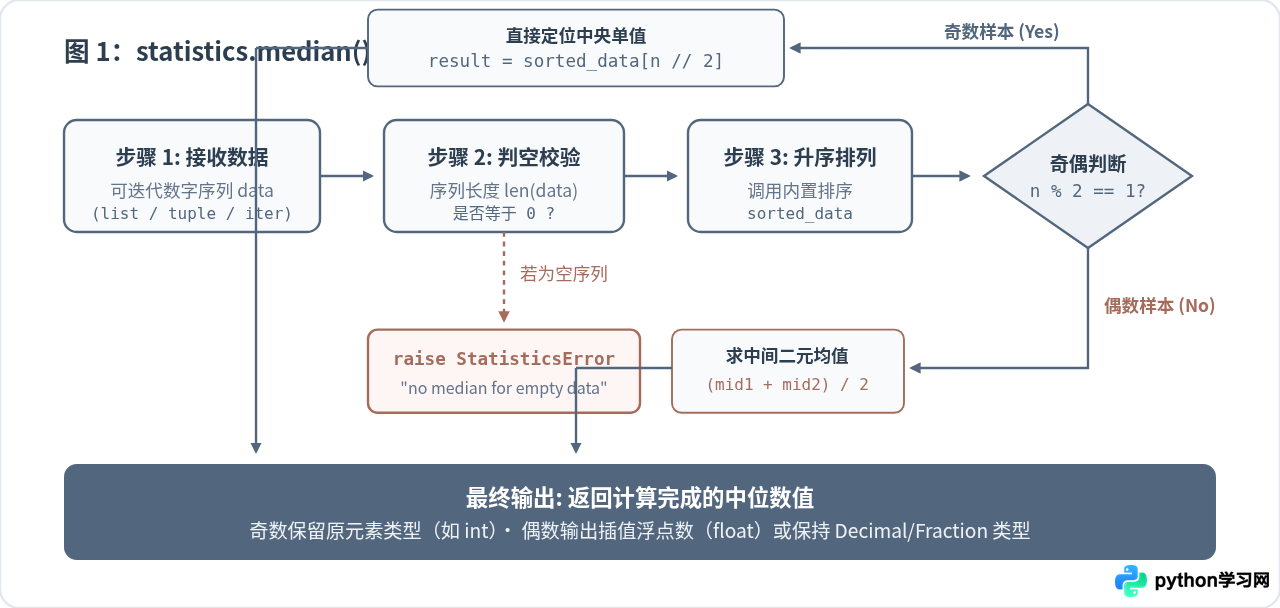
在 statistics.median() 内部,无论传入的序列是否已经预先排序,模块都会先对其执行稳定排序,随后根据样本元素总数 n 是奇数还是偶数,执行不同的取值策略:
- 奇数样本(n % 2 == 1):直接返回正正中央位置的单一元素,索引位置为
n // 2。返回结果与原数据类型保持一致。 - 偶数样本(n % 2 == 0):中央不存在单个数字,而是存在两个中间数值(索引分别为
n // 2 - 1和n // 2)。函数会自动求这两个中间数的算术平均值(即相加除以 2),因此即便传入的是纯整数列表,通常也会输出一个float类型的浮点数。
以下是处理奇数和偶数长度列表的完整示例代码:
import statistics

# 1. 奇数个元素的列表(5个数字,未排序)
odd_data = [18, 4, 32, 9, 25]
result_odd = statistics.median(odd_data)
print(f"奇数样本排序后为 [4, 9, 18, 25, 32],中位数为: {result_odd} (类型: {type(result_odd).__name__})")

# 2. 偶数个元素的列表(4个数字,未排序)
even_data = [14, 2, 28, 8]
result_even = statistics.median(even_data)
print(f"偶数样本排序后为 [2, 8, 14, 28],中间两数 (8+14)/2,中位数为: {result_even} (类型: {type(result_even).__name__})")
偶数样本排序后为 [2, 8, 14, 28],中间两数 (8+14)/2,中位数为: 11.0 (类型: float)
二、保持原始观测值:median_low 与 median_high
在常规数学计算中,偶数长度数据求中间两数的均值是标准做法。然而在不少实际业务场景中,这种“求平均产生虚拟插值”的行为并不符合需求:
- 离散等级与分类数据:例如用户评分只能是 1、2、3、4、5 颗星,或者商品尺码仅支持整数编码。若偶数样本中间为 3 和 4,输出 3.5 星在实际业务实体中并不存在。
- 不可分割实物与库存分析:如果统计的是仓库中各箱装货件数,非整数件在物理上不成立,分析人员往往要求中位数必须取自样本中真实存在的观测值。
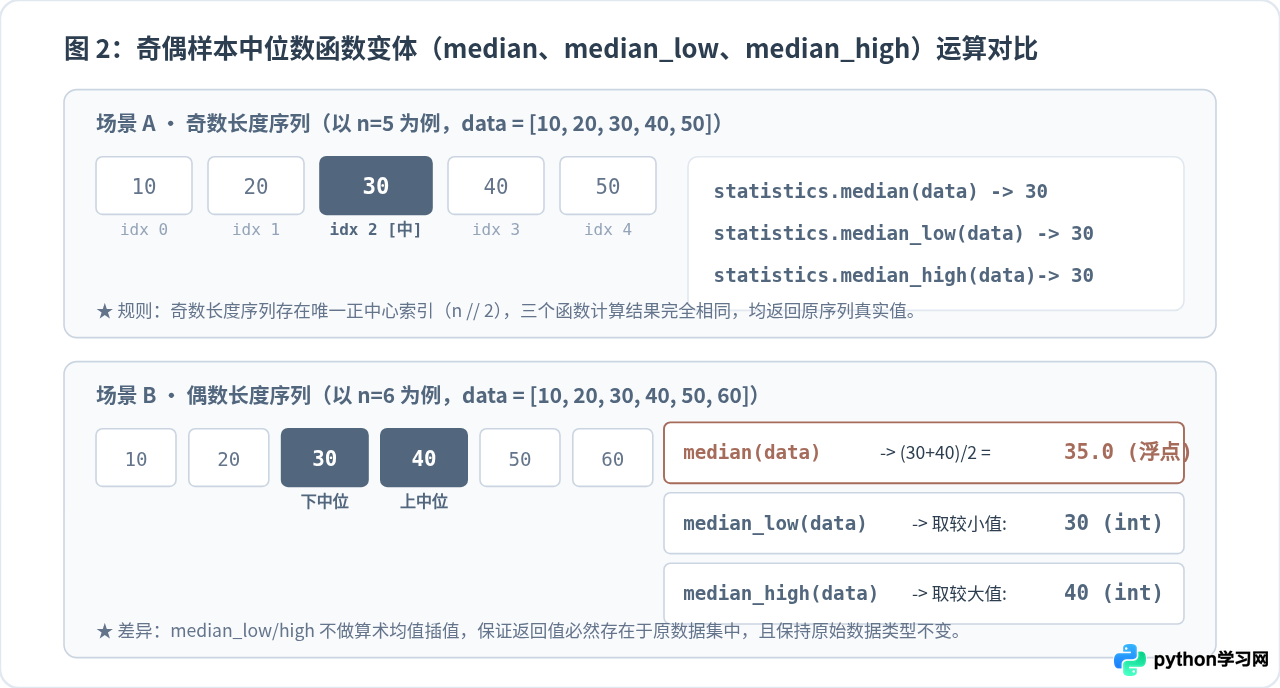
为了解决这个问题,statistics 模块额外提供了两个变体函数:median_low() 和 median_high():
statistics.median_low(data):当样本为偶数个时,返回中间两个数中较小的一个(下中位数);样本为奇数时与常规median()一致。statistics.median_high(data):当样本为偶数个时,返回中间两个数中较大的一个(上中位数);样本为奇数时与常规median()一致。
这两个函数最重要的价值在于:它们绝不进行插值计算,因此返回的数值必然来自于原始输入数据集,并且能够完整保留原本的数据类型(例如整数输入返回纯整数,而不是浮点数)。
import statistics

# 模拟用户离散评分数据(6条记录,偶数个样本)
ratings = [2, 3, 3, 4, 5, 5]
# 中间两数索引为 2 和 3,对应的值为 3 和 4

m_standard = statistics.median(ratings)
m_low = statistics.median_low(ratings)
m_high = statistics.median_high(ratings)

print(f"标准中位数 median:      {m_standard} (插值均值,浮点型)")
print(f"下中位数 median_low:     {m_low} (样本真实值,保留整数)")
print(f"上中位数 median_high:    {m_high} (样本真实值,保留整数)")
下中位数 median_low: 3 (样本真实值,保留整数)
上中位数 median_high: 4 (样本真实值,保留整数)
此外,模块中还包含一个专门用于连续分组数据的函数 statistics.median_grouped(data, interval=1.0)。当数据以直方图分箱或四舍五入后的整数形式记录连续物理量(如受访者年龄、测量温度)时,该函数会假定数据在各自组距 interval 内均匀分布,并使用线性插值估算第 50 百分位数,使结果比简单的离散点更贴近连续总体的中位数。
三、数值类型兼容性与生成器支持
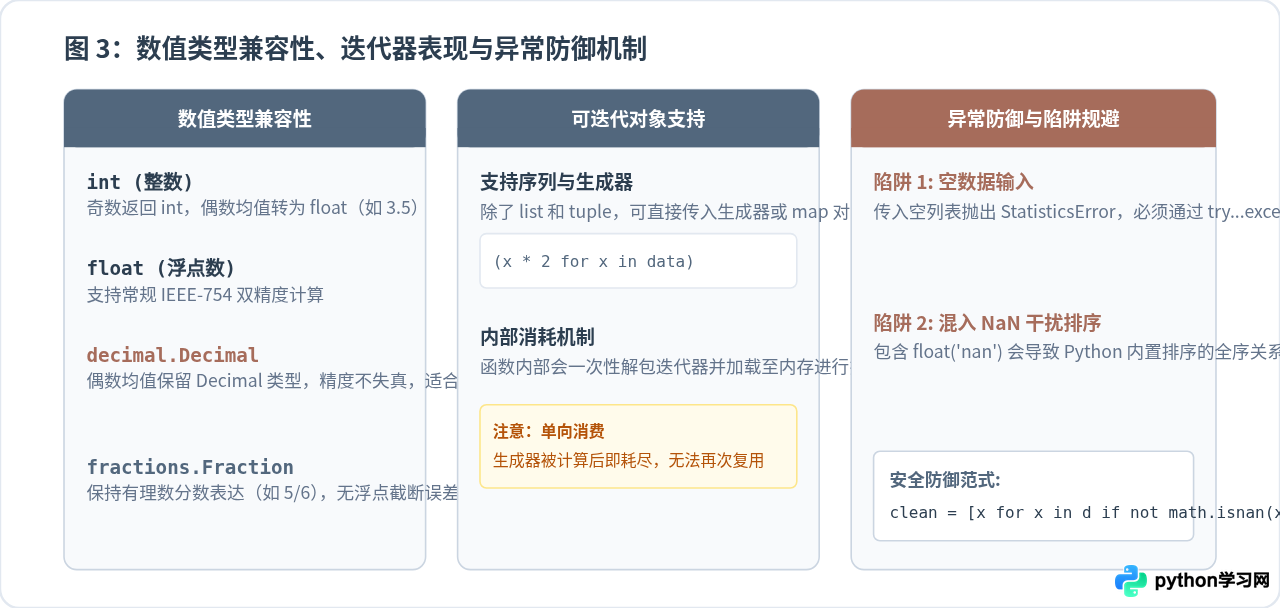
statistics 模块不仅支持 Python 的内置整型(int)和浮点型(float),还与高精度数据类型原生无缝集成。在金融支付、资产计价等对精度极其敏感的场景中,直接使用二进制浮点数计算往往会带来微小的舍入误差。statistics.median() 能够良好地配合 decimal.Decimal 以及 fractions.Fraction 使用:
import statistics
from decimal import Decimal
from fractions import Fraction

# 1. 使用高精度 Decimal 进行资产核算
price_records = [Decimal("100.25"), Decimal("105.50"), Decimal("112.75"), Decimal("120.00")]
price_median = statistics.median(price_records)
print(f"Decimal 中位数: {price_median} (保持类型: {type(price_median)})")

# 2. 使用 Fraction 进行有理数分数运算
ratios = [Fraction(1, 3), Fraction(2, 5), Fraction(3, 4), Fraction(7, 8)]
ratio_median = statistics.median(ratios)
print(f"Fraction 中位数: {ratio_median} (输出分数表达,绝对无截断误差)")
Fraction 中位数: 23/40 (输出分数表达,绝对无截断误差)
在传入参数的数据结构方面,函数接受任何合法的 Python 可迭代对象(Iterable),包括元组(tuple)、集合(set,但需注意集合会自动去重,若要保留频次请不要转为集合)以及生成器表达式(Generator)。需要注意的是,生成器属于单次流式消费结构,一旦被 statistics.median() 消费以完成排序,该生成器对象便被耗尽,无法再次遍历。
四、边界场景与异常防御实践
在生产代码中处理中位数计算时,有两个常见陷阱需要引起重视:
1. 空数据序列引发的 StatisticsError
如果将空列表 [] 或耗尽的迭代器传入 statistics.median(),Python 会主动抛出 statistics.StatisticsError: no median for empty data 异常,而不会默默返回 None 或 0。在编写健壮的服务逻辑时,应当在调用前做长度判断,或者使用 try...except 结构妥善捕获:
import statistics

def safe_get_median(data_sequence, default_val=None):
    try:
        return statistics.median(data_sequence)
    except statistics.StatisticsError:
        # 捕获空序列异常,返回安全的业务预设默认值
        return default_val

print(f"空列表安全处理结果: {safe_get_median([])}")
print(f"正常数据计算结果: {safe_get_median([5, 10, 15])}")
正常数据计算结果: 10
2. 包含 NaN(非数)对排序全序的破坏
当浮点列表中混入 float('nan') 时,由于按照 IEEE 754 标准,任何数与 NaN 进行比对(包括 nan == nan)都会返回 False,这会直接破坏 Python 内置排序算法(Timsort)的前提假设,导致排序结果不可控,进而使计算出的中位数偏离预期。因此,在统计计算前应使用列表推导式或过滤器剔除无效数值:
import math
import statistics

raw_samples = [10.5, 12.0, float('nan'), 15.5, 18.0]

# 前置清洗:过滤掉所有 math.isnan 为 True 的非数项
clean_samples = [x for x in raw_samples if not math.isnan(x)]
print(f"清洗后的中位数为: {statistics.median(clean_samples)}")
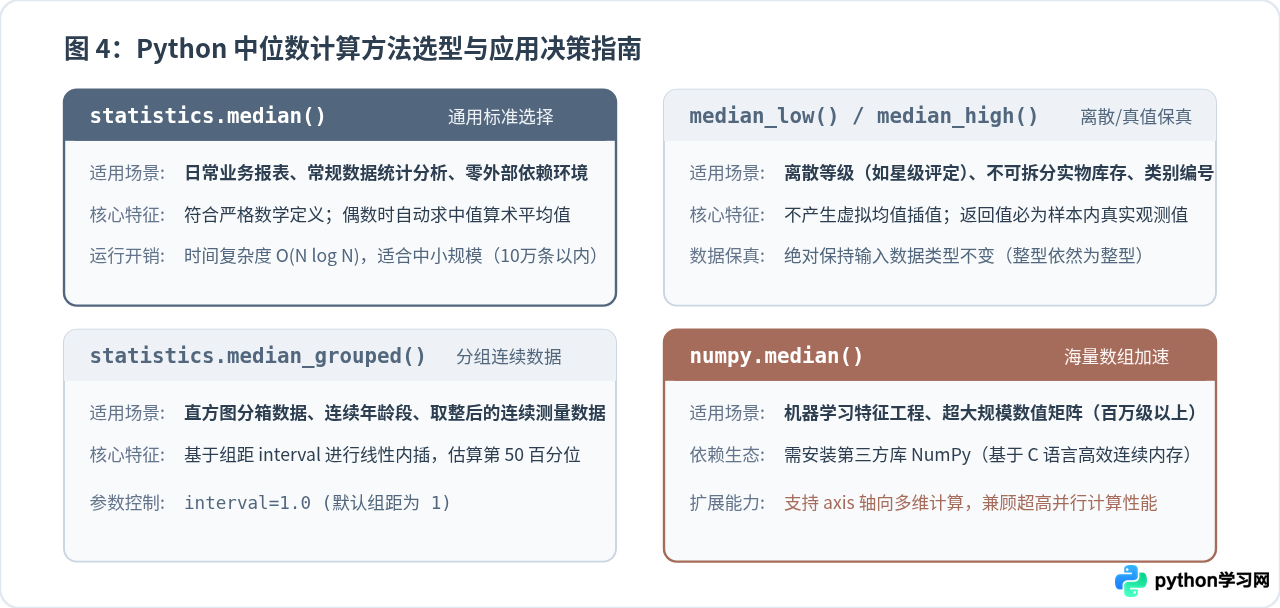
五、方法选型与总结
Python 提供了多种中位数计算途径,合理选择工具能兼顾开发效率与执行性能:
| 函数 / 方法 | 所属模块 | 偶数样本处理机制 | 主要优势与适用场景 |
|---|---|---|---|
median() |
statistics(标准库) |
取中间二元平均(转浮点) | 零依赖、通用统计、支持 Decimal / Fraction 精度 |
median_low() |
statistics(标准库) |
取中间二元较小值 | 保留原始样本值与原始类型(如离散评分、实物计数) |
median_high() |
statistics(标准库) |
取中间二元较大值 | 保留原始样本值与原始类型(保守估高场景) |
median_grouped() |
statistics(标准库) |
基于组距线性插值估算 | 连续性分箱数据、按区间归纳的直方图统计 |
numpy.median() |
numpy(第三方库) |
取中间二元平均(默认浮点) | 多维矩阵轴向统计、超大规模数值计算(数百万项以上) |
总结来说,对于常规的 Python 开发、Web 后端服务、运维自动化脚本或中小规模数据清洗,内置的 statistics.median 及其变体是最轻量、可读性最高且最安全的选择。只有当数据量达到数十万乃至数百万级别,或者需要沿着多维数组的特定轴向(axis)批量计算时,才需要引入第三方的 NumPy 科学计算库。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









