

Python零基础自学路线:怎么制定免费学习计划
针对零基础学习者的Python自学路线与免费学习计划制定方案。涵盖核心语法、数据结构、常用标准库三阶段规划,精选官方免费资源,提供科学的每日与每周时间表,规避自学卡点与假性勤奋。
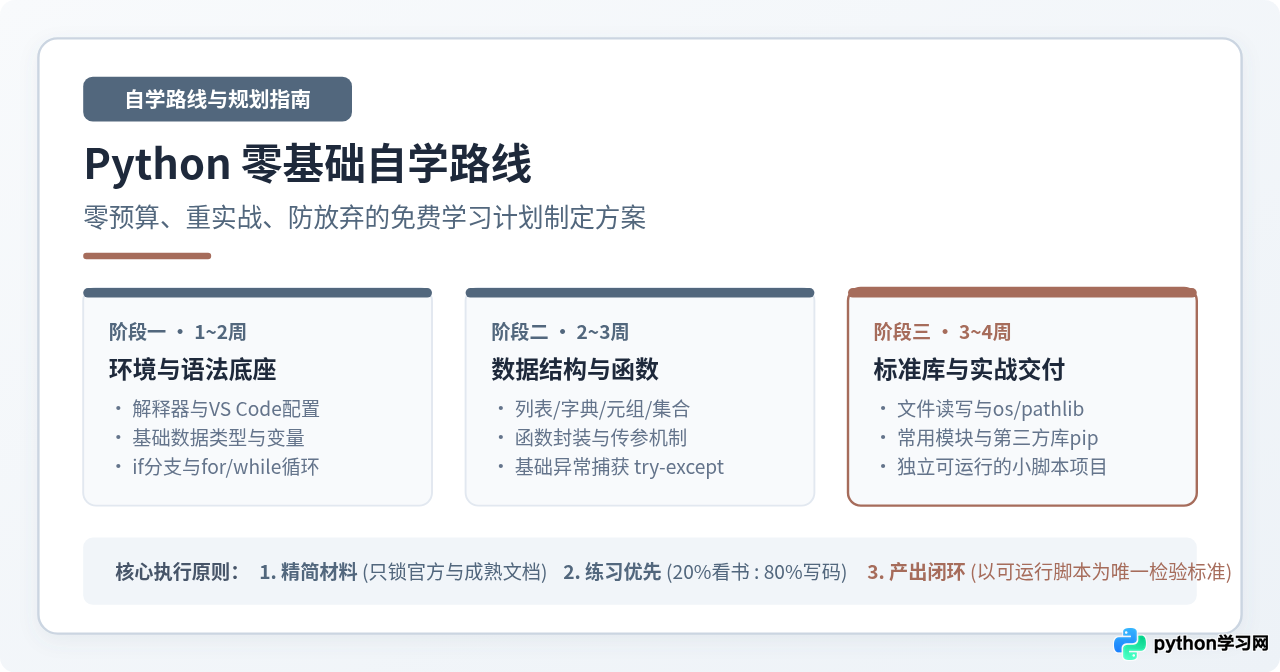
自学 Python 最大的障碍往往不是找不到资料,而是资料泛滥带来的无所适从与“只看不练”的虚假充实感。制定一份真正能够落地的免费自学计划,关键在于建立“三阶段阶梯推进、聚焦单一权威文档、60%以上键盘敲码、每阶段交付微型脚本”的执行闭环。本文将详细拆解每个阶段的学习范围与验收标准,指导如何筛选完全免费的优质资源,并给出一份可直接套用的每日与每周时间表。
一、明确自学路线的三个核心阶段与验收标准
零基础自学者最容易犯的错误之一是试图在第一周就搞懂面向对象的高阶继承、元编程或庞大的第三方框架。稳妥的学习节奏应该是金字塔式的:先扎实打牢语法底座,再掌握数据组织和函数封装,最后结合标准库完成自动化小脚本。
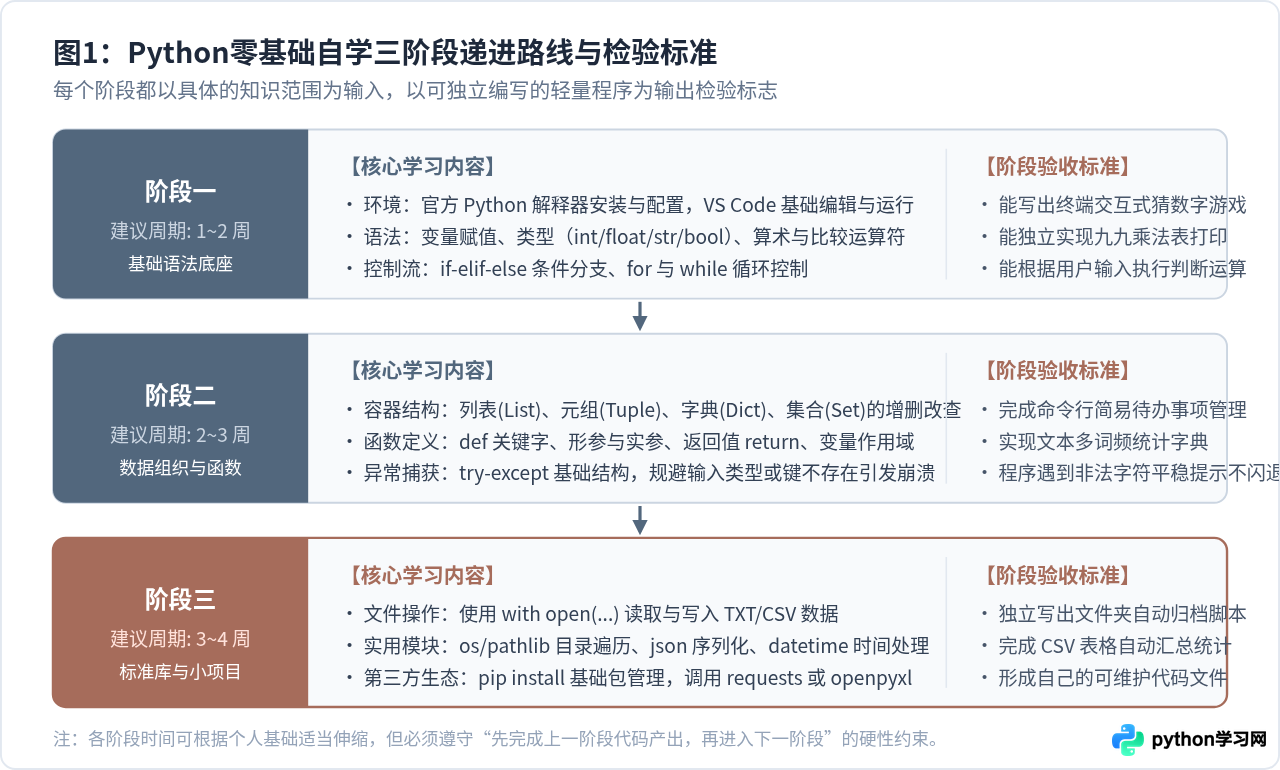
阶段一:运行环境与核心语法底座(周期:第 1 ~ 2 周)
本阶段的核心任务是熟悉 Python 代码是如何在电脑中运行的,以及掌握最基本的控制流逻辑。不需要安装庞大复杂的集成开发环境,仅需前往 Python 官方网站下载匹配系统的最新稳定版解释器(如 Python 3.11 或 3.12),并搭配轻量级的 Visual Studio Code。
- 必备概念:变量命名规范与内存引用直观理解;四大基础数据类型(整数
int、浮点数float、字符串str、布尔值bool);基本算术运算与逻辑比较。 - 核心控制流:
if - elif - else条件分支逻辑;for遍历循环与while条件循环;break与continue的跳转控制。 - 阶段验收标准:不需要翻看任何笔记,能在一个独立的
.py文件中,结合用户输入(input())与随机数模块,编写出一个完整的命令行猜数字程序。
import random

def guess_game():
    target = random.randint(1, 100)
    attempts = 0
    max_attempts = 5

    print("=== 猜数字游戏已启动 (范围 1-100,共 5 次机会) ===")

    while attempts < max_attempts:
        user_input = input(f"第 {attempts + 1} 次尝试,请输入数字: ")

        # 基础数据合法性判断
        if not user_input.isdigit():
            print("输入无效,请输入正整数!")
            continue

        guess = int(user_input)
        attempts += 1

        if guess == target:
            print(f"恭喜猜对了!目标数字就是 {target},共用了 {attempts} 次。")
            return
        elif guess < target:
            print("太小了,再试一次。")
        else:
            print("太大了,再试一次。")

    print(f"游戏结束,机会已耗尽!正确答案是 {target}。")

if __name__ == "__main__":
guess_game()阶段二:数据结构、函数与防御性编程(周期:第 3 ~ 5 周)
现实中的业务问题绝不仅仅是单个数值的处理,而是成批数据的清洗、归纳与转换。阶段二必须攻克 Python 灵活的容器结构,并掌握将重复代码抽离为函数的基本能力。
- 四大容器:列表(List)的切片与追加;字典(Dict)的键值映射、查找与嵌套;元组(Tuple)的不可变性场景;集合(Set)的快速去重与交并集。
- 函数设计:使用
def定义函数、形参与实参传递、返回值return的规范设计、局部变量与全局变量的作用域边界。 - 防御性编程:使用
try - except捕获常见的运行期异常(如ValueError、KeyError、IndexError),防止控制台直接抛出红字崩溃。 - 阶段验收标准:实现一个支持“录入学生成绩”、“按及格分数自动分类统计”、“根据姓名快速查分”的控制台微型应用。
def calculate_summary(scores):
    """统计总分、平均分与及格人数"""
    if not scores:
        return {"count": 0, "avg": 0.0, "pass_count": 0}

    total = sum(scores.values())
    avg = total / len(scores)
    passed = sum(1 for s in scores.values() if s >= 60)

    return {
        "count": len(scores),
        "avg": round(avg, 2),
        "pass_count": passed
    }

def main():
    grade_book = {"张伟": 85, "王芳": 92, "李娜": 58, "刘洋": 74}
    summary = calculate_summary(grade_book)

    print(f"参与统计人数: {summary['count']}")
    print(f"班级平均分: {summary['avg']}")
    print(f"及格人数: {summary['pass_count']}")

if __name__ == "__main__":
main()阶段三:标准库应用与自动化小脚本交付(周期:第 6 ~ 8 周)
学习语法的最终目的是让程序替人处理现实繁琐事务。阶段三不再大量死抠新的语法点,而是把精力集中在 Python 强大的“内置电池”(内置标准库)上,学会在本地磁盘上处理真实的文件与数据。
- 文件 I/O 规范:使用
with open(...) as f:语法读写本地文本与日志,掌握utf-8编码指定,规避中文乱码报错。 - 核心内置库:
os与pathlib(遍历文件夹、重命名、移动文件);json(数据结构与文本字符串的序列化和反序列化);csv(读取与生成表格数据)。 - 包管理器初探:掌握在终端使用
pip install安装单个第三方辅助库(如用于 Excel 读写的openpyxl或网络请求库requests)。 - 阶段验收标准:完成一个真实能跑的脚本——例如把下载文件夹里所有的
.png和.jpg文件自动按日期移动到归档文件夹中。
二、零预算获取高质量学习资源的筛选法则
互联网上并不缺少免费的 Python 教学内容,真正稀缺的是“成体系、低噪音、无推销干扰”的高信息密度源头。很多初学者在 B 站或各视频平台收藏了上百个 G 的网盘教程,最终却停留在第一节的环境配置,这种现象被称为“囤积式伪学习”。
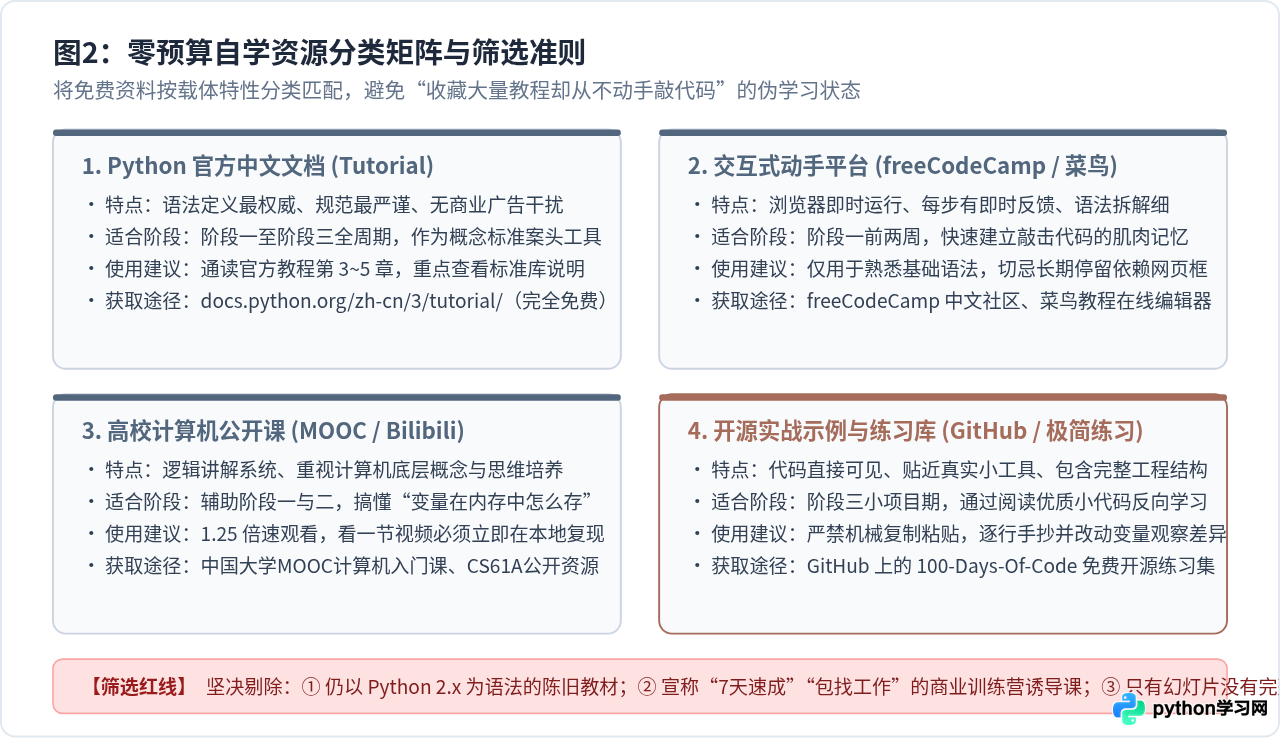
在挑选学习材料时,建议将资源精简到最少,坚持“以一份官方中文教程为骨架,以交互式题库为辅料,以搜索引擎定位具体报错”的三元组合:
| 资源类型 | 推荐免费获取渠道 | 正确打开方式 |
|---|---|---|
| 官方核心教程 | Python 官方网站中文文档(Tutorial 模块) | 语法定义的最高法典。每学到一个新语句,优先核对官方给出的语法规范与参数说明。 |
| 交互式练手平台 | freeCodeCamp 中文社区 / 菜鸟在线运行沙箱 | 用于前两周熟悉基础语法。直接在网页中敲击代码,获得即时输出反馈,降低配置心智负担。 |
| 大学公开课视频 | Bilibili 高校计算机导论与程序设计基础公开课 | 仅在遇到“理解不了为什么列表是有序可变的”这类抽象模型时,看单个章节的板书推导。 |
| 开源实战练习集 | GitHub 开源新手项目(如 100 天 Python 练习系列) | 用于阶段三模仿代码风格。切忌直接复制粘贴,必须自己新建空白文件逐行键入并理解。 |
1. 还在教授
print "hello"(无括号)的 Python 2.x 陈旧教材;2. 声称“零基础 7 天精通接单”、“不写代码纯靠拖拽”的商业引流软文课;
3. 全程由讲师念幻灯片概念、屏幕上没有一行可运行 Python 代码的纯理论讲座。
三、怎么制定可执行的周计划与每日时间表
许多自学计划破产的原因并不是内容太难,而是计划本身脱离了常人的意志力极限。一次性定下“每天下班后苦读 4 小时”的目标,通常只需连续加班两天就会彻底断档。
对于兼顾学业或全职工作的零基础自学者,最科学的投入是“工作日每天 90 分钟,周末集中交付 3 小时”。同时,将每次 90 分钟的时间结构做硬性切割,形成标准动作。
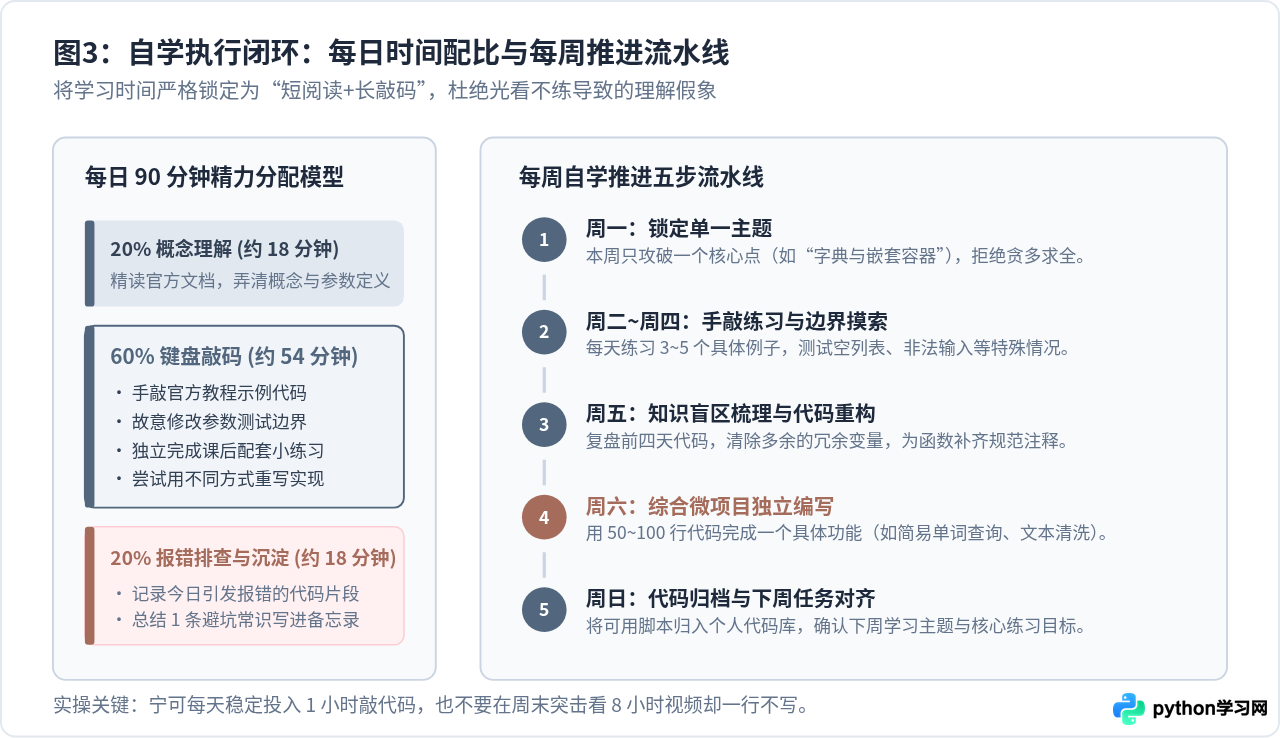
每日 90 分钟黄金精力模型(20% : 60% : 20%)
- 前 18 分钟(概念吸收):只看教材中对应的小节说明,理解语法意图与核心关键词。严禁无休止地扩展阅读超纲内容。
- 中间 54 分钟(敲击实践):打开本地代码编辑器,将教材中的示例完整键入一遍。接着进行“破坏性实验”:故意把变量改名、故意删掉缩进、故意传入负数或空值,观察程序如何反馈。
- 最后 18 分钟(报错记录):如果今天遇到了报错,将报错文本与解决方案记录在个人的《排坑笔记》中;若没有报错,用两句话总结今日学会的函数用法。
周度迭代节奏安排
周一至周四聚焦在单一功能模块(如周一学字典键值操作,周二学嵌套遍历,周三学字典内置方法 get() 与 items(),周四做综合练习题)。周五作为缓冲日,不学习任何新语法,专门整理前四天的练习代码并解决遗留疑难。周六上午集中投入 2~3 小时,不看教材代码,独立编写一个包含本周知识点的小脚本。周日完成代码备份,并规划下一周的具体目标。
四、自学中最容易踩的坑与卡点自救指南
在自学初期,遇到错误是不可避免的正常现象。不少初学者一看到终端打印出长串红色的 Traceback (most recent call last) 就会产生挫败感,甚至直接关闭终端。实际上,错误回溯信息是 Python 解释器提供给开发者的“诊断书”。
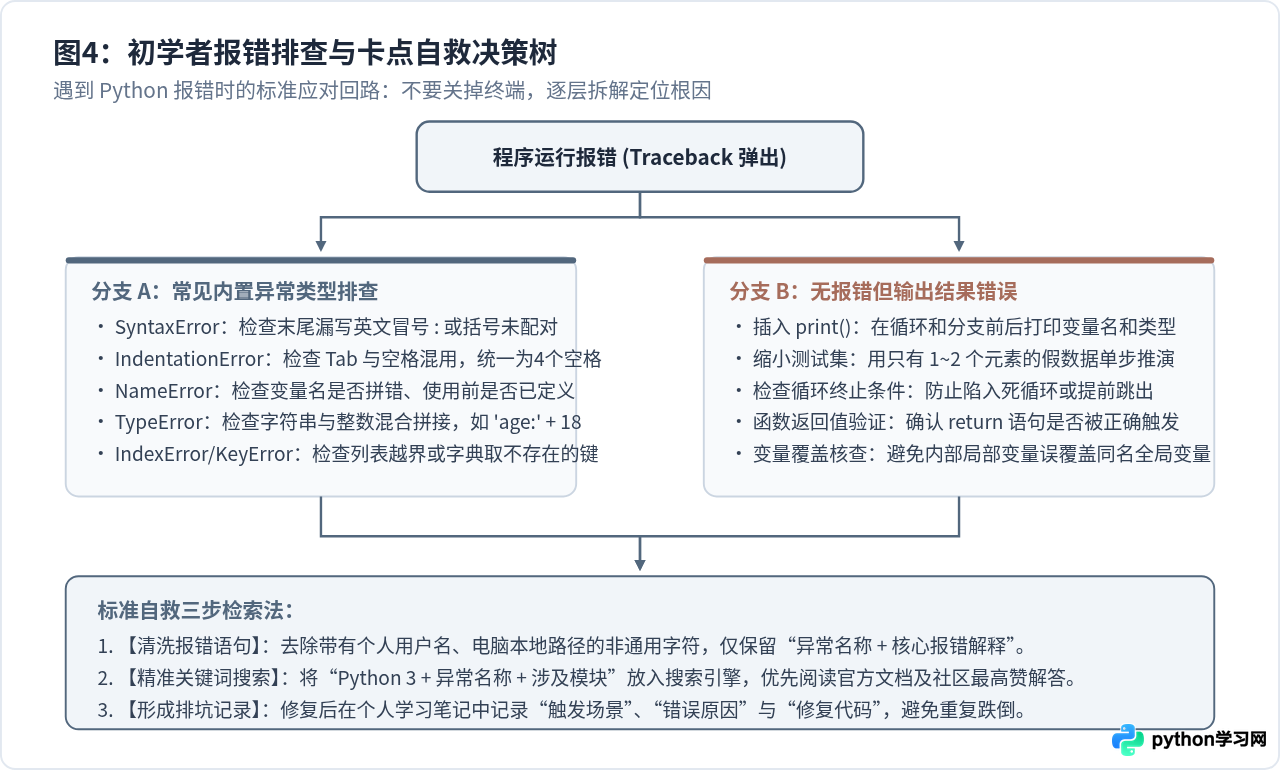
卡点一:面对 Traceback 不知所措
阅读报错信息的第一准则:永远从最底部的那一行看起。
- 最后一行明确标明了错误的具体类别与简述。例如
IndexError: list index out of range直接告诉你列表访问越界了;KeyError: 'age'说明字典中根本不存在'age'这个键。 - 倒数第二行或第三行会明确指出触发错误的文件名与行号(如
File "app.py", line 18)。点击行号即可直接跳转定位问题代码。
卡点二:陷入“以为自己懂了,一关教程大脑一片空白”
这是典型的被动学习陷阱。人类的大脑识别模式比调取记忆容易得多。看别人的代码逻辑流畅,是因为作者已经完成了逻辑构思;当你面对空白屏幕时,需要的是主动设计逻辑结构。
应对方案是采用“注释先行法”:在动手写 Python 代码前,先在编辑器里用中文注释把解决步骤分条写下,然后再逐行将中文翻译成对应的 Python 语句。
import os
import shutil
from pathlib import Path

def archive_log_files(source_dir, target_dir):
    """
    业务逻辑步骤拆解:
    步骤 1: 检查源目录是否存在,不存在则友好提示并退出
    步骤 2: 检查目标归档目录,若不存在则自动创建
    步骤 3: 遍历源目录下所有的 .log 文件
    步骤 4: 安全移动文件至目标目录,并统计迁移成功的文件数
    """
    src_path = Path(source_dir)
    dst_path = Path(target_dir)

    # 步骤 1:源目录前置防御检查
    if not src_path.exists() or not src_path.is_dir():
        print(f"错误:源路径 '{source_dir}' 不存在或不是有效文件夹!")
        return 0

    # 步骤 2:自动建立目标目录
    dst_path.mkdir(parents=True, exist_ok=True)

    moved_count = 0
    # 步骤 3:遍历指定后缀文件
    for item in src_path.glob("*.log"):
        if item.is_file():
            target_file = dst_path / item.name
            try:
                # 步骤 4:移动文件并处理异常
                shutil.move(str(item), str(target_file))
                print(f"已归档: {item.name} -> {target_dir}")
                moved_count += 1
            except Exception as e:
                print(f"移动文件 {item.name} 失败,原因: {e}")

    print(f"归档处理完毕,共成功转移 {moved_count} 个日志文件。")
    return moved_count

if __name__ == "__main__":
    # 执行归档示范
archive_log_files("./workspace_logs", "./archive_logs")五、自学计划的长期执行清单
完成前八周的学习后,你已经跨过了“语法语法看不懂、环境配置配不好”的初学者瓶颈期。此时的你已经具备了看懂官方文档、排查基础报错、编写轻量脚本的独立行动能力。为了让所学知识长期转化为实际生产力,建议在自学计划收尾时落地以下三项资产:
- 建立个人本地代码仓库:把自学期间写过的每一个
.py练习文件按章节命名保存(如ch01_guess.py、ch02_dict_calc.py)。这些亲自敲出的代码将成为未来最方便查阅的代码片段库。 - 沉淀个人的报错速查备忘录:记录下曾困扰你超过 15 分钟的错误排查经历,标注当时的触发条件与修复方法。这比网上的任何通用面经都更契合你的思维盲区。
- 以“解决身边的一个具体小痛点”开启后续进阶:无论是批量整理桌面杂乱的文档、自动从几十个网页表格中抓取数据,还是自动发送邮件周报,用真实需求驱动的代码探索,永远是编程能力跃升的最强动力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









