

Python什么时候用类:类与函数的选择边界
深入解析Python中什么时候用类、什么时候用函数的选择边界。从状态管理、典型反模式、四大真实适用场景到替代方案,提供清晰的决策推导路径与选型自检清单。
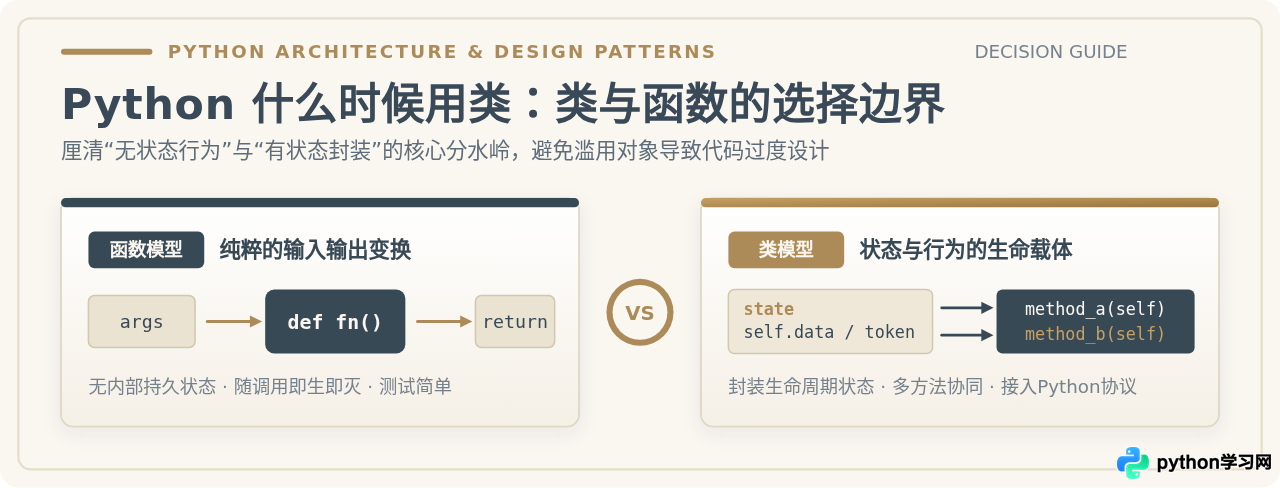
一、核心分水岭:有状态还是无状态?
区分函数与类的最本质标准,不是代码量的多少,也不是业务名词的大小,而是生命周期内是否存在“状态(State)”。
函数是“管道”。它的核心任务是接收输入参数,执行确定的运算步骤,然后输出返回值。函数的生命周期非常短暂:一旦函数执行结束,局部作用域内的栈帧随即被 Python 垃圾回收机制回收,内存中不保留任何历史痕迹。这种“输入即决定输出、执行完不留残余”的特性,被称为无状态计算。
类则是“实体”。类的实例(self)在内存堆中拥有持久的生存空间。它把数据(属性)和对这些数据的操作(方法)包裹在同一个边界内。每次调用实例的方法,内部属性可能随之改变,并影响下一次调用的结果。这种“跨时间持续留存并在多个操作之间互相共享”的特性,被称为有状态封装。
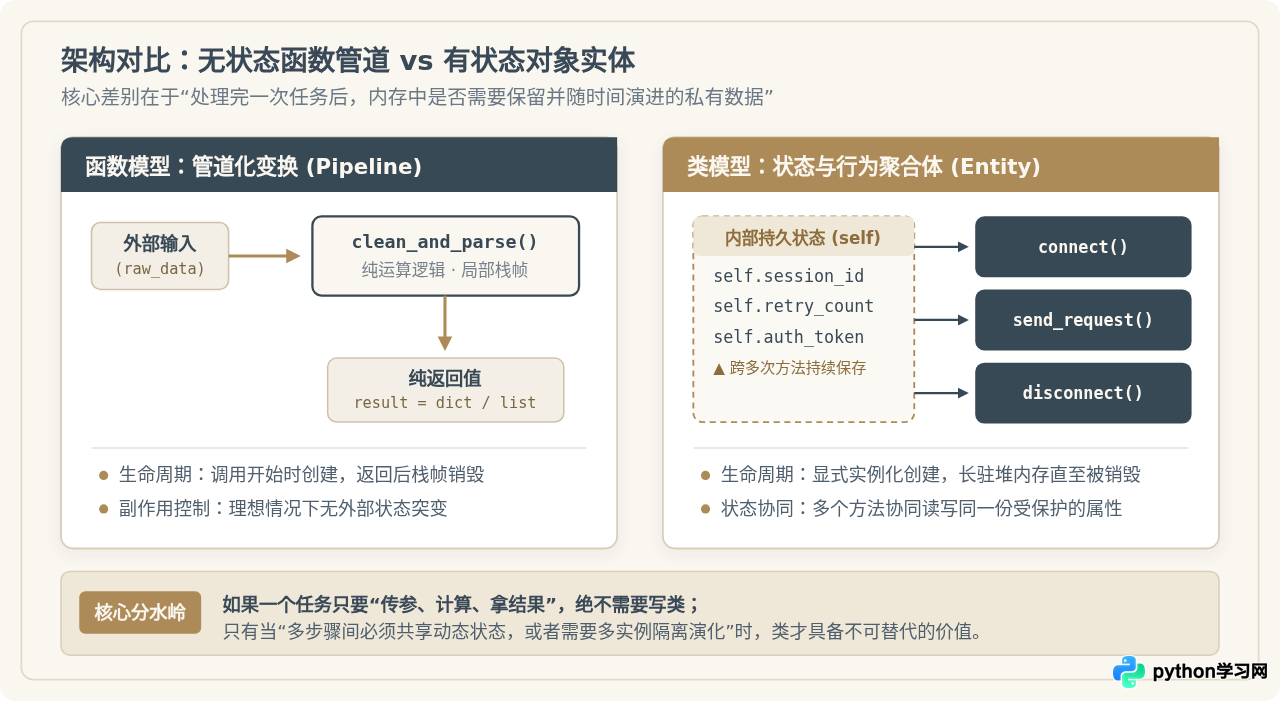
通过一段直观的代码对比即可看清两者的适用界限:
# 【无状态场景】纯输入输出变换:字符串清洗与哈希运算(果断使用函数)
import hashlib

def normalize_and_hash(raw_text: str) -> str:
    cleaned = raw_text.strip().lower()
    return hashlib.sha256(cleaned.encode("utf-8")).hexdigest()

# 调用方式:传入数据直接拿结果,无任何内存残留
digest = normalize_and_hash("  Admin_Token_123  ")
如果有人把上述纯计算逻辑写成一个 Hasher 类,每次使用时先 h = Hasher(raw_text) 然后 h.get_hash(),就属于典型的画蛇添足。因为该计算过程完全不需要跨方法共享并演化状态。
二、警惕两种最典型的“类反模式”
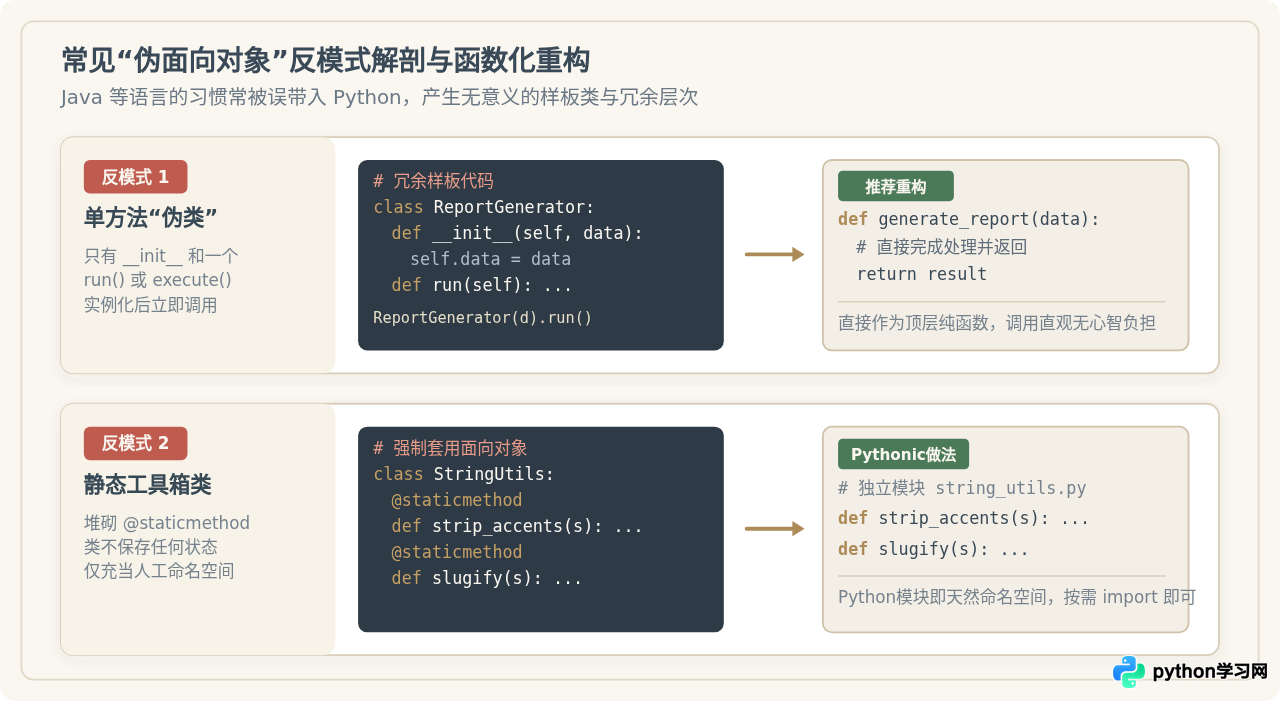
很多来自 Java、C# 或受早期教材影响的开发者,容易把“万物皆对象”的口号生搬硬套到 Python 中。在 Python 核心开发者 Jack Diederich 著名的演讲《Stop Writing Classes》中,提到了两种极为普遍的反模式:
1. 单方法“伪类”
这种类通常只有一个 __init__ 接收参数,外加一个类似 run()、execute() 或 process() 的唯一方法。实例化后通常只调用一次该方法就被丢弃。
# ✘ 反模式:只有一个实际执行方法的“伪类”
class MarkdownCompiler:
    def __init__(self, content: str, enable_toc: bool = True):
        self.content = content
        self.enable_toc = enable_toc

    def compile(self) -> str:
        # 执行转换逻辑
        return f"<html>{self.content}</html>"

# 实际调用必须写两层:实例化 + 调方法
html_out = MarkdownCompiler(raw_doc).compile()

# ✔ 正确做法:直接使用顶层函数
def compile_markdown(content: str, enable_toc: bool = True) -> str:
    return f"<html>{content}</html>"

html_out = compile_markdown(raw_doc)
2. 静态工具箱类(把类当做人工命名空间)
在 Java 中,由于所有函数必须依附于类,因此充斥着类似 MathUtils、StringUtils 这种全由 static 方法组成的类。但在 Python 中,每一个 .py 代码文件本身就是一个天然的独立命名空间(模块)。
在一个 Python 文件里定义一个只有一堆 @staticmethod 的类,完全违背了 Python 的模块化哲学。直接在文件中定义顶层函数,外部通过 import string_utils 来使用,不仅语法干净,还能享受解释器更快的函数查找效率。
三、什么时候必须用类:四类确定性场景
反对滥用类并不意味着排斥面向对象。当满足以下四个条件之一时,使用类是不可替代的最优解:
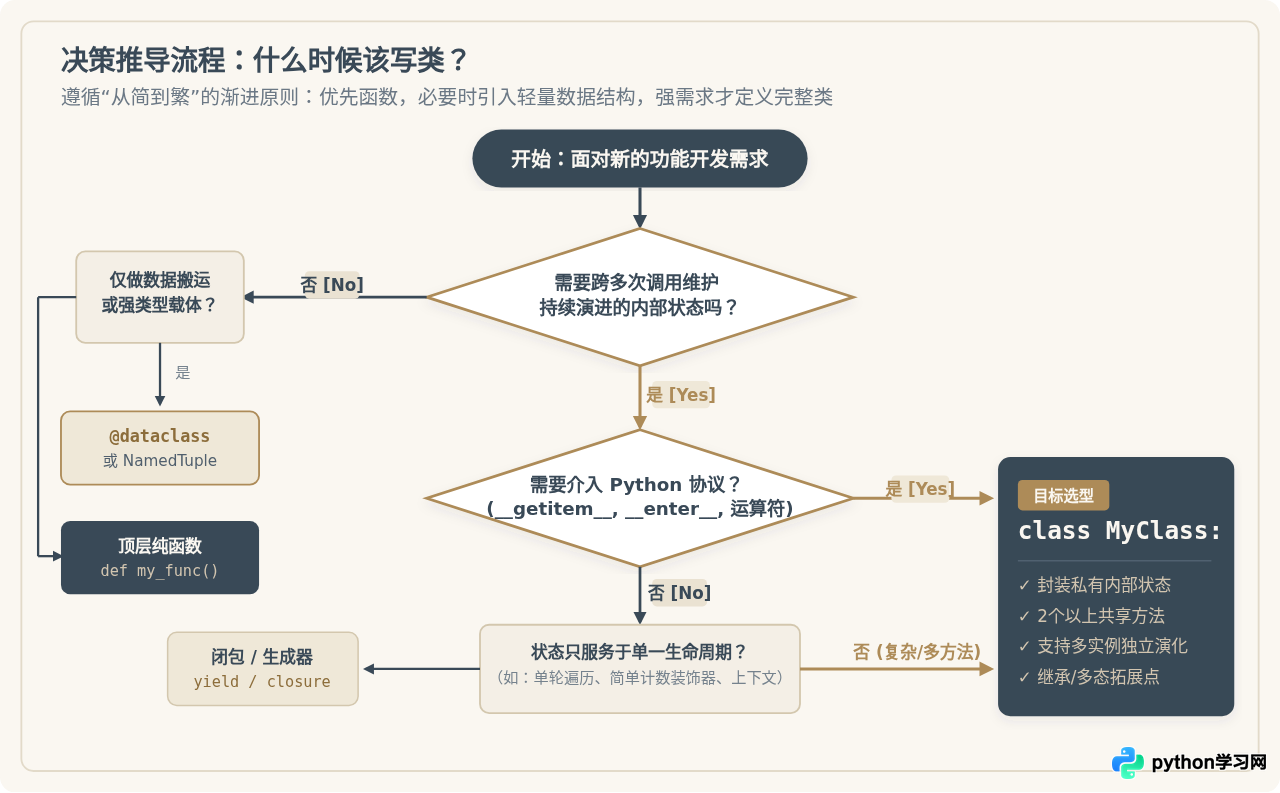
1. 多个方法紧密共享并修改内部持久状态
典型的例子是网络客户端、长连接会话或数据库连接池。在连接建立后,会话维持着身份凭据、重试计数器与底层套接字。调用不同的业务请求方法时,都需要复用并更新这些共享状态。
import time

class APIClientSession:
    def __init__(self, base_url: str, token: str):
        self.base_url = base_url
        self.token = token
        self._request_count = 0
        self._last_active = time.time()

    def send_request(self, endpoint: str, payload: dict) -> dict:
        self._request_count += 1
        self._last_active = time.time()
        # 复用 self.token 发送网络请求...
        return {"status": "ok", "count": self._request_count}

    def get_stats(self) -> dict:
        return {"total": self._request_count, "last_active": self._last_active}
2. 需要介入 Python 数据模型协议(魔法方法)
Python 拥有强大的数据模型协议(Data Model)。如果你希望对象能够支持特定的原生语法,比如使用 with 上下文管理器、像列表一样用 len() 和切片访问、或者支持算术运算符重载,就必须定义类并实现对应的魔术方法(如 __getitem__、__enter__、__eq__)。
3. 多实例独立隔离与演化
如果同一个系统内需要并发或同时管理多个彼此独立的业务实体(例如游戏中的 100 个怪物单位、电商购物车中不同用户的购物车对象),每个实例都需要持有互不干扰的独立数据与操作接口,此时类是天然的边界隔离单元。
4. 策略多态与依赖注入
当业务逻辑依赖某种外部能力,而该能力有多种底层实现方案时(例如:通知渠道有邮件通知、短信通知、企微通知),定义基类规范或协议(Protocol/ABC),通过派生类实现多态,可以大幅解耦核心业务与底层细节。
四、轻量替代方案:介于函数与完整类之间的利器
在实际开发中,需求往往介于“一个函数搞不定”和“写个完整类又太重”之间。现代 Python 提供了数个极具表现力的中间方案:
- 纯数据承载器:
dataclasses.dataclass
当你只需要将分散的几个字段打包成结构体(例如用户配置、订单详情),并不包含复杂的业务方法时,不要手写包含__init__、__repr__的繁琐类,直接使用标准库的@dataclass。 - 轻量级资源清理:
contextlib.contextmanager
如果写类的唯一目的是实现__enter__和__exit__配合with语句(例如临时计时、临时重定向日志),可以使用生成器装饰器,直接用几行函数写出优雅的上下文。 - 单轮流式局部状态:生成器(
yield)
如果需要按需生成数据序列并记录当前迭代进度,优先编写生成器函数,而不是维护一个带内部索引指针的类。
# 场景对比:临时计时上下文(用 contextmanager 代替手写类)
import time
from contextlib import contextmanager

@contextmanager
def timer(label: str):
    start = time.perf_counter()
    try:
        yield
    finally:
        elapsed = time.perf_counter() - start
        print(f"[{label}] 耗时: {elapsed:.4f} 秒")

# 使用时:
with timer("批量计算"):
    sum(i * i for i in range(1_000_000))
五、选型总结与 4 步自检清单
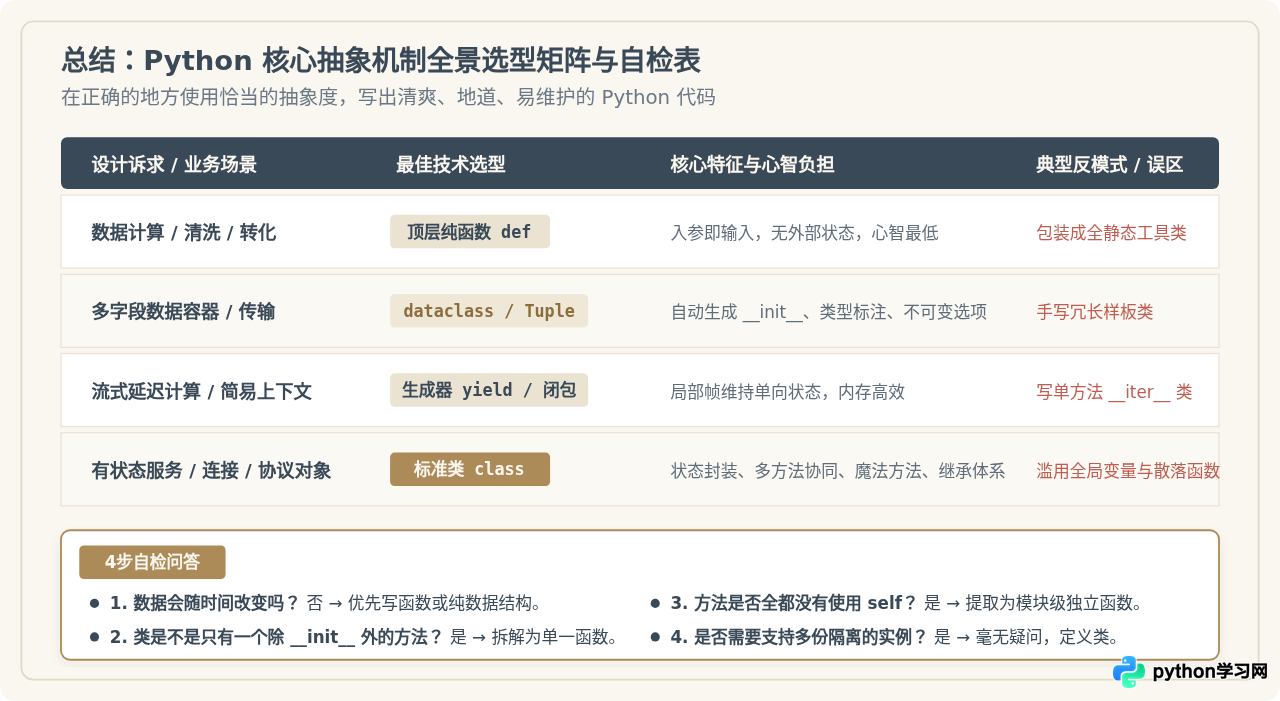
判断一段逻辑该写成类还是函数,可以按照以下自检流程快速确认:
① 状态自检
任务在一次执行完成后,是否有任何数据需要留待后续调用访问?如果没有,坚决使用纯函数。
② 方法数自检
所构想的类是否只有一个核心方法(除 __init__ 外)?如果是,立即改写为顶层函数。
③ self 依附自检
类里的方法是否大量使用 @staticmethod 且完全没有访问 self?如果是,全部提取为模块函数。
④ 协议需求自检
是否需要支持上下文管理、容器索引或运算符?如果是,定义规范类并实现对应的双下划线方法。
总的原则是:从最简单的纯函数开始构建系统。当且仅当多个行为必须共同守护并改变同一份状态时,才把它们升格为一个类。这种渐进式的抽象思维,正是保持 Python 代码简洁、轻盈且高可维护性的关键所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









