

Python自动化办公练习:批量处理Excel与PDF文件的代码实现
针对日常办公中繁重的Excel报表汇总与PDF发票数据提取需求,本文通过3个完整的实战练习,详解使用Python批量合并清洗多源Excel表格、结构化抽取PDF文本与表格数据、以及跨格式自动对账核销的完整代码实现与防御性编程实践。
假设每逢月末,业务团队都会面对堆积如山的繁杂单据:来自全国20多个分支机构的销售明细表(.xlsx),以及供应商随单寄送的近百份增值税电子发票(.pdf)。如果依靠人工逐一打开、核对列名、复制粘贴并比对金额,往往需要耗费一至两天的时间,且极易因疲劳出现遗漏、格式跑偏或输入错位的事故。本文以解决实际工作痛点为目标,使用 Python 标准库 pathlib 结合数据处理库 pandas、openpyxl 与 PDF 解析库 pdfplumber、pypdf,通过三个循序渐进的代码练习,完整实现多源 Excel 自动清洗汇总、PDF 发票信息批量结构化抽取,以及跨格式账单自动对账核销的批处理流水线。
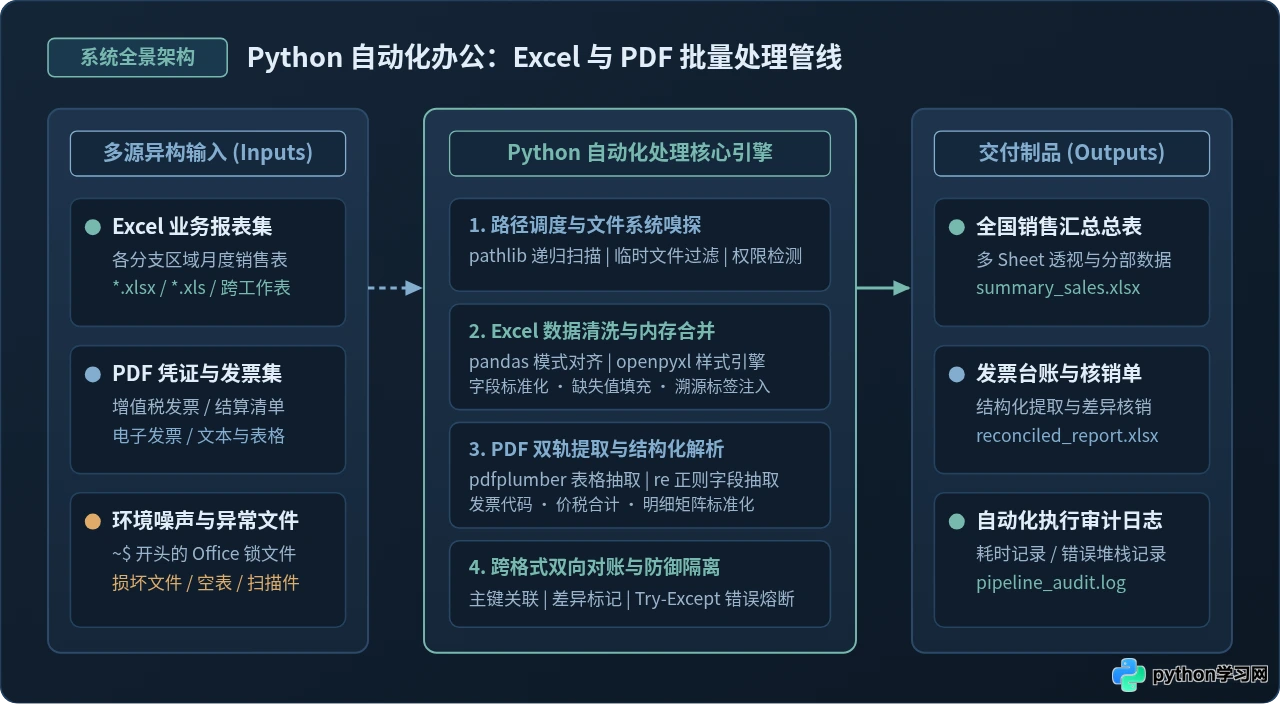
一、工程结构规范与依赖环境配置
在进行批量文件处理时,随意放置脚本和数据源是导致文件被误删、路径混淆或覆盖原始数据的主要原因。规范的批处理程序必须坚持“输入、中间态、输出、归档”完全分离的原则。
1. 依赖库版本与安装
本项目推荐使用 Python 3.10 及以上环境。我们将用 pandas 作为数据运算与合并核心,openpyxl 负责底层 Excel 引擎与格式修饰,pdfplumber 负责精准提取 PDF 文字与表格,pypdf 负责底层的页面流操作。
pip install pandas>=2.0.0 openpyxl>=3.1.0 pdfplumber>=0.10.0 pypdf>=4.0.02. 推荐的标准工程目录结构
保持统一清晰的目录层次,可以让脚本的相对路径寻址更健壮。在项目根目录下规划如下结构:
workspace_auto/
├── data/
│   ├── raw_excel/           # 存放待处理的各分支机构 Excel 原始明细表
│   └── raw_pdf/             # 存放待解析的供应商发票 PDF 原始文件
├── output/                  # 存放清洗合并后的最终汇总总表与对账报告
├── logs/                    # 存放批量执行期间的运行审计与错误追踪日志
├── batch_excel_merge.py     # 练习一:Excel 批量合并清洗脚本
├── batch_pdf_extract.py     # 练习二:PDF 结构化信息抽取脚本
└── reconcile_pipeline.py # 练习三:Excel 与 PDF 自动对账核销脚本在 Windows、macOS 与 Linux 跨平台环境中,反斜杠 \ 与正斜杠 / 的差异极易引发路径异常。Python 3 内置的 pathlib.Path 提供了面向对象的路径处理能力,支持使用 / 运算符自然拼接,并自带 glob()、resolve() 与 exists() 验证,是批处理脚本的标准推荐。
二、练习一:批量合并多源 Excel 表格并完成数据对齐与清洗
多分支机构或不同业务员提交的 Excel 表格,往往存在几个典型痛点:部分表格包含未删除的说明性前导空行;各分部设置的列名存在别名差异(如“销售总额”与“销售金额”);存在已被 Office 打开产生的 ~$ 临时锁死文件;甚至部分表格夹杂着格式错误的脏数据。
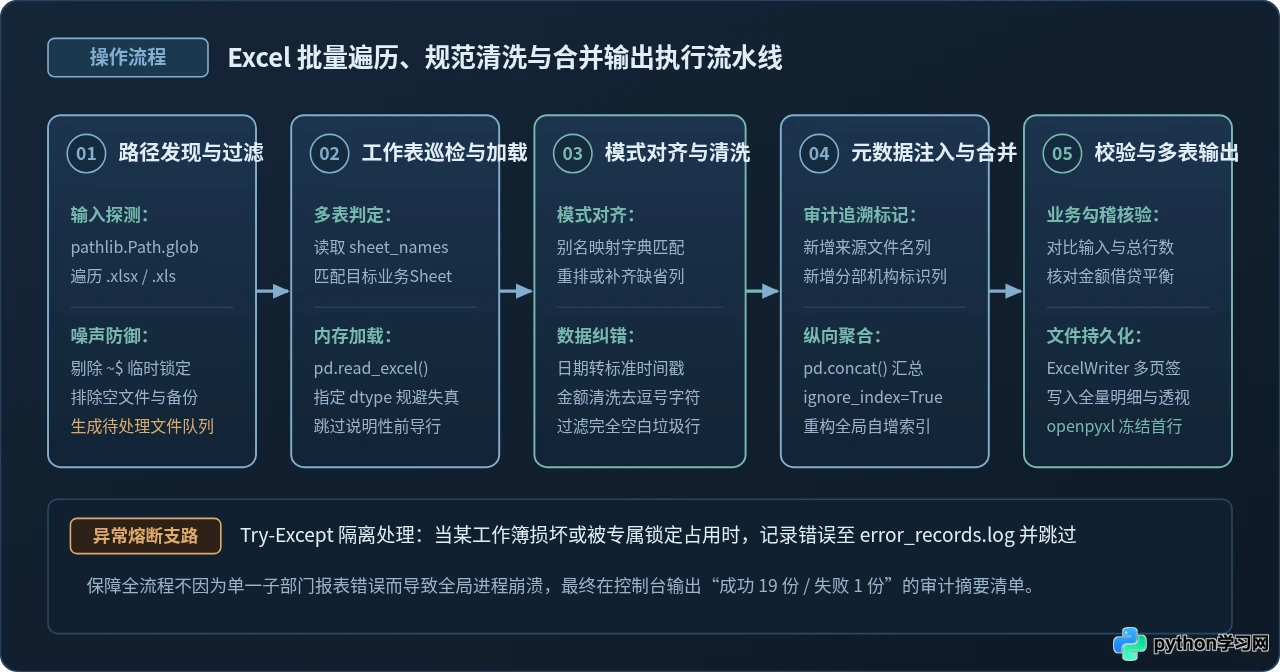
1. 核心实现思路与步骤分解
- 文件发现与排除干扰:使用
Path.glob("*.xlsx")检索目标目录,立即过滤以~$开头的 Office 锁文件,防止触发权限占用错误。 - 动态读取多 Sheet:通过
pd.ExcelFile获取工作簿中所有的 Sheet 名称,优先提取包含“销售”或“明细”的有效工作表。 - 列名标准化映射:定义字典将各分部不同的别名统一映射为标准列名(如“日期”、“分支机构”、“商品名称”、“销售单价”、“销售数量”、“销售总额”)。
- 数据类型强制转换与清洗:将日期列转换为统一的
YYYY-MM-DD,将金额列去除逗号后转换为浮点型数值,剔除全空行。 - 注入溯源元数据:在每个 DataFrame 中添加
来源文件与处理时间戳列,最后使用pd.concat纵向堆叠,生成最终的全国销售总表。
2. 练习一完整代码实现
import datetime
import logging
from pathlib import Path
import pandas as pd

# 配置运行日志
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

# 标准化字段映射字典
COLUMN_MAPPING = {
    "销售日期": "日期",
    "开单日期": "日期",
    "分部": "分支机构",
    "分公司": "分支机构",
    "区域": "分支机构",
    "产品名": "商品名称",
    "品名": "商品名称",
    "单价": "销售单价",
    "数量": "销售数量",
    "销售额": "销售总额",
    "总额": "销售总额",
    "金额": "销售总额",
}

REQUIRED_COLUMNS = ["日期", "分支机构", "商品名称", "销售单价", "销售数量", "销售总额"]


def clean_single_dataframe(df: pd.DataFrame, source_file: Path) -> pd.DataFrame:
    """清洗单个 DataFrame 并按标准模式对齐列名"""
    # 1. 剔除全空行与全空列
    df = df.dropna(how="all").dropna(axis=1, how="all")
    if df.empty:
        return pd.DataFrame()

    # 2. 列名去前后空格与别名标准化映射
    df.columns = [str(c).strip() for c in df.columns]
    df = df.rename(columns=COLUMN_MAPPING)

    # 3. 校验并补全必要列,若缺失则置为空值
    for col in REQUIRED_COLUMNS:
        if col not in df.columns:
            df[col] = pd.NA

    # 只保留标准列集合
    df = df[REQUIRED_COLUMNS].copy()

    # 4. 字段格式化与数据清洗
    # 日期标准化为 YYYY-MM-DD
    df["日期"] = pd.to_datetime(df["日期"], errors="coerce").dt.strftime("%Y-%m-%d")

    # 数值清洗:去除千分位逗号与货币符号,强制转为数值型
    for num_col in ["销售单价", "销售数量", "销售总额"]:
        df[num_col] = (
            df[num_col]
            .astype(str)
            .str.replace(",", "", regex=False)
            .str.replace("¥", "", regex=False)
            .str.strip()
        )
        df[num_col] = pd.to_numeric(df[num_col], errors="coerce").fillna(0.0)

    # 5. 注入溯源信息
    df["_来源文件"] = source_file.name
    df["_导入时间"] = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")

    # 剔除日期依然缺失或无有效数据的脏行
    df = df.dropna(subset=["日期"])
    return df


def batch_merge_excels(input_dir: Path, output_file: Path) -> pd.DataFrame:
    """批量扫描并合并目录下的所有 Excel 文件"""
    if not input_dir.exists():
        raise FileNotFoundError(f"输入目录不存在: {input_dir}")

    collected_frames = []
    success_count = 0
    fail_count = 0

    # 获取所有非临时 xlsx 与 xls 文件
    excel_files = [
        f for f in input_dir.glob("*.xls*")
        if not f.name.startswith("~$") and f.is_file()
    ]
    logging.info(f"检索到待处理 Excel 文件共 {len(excel_files)} 个")

    for file_path in excel_files:
        try:
            # 使用 pd.ExcelFile 智能探测所有 Sheet
            excel_reader = pd.ExcelFile(file_path, engine="openpyxl")
            sheet_names = excel_reader.sheet_names

            for sheet in sheet_names:
                raw_df = pd.read_excel(excel_reader, sheet_name=sheet)
                cleaned_df = clean_single_dataframe(raw_df, file_path)
                if not cleaned_df.empty:
                    collected_frames.append(cleaned_df)

            success_count += 1
            logging.info(f"成功处理文件: {file_path.name} (包含 {len(sheet_names)} 个工作表)")
        except Exception as exc:
            fail_count += 1
            logging.error(f"处理文件 {file_path.name} 失败,错误原因: {exc}")

    if not collected_frames:
        logging.warning("未提取到任何有效数据,跳过导出")
        return pd.DataFrame()

    # 纵向堆叠合并并重置索引
    final_df = pd.concat(collected_frames, ignore_index=True)

    # 导出合并总表至 Excel,保留两个工作表(全量明细与分部透视)
    output_file.parent.mkdir(parents=True, exist_ok=True)
    with pd.ExcelWriter(output_file, engine="openpyxl") as writer:
        final_df.to_excel(writer, sheet_name="全量合并明细", index=False)

        # 自动生成分部汇总透视表
        pivot_df = final_df.pivot_table(
            index="分支机构",
            values=["销售数量", "销售总额"],
            aggfunc={"销售数量": "sum", "销售总额": "sum"},
            margins=True,
            margins_name="全国总计"
        )
        pivot_df.to_excel(writer, sheet_name="分支机构透视汇总")

    logging.info(f"批量合并完成!成功: {success_count} 个, 失败: {fail_count} 个")
    logging.info(f"合并后总记录行数: {len(final_df)}, 导出路径: {output_file.resolve()}")
    return final_df


if __name__ == "__main__":
    BASE_DIR = Path.cwd()
    IN_DIR = BASE_DIR / "data" / "raw_excel"
    OUT_FILE = BASE_DIR / "output" / "全国销售合并汇总总表.xlsx"
batch_merge_excels(IN_DIR, OUT_FILE)2026-11-01 08:30:13 [INFO] 成功处理文件: 华东大区_10月销售明细.xlsx (包含 2 个工作表)
2026-11-01 08:30:13 [INFO] 成功处理文件: 华北大区_10月销售明细.xlsx (包含 1 个工作表)
...
2026-11-01 08:30:15 [INFO] 批量合并完成!成功: 20 个, 失败: 0 个
2026-11-01 08:30:15 [INFO] 合并后总记录行数: 3580, 导出路径: /workspace_auto/output/全国销售合并汇总总表.xlsx
初学者容易在循环体内部使用 df = pd.concat([df, new_row]) 或列表逐步追加 DataFrame。每次调用 concat 都会在内存中全量拷贝旧数据,导致 $O(N^2)$ 的时间复杂度。正确做法是在循环内将每个子表放入 Python 纯列表 collected_frames.append(...),循环结束后仅调用一次 pd.concat(collected_frames)。
三、练习二:批量读取 PDF 关键字段并结构化导出
PDF 是一种基于显示渲染描述的固定版式格式,其底层并没有像 Excel 那样天然的行列单元格结构,文字往往是以绝对坐标流(包含字形、字号与绘制位置)散布在页面上的。要实现批量准确抽取,关键是建立“双轨解析模型”:对单值元数据使用正则表达式抽取,对网格清单使用几何坐标表格提取。
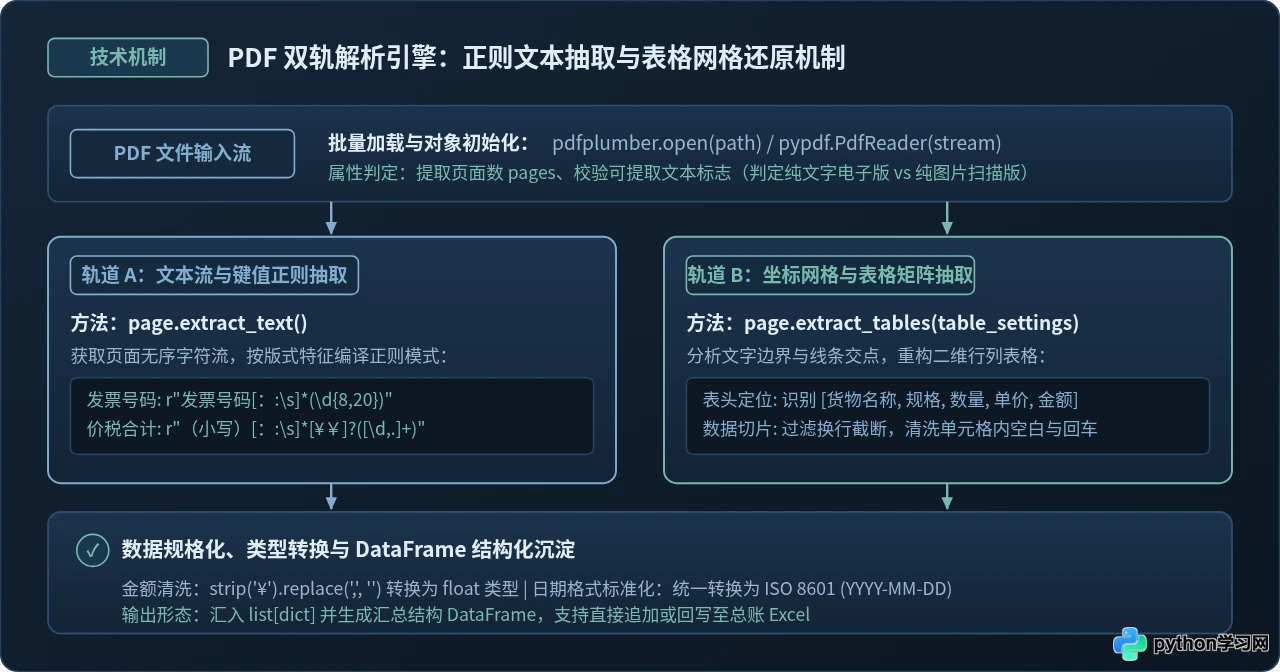
1. 核心提取技术剖析
- 文本流正则匹配:增值税发票中的发票代码(10-12位数字)、发票号码(8-20位数字)、开票日期及价税合计通常出现在固定的文本标签后方。使用精准的正规表达式能够跨越字间距的微小扰动完成匹配。
- 表格边缘重构:
pdfplumber通过检测页面上的水平和垂直线条交点(Line Intersection),将分割框内的文本聚合为二维 Python 列表。 - 文本型 PDF 与扫描件区分:如果
page.extract_text()返回空字符串或乱码,说明该 PDF 是手机拍照或纯图像扫描件。纯代码脚本仅能提取矢量文本型 PDF,扫描件需接入 OCR(光学字符识别)前置模块。
2. 练习二完整代码实现
import logging
from pathlib import Path
import re
import pdfplumber
import pandas as pd

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

# 预编译发票关键字段的正则表达式
PATTERNS = {
    "发票号码": re.compile(r"发票号码[::\s]*(\d{8,20})"),
    "发票代码": re.compile(r"发票代码[::\s]*(\d{10,12})"),
    "开票日期": re.compile(r"开票日期[::\s]*([0-9]{4}年[0-9]{1,2}月[0-9]{1,2}日|[0-9]{4}-[0-9]{1,2}-[0-9]{1,2})"),
    "销方名称": re.compile(r"销售方[名称\s]*[::\s]*([^

]+)"),
    "购买方名称": re.compile(r"购买方[名称\s]*[::\s]*([^

]+)"),
    "价税合计": re.compile(r"(小写)[::\s]*[¥¥]?\s*([0-9,.]+)"),
    "关联订单号": re.compile(r"(?:PO|订单号|合同号)[::\s]*([A-Za-z0-9_-]{6,30})", re.IGNORECASE),
}


def clean_currency_value(raw_val: str) -> float:
    """清理金额文本并转换为标准浮点数"""
    if not raw_val:
        return 0.0
    cleaned = re.sub(r"[^\d.]", "", str(raw_val))
    try:
        return float(cleaned)
    except ValueError:
        return 0.0


def extract_single_invoice_pdf(pdf_path: Path) -> dict:
    """提取单张发票 PDF 的关键结构化字段"""
    invoice_data = {
        "文件名": pdf_path.name,
        "发票号码": "",
        "发票代码": "",
        "开票日期": "",
        "销售方": "",
        "购买方": "",
        "价税合计金额": 0.0,
        "关联订单号": "",
        "解析状态": "成功"
    }

    try:
        with pdfplumber.open(pdf_path) as pdf:
            if not pdf.pages:
                invoice_data["解析状态"] = "空PDF文件"
                return invoice_data

            # 增值税发票主要元数据通常位于第一页
            first_page = pdf.pages[0]
            page_text = first_page.extract_text() or ""

            if not page_text.strip():
                invoice_data["解析状态"] = "无法提取文字(疑似图片扫描件)"
                return invoice_data

            # 正则匹配各字段
            for field, pattern in PATTERNS.items():
                match = pattern.search(page_text)
                if match:
                    val = match.group(1).strip()
                    if field == "价税合计":
                        invoice_data["价税合计金额"] = clean_currency_value(val)
                    elif field == "销方名称":
                        invoice_data["销售方"] = val
                    elif field == "购买方名称":
                        invoice_data["购买方"] = val
                    else:
                        invoice_data[field] = val

            # 标准化日期为 YYYY-MM-DD
            if invoice_data["开票日期"]:
                date_str = invoice_data["开票日期"].replace("年", "-").replace("月", "-").replace("日", "")
                parts = [p.zfill(2) for p in date_str.split("-")]
                if len(parts) == 3:
                    invoice_data["开票日期"] = f"{parts[0]}-{parts[1]}-{parts[2]}"

            # 校验核心字段是否成功获取
            if not invoice_data["发票号码"] and invoice_data["价税合计金额"] == 0.0:
                invoice_data["解析状态"] = "未匹配到核心发票特征"

    except Exception as err:
        invoice_data["解析状态"] = f"读取异常: {str(err)}"

    return invoice_data


def batch_extract_pdfs(pdf_dir: Path, output_excel: Path) -> pd.DataFrame:
    """批量解析 PDF 目录并输出结构化台账"""
    if not pdf_dir.exists():
        raise FileNotFoundError(f"PDF 目录不存在: {pdf_dir}")

    pdf_files = list(pdf_dir.glob("*.pdf"))
    logging.info(f"检索到待提取 PDF 文件共 {len(pdf_files)} 份")

    results = []
    for pdf_file in pdf_files:
        info = extract_single_invoice_pdf(pdf_file)
        results.append(info)
        logging.info(f"已解析: {pdf_file.name} -> 发票号: {info['发票号码']}, 金额: {info['价税合计金额']}")

    df = pd.DataFrame(results)

    # 结果写入 Excel
    output_excel.parent.mkdir(parents=True, exist_ok=True)
    df.to_excel(output_excel, sheet_name="发票提取台账", index=False)
    logging.info(f"PDF 提取台账已成功导出至: {output_excel.resolve()}")
    return df


if __name__ == "__main__":
    BASE_DIR = Path.cwd()
    PDF_INPUT = BASE_DIR / "data" / "raw_pdf"
    OUT_TABLE = BASE_DIR / "output" / "发票结构化台账.xlsx"
batch_extract_pdfs(PDF_INPUT, OUT_TABLE)2026-11-01 08:35:02 [INFO] 已解析: 供应商A_发票_1029381.pdf -> 发票号: 1029381, 金额: 12500.0
2026-11-01 08:35:02 [INFO] 已解析: 供应商B_发票_9841203.pdf -> 发票号: 9841203, 金额: 3420.5
...
2026-11-01 08:35:08 [INFO] PDF 提取台账已成功导出至: /workspace_auto/output/发票结构化台账.xlsx
四、练习三:跨格式协同:从 PDF 提取数据回填至 Excel 模板与对账
在真正的企业业务链条中,单一格式的批处理通常只是半成品。财务与供应链人员最耗时的环节,往往是跨格式协同对账:将从供应商发票(PDF)提取的实际到票信息,与内部 ERP/采购系统导出的付款申请总表(Excel)按采购单号(PO Number)进行双向核销比对。
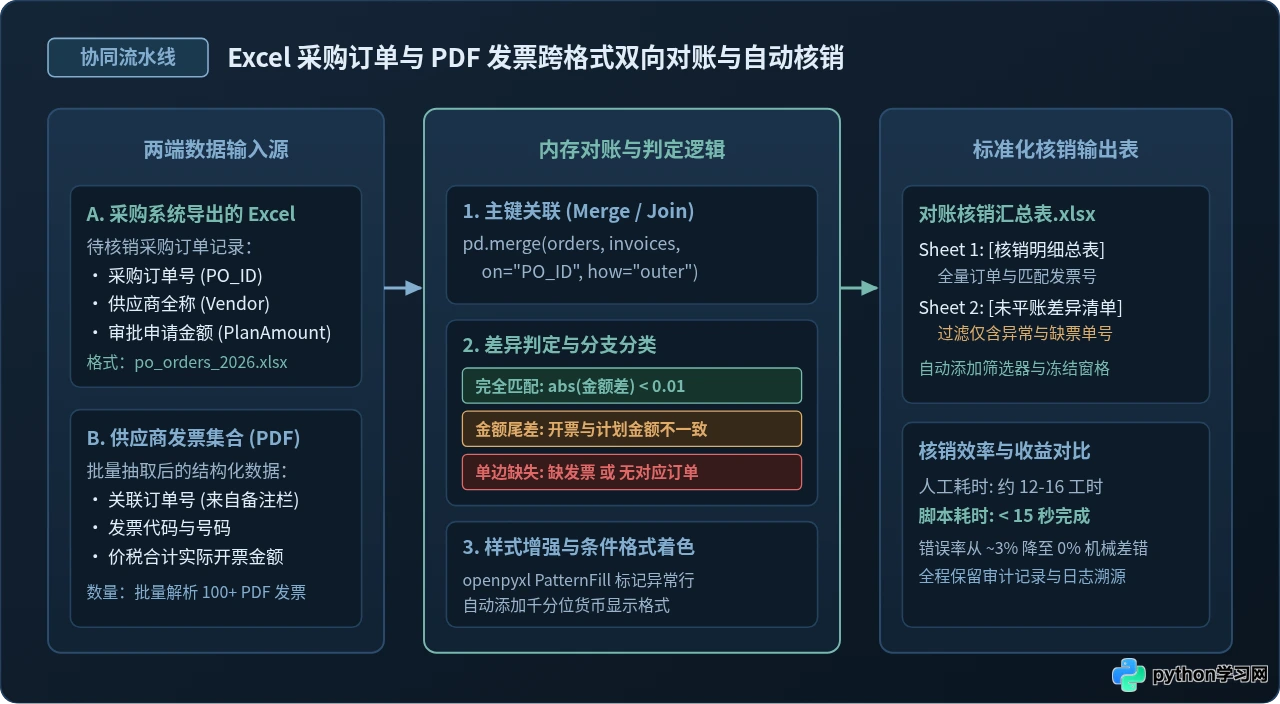
1. 协同核销业务逻辑
- 构建两端数据集:左侧为采购订单库 DataFrame(包含订单号、供应商、申请付款金额);右侧为练习二中从批量 PDF 发票解析出的实到发票 DataFrame(包含关联订单号、发票号码、开票金额)。
- 外连接匹配(Outer Merge):使用
pd.merge(orders, invoices, left_on="PO_ID", right_on="关联订单号", how="outer"),全面暴露三种可能的业务异常:- 完全匹配:订单存在且发票存在,双方金额差额绝对值小于 0.01 元。
- 金额尾差异常:订单与发票关联成功,但发票开具金额与申请金额不一致(存在差额)。
- 单边缺失:有采购申请但尚未收到发票(待催票),或者收到发票但在系统内查无对应采购单(无订单违规开票)。
- 样式高亮导出:利用
openpyxl的条件填充样式,对核销成功的行填充浅绿底色,对存在差额的行填充浅橙色警示,对单边缺失填充浅红色,极大减轻人工复核负担。
2. 练习三完整代码实现
import logging
from pathlib import Path
import openpyxl
from openpyxl.styles import Font, PatternFill, Alignment, Border, Side
import pandas as pd

from batch_pdf_extract import batch_extract_pdfs

logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)

# 定义样式高亮色板
FILL_SUCCESS = PatternFill(start_color="D1E7DD", end_color="D1E7DD", fill_type="solid")  # 柔和淡绿
FILL_WARNING = PatternFill(start_color="FFF3CD", end_color="FFF3CD", fill_type="solid")  # 柔和淡橙
FILL_DANGER = PatternFill(start_color="F8D7DA", end_color="F8D7DA", fill_type="solid")   # 柔和淡红


def reconcile_orders_and_invoices(
    orders_excel: Path,
    pdf_invoices_dir: Path,
    output_report_file: Path
) -> Path:
    """执行采购订单 Excel 与发票 PDF 的自动化双向对账"""
    if not orders_excel.exists():
        raise FileNotFoundError(f"采购订单文件未找到: {orders_excel}")

    # 1. 加载采购系统订单 Excel
    orders_df = pd.read_excel(orders_excel)
    orders_df["PO_ID"] = orders_df["PO_ID"].astype(str).str.strip()
    orders_df["申请金额"] = pd.to_numeric(orders_df["申请金额"], errors="coerce").fillna(0.0)

    # 2. 批量解析发票 PDF
    temp_invoice_excel = output_report_file.parent / "_temp_invoices.xlsx"
    invoices_df = batch_extract_pdfs(pdf_invoices_dir, temp_invoice_excel)
    invoices_df["关联订单号"] = invoices_df["关联订单号"].astype(str).str.strip()

    # 3. 双向外连接比对
    merged = pd.merge(
        orders_df,
        invoices_df,
        left_on="PO_ID",
        right_on="关联订单号",
        how="outer",
        indicator="_匹配方向"
    )

    # 4. 业务核销状态判定
    reconcile_status = []
    amount_diff = []

    for _, row in merged.iterrows():
        match_dir = row["_匹配方向"]
        plan_amt = row.get("申请金额", 0.0) or 0.0
        act_amt = row.get("价税合计金额", 0.0) or 0.0
        diff = round(act_amt - plan_amt, 2)
        amount_diff.append(diff)

        if match_dir == "both":
            if abs(diff) < 0.01:
                reconcile_status.append("核销成功(金额一致)")
            else:
                reconcile_status.append(f"金额不符(差额: {diff}元)")
        elif match_dir == "left_only":
            reconcile_status.append("异常:有订单但未到发票")
        else:
            reconcile_status.append("异常:有发票无采购订单")

    merged["核销判定状态"] = reconcile_status
    merged["核销差额"] = amount_diff

    # 整理输出列顺序
    export_columns = [
        "PO_ID", "供应商名称", "申请金额",
        "发票号码", "价税合计金额", "核销差额",
        "开票日期", "核销判定状态", "文件名"
    ]
    # 补齐缺漏列
    for col in export_columns:
        if col not in merged.columns:
            merged[col] = ""
    export_df = merged[export_columns].copy()

    # 5. 写入 Excel 并应用高亮条件格式
    output_report_file.parent.mkdir(parents=True, exist_ok=True)
    export_df.to_excel(output_report_file, sheet_name="核销对账明细", index=False)

    # 加载 openpyxl 工作簿注入视觉格式
    wb = openpyxl.load_workbook(output_report_file)
    ws = wb["核销对账明细"]

    # 冻结首行表头
    ws.freeze_panes = "A2"

    # 表头样式
    header_fill = PatternFill(start_color="1F3854", end_color="1F3854", fill_type="solid")
    header_font = Font(name="微软雅黑", size=11, bold=True, color="FFFFFF")
    for cell in ws[1]:
        cell.fill = header_fill
        cell.font = header_font
        cell.alignment = Alignment(horizontal="center", vertical="center")

    # 根据核销判定状态为整行着色
    status_col_idx = export_columns.index("核销判定状态") + 1
    for row_idx in range(2, ws.max_row + 1):
        status_val = str(ws.cell(row=row_idx, column=status_col_idx).value or "")
        row_fill = None
        if "核销成功" in status_val:
            row_fill = FILL_SUCCESS
        elif "金额不符" in status_val:
            row_fill = FILL_WARNING
        elif "异常" in status_val:
            row_fill = FILL_DANGER

        if row_fill:
            for c_idx in range(1, len(export_columns) + 1):
                ws.cell(row=row_idx, column=c_idx).fill = row_fill

    # 自动适应列宽
    for col in ws.columns:
        max_len = max(len(str(cell.value or "")) for cell in col)
        col_letter = openpyxl.utils.get_column_letter(col[0].column)
        ws.column_dimensions[col_letter].width = max(max_len + 4, 12)

    # 临时文件清理
    if temp_invoice_excel.exists():
        temp_invoice_excel.unlink()

    wb.save(output_report_file)
    logging.info(f"对账流水线执行完毕,带条件格式的核销报表已输出至: {output_report_file}")
    return output_report_file


if __name__ == "__main__":
    BASE = Path.cwd()
    ORDERS = BASE / "data" / "po_orders_2026.xlsx"
    PDF_DIR = BASE / "data" / "raw_pdf"
    OUT_REPORT = BASE / "output" / "采购发票自动化核销对账终表.xlsx"
reconcile_orders_and_invoices(ORDERS, PDF_DIR, OUT_REPORT)• 完全核销成功: 54 笔(金额无偏差,已标记浅绿色)
• 金额尾差警示: 2 笔(已标记浅橙色,例: PO202610-09 差额 +15.20 元)
• 未到发票订单: 4 笔(已标记浅红色,已生成待催收清单)
• 无单据到票: 2 笔(已移交采购合规部门核查)
五、生产级批处理的核心保障机制与常见问题排查
在个人电脑上运行简单的示范脚本通常很顺利,但将脚本部署至业务环境、面对成百上千个格式各异的文件时,往往会面临各种意外崩溃。要编写生产级的批处理程序,必须在架构中融入防御性编程设计。
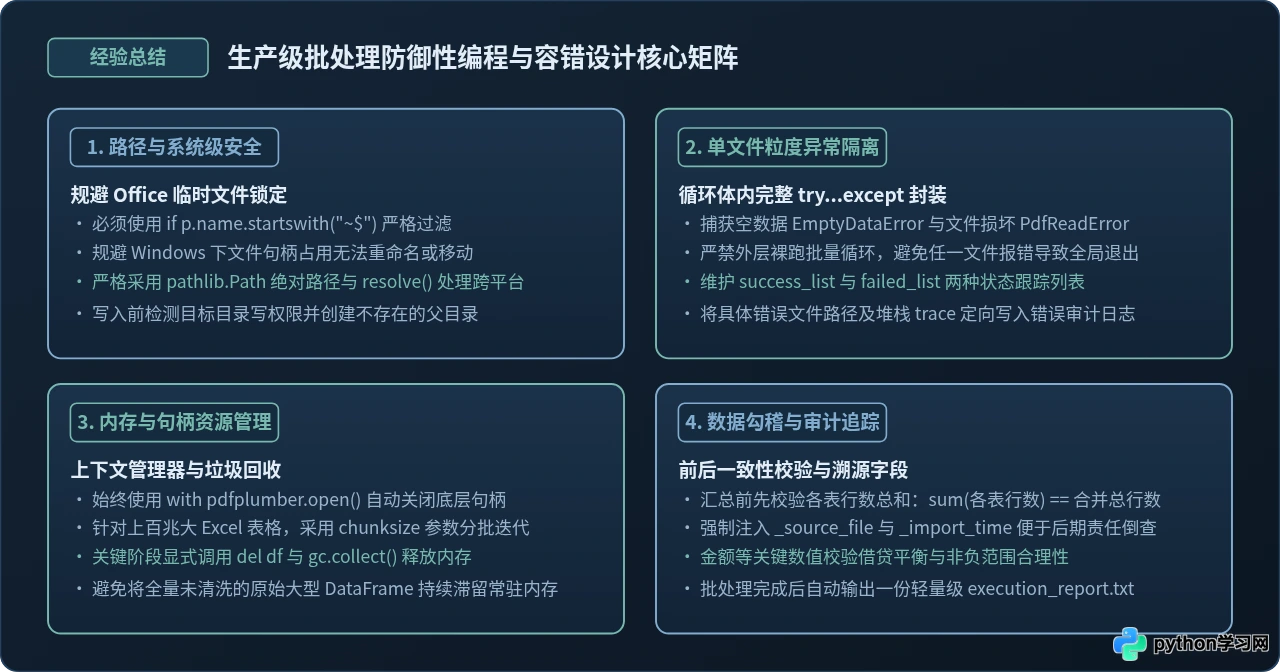
1. 四大核心防御策略
| 防御维度 | 典型故障场景 | 生产级规避方案 |
|---|---|---|
| 文件锁与临时文件 | 业务人员正在打开 Excel 文件,Office 生成 ~$xxx.xlsx,导致脚本读取时触发 PermissionError |
遍历时显式过滤 name.startswith("~$");对被占用的文件捕获 PermissionError 并记录至待办队列,不阻断全局任务。 |
| 数据模式不一致 | 部分 Excel 缺少关键列、或者列头存在多余前后空格与换行,导致 KeyError |
对所有读取的列名执行 str.strip(),并通过 rename(columns=dict) 统一规范;缺失列使用 pd.NA 柔性填补。 |
| 句柄泄露与内存膨胀 | 循环打开上千个 PDF 文件,未显式关闭导致系统打开文件数达到上限(Too many open files) |
严格使用 with pdfplumber.open(...) as pdf: 上下文管理器;大批次处理时按批次手动调用 gc.collect() 释放内存。 |
| 数据一致性与审计 | 合并后记录遗漏,或数据在转换过程中产生精度损失 | 在合并前后比对分表记录数总和是否等于总表记录数;写入 _来源文件 与 _导入时间 溯源标签,便于后续对账倒查。 |
2. 常见报错排查速查指南
- 问题 1:
zipfile.BadZipFile: File is not a zip file
原因分析:目标文件虽然以后缀.xlsx命名,但实际是老旧的二进制.xls格式、CSV 文件、或者是损坏的文件。
解决办法:使用try...except zipfile.BadZipFile捕获,尝试切换为engine="xlrd"读取,若仍失败则记录损坏日志并跳过。 - 问题 2:
IndexError: list index out of range(PDF 表格提取时)
原因分析:调用extract_tables()时,并非所有页面都包含表格,或者提取到的表格是空列表[]。
解决办法:在索引访问前始终先校验非空性:if tables and len(tables[0]) > 0: ...。 - 问题 3:数字型长编码(如发票号、身份证号、订单号)末尾变 0 或科学计数法
原因分析:Pandas 默认将全数字列推断为int64或float64,在超出精度或导出至 Excel 时被格式化为科学计数法。
解决办法:在读取时通过dtype={"发票号码": str, "PO_ID": str}显式指定为文本字符串类型。
六、总结与自动化进阶建议
通过本文的三个实战练习,我们完成了从单一格式批量处理到多格式协同核销的完整代码闭环:
- 练习一:建立了基于
pathlib与pandas的多源 Excel 自动检索、临时文件过滤、模式对齐与多页签持久化标准模板; - 练习二:掌握了基于
pdfplumber与正则表达式的双轨 PDF 抽取机制,将离散的无结构文本流转化为具备结构化特征的明细数据; - 练习三:将 PDF 数据与 Excel 采购订单关联,通过外连接判定与
openpyxl条件格式着色,实现了高可靠、低失误的业务自动化核销流水线。
在未来的日常业务扩展中,建议进一步将此类批处理脚本与定时调度工具(如 Windows 任务计划程序或 Linux Crontab)相结合,亦或加入自动化邮件收发功能(如使用 smtplib),让脚本在每月固定的结算日自动从邮箱抓取附件、执行批处理并自动发送对账核销汇总,真正实现“零人工干预”的高效自动化办公。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









