

Python使用schedule库实现定时运行py文件
详细讲解如何使用Python的schedule轻量调度库定时运行外部py文件。涵盖subprocess子进程隔离方案、路径与解释器锁定、长任务阻塞解决、多线程调度及生产环境守护落地的全流程实践。
schedule 库定时执行另一个独立的 .py 脚本,最稳妥、规范的做法是通过 Python 内置的 subprocess 模块发起独立子进程。由 schedule 负责轻量级的时间周期判断与轮询节拍,当满足执行条件时拉起外部 Python 进程运行目标代码。这种架构既保留了 schedule 声明式语法清晰简明的优点,又实现了调度引擎与业务代码的彻底解耦,避免了内存污染、全局状态干扰以及子任务崩溃殃及主调度器的问题。
一、基础准备:拆分调度器与目标业务脚本
定时执行脚本时,许多初学者容易把所有逻辑揉杂在单个脚本中。真正健壮的工程做法是建立清晰的职责分离:
- 目标脚本(Worker):专心完成具体业务逻辑(如爬虫采集、数据清洗、报表导出或模型推理),独立运行即可退出,不关心何时被触发。
- 调度器脚本(Scheduler):轻量常驻进程,专门用于跟踪预设时刻、维护执行时间表,并在时机成熟时调用目标脚本。
1. 安装 schedule 依赖库
schedule 是一个纯 Python 实现的轻量任务调度库,不依赖任何第三方二进制扩展。在终端或虚拟环境中运行以下命令完成安装:
pip install schedule2. 编写独立的目标脚本 worker.py
在项目工作目录中创建名为 worker.py 的独立脚本。该脚本仅负责业务,完成后正常退出:
import sys
import time
from datetime import datetime

def run_task():
    current_time = datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    print(f"[{current_time}] [Worker] 开始执行日常统计同步任务...")

    # 模拟耗时操作,例如网络请求或数据库写入
    time.sleep(2)

    print(f"[{current_time}] [Worker] 任务完成,正常退出。")

if __name__ == "__main__":
    run_task()
    sys.exit(0)
在正式接入调度器之前,应先在终端手动执行一次以验证脚本本身无语法错误与缺包问题:
python3 worker.py二、核心实现:基于 subprocess 的标准调度模式
调用外部 .py 脚本时,强烈推荐使用 Python 标准库中的 subprocess.run()。它能直接利用当前系统已激活的 Python 解释器启动独立进程。
import sys
import time
import schedule
import subprocess
from pathlib import Path

# 定位当前脚本所在目录及目标 py 文件的绝对路径
BASE_DIR = Path(__file__).resolve().parent
TARGET_SCRIPT = BASE_DIR / "worker.py"

def execute_py_file():
    '''触发并执行外部 py 脚本的回调任务'''
    if not TARGET_SCRIPT.exists():
        print(f"❌ 错误:找不到目标文件 {TARGET_SCRIPT}")
        return

    print(f"⏰ [Scheduler] 到达预定时间,准备启动子进程:{TARGET_SCRIPT.name}")

    try:
        # sys.executable 确保调用与调度器完全相同的 Python 解释器环境
        result = subprocess.run(
            [sys.executable, str(TARGET_SCRIPT)],
            capture_output=True,
            text=True,
            timeout=60,  # 设定最大执行限时,防止外部任务死锁
            cwd=str(BASE_DIR)  # 显式对齐工作目录,避免文件相对路径找不到
        )

        # 打印子进程的标准输出与标准错误
        if result.stdout:
            print("--- [子进程输出] ---")
            print(result.stdout.strip())

        if result.returncode == 0:
            print(f"✅ [Scheduler] 子进程执行成功 (退出码: {result.returncode})")
        else:
            print(f"⚠️ [Scheduler] 子进程返回异常退出码: {result.returncode}")
            if result.stderr:
                print(f"--- [错误详情] ---\n{result.stderr.strip()}")

    except subprocess.TimeoutExpired:
        print(f"⛔ [Scheduler] 任务执行超时(超过 60 秒),已强制终止")
    except Exception as e:
        print(f"❌ [Scheduler] 调用子进程发生未预料异常: {e}")

# 注册定时调度规则
# 示例 1: 每隔 10 秒执行一次(便于调试观察)
schedule.every(10).seconds.do(execute_py_file)

# 示例 2: 常用常规周期设定语法
# schedule.every(30).minutes.do(execute_py_file)
# schedule.every().hour.at(":15").do(execute_py_file)
# schedule.every().day.at("02:30").do(execute_py_file)
# schedule.every().monday.at("09:00").do(execute_py_file)

print("🚀 [Scheduler] 调度服务已启动,按 Ctrl + C 可终止...")

# 维持主轮询常驻循环
while True:
    schedule.run_pending()
    time.sleep(1)  # 适度休眠 1 秒,将 CPU 占用率降至近 0%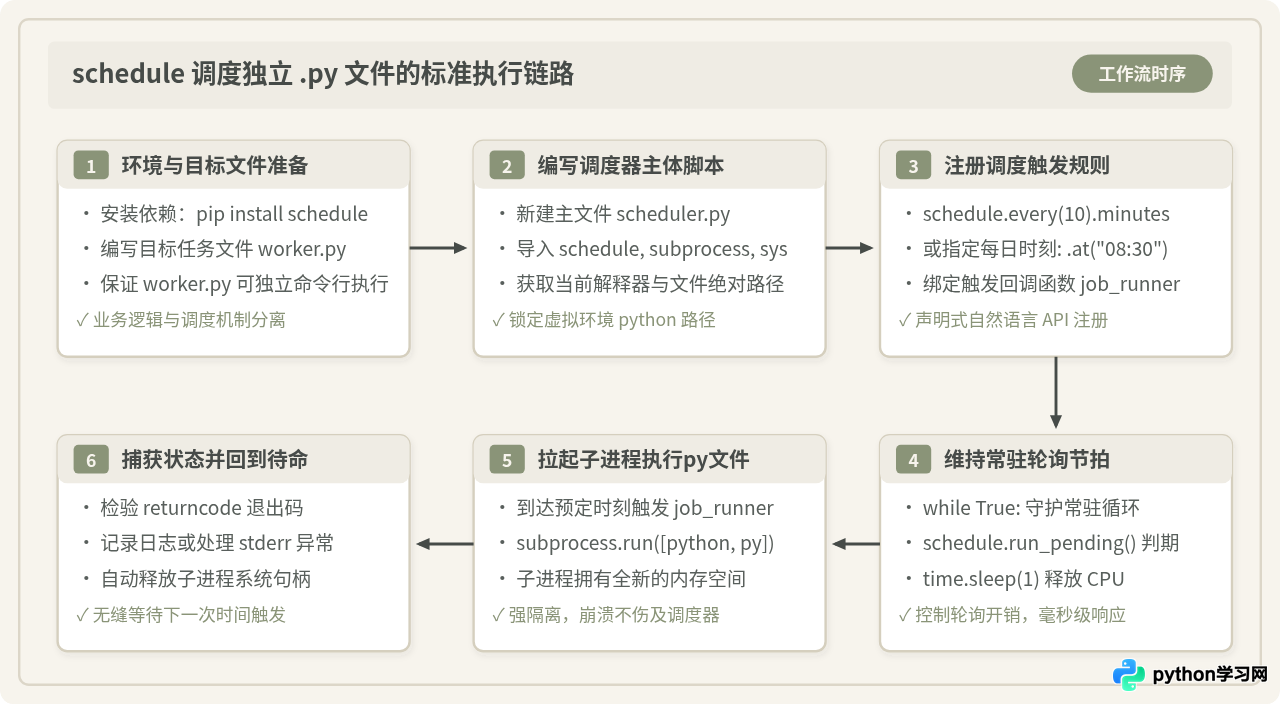
核心代码要点解释
sys.executable的必要性:在终端中直接敲python往往容易指向系统全局解释器,而项目通常运行在 Poetry、Conda 或 venv 虚拟环境中。sys.executable返回启动调度器本身的 Python 解释器绝对路径,百分之百保证子进程与调度器共用相同的依赖包。pathlib.Path绝对路径:无论从哪个终端路径启动调度器,基于__file__计算目标文件路径都能彻底规避FileNotFoundError。time.sleep(1)的节能机制:schedule.run_pending()只是检查当前时间是否达到任务触发线。如果没有time.sleep(),空转的死循环将瞬间吃满单核 CPU 100%;休眠 1 秒既能保证秒级精度,又能让 CPU 占用率接近 0%。
三、深入辨析:为什么推荐 subprocess 而非直接 import?
部分开发者会有疑问:“既然都是 Python 代码,为什么不直接 import worker; worker.run_task(),还要大费周章地调用 subprocess 呢?”
这种疑问很自然,因为在纯函数式脚本中 import 看上去代码更紧凑、没有进程创建的微小开销。但在“定时运行既有 py 文件”这个场景下,直接 import 会带来三个隐蔽且致命的问题:
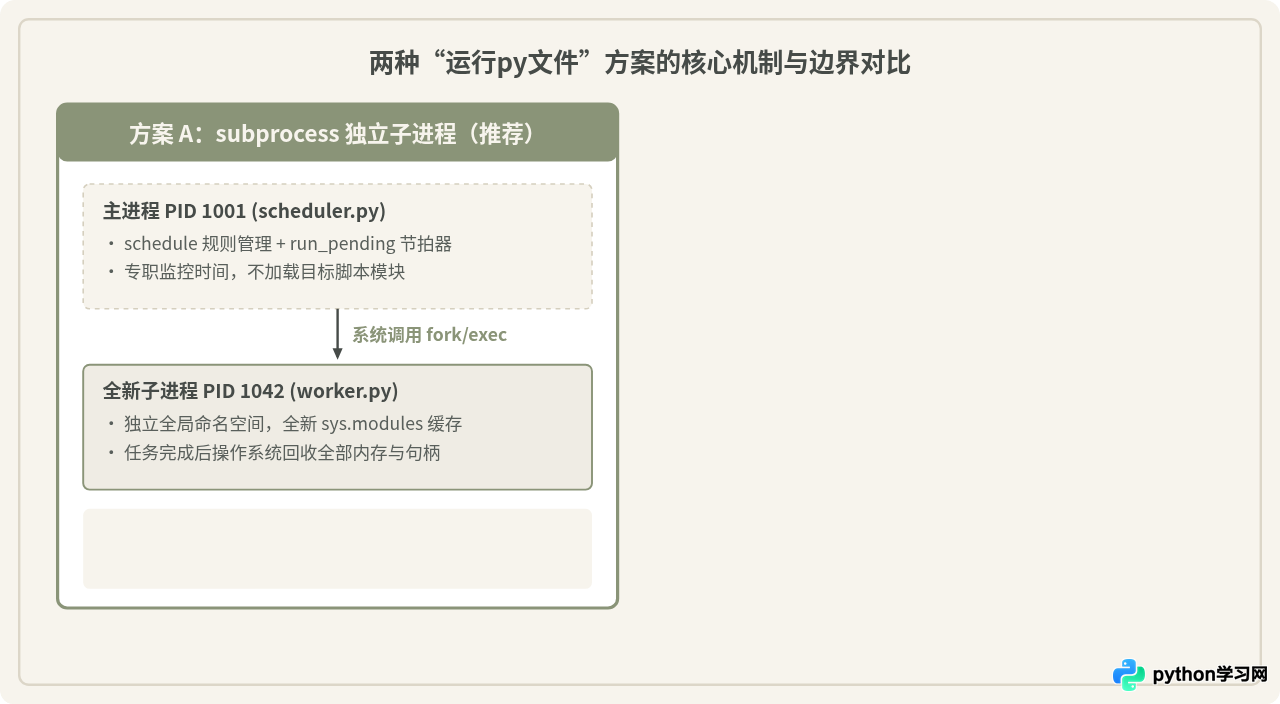
| 对比维度 | subprocess.run 独立子进程(推荐) | 直接 import 模块调用 |
|---|---|---|
| 内存与状态隔离 | 每次运行分配独立内存,执行完毕全部由操作系统回收,全局变量自动重置。 | 共享同一进程,模块缓存在 sys.modules 中,静态变量与单例对象长期驻留。 |
| 故障扩散性 | 子进程抛出未捕获异常、OOM 内存溢出或调用 sys.exit(),主调度器不受波及。 |
目标脚本若触发 sys.exit() 或未捕获严重异常,直接导致整个主调度器崩溃退出。 |
| 热更新支持 | 修改 worker.py 文件代码后,下一次触发时自动执行最新代码,无需重启调度器。 |
由于 Python 模块缓存机制,修改文件后必须手动介入 importlib.reload(),极其繁琐。 |
| 启动性能 | 有毫秒级的 Python 解释器启动开销,适合周期为秒级以上的定时离线批处理。 | 函数直接调用,无进程创建开销,仅适合高频、无状态的微型内存计算。 |
四、进阶处理:耗时任务阻塞与非阻塞多线程调度
schedule 默认是单线程阻塞运行的。这意味着:如果一个任务的实际运行耗时超过了设定的调度间隔,主轮询线程就会被卡住,后续原本应该触发的任务将被积压推迟,产生不可逆的时间基准漂移。
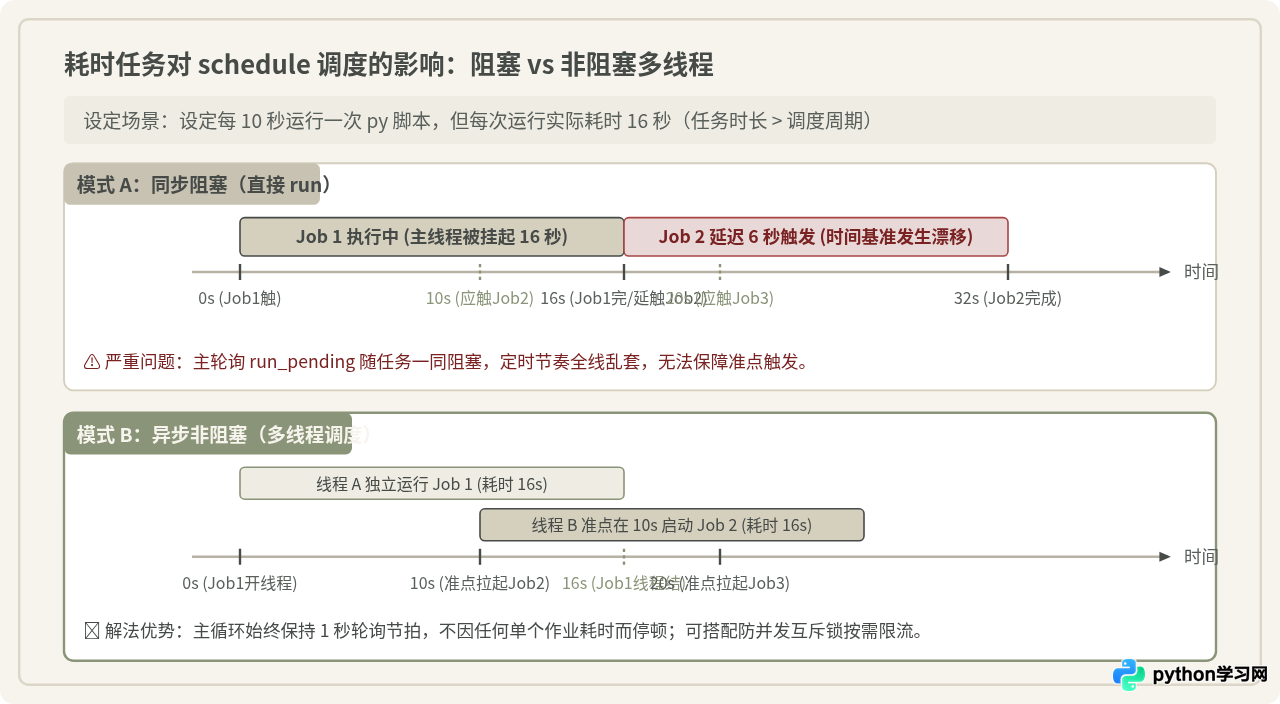
解决方案:结合 threading 实现非阻塞多线程调度
要解决长任务卡顿问题,可以在 schedule 触发时立即拉起一个独立的 Python 工作线程去执行 subprocess.run。这样主轮询线程在发起调用后瞬间返回,继续履行 1 秒一次的 run_pending() 判期逻辑:
import sys
import time
import schedule
import threading
import subprocess
from pathlib import Path

BASE_DIR = Path(__file__).resolve().parent
TARGET_SCRIPT = BASE_DIR / "worker.py"

# 防重复并发锁:防止上一次长任务还没跑完,下一个同名任务就无节制启动
task_lock = threading.Lock()

def _worker_process_runner():
    '''在后台线程中实际运行子进程的封装函数'''
    # 尝试获取锁;如果上一次还在跑,则果断跳过本次,避免服务器负载雪崩
    if not task_lock.acquire(blocking=False):
        print(f"⏳ [Scheduler] 上一轮任务尚未结束,跳过本次触发,防止并发堆叠。")
        return

    try:
        start_ts = time.time()
        print(f"▶️ [Worker Thread] 启动后台子任务: {TARGET_SCRIPT.name}")

        proc = subprocess.run(
            [sys.executable, str(TARGET_SCRIPT)],
            capture_output=True,
            text=True,
            timeout=300
        )

        duration = round(time.time() - start_ts, 2)
        if proc.returncode == 0:
            print(f"✔ [Worker Thread] 任务完成,耗时 {duration} 秒")
        else:
            print(f"❌ [Worker Thread] 任务失败 (退出码: {proc.returncode})\n{proc.stderr.strip()}")

    except subprocess.TimeoutExpired:
        print("⛔ [Worker Thread] 任务执行超时被强行终止!")
    except Exception as ex:
        print(f"❌ [Worker Thread] 运行异常: {ex}")
    finally:
        task_lock.release()

def run_async_job():
    '''调度器统一入口:每次触发直接生成后台子线程'''
    thread = threading.Thread(target=_worker_process_runner, daemon=True)
    thread.start()

# 设定每 10 秒运行一次,即便 worker 耗时 15 秒,也不会卡死主循环
schedule.every(10).seconds.do(run_async_job)

print("🚀 [Scheduler] 多线程非阻塞调度器运行中...")
while True:
    schedule.run_pending()
    time.sleep(1)
开启异步多线程后,务必评估是否允许同一任务多实例并发运行。若目标脚本涉及写同一份数据库、修改相同本地文件或调用限流 API,多个实例同时跑会发生数据覆盖或冲突。代码中通过 task_lock.acquire(blocking=False) 实现“前序未完则自动丢弃本期”,是工程实践中最简单有效的防雪崩机制。
五、常见认知误区与适用场景边界
1. 误区:误以为 schedule 库本身能够脱离 Python 进程常驻后台
这是最容易混淆的理解误区。schedule 只是 Python 应用程序内的一个普通对象和时钟轮询器。当关闭终端窗口、SSH 连接断开或机器重启时,Python 进程随之终止,所有调度也全部消亡。
如果需要服务器级的 7×24 小时持久运行,schedule 必须搭配系统的进程托管工具使用(如 Linux 的 systemd、Supervisor,或容器化 Docker)。
2. 误区:试图使用 schedule 实现硬实时(精确到毫秒)的高精度控制
schedule 属于典型的软调度器(Soft Scheduler)。它的判定周期依赖于 while 循环里的 time.sleep(N),因此触发时间天然存在若干毫秒到一秒以内的抖动。
- 适用场景:每隔几分钟抓取行情、每日清晨生成日报、每小时清理磁盘临时文件、夜间同步备份数据库。
- 不适用场景:工业自动化脉冲采样、金融高频毫秒级套利交易、音视频流硬时间戳同步。
六、生产环境落地与最佳实践全景
要将“schedule 定时运行 py 文件”应用到实际服务器中,可以参考以下四大维度的完整架构图进行检查:
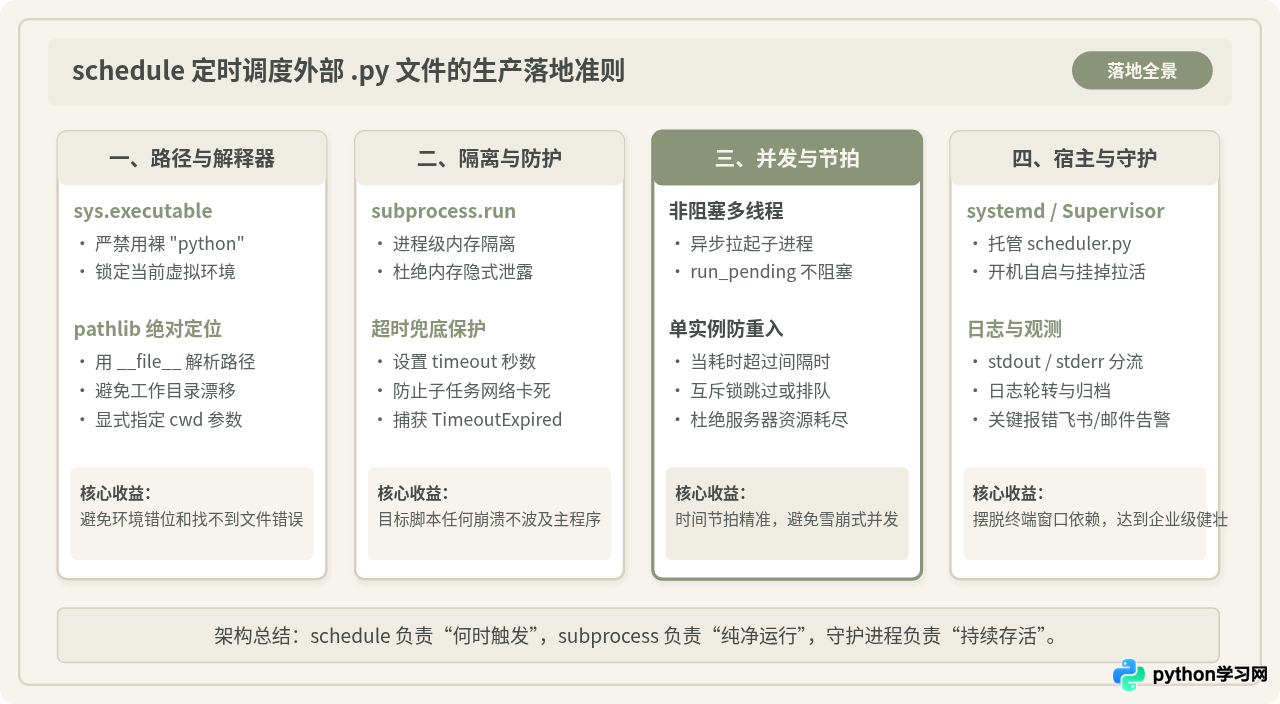
附:Linux 下使用 systemd 守护调度器示例
在 Linux 服务器(如 Ubuntu / CentOS)上,可创建服务单元配置文件 /etc/systemd/system/py-scheduler.service:
[Unit]
Description=Python Schedule Task Runner
After=network.target

[Service]
Type=simple
User=www-data
WorkingDirectory=/var/www/my_project
ExecStart=/var/www/my_project/venv/bin/python scheduler_threaded.py
Restart=always
RestartSec=10
StandardOutput=append:/var/log/my_project/scheduler_stdout.log
StandardError=append:/var/log/my_project/scheduler_stderr.log

[Install]
WantedBy=multi-user.target
配置完成后,在系统终端执行激活命令即可实现开机自启与挂掉自动拉活:
sudo systemctl daemon-reload
sudo systemctl enable --now py-scheduler
sudo systemctl status py-scheduler
七、上线前检查清单
- 环境锁定:已在调度器中使用
sys.executable启动子进程,确保依赖包与虚拟环境一致。 - 路径解析:已使用
Path(__file__).resolve().parent计算绝对文件路径,避免相对工作目录漂移。 - 异常兜底:调度回调函数内部已被
try...except全面包裹,单次脚本抛错不会终止主轮询。 - 超时截断:
subprocess.run已配置合理的timeout参数,杜绝外部网络或死锁导致进程长期悬挂。 - 并发管控:耗时任务已采用多线程异步触发,并结合防重入锁控制并发实例数量。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









