

Python办公自动化与运维脚本开发实战指南

办公自动化与系统运维本质上都在解决同一个问题:把人在图形界面或终端里机械重复的输入输出,转变为依靠程序调度的数据流。使用 Python 落地这两类场景,核心路径是“捕获数据源、规范结构化处理、写入目标载体并接入防御性日志”。本文将系统梳理实现文件批量流转、多源表格合并、操作系统资源监控与安全远程执行的标准方法与完整代码工程。
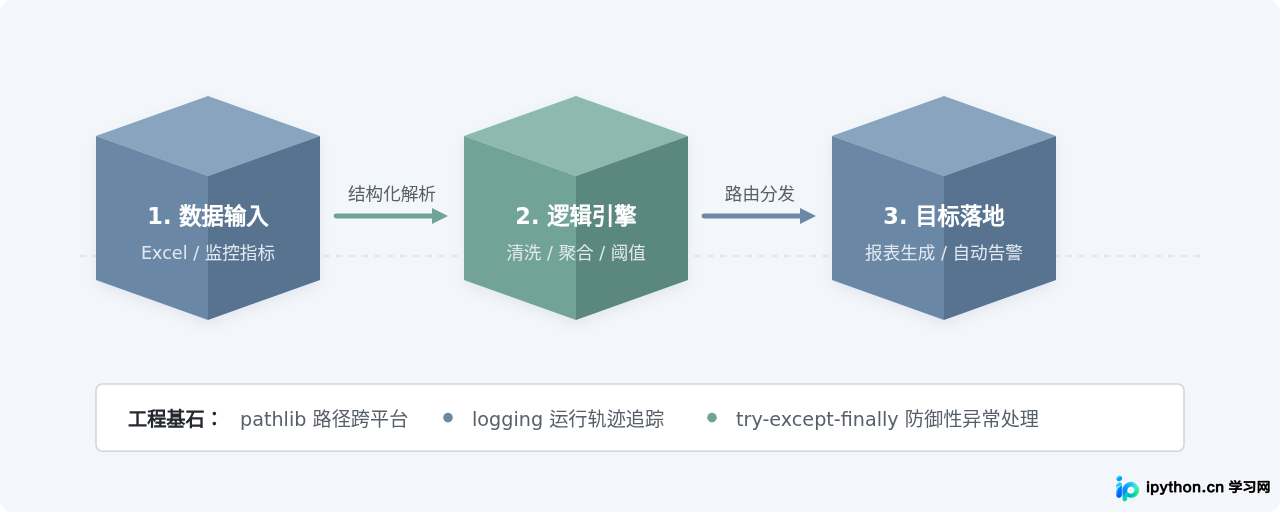
一、为什么这两套场景使用相同的底层范式?
表面上看,制作 Excel 汇总表与检查 Linux 磁盘剩余空间是完全不同的工种;但在脚本层面,两者面对的技术诉求高度一致:
- 弱界面依赖:必须在无图形界面的宿主或后台服务中静默执行,输出依靠文件、数据库或网络通道传递。
- 容错要求高:一个待汇总文件损坏或一台远端主机响应超时,脚本不能直接崩溃退栈,必须跳过故障点并精确记录。
- 跨平台文件路径:无论处理 Windows 共享盘下的财务凭单,还是读取 Linux 下的系统日志,路径格式都需要通用适配。
在设计脚本前,应尽量避开旧式的 os.path 字符串拼接方式,全面改用 Python 3 标准库中的 pathlib.Path 对象。这能直接消除由于 Windows 的反斜杠 \ 与 Linux/macOS 的正斜杠 / 混用造成的路径语法错误。
二、办公自动化核心:多格式文件与多源表格处理
办公场景中最频繁的任务,是把散落在不同文件夹下的结构化数据汇总成一张干净的交付报表。在此类任务中,openpyxl 是主流且依赖项较为轻量的解决方案。如果使用 pandas,在初次部署和跨环境分发时往往会引入庞大的轮子包依赖,而纯文本及原生表格处理通过 openpyxl 便已足够健壮。
实战场景:按月份批量聚合销售报表
假设我们每天都会从各个部门接收到命名格式为 data_部门_日期.xlsx 的明细表,现在需要脚本自动扫描指定目录,过滤出指定月份的所有有效数据行,统一累加并写入新的 Monthly_Summary.xlsx。
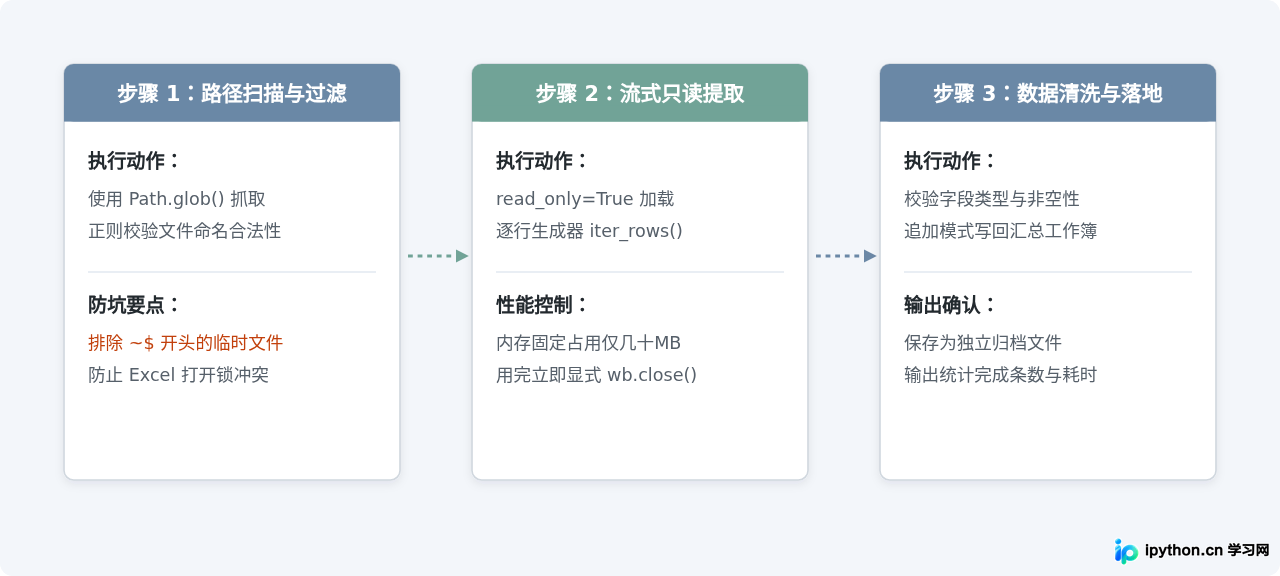
针对上述时序,实现完整业务逻辑的代码如下。此脚本包含了对临时隐藏文件 ~$ 的过滤和流式读取机制:
import logging
from pathlib import Path
from openpyxl import load_workbook, Workbook

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def aggregate_excel_reports(source_folder: str, output_path: str):
    base_dir = Path(source_folder)
    out_file = Path(output_path)

    # 步骤 1:创建汇总工作簿与表头
    summary_wb = Workbook()
    summary_ws = summary_wb.active
    summary_ws.title = "汇总数据"
    summary_ws.append(["部门", "单据编号", "金额", "来源文件"])

    total_rows = 0
    # 步骤 2:遍历目录下所有 .xlsx 文件并规避 Office 临时隐藏文件
    for excel_file in base_dir.glob("*.xlsx"):
        if excel_file.name.startswith("~$"):
            continue

        logging.info(f"正在读取文件: {excel_file.name}")
        wb = None
        try:
            # 采用只读模式加载,大幅降低大文件内存占用
            wb = load_workbook(filename=excel_file, read_only=True, data_only=True)
            ws = wb.active

            # 跳过第一行表头,提取数据行
            for row in ws.iter_rows(min_row=2, values_only=True):
                # 过滤全空行
                if not any(row):
                    continue
                dept, bill_id, amount = row[0], row[1], row[2]
                summary_ws.append([dept, bill_id, amount, excel_file.name])
                total_rows += 1
        except Exception as e:
            logging.error(f"处理文件 {excel_file.name} 时发生异常: {e}")
        finally:
            if wb:
                wb.close()

    # 步骤 3:持久化落地
    summary_wb.save(out_file)
    logging.info(f"汇总完毕,共整合 {total_rows} 条记录,已保存至: {out_file.resolve()}")

if __name__ == "__main__":
aggregate_excel_reports("./reports", "./reports/Monthly_Summary.xlsx")data_only=True 表示只抓取计算后的单元格值,而非 Excel 公式字符串。此外,以 read_only=True 打开的文件在使用完后必须显式调用 wb.close(),否则在 Windows 操作系统中会因文件句柄未释放而无法被删除或移动。
三、运维脚本核心:系统巡检与底层调用
在运维自动化领域,开发脚本的核心任务通常分为两部分:收集主机状态(CPU、内存、磁盘、进程)与可靠调用外部 Shell/系统命令。
1. 为什么不能乱用 os.system?
很多初学者喜欢使用 os.system("command") 执行命令,但这在生产环境运维中极不推荐:
- 它只返回命令的终止状态码(0 表示成功),无法直接捕获标准输出和标准错误。
- 它直接打开系统的 Shell 执行,一旦参数中包含未经检查的用户输入,极易诱发命令注入攻击。
标准且安全的替代方案是使用 subprocess.run,并显式传入列表形式的参数、设置超时时间以及独立捕获流通道。
import subprocess
import logging

def safe_run_command(cmd_list: list, timeout_sec: int = 15) -> str:
    """
    通过 subprocess.run 安全执行系统命令,捕获输出并控制超时
    """
    try:
        # shell=False 阻断绝大部分 shell 注入路径
        result = subprocess.run(
            cmd_list,
            shell=False,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            timeout=timeout_sec,
            check=True
        )
        return result.stdout.strip()
    except subprocess.TimeoutExpired:
        logging.error(f"命令执行超时 (超过 {timeout_sec} 秒): {' '.join(cmd_list)}")
        return ""
    except subprocess.CalledProcessError as e:
        logging.error(f"命令退出码异常 ({e.returncode}): {e.stderr.strip()}")
        return ""
2. 主机状态巡检:psutil 最佳实践
在巡检脚本中,psutil 库能够统一跨平台获取底层资源指标。下面是一个用于生产巡检的核心脚本片段,涵盖指标抓取、阈值判断与格式化报警输出:
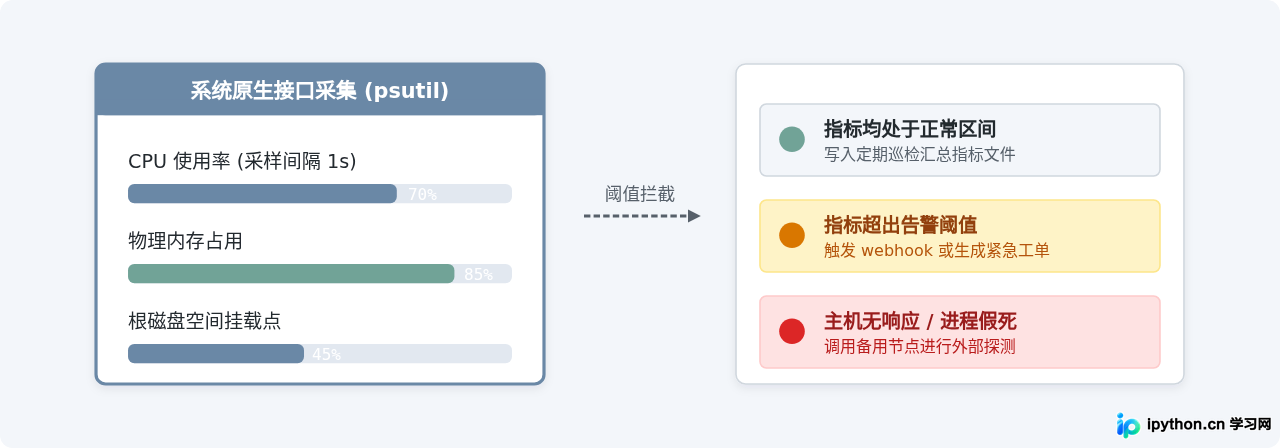
下面是能够独立部署运行的轻量级巡检脚本:
import psutil
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def inspect_server_health(cpu_threshold: float = 80.0, mem_threshold: float = 85.0):
    # 阻塞 1 秒测算 CPU 占用,避免瞬时尖刺误差
    cpu_usage = psutil.cpu_percent(interval=1)

    mem_info = psutil.virtual_memory()
    mem_usage = mem_info.percent

    disk_info = psutil.disk_usage('/')
    disk_usage = disk_info.percent

    logging.info(f"系统当前指标: CPU={cpu_usage}%, 内存={mem_usage}%, 根磁盘={disk_usage}%")

    alerts = []
    if cpu_usage > cpu_threshold:
        alerts.append(f"CPU 使用率过高 (当前: {cpu_usage}%, 阈值: {cpu_threshold}%)")
    if mem_usage > mem_threshold:
        alerts.append(f"内存使用率过高 (当前: {mem_usage}%, 阈值: {mem_threshold}%)")

    if alerts:
        logging.warning("【触发报警】" + " | ".join(alerts))
        # 此处可接入企业微信、飞书或钉钉 Webhook 告警逻辑
    else:
        logging.info("各项资源正常,未超出阈值。")

if __name__ == "__main__":
    inspect_server_health()
四、工程化交付:日志记录、配置解耦与定时调度
一段只能在个人电脑终端里手动 python main.py 运行的代码,并不能称之为自动化或运维系统。要让脚本脱离人工干预且出现问题可溯源,必须建立标准工程骨架。
脚本开发有三个不可妥协的工程习惯:
- 严禁使用
print输出关键信息:必须使用标准库logging,按日期将INFO、WARNING、ERROR分级记录到物理文件中,同时配置日志滚动(RotatingFileHandler),防止日志撑爆磁盘。 - 配置项从代码中抽离:将监控阈值、文件夹路径、邮箱或机器人的 Webhook Token 写入独立文件(例如
config.ini或config.yaml),修改参数无需改动业务逻辑。 - 环境隔离与依赖锁定:在 Linux 服务器或办公用机上统一使用
python -m venv .venv建立虚拟环境,并通过pip freeze > requirements.txt锁定依赖版本。
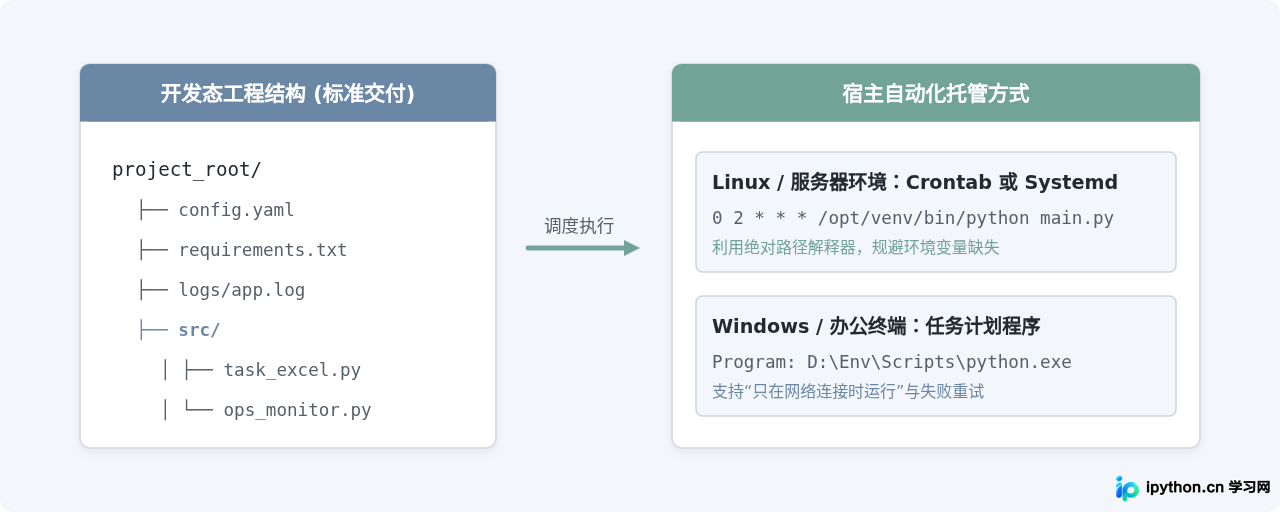
五、常见问题与排错手册
| 常见故障现象 | 根因分析 | 具体解决方法 |
|---|---|---|
| 手动运行正常,Crontab 定时启动报错 No module named ... | 系统定时任务执行时使用的是极简的全局 PATH,未加载用户的环境配置文件,导致未找到虚拟环境下的第三方库。 |
在 Crontab 中强制使用绝对路径指定虚拟环境的解释器,例如:/home/user/project/.venv/bin/python /home/user/project/main.py。 |
| Excel 处理过程偶发 PermissionError: [Errno 13] | 待处理的目标工作簿正处于被人工打开(Excel 软件占用锁),或者上一个读取操作未调用 close()。 |
代码层面引入 try...finally: wb.close();扫描时使用正则排除以 ~$ 开头的隐藏锁文件。 |
| subprocess 命令在终端正常,脚本中假死(Hang 住) | 调用时重定向了 stdout=subprocess.PIPE 但输出内容体积过大,撑满了系统管道缓冲区,导致进程阻塞等待读取。 |
改用 subprocess.run(..., capture_output=True) 或显式指定 timeout,避免无限制卡死。 |
掌握这套“输入规整、核心逻辑纯粹、受限安全调用、带日志退出”的设计范式后,无论是继续扩展 PDF 票据解析、邮件批量自动派发,还是构建分布式主机的统一 SSH 编排,都可以沿用完全相同的工程骨架,以最低的维护成本确保任务静默稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









