

Python subprocess.run() 基础用法:执行命令与捕获输出
在 Python 脚本中调用系统命令或第三方工具时,标准库推荐的主入口是 subprocess.run()。该函数在 Python 3.5 中引入,旨在统一旧版本中繁杂分散的 os.system、os.popen 以及 subprocess.call 等接口。理解 subprocess.run() 的核心在于掌握两点:如何以安全且平台兼容的方式传递命令,以及如何正确捕获并解码命令运行后产生的标准输出(stdout)和错误信息(stderr)。
一、subprocess.run() 基础调用与生命周期
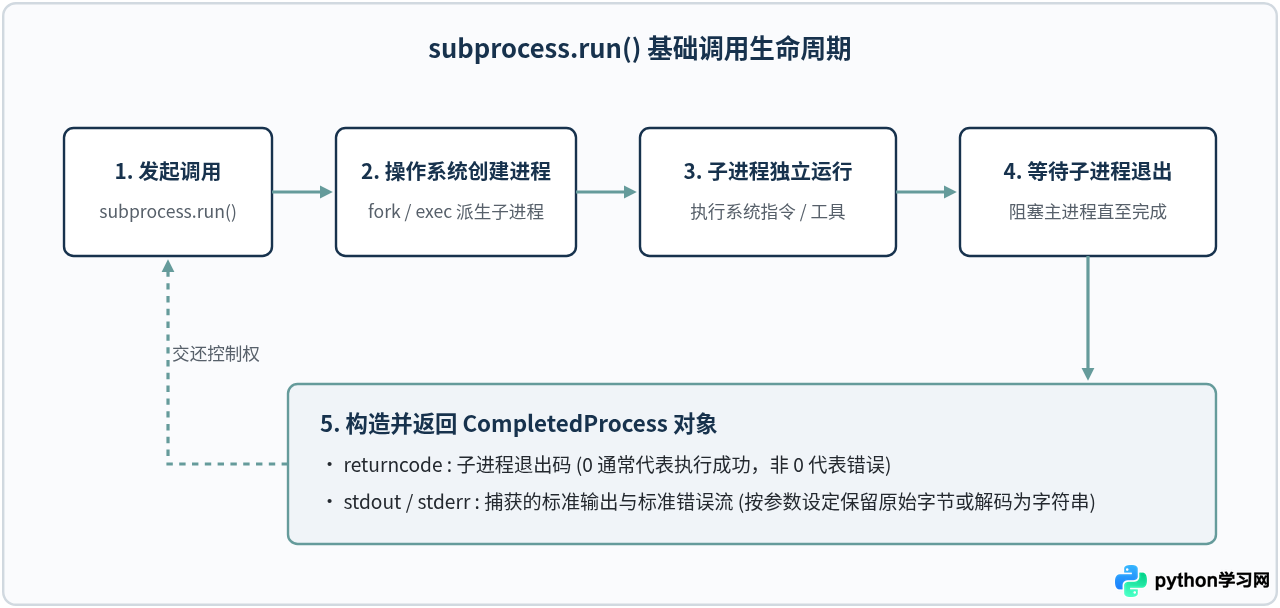
调用 subprocess.run() 时,Python 会创建一个子进程来执行指定程序,等待该子进程运行完毕后,返回一个包含执行结果的 CompletedProcess 实例。其核心签名如下:
subprocess.run(args, *, stdin=None, input=None, stdout=None, stderr=None,
               capture_output=False, shell=False, timeout=None, check=False,
               encoding=None, errors=None, text=None, env=None)
最简单的调用方式是传入一个命令参数列表。例如执行系统查看当前目录文件的命令:
import subprocess

# 在 Linux/macOS 上调用 ls,在 Windows 上可以调用 dir
result = subprocess.run(["ls", "-l"])
print("退出状态码:", result.returncode)
默认情况下,子进程的标准输出和标准错误会直接打印到当前控制台,Python 脚本本身并不保存输出文本,返回的 result.stdout 为 None。整套调用过程的生命周期如下图所示:
二、捕获命令输出:capture_output 与 text 参数
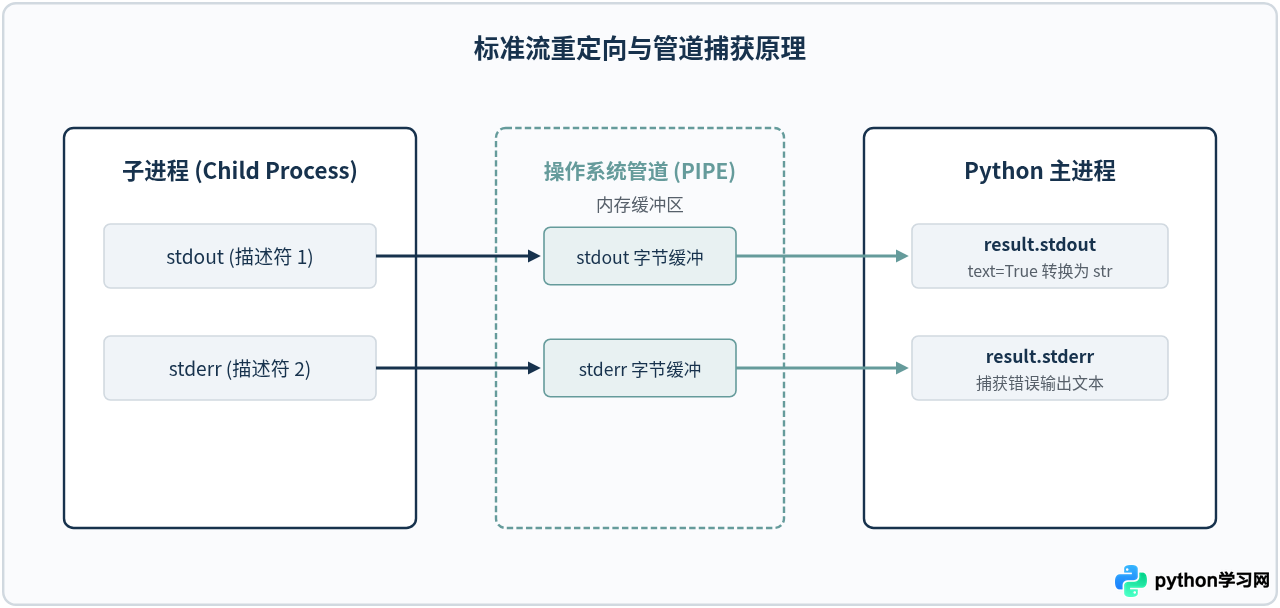
许多自动化场景需要读取命令执行后的输出结果进行解析,例如获取 Git 分支名、读取磁盘占用量等。直接调用命令时输出会直接显示在终端屏幕上,若要将输出保留在变量中,关键是设置 capture_output=True。
1. 捕获字节数据
当仅指定 capture_output=True 时,捕获到的输出为原始字节串(bytes):
import subprocess

res = subprocess.run(["echo", "Hello World"], capture_output=True)
print("标准输出原始字节:", res.stdout)
# 示例输出: 标准输出原始字节: b'Hello World\n'
2. 自动解码为文本字符串(text=True)
处理文本输出时,手动对 stdout.decode() 较为繁琐且容易引发编码异常。推荐同时添加 text=True(早期版本中为 universal_newlines=True)。此时 Python 会依据系统默认字符编码(如 UTF-8)自动将输出流转换为 str 字符串,并将系统换行符统一规范化为 \n:
import subprocess

res = subprocess.run(["echo", "Hello World"], capture_output=True, text=True)
print("输出文本内容:", res.stdout.strip())
# 示例输出: 输出文本内容: Hello World
如果目标命令输出特定编码(例如在 Windows 中文系统下的 gbk),可以直接通过 encoding="gbk" 参数显式指定,避免乱码。
三、状态检查与异常处理:check=True
在默认设置下,即便被调用的外部命令运行失败并返回了非零退出码(如 1 或 127),subprocess.run() 也不会抛出 Python 异常,它会正常返回并将退出码记录在 returncode 属性中。这意味着如果开发者没有显式校验 returncode,脚本可能会带着错误的结果继续向下执行。
为了让错误及时暴露,有两种常见的处理范式:
1. 自动触发异常:check=True
设置 check=True 后,一旦子进程返回码不为 0,就会抛出 subprocess.CalledProcessError 异常。该异常对象会完整包含发生错误的命令、返回码以及捕获到的输出内容:
import subprocess

try:
    # 尝试列出一个不存在的路径
    res = subprocess.run(
        ["ls", "/path/to/nonexistent_dir"],
        capture_output=True,
        text=True,
        check=True
    )
except subprocess.CalledProcessError as e:
    print("命令执行失败!")
    print(f"退出码: {e.returncode}")
    print(f"错误信息: {e.stderr.strip()}")
    print(f"触发命令: {e.cmd}")
2. 手动条件判断
如果外部命令的非零退出码属于可接受的正常分支(例如通过命令返回值做状态检测),则不必抛出异常,可以通过判断 res.returncode == 0 编写业务逻辑。
四、常用参数矩阵与配置对比
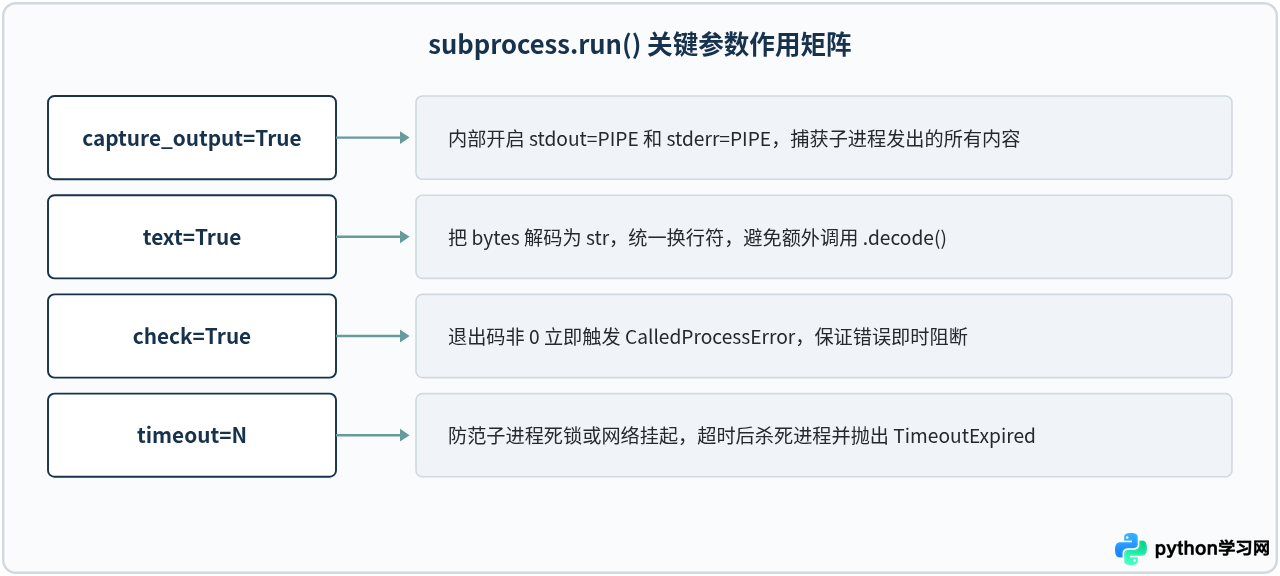
subprocess.run() 提供了丰富的控制参数,下表汇总了日常开发中最核心的配置项及其作用机制:
| 参数名称 | 默认值 | 推荐设置 | 具体功能与行为 |
|---|---|---|---|
args |
无(必填) | 列表格式 ["cmd", "arg1"] |
要执行的命令及参数。避免直接传单条长字符串。 |
capture_output |
False |
True |
设置为 True 时,自动将标准输出与标准错误重定向到内存管道中。 |
text |
False |
True |
将捕获的字节流依据指定编码解码为字符串,并将换行符统一处理。 |
check |
False |
根据场景选择 True |
若退出码非零,自动抛出 CalledProcessError 异常阻止错误扩散。 |
timeout |
None |
秒数(如 10) |
超时截断时间,若子进程运行超时则抛出 TimeoutExpired 异常。 |
shell |
False |
保持 False |
是否通过系统 Shell(如 /bin/sh 或 cmd.exe)解释命令。通常应当禁用。 |
五、常见易错点与安全考量
1. 严禁随意开启 shell=True
许多初学者为了图省事,将命令以整串字符串形式传递并开启 shell=True:
# 不推荐写法:易产生命令注入安全漏洞
user_input = "file.txt; rm -rf /"
subprocess.run(f"cat {user_input}", shell=True)
当 shell=True 时,Python 会启动一个 Shell 进程来执行整条命令。如果命令中拼接了不受信任的用户输入,攻击者可以通过 ;、&& 或 | 注入任意恶意命令。正确的做法是保持 shell=False(默认值),并将命令拆分为列表传递。在列表模式下,参数会直接作为数组传递给底层的系统调用(如 execvp),操作系统绝不会将其解释为 Shell 指令,彻底杜绝注入隐患。
cmd.exe 的内建命令(如 dir、copy、cls)。如果在 Windows 下直接执行 subprocess.run(["dir"]) 会报 FileNotFoundError。此时推荐显式调用 ["cmd", "/c", "dir"],同样无需将 shell=True 暴露给未受控字符串。
2. 合理配置超时时间防止进程挂起
外部命令可能因为等待用户输入、网络阻塞或发生死锁而长时间停滞。在生产级代码中,建议总是显式配置 timeout 参数:
import subprocess

try:
    # 设定 5 秒超时保护
    subprocess.run(["ping", "8.8.8.8"], timeout=5, check=True)
except subprocess.TimeoutExpired:
    print("命令执行超时,子进程已自动终止")
六、调用策略与决策路线总结
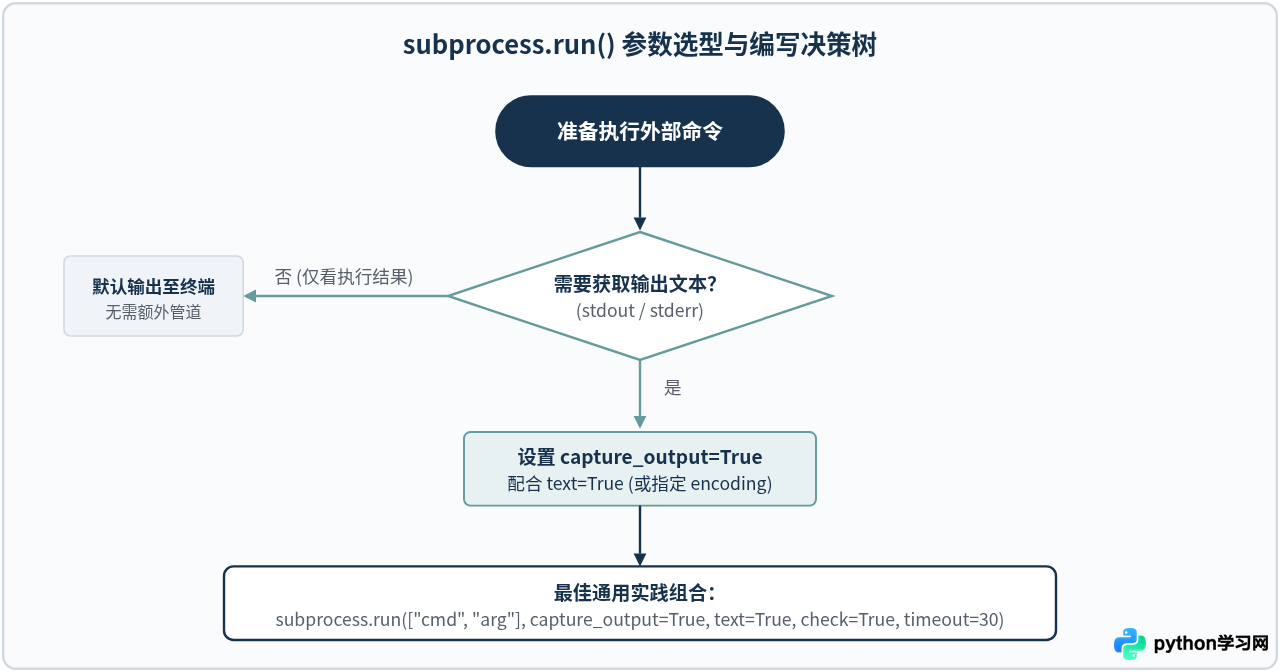
在实际工程中,编写外部命令调用逻辑时,可以依据以下决策树来确定参数配置与异常拦截方案:
七、总结
在 Python 中执行外部命令并捕获输出时,始终优先使用 subprocess.run()。核心准则总结如下:
- 传参格式:使用参数列表(如
["git", "status"])而非拼装字符串,默认关闭shell=False,保障安全性与跨平台可靠性。 - 输出捕获:组合使用
capture_output=True与text=True,直接通过result.stdout与result.stderr获取格式化良好的字符串内容。 - 容错与异常:对依赖执行成功的前提任务启用
check=True,并辅以timeout防止进程长期卡死。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









