

Python将datetime格式化为包含毫秒的字符串
全面讲解Python中将datetime对象格式化为包含3位毫秒字符串的可靠方法,深入分析%f微秒机制、isoformat标准方案、f-string数学截断法及常见时区截断陷阱。
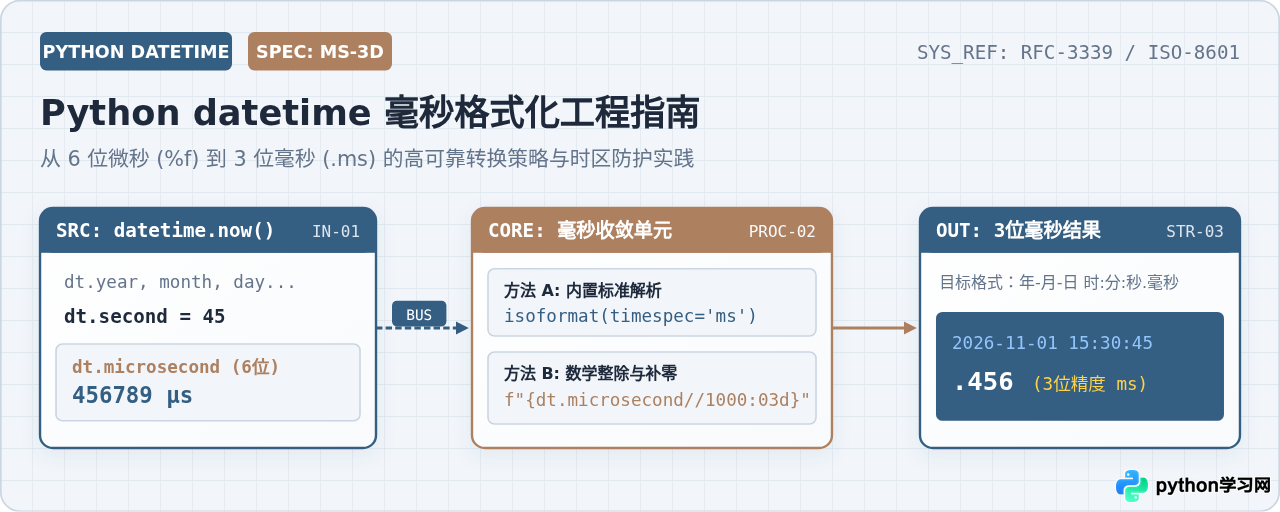
datetime.strftime() 原生仅支持 6 位微秒占位符 %f,并未提供直接输出 3 位毫秒的格式化指令。要将 datetime 格式化为包含 3 位毫秒的字符串,最稳妥、高效的两种做法是:一是使用 Python 3.6+ 内置的 dt.isoformat(sep=' ', timespec='milliseconds');二是使用 f-string 结合整除计算 f"{dt:%Y-%m-%d %H:%M:%S}.{dt.microsecond // 1000:03d}"。
1. 为什么 strftime('%f') 无法直接得到毫秒?
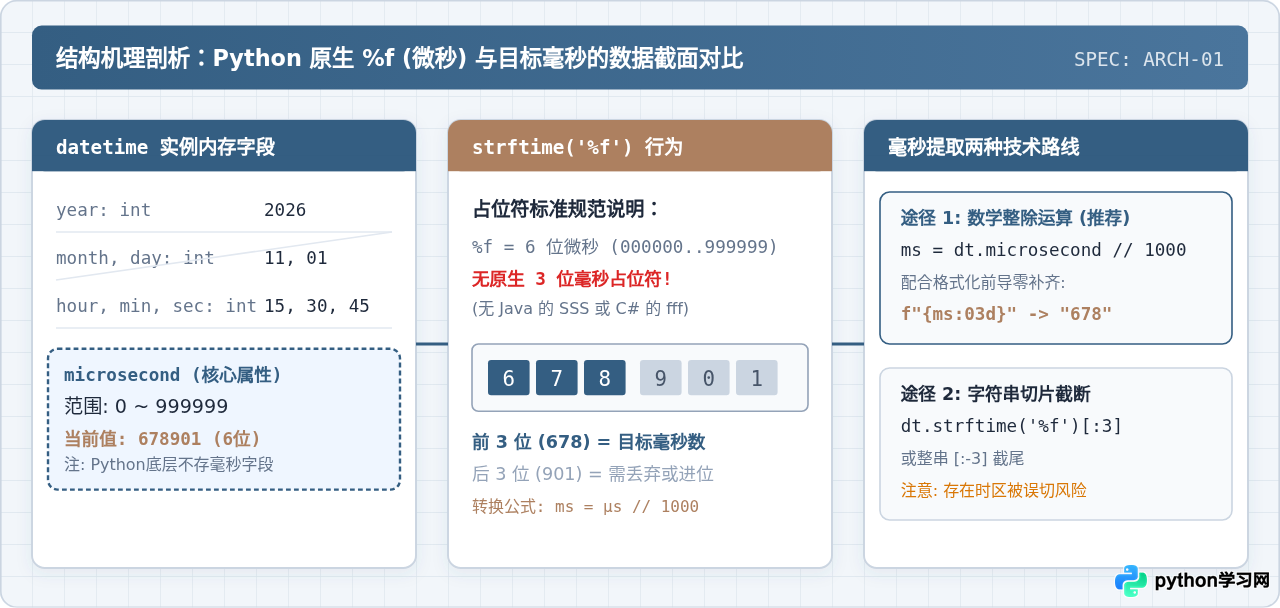
许多有其他编程语言背景(如 Java 的 SSS 或 C# 的 fff)的开发者,在首次使用 Python 格式化时间戳时,常会寻找类似 %L 或 %3f 的毫秒占位符。然而在 Python 标准库的 datetime 模块中,唯一定义的小数秒指令是 %f。
在 datetime 对象的内部数据结构中,时间是以年、月、日、时、分、秒以及微秒(microsecond)形式存储的,其微秒的有效范围为 0 到 999999。%f 严格输出固定的 6 位十进制微秒数字,例如 456789。
因为 1 毫秒(Millisecond)等于 1000 微秒(Microsecond),所以 3 位毫秒本质上就是 6 位微秒的高 3 位数值。Python 既没有在 strftime 中引入截断修饰符,也没有提供专门的毫秒指令。理解了微秒与毫秒的倍数关系,我们就可以通过内置参数、数学计算或切片三种途径来实现目标。
2. 方案一:使用内置 isoformat() 方法(标准推荐)
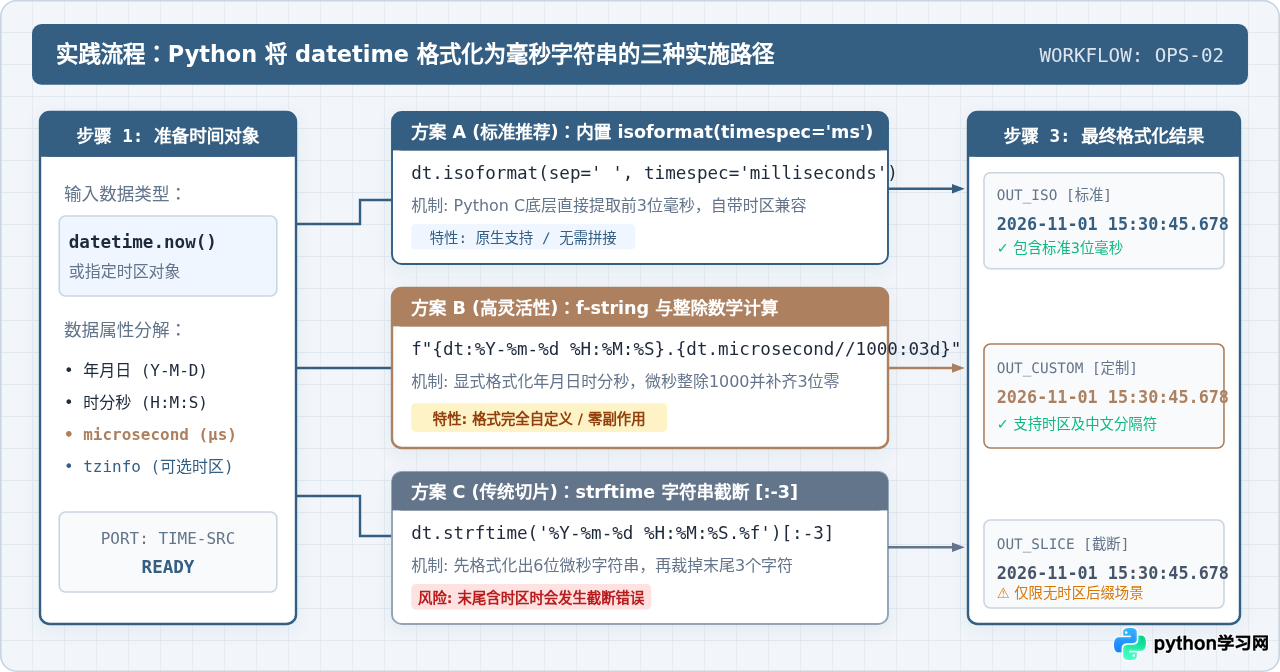
从 Python 3.6 开始,datetime.isoformat() 方法增加了 timespec 参数。该参数允许开发者明确指定时间精度,传入 'milliseconds' 即可直接得到精确到 3 位的毫秒表示,无需任何手动字符串截取或数学运算。
默认情况下,isoformat() 会在日期与时间之间使用字符 'T' 分隔(符合 ISO 8601 规范)。如果业务需要常见的空格分隔符,只需将 sep=' ' 传入即可。
from datetime import datetime

# 获取当前本地时间
now = datetime.now()

# 默认 ISO 8601 格式(使用 T 分隔,保留毫秒)
iso_t = now.isoformat(timespec='milliseconds')

# 使用空格替代 T 分隔符(常见于日志与数据库格式)
iso_space = now.isoformat(sep=' ', timespec='milliseconds')

print("ISO 默认格式:", iso_t)
print("空格分隔格式:", iso_space)
适用性评价:此方法完全由 Python 底层 C 代码驱动,执行速度极快,且原生兼顾时区偏移(例如若存在时区,输出会自动带有 +08:00),是输出符合标准时间戳的首选方案。
3. 方案二:使用 f-string 与整除运算(高度自定义首选)
如果你的目标格式不是标准的 YYYY-MM-DD HH:MM:SS.mmm,例如需要输出中文格式 2026年11月01日 20时25分40秒.456毫秒,或者斜杠分隔符 2026/11/01 20:25:40.456,isoformat() 就无法直接满足要求了。
此时最优的解法是利用 Python 3.6+ 的 f-string 格式化能力,结合 dt.microsecond // 1000 进行整除。需要特别强调的是,整除后的整数必须配合 :03d 格式说明符进行左侧补零,防止毫秒数小于 100 时丢失前导零(例如 5 毫秒应显示为 005,若仅用数字输出会错误变成 5)。
from datetime import datetime

# 构造一个微秒小于 100000 的时间,检验补零效果
sample_dt = datetime(2026, 11, 1, 20, 25, 40, 5067)

# 使用 f-string 直接组合
# {sample_dt:%Y-%m-%d %H:%M:%S} 格式化常规时间部分
# {sample_dt.microsecond // 1000:03d} 格式化3位毫秒,不足3位补0
formatted_str = f"{sample_dt:%Y-%m-%d %H:%M:%S}.{sample_dt.microsecond // 1000:03d}"

# 支持自由定制各类排版需求
custom_format = f"{sample_dt:%Y/%m/%d %H:%M:%S}.{sample_dt.microsecond // 1000:03d}"

print("标准点分毫秒:", formatted_str)
print("斜杠定制格式:", custom_format)
:03d?若微秒是
5067,整除 1000 的结果是整数 5。如果直接写 f"{sample_dt.microsecond // 1000}",输出将变为 .5,导致原本代表 5 毫秒的时间被误读为 500 毫秒。使用 :03d 可以强制将其固定为 3 位并靠右对齐、前导补零,确保时间精度的严谨。
4. 方案三:字符串切片法及其严重安全隐患
在许多早期 Python 代码或网络问答中,常见的做法是先用 strftime('%Y-%m-%d %H:%M:%S.%f') 生成包含 6 位微秒的完整字符串,然后直接使用切片 [:-3] 剔除最后 3 个字符。
from datetime import datetime

dt = datetime(2026, 11, 1, 20, 25, 40, 123456)

# 基础切片法(仅在无时区后缀时成立)
naive_str = dt.strftime('%Y-%m-%d %H:%M:%S.%f')[:-3]
print("无时区切片结果:", naive_str)
时区损坏陷阱(Timezone Truncation Hazard)
切片法看似简短,但在工程生产环境中存在极具隐蔽性的严重陷阱。当时间对象包含时区信息(Timezone-aware),且格式字符串末尾带有 %z(例如 +0800)时,切片 [:-3] 截掉的不是微秒的后 3 位,而是时区字符串的后 3 位!
from datetime import datetime, timezone, timedelta

# 创建一个东八区时间
tz_beijing = timezone(timedelta(hours=8))
aware_dt = datetime(2026, 11, 1, 20, 25, 40, 123456, tzinfo=tz_beijing)

# 错误做法:盲目整体切片 [:-3]
buggy_output = aware_dt.strftime('%Y-%m-%d %H:%M:%S.%f%z')[:-3]

print("完整格式化结果:", aware_dt.strftime('%Y-%m-%d %H:%M:%S.%f%z'))
print("盲目切片损坏结果:", buggy_output)
如上所示,微秒 123456 根本没有被缩减,反而是时区 +0800 被切成了无效的 +0,导致后续解析(例如传递给 Elasticsearch 或第三方 API)时报时间解析语法错误。如果必须使用切片,应当仅对 %f 部分单独做切片,例如 aware_dt.strftime('%f')[:3]。
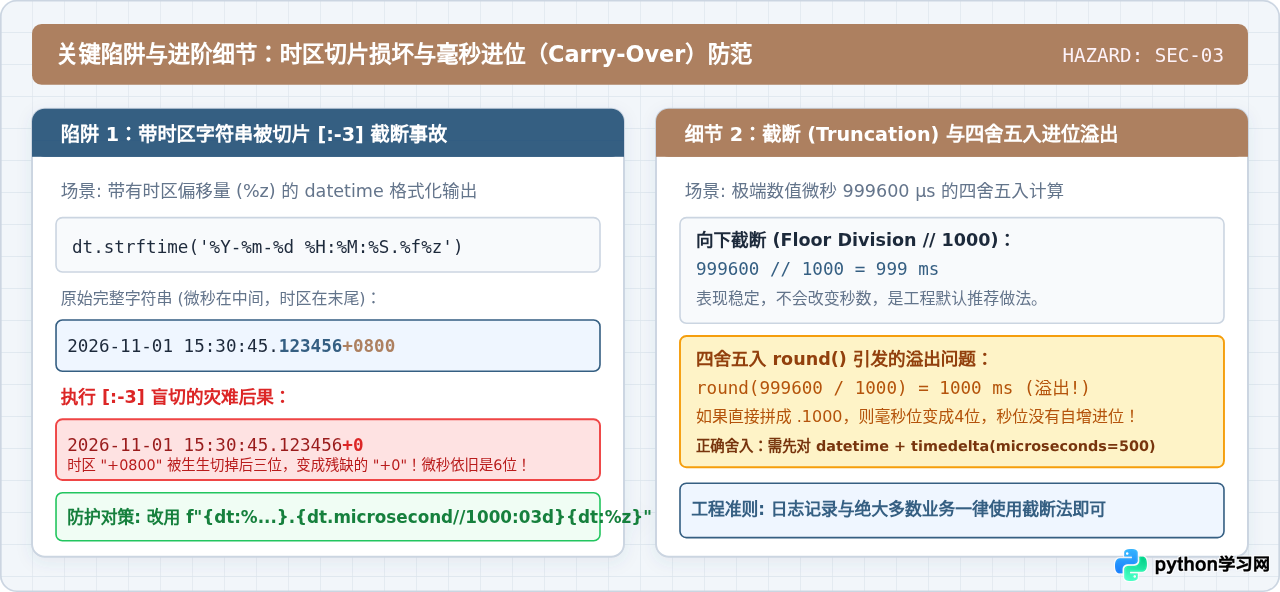
5. 进阶考量:截断 (Floor) 与四舍五入 (Rounding)
在处理时间精度缩减时,存在两种截然不同的数学处理方式:
- 向下截断(Truncation / Floor):直接丢弃微秒后 3 位,对应
microsecond // 1000以及isoformat(timespec='milliseconds')。例如999600 μs变为999 ms。 - 四舍五入(Rounding):根据微秒第 4 位的值决定是否向前进 1。例如
999600 μs会向上舍入。
工程实现中需注意:如果直接使用 round(microsecond / 1000),当微秒超过 999500 时,计算出的毫秒将是 1000。若直接拼进字符串,秒数未进位而毫秒变成了 4 位数(例如 40.1000),这完全破坏了时间格式。
如果业务要求严格的四舍五入舍入行为,最简洁优雅的方法是在格式化之前,先通过 timedelta 为时间对象加上 500 微秒的偏移量,然后再统一执行向下截断:
from datetime import datetime, timedelta

def format_datetime_with_round_ms(dt: datetime) -> str:
    # 加上 500 微秒,使向下截断自然达到四舍五入效果,并自动处理秒与分进位
    rounded_dt = dt + timedelta(microseconds=500)
    return rounded_dt.isoformat(sep=' ', timespec='milliseconds')

# 示例:999600 微秒应向上进位至下一秒
dt_edge = datetime(2026, 11, 1, 20, 25, 40, 999600)
print("原始时间:", dt_edge.strftime('%Y-%m-%d %H:%M:%S.%f'))
print("四舍五入毫秒:", format_datetime_with_round_ms(dt_edge))
工程准则:绝大多数应用(如系统日志记录、数据库落库、订单流水等)都统一采用向下截断,因为它确保了时间戳不会“提前跨入未来的一秒”,并且与 isoformat() 的标准行为保持一致。
6. 方案对比与选型建议
综合以上各方案的特性与工程限制,下表给出了客观的功能对比:
| 实现方案 | 标准代码示例 | 时区安全性 | 格式自定义能力 | 推荐使用场景 |
|---|---|---|---|---|
| isoformat (标准) | dt.isoformat(sep=' ', timespec='milliseconds') |
高(原生保留 ISO 时区) | 中(固定 ISO 结构,支持改分隔符) | Web API 通信、系统日志、标准接口 |
| f-string 数学计算 | f"{dt:%Y-%m-%d %H:%M:%S}.{dt.microsecond//1000:03d}" |
高(可显式拼接 %z) |
极高(完全自由定义任意字符) | 报表输出、中文日期、特定第三方接口 |
| 全局切片 [:-3] | dt.strftime('%Y-%m-%d %H:%M:%S.%f')[:-3] |
低(末尾有时区会被截坏) | 低(格式必须以 %f 结尾) | 仅限确保无时区的遗留代码临时兼容 |
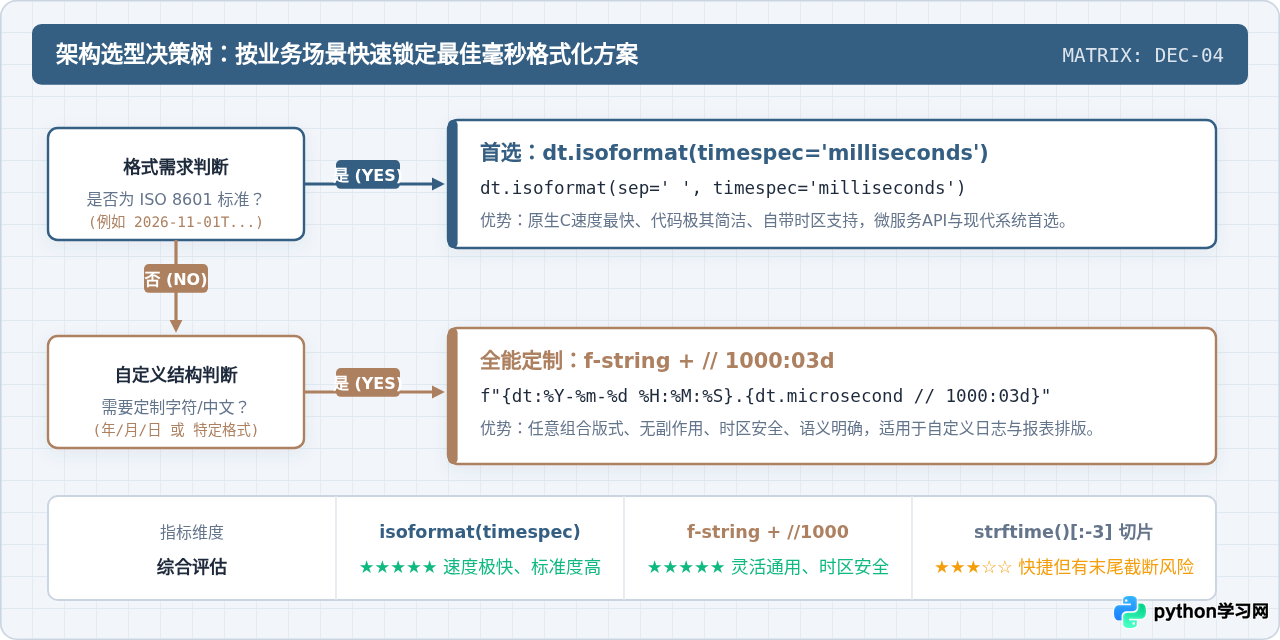
dt.isoformat(sep=' ', timespec='milliseconds'),干净、高性能且不易出错;若需要定制时间文本格式,使用 f"{dt:%Y-%m-%d %H:%M:%S}.{dt.microsecond // 1000:03d}",既直观又完全避免时区截断事故。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









