

Python调用JS文件的三种方式对比:库执行vs Node子进程

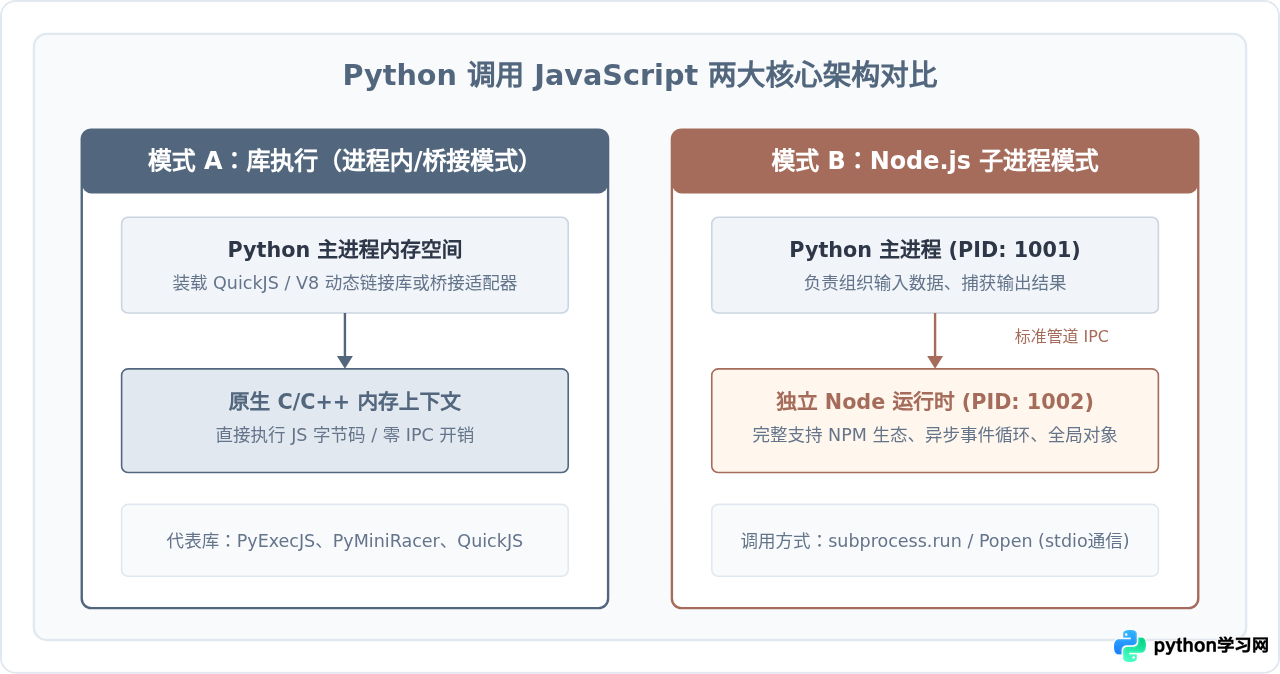
在数据采集、逆向解密以及自动化流程中,核心算法往往以 JavaScript 文件的形式存在。面对复杂的签名生成逻辑与高度混淆代码,直接用 Python 重写算法不仅成本极高,还极易因微小的语法差异引发结果不一致。在工程实践中,最务实的路径是在 Python 宿主程序中直接调用 JS 代码。目前主流的解决方案主要分为两大派系:一类是通过 Python 库直接在进程内部或桥接环境中执行,另一类则是通过操作系统的 Node.js 子进程进行独立调度。本文将对三种最典型的落地方式进行逐一拆解与横向对比,帮助读者在不同业务场景下做出准确选型。
一、方式一:传统桥接库(以 PyExecJS 为代表)
PyExecJS 曾是 Python 生态中最知名的 JS 调用胶水库。它的核心思想并不是在 Python 内部实现解释器,而是通过探测系统已经安装的 JavaScript 引擎(如 Node.js、JScript、SpiderMonkey),自动把 JS 代码组装后写入临时文件,并通过底层命令行调用该引擎获取标准输出。
1. 安装与调用步骤
使用该方案前,需确保宿主系统已全局安装 Node.js,并在 Python 环境中安装对应的驱动包:
# 安装 Python 驱动
pip install PyExecJS
假设我们有一个负责对用户标识进行加密计算的脚本 encrypt.js,内容如下:
// encrypt.js
function calculateToken(userId, salt) {
    var combined = userId + ":" + salt;
    var hash = 0;
    for (var i = 0; i < combined.length; i++) {
        hash = (hash << 5) - hash + combined.charCodeAt(i);
        hash |= 0; // 转换为32位整数
    }
    return "tk_" + Math.abs(hash);
}
在 Python 端通过 execjs 读取并编译该文件:
import execjs

def call_by_execjs():
    with open("encrypt.js", "r", encoding="utf-8") as f:
        js_code = f.read()

    # 编译 JS 上下文
    ctx = execjs.compile(js_code)

    # 调用函数并传参
    result = ctx.call("calculateToken", "user_9527", "secret_key_888")
    print(f"[PyExecJS 输出] 运算结果: {result}")

if __name__ == "__main__":
    call_by_execjs()
2. 优缺点与实际边界
PyExecJS 的优势在于 API 设计极为平易近人,调用 compile() 与 call() 两个方法就能完成基本运算。但它的缺陷同样明显:
- 维护停滞:该项目早在数年前已宣布归档,不再适配现代 Python 和新型 Node 特性。
- 虚假的对象持久化:由于其底层依赖创建临时文件和标准流重定向,每次调用
call()实际上都会重新启动一次子进程,带来显著的高并发瓶颈。 - 编码隐患:在 Windows 平台上,其默认基于系统 GBK 编码进行文本重定向,极易发生 Unicode 乱码或解析崩溃。
二、方式二:现代进程内嵌入引擎(以 PyMiniRacer / QuickJS 为代表)
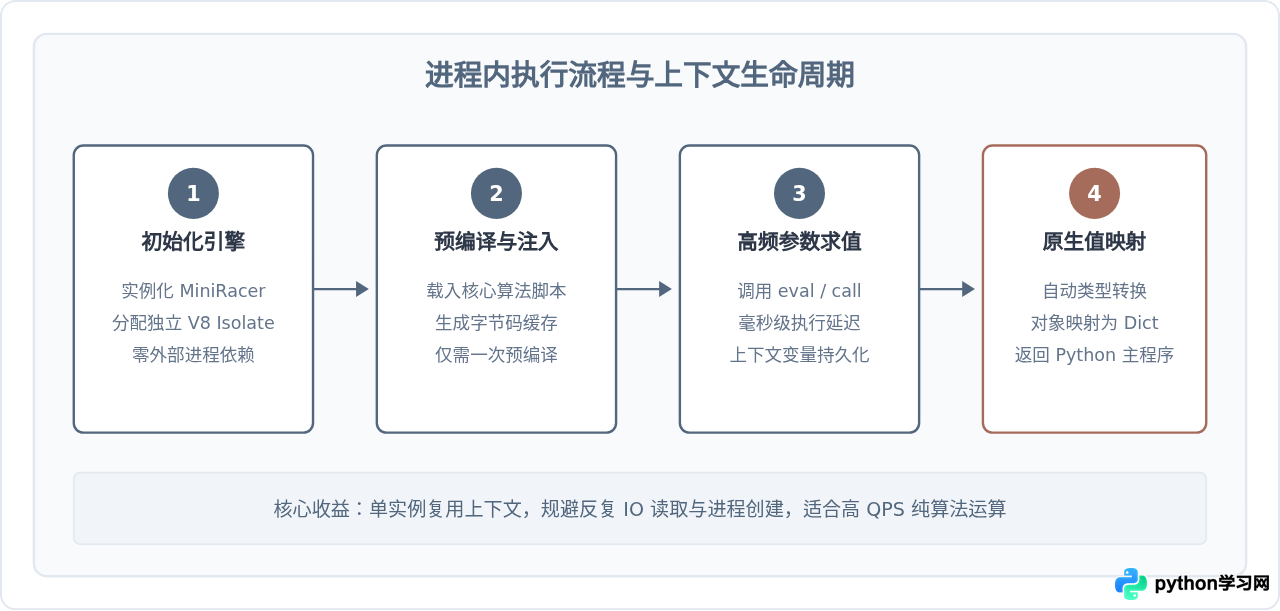
针对传统桥接方案性能低下的问题,进程内嵌入引擎应运而生。这类库(例如基于 Google V8 的 py_mini_racer 或基于 Fabrice Bellard 经典工作的 quickjs)通过 C/C++ 扩展直接将轻量引擎嵌入 Python 进程内。脚本执行在同一个操作系统进程地址空间完成,完全消除了进程频繁启停的系统调用成本。
1. 安装与调用步骤
以 py_mini_racer 为例,该库提供预编译的二进制轮子包,直接安装即可使用:
pip install py_mini_racer调用示例演示了如何复用执行上下文并进行高频调用:
from py_mini_racer import MiniRacer

def call_by_miniracer():
    # 实例化内嵌 V8 引擎
    ctx = MiniRacer()

    # 载入 JS 基础文件
    with open("encrypt.js", "r", encoding="utf-8") as f:
        ctx.eval(f.read())

    # 模拟批量高频调用
    test_cases = [("user_101", "salt_a"), ("user_102", "salt_b"), ("user_103", "salt_c")]
    for user_id, salt in test_cases:
        # 直接在已存上下文内调用函数
        call_expr = f'calculateToken("{user_id}", "{salt}")'
        res = ctx.eval(call_expr)
        print(f"[PyMiniRacer 输出] {user_id} => {res}")

if __name__ == "__main__":
    call_by_miniracer()
2. 优缺点与实际边界
内嵌引擎的执行速度极快,单次调用耗时通常在微秒至毫秒级别,非常适合嵌入 Web 接口提供高并发解密服务。然而其限制在于缺乏浏览器或 Node.js 的全局宿主对象:
- 标准纯 JS 语法(ES6+、JSON、Math、RegExp)支持完备;
- 不包含 Node.js 原生模块(如
fs、path、crypto、Buffer); - 不包含 浏览器环境对象(如
window、document、navigator、location)。如果目标脚本高度依赖补环境,需要手动在前端定义大量 Mock 变量。
三、方式三:Node.js 子进程调度(subprocess 通信)
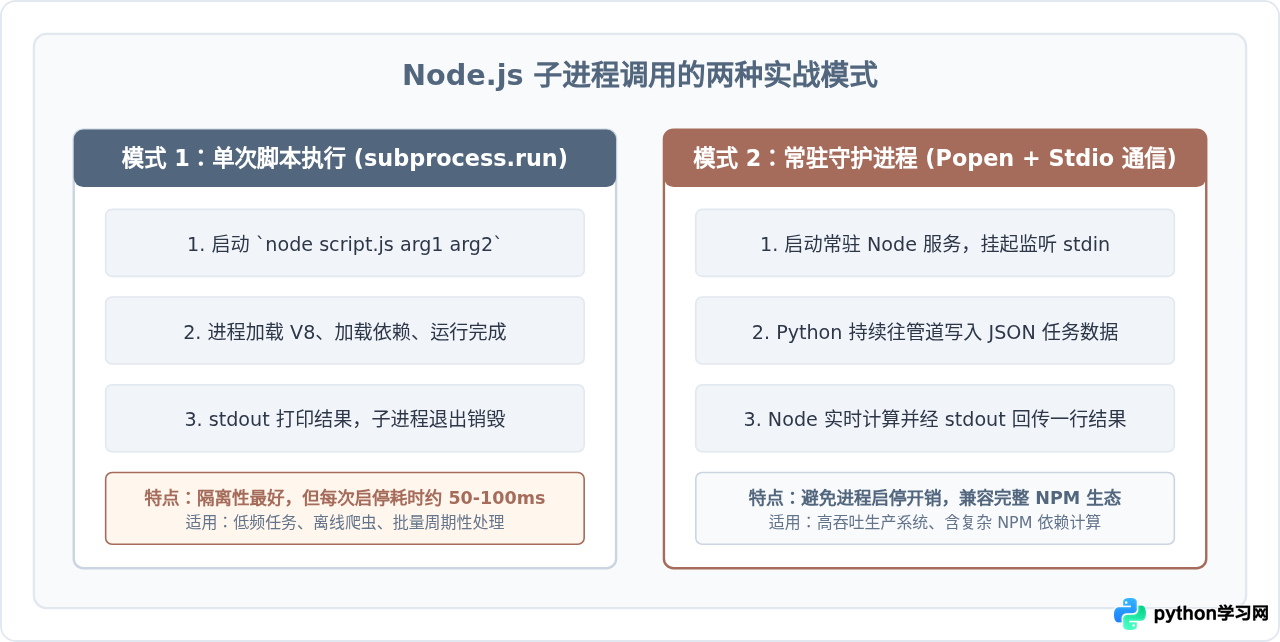
当目标 JS 脚本极其复杂、引入了大量的 NPM 第三方依赖,或者利用 Webpack 深度打包且难以剥离 Node 环境时,最稳健的做法是直接交由原生的 Node.js 环境去执行。Python 通过内置的 subprocess 模块启动独立子进程,二者通过标准输入输出(stdin / stdout)进行数据交互。
1. 编写适配的 JS 入口脚本
为了让 Node.js 接收命令行参数并返回标准化结果,我们编写一个包装脚本 node_runner.js:
// node_runner.js
const fs = require('fs');

function calculateToken(userId, salt) {
    var combined = userId + ":" + salt;
    var hash = 0;
    for (var i = 0; i < combined.length; i++) {
        hash = (hash << 5) - hash + combined.charCodeAt(i);
        hash |= 0;
    }
    return "tk_" + Math.abs(hash);
}

// 从命令行接收参数
const args = process.argv.slice(2);
const userId = args[0] || "guest";
const salt = args[1] || "default_salt";

const output = {
    code: 0,
    result: calculateToken(userId, salt),
    timestamp: Date.now()
};

// 格式化输出 JSON 字符串至标准输出
console.log(JSON.stringify(output));
2. Python subprocess 调用实战
在 Python 端,使用 subprocess.run 捕获标准输出并反序列化 JSON:
import subprocess
import json

def call_by_node_subprocess(user_id, salt):
    cmd = ["node", "node_runner.js", user_id, salt]

    # 显式声明 text=True 和 utf-8 编码,防止跨平台输出乱码
    process = subprocess.run(
        cmd,
        capture_output=True,
        text=True,
        encoding="utf-8",
        timeout=10 # 关键:必须设置超时,防范死循环
    )

    if process.returncode != 0:
        raise RuntimeError(f"Node 执行失败: {process.stderr}")

    response = json.loads(process.stdout.strip())
    print(f"[Node 子进程输出] 结果: {response['result']}, 时间戳: {response['timestamp']}")
    return response['result']

if __name__ == "__main__":
call_by_node_subprocess("user_9527", "secret_key_888")subprocess 时务必设置 timeout。某些混淆 JS 代码内部若包含反调试的死循环或定时器,若未设置超时限制,Python 主线程将发生永久挂起。
四、三类方案多维度横向对比
为了给架构选型提供直观的数据参照,下表从执行延迟、依赖成本、生态支持及并发安全性等关键指标进行综合评定:
| 对比维度 | 传统桥接 (PyExecJS) | 进程内引擎 (PyMiniRacer) | Node.js 子进程 (subprocess) |
|---|---|---|---|
| 底层执行机制 | 临时生成文件 + 调用本地环境 | 动态链接 V8 / QuickJS 进程内解释 | 操作系统级跨进程 IPC 管道调用 |
| 单次平均调用延迟 | 50ms - 150ms(每次均重建上下文) | < 1ms(上下文常驻,直接内存求值) | 单次:40-80ms;管道常驻:1-3ms |
| 环境依赖成本 | 宿主需安装 Node.js 或系统引擎 | 仅需 pip 安装二进制 wheel,无外部依赖 | 宿主必须预装 Node.js 运行时 |
| NPM 生态与原生模块 | 受限(传参与环境组装困难) | 完全不支持(无 fs、Buffer、crypto) | 原生完全支持(无任何兼容限制) |
| 补环境友好度 | 一般(难以捕获深层原型链) | 需手动注入 window / document 对象 | 极佳(可引入 jsdom 等成熟库) |
| 内存占用表现 | 进程频繁回收,总体起伏大 | 共享主进程内存,可控轻量 | 独立 Node 进程,每个占 30-50MB+ |
| 项目维护现状 | 已停止维护,不推荐新项目使用 | 活跃更新,适配最新 Python / V8 | 随官方 Node.js 长期演进 |
五、工程选型决策路径
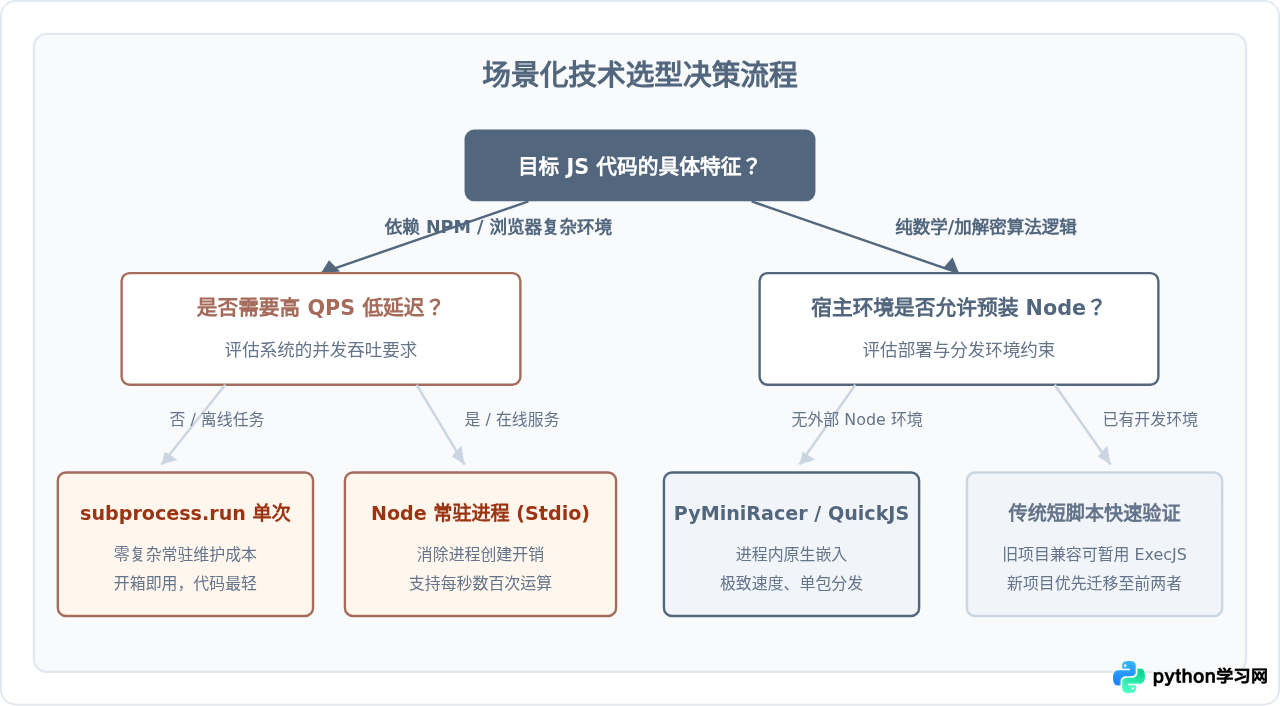
在面对具体的项目需求时,不应盲目追求单项指标的极致,而应综合权衡开发时间成本与运行效率。以下决策图为日常开发提供了清晰的判断路径:
六、总结与落地建议
归结起来,Python 桥接 JavaScript 并非单选题,而是取决于具体的业务侧重点:
- 优先拥抱 Node.js 子进程:在绝大多数实际逆向与工程项目中,解密脚本往往深度嵌套第三方库。除非有极其苛刻的性能指标要求,优先使用
subprocess配合node能够省去绝大多数补环境的心智负担。 - 高频纯计算选用进程内引擎:如果需要将算法打包进独立的 Python SDK,或者在 Web API 中面临每秒成千上万次的高频调用,且算法已剥离全局环境依赖,
py_mini_racer是目前兼顾执行效率与稳定性的最佳选择。 - 谨慎使用归档项目:针对历史存量的
PyExecJS代码,新项目建议逐步完成重构迁移,防范跨平台编码陷阱与进程泄漏问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









