

Python新手必学的10个常用库:从Requests到Pandas
针对Python初学者梳理的10个高频核心第三方库,涵盖网络抓取、数据分析与计算、办公自动化、图像处理与工程测试,帮助新手快速构建实用的开发能力。
掌握了 Python 的变量、循环、函数与基础语法后,写出真正解决实际问题程序的关键,在于熟练运用 Python 丰富的第三方库生态。初学者面对数以万计的开源项目,往往容易陷入不知道学什么、先学什么的迷茫。本文系统梳理了 10 个在实际开发、数据分析与日常自动化中最常使用的基础第三方库,涵盖网络通信、数据处理、自动化报表、图像处理与工程测试五个维度,帮助新手建立清晰的技术选型认知。
一、准备工作:新手如何规范管理与安装第三方库
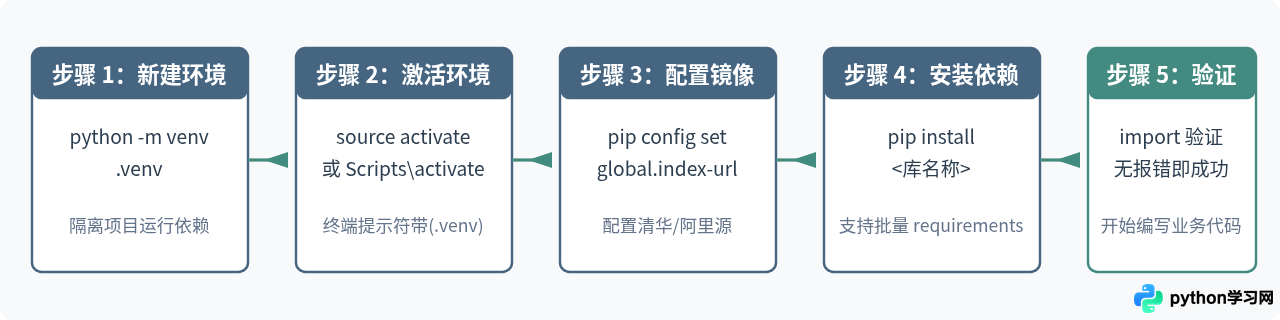
在开始安装和使用任何第三方库之前,建议养成使用独立虚拟环境的习惯。这样可以避免不同项目之间的依赖版本产生冲突,也能保持系统级 Python 环境的干净整洁。
通常的标准流程包括:创建专属项目目录、初始化独立虚拟环境、激活环境,随后使用官方包管理器 pip 进行安装。在国内网络环境下,可以配置稳定的镜像源以提升下载速度。
二、网络通信与数据获取篇
互联网是现代程序获取数据的重要来源。无论是与外部微服务 API 交互,还是采集公开网页信息,下面两个库是几乎每个开发者的首选组合。
1. Requests:人性化的 HTTP 请求库
在 Python 内置的 urllib 中,处理身份验证、Cookies、重定向和编码往往需要编写冗长的配置代码。Requests 库将复杂的网络请求抽象成了极具可读性的 Python 接口,支持 GET、POST、PUT、DELETE 等常用 HTTP 方法。
import requests

url = "https://api.github.com/events"
try:
    response = requests.get(url, timeout=5)
    # 状态码非 200 会抛出 HTTPError 异常
    response.raise_for_status()
    # 自动完成 JSON 反序列化
    data = response.json()
    print("成功获取事件数量:", len(data))
except requests.RequestException as e:
print("网络请求失败:", e)新手提醒:发起网络请求时,务必显式传入 timeout 参数。若省略超时时间,在网络阻塞或服务端挂起时,程序可能会陷入无限等待。
2. Beautiful Soup 4 (bs4):优雅的 HTML/XML 解析工具
当通过 Requests 获取到原始网页的 HTML 字符串后,需要从中提取具体的文字、图片地址或超链接。BeautifulSoup 能将杂乱的 HTML 文本构建为树状对象,提供简单直观的查找方法。
from bs4 import BeautifulSoup

html_doc = """
<div class="content">
  <h2>文章标题</h2>
  <p class="author">发布者:张三</p>
  <ul>
    <li><a href="/post/1">第一章节</a></li>
    <li><a href="/post/2">第二章节</a></li>
  </ul>
</div>
"""

soup = BeautifulSoup(html_doc, "html.parser")
title = soup.find("h2").text
links = [a["href"] for a in soup.select("ul li a")]
print("提取标题:", title)
print("提取链接:", links)新手提醒:安装命令为 pip install beautifulsoup4。代码导入时使用 from bs4 import BeautifulSoup。如果需要解析大型或结构残缺的页面,建议额外安装 lxml 解析器以提升解析速度。
三、科学计算与数据分析“全家桶”篇
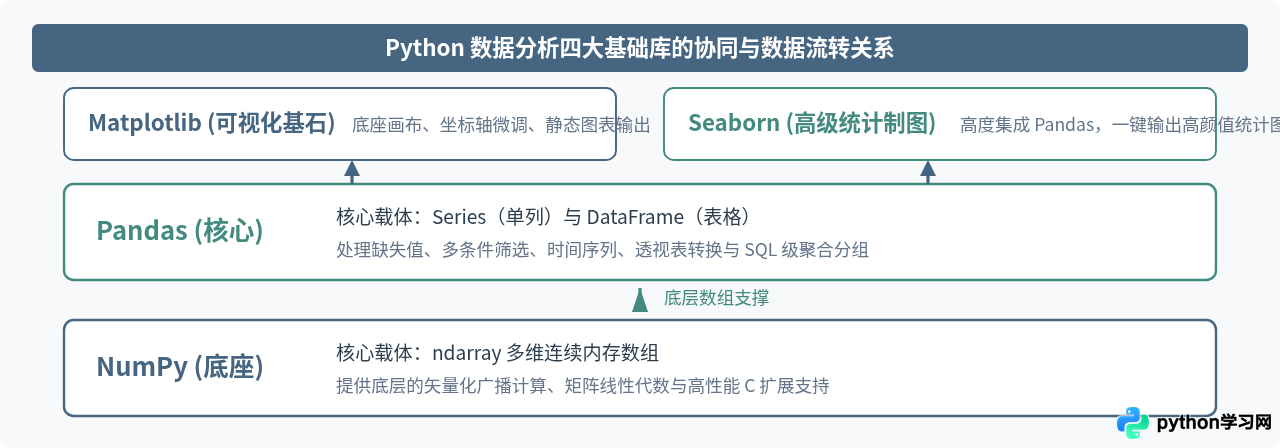
Python 在数据科学、机器学习和商业分析领域的绝对优势,离不开以 NumPy 和 Pandas 为代表的基础设施。它们与可视化库紧密交织,构成了完整的数据处理管线。
3. NumPy:高性能科学计算与数组底座
Python 原生列表(list)由于存储的是对象指针,在处理海量数值时遍历效率较低。NumPy 引入了连续内存的 ndarray 数据结构,通过 C 语言编写的底层实现,让整列、整矩阵的运算能够实现毫秒级“矢量化操作”。
import numpy as np

# 创建连续数值数组
arr = np.array([10, 20, 30, 40, 50])
# 矢量化运算:无需写 for 循环,所有元素同时乘以 1.05
arr_adjusted = arr * 1.05

print("均值:", np.mean(arr_adjusted))
print("标准差:", np.std(arr_adjusted))
NumPy 是几乎所有数据科学与机器学习库的底层依赖。掌握 NumPy 的切片、维度变换(reshape)与广播机制(Broadcasting),是后续深入学习的前提。
4. Pandas:结构化数据清洗与表格分析核心
如果说 NumPy 解决了纯数字的矩阵计算,Pandas 则解决了现代商业中最常见的二维表格数据分析需求。无论是从 Excel、CSV、SQL 数据库还是 JSON 文件中读取数据,Pandas 都能以 DataFrame 的形式加载并完成行列清洗、分组求和与透视转换。
import pandas as pd

# 创建示例表格
data = {
    "部门": ["技术部", "市场部", "技术部", "运营部", "市场部"],
    "员工": ["小王", "小李", "小张", "小赵", "小刘"],
    "绩效评分": [88, 92, 95, 78, 85]
}
df = pd.DataFrame(data)

# 分组求平均绩效,并按评分从高到低排序
summary = df.groupby("部门")["绩效评分"].mean().reset_index()
summary = summary.sort_values(by="绩效评分", ascending=False)
print(summary)新手提醒:避免使用 for index, row in df.iterrows() 去逐行修改表格。Pandas 的列运算(如 df["新列"] = df["A"] + df["B"])采用了底层优化,性能通常比循环高出数十倍甚至数百倍。
5. Matplotlib:自由度极高的数据可视化基石
Matplotlib 是 Python 图表绘制的常青树。无论需要绘制折线图、柱状图、直方图还是散点图,通过它的面向对象接口(fig, ax = plt.subplots()),开发者可以精确控制画布上的每一根线条、坐标轴刻度与图例说明。
import matplotlib.pyplot as plt

months = ["1月", "2月", "3月", "4月"]
sales = [120, 150, 180, 210]

fig, ax = plt.subplots(figsize=(6, 4))
ax.plot(months, sales, marker="o", color="#456581", linewidth=2)
ax.set_title("季度销售额趋势")
ax.set_ylabel("金额 (万元)")
ax.grid(True, linestyle="--", alpha=0.6)
# plt.show() 或保存为本地图片
fig.savefig("sales_trend.png", dpi=150)新手提醒:Matplotlib 默认英文字体可能无法显示中文字符(表现为方块或警告)。需在代码开头指定系统支持的中文字体,例如:plt.rcParams['font.sans-serif'] = ['SimHei', 'PingFang SC']。
6. Seaborn:优雅美观的统计可视化利器
尽管 Matplotlib 控制力极强,但调整出符合专业美学标准的图表往往需要编写繁琐的代码。Seaborn 基于 Matplotlib 封装,原生适配 Pandas DataFrame,只需一行代码即可生成带有统计置信区间、多维度着色与密度估计的高阶图表。
import seaborn as sns
import matplotlib.pyplot as plt

# 假设已有包含员工评分与工龄的 DataFrame: df
# sns.boxplot(x="部门", y="绩效评分", data=df, palette="crest")
# plt.title("各部门绩效分布箱线图")
# plt.show()
Seaborn 极其适合用于探索性数据分析(EDA),常见图表包括热力图(heatmap)、成对关系图(pairplot)和分类箱线图(boxplot)。
四、日常办公与实用自动化篇
许多新手学习 Python 的初衷是提升日常办公效率,将繁重重复的表格整理和图片批量转换交给脚本自动完成。
7. OpenPyXL:打通 Excel 表格的读写通道
虽然 Pandas 能快速导出 Excel,但如果任务需要读取现有 .xlsx 模板、保留单元格样式、追加多工作表或写入 Excel 原生公式,OpenPyXL 便是最直接、轻量且无需在机器上安装 Office 软件的解决方案。
import openpyxl

wb = openpyxl.Workbook()
ws = wb.active
ws.title = "销售汇总"

# 写入表头与数据
ws.append(["产品名称", "单价", "数量", "销售总额"])
ws.append(["键盘", 199, 5, "=B2*C2"])
ws.append(["鼠标", 79, 10, "=B3*C3"])

# 保存工作簿
wb.save("自动化销售报表.xlsx")适用场景:月度财务报表批量拆分、多个分支机构数据自动汇总回填、带格式的自动化周报生成。
8. Pillow (PIL):轻量易用的图像处理工具箱
Pillow 是经典图像库 PIL 的现代活跃分支。它提供直观的 API,能够完成图片尺寸压缩、批量裁剪、旋转、滤镜应用以及添加文字水印等常见任务。
from PIL import Image, ImageOps

with Image.open("photo.jpg") as img:
    # 等比例缩放为最大边 800px 的缩略图
    img.thumbnail((800, 800))
    # 自动校正手机拍摄时的 EXIF 旋转方向
    img_corrected = ImageOps.exif_transpose(img)
    # 保存为压缩后的 web 格式
img_corrected.save("thumbnail.webp", "WEBP", quality=85)新手提醒:安装命令使用 pip install Pillow,而在 Python 脚本中引入的模块名始终是首字母大写的 from PIL import Image。
五、工程规范与开发体验篇
编写能跑通的代码只是第一步。当脚本逻辑日渐复杂时,通过自动化测试确保逻辑正确,并借助友好的控制台输出排查问题,是新手迈向专业开发的关键转变。
9. Pytest:简洁可靠的现代化测试框架
与内置较为繁琐的 unittest 相比,Pytest 无需继承任何基类,只需使用标准的 Python assert 关键字即可完成丰富的断言判断。配合参数化测试,可以用极少的代码覆盖大量边界情况。
# test_calc.py
def calculate_discount(price, rate):
    if rate < 0 or rate > 1:
        raise ValueError("折扣率必须在 0 到 1 之间")
    return round(price * rate, 2)

def test_normal_discount():
    assert calculate_discount(100, 0.8) == 80.0

def test_zero_discount():
    assert calculate_discount(100, 0.0) == 0.0
在项目根目录命令行直接运行 pytest,工具会自动发现所有以 test_*.py 命名的文件并执行测试,输出直观的成功与失败回溯报告。
10. Rich:终端富文本与控制台可视化利器
长期面对黑白沉闷的 print() 打印容易导致调试信息混乱。Rich 可以让终端输出彩色的文字、整齐的表格、JSON 高亮以及平滑的动态进度条,极大提升脚本的交互质感。
from rich.console import Console
from rich.table import Table

console = Console()
table = Table(title="系统任务运行状态")

table.add_column("任务ID", style="cyan")
table.add_column("任务名称", style="magenta")
table.add_column("状态", style="green")

table.add_row("T-101", "数据抓取", "已完成")
table.add_row("T-102", "报表生成", "运行中")

console.print(table)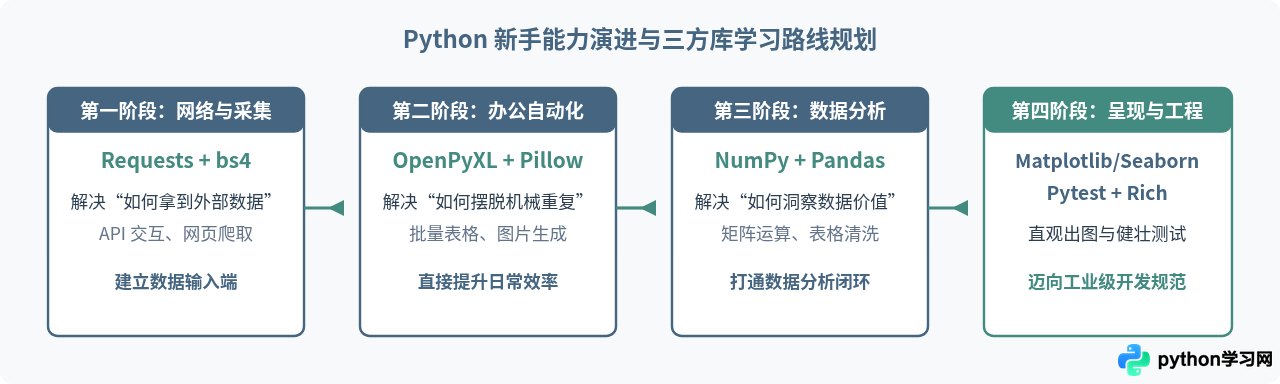
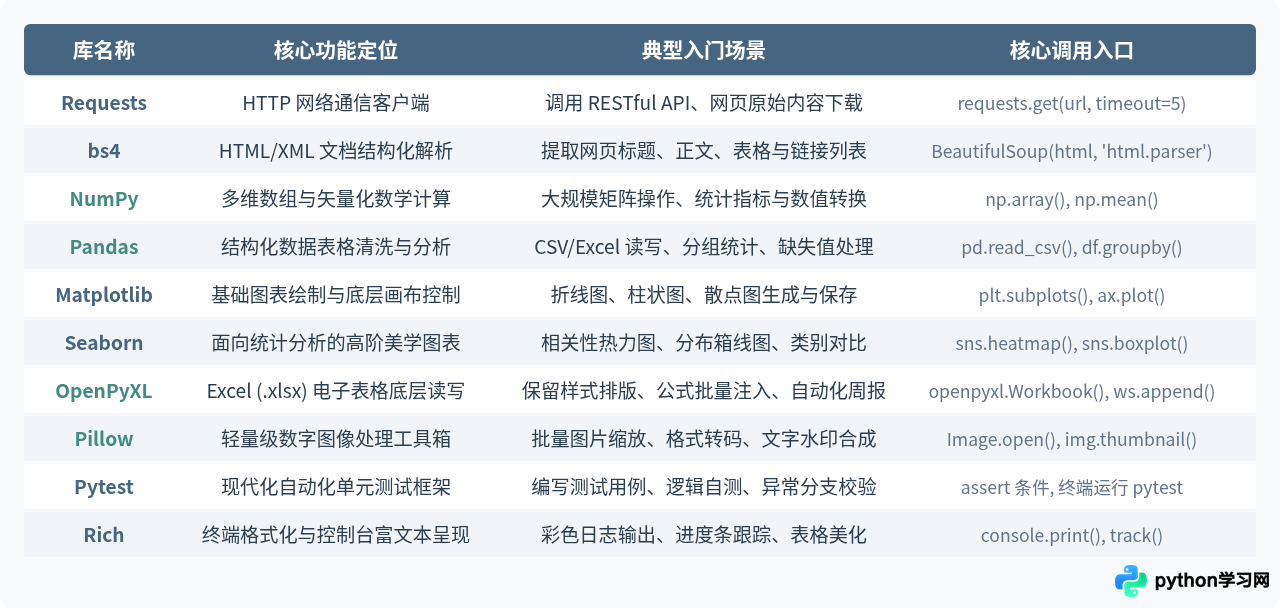
六、10大常用库核心选型与场景速查
为了帮助读者在遇到具体业务问题时能够快速定位所需工具,下表将本文介绍的 10 个库的定位、核心场景与常用调用方法做出了系统汇总:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









