

Python装饰器工作原理及实战案例讲解
深入解析Python装饰器的工作原理,从一等公民函数、闭包作用域到@语法糖底层等价机制,并结合性能监控、数据缓存与鉴权等工程实战案例,提供完整的代码实现与避坑指南。
一、语法糖本质与底层装配机制
在日常开发中,我们通常使用 @decorator 语法直接标注在函数定义的上一行。这一语法符号被称为“语法糖”(Syntactic Sugar),它本身不包含任何特殊的魔法,而是 Python 编译器在语法分析阶段提供的一种等价简写形式。
当 Python 解释器在模块中解析到被 @decorator 修饰的函数时,会按照以下规则进行等价转换:
# 语法糖写法
@my_decorator
def calculate(a, b):
    return a + b

# 解释器底层的等价操作
def calculate(a, b):
    return a + b
calculate = my_decorator(calculate)
从这一等价赋值式中,可以得出两个关键结论:
- 装配发生于模块加载期,而非函数调用期:
my_decorator(calculate)这次函数调用在函数定义完成的瞬间就已经执行完毕。如果装饰器函数的外层包含执行语句(例如输出日志或建立连接),即使后续从未调用过calculate(),这些外层语句也会立即执行。 - 符号名发生了重绑定:原函数名
calculate已经不再指向原有的函数对象,而是被重新赋值为my_decorator的返回值(通常是一个内层包装函数wrapper)。后续所有对calculate(x, y)的调用,本质上都是在调用该包装函数。
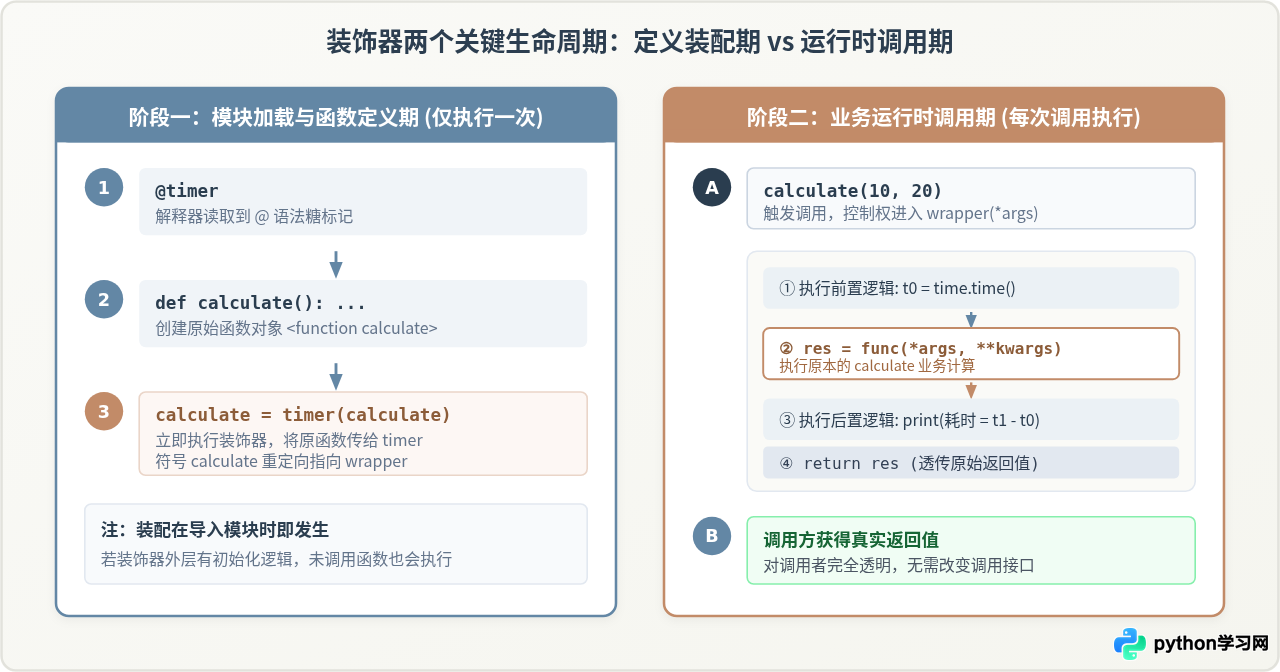
理解这两个阶段的边界,是避免在装饰器中写出隐藏 Bug 的基础。例如,绝不能把每次调用都需要重新计算的动态状态(如当前请求时间戳)写在装饰器的外层函数中,否则该状态只会在模块导入时初始化一次,导致所有调用共享同一个过时时间戳。
二、支撑基石:头等函数与闭包作用域
装饰器之所以能在 Python 中优雅实现,根本原因在于 Python 的函数具备头等公民(First-Class Citizen)特性:函数可以作为参数传递给其他函数、作为其他函数的返回值返回,并能够赋值给普通变量。
当一个外部函数返回了一个内部嵌套函数,且该内部函数引用了外部函数作用域中的变量时,就构成了闭包(Closure)。在装饰器中,被装饰的原始函数 func 恰好就是外部装饰器函数的局部形参:
def time_master(func):
    def wrapper(*args, **kwargs):
        # wrapper 内部引用了外部函数的局部变量 func
        result = func(*args, **kwargs)
        return result
    return wrapper
按照通常的变量作用域规则,外部函数 time_master 执行结束返回后,其内部栈帧应当被销毁。但在闭包机制下,Python 运行时会为被内层函数捕获的自由变量创建专门的 cell 对象,并将其存放在 wrapper.__closure__ 元组中。
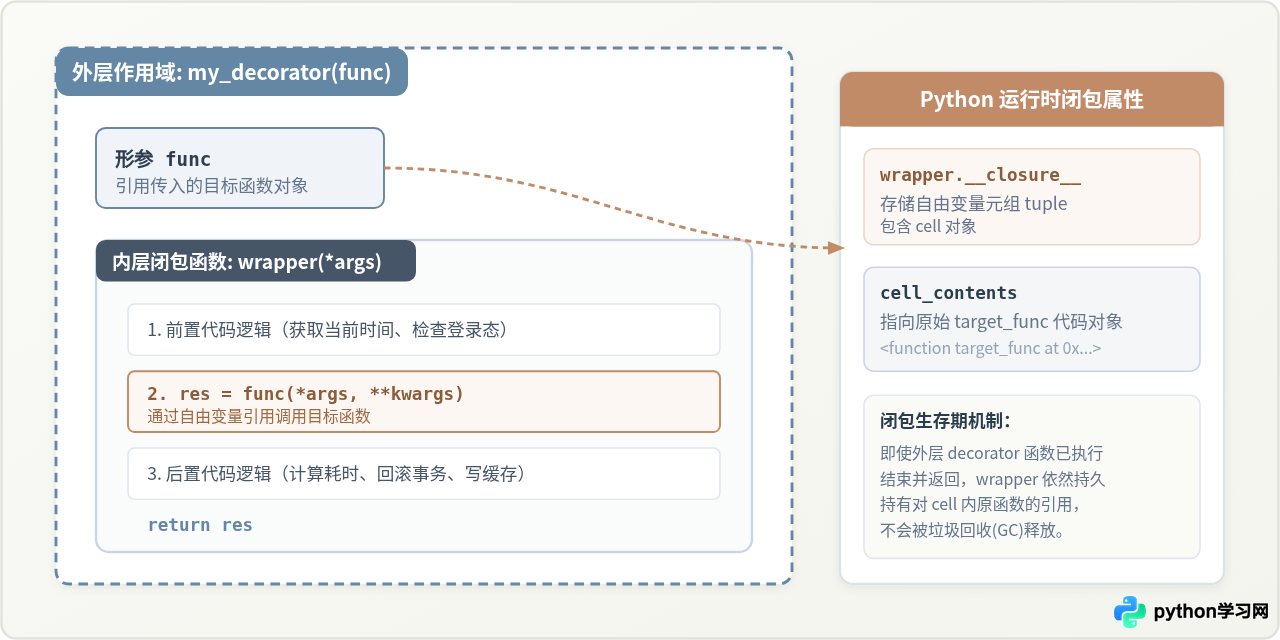
通过检查函数的内部属性,可以清晰地观察到闭包对原始函数的持久持有:
@time_master
def get_user_name():
    return "Alice"

# 检查当前 get_user_name 实际指向的包装函数及其闭包内容
print(get_user_name.__closure__)
# 输出示例: (<cell at 0x...: function object at 0x...>,)
print(get_user_name.__closure__[0].cell_contents)
# 输出结果直接指向原始的 get_user_name 函数对象
这种机制确保了即使外部装饰器函数早已退出,包装函数在未来的任意调用时刻,都能准确找到并执行保存在闭包内的原业务逻辑。
三、元信息丢失与 functools.wraps 的必要性
由于符号发生了重绑定,未经处理的装饰器会导致函数的元信息发生“身份漂移”。在没有特殊保护的情况下,调用原函数的 __name__、__doc__ 以及类型注解时,获取到的将是内层 wrapper 的信息。
# 未使用 functools.wraps 的情况
def bad_decorator(func):
    def wrapper(*args, **kwargs):
        '''包装层帮助文档'''
        return func(*args, **kwargs)
    return wrapper

@bad_decorator
def query_order(order_id: int) -> dict:
    '''根据订单号查询订单详细信息'''
    return {"id": order_id, "status": "success"}

print(query_order.__name__)  # 输出: wrapper(原函数名丢失)
print(query_order.__doc__)   # 输出: 包装层帮助文档(原docstring丢失)
这种元信息丢失在大型工程中会引发严重连锁反应:基于函数名路由的 Web 框架(如 Flask 视图注册)、自动化 API 文档生成工具(如 Swagger/Sphinx)、以及代码调试栈追踪都会受到干扰。
标准库提供的 functools.wraps 专门用于解决该问题。它本身也是一个装饰器,通过在包装函数定义前添加 @wraps(func),可以自动将原始函数的 __name__、__doc__、__module__、__annotations__ 等关键属性逐一复制到 wrapper 对象上,并保留指向底层的 __wrapped__ 属性。
import functools

def robust_decorator(func):
    @functools.wraps(func)  # 关键修复步骤
    def wrapper(*args, **kwargs):
        '''包装层内部逻辑'''
        return func(*args, **kwargs)
    return wrapper

@robust_decorator
def query_order(order_id: int) -> dict:
    '''根据订单号查询订单详细信息'''
    return {"id": order_id, "status": "success"}

print(query_order.__name__)  # 正确输出: query_order
print(query_order.__doc__)   # 正确输出: 根据订单号查询订单详细信息
print(query_order.__wrapped__) # 可直接访问未被装饰的原始函数对象@functools.wraps(func)。
四、进阶模式:带参数装饰器与多层堆叠
1. 带参数装饰器的三层闭包结构
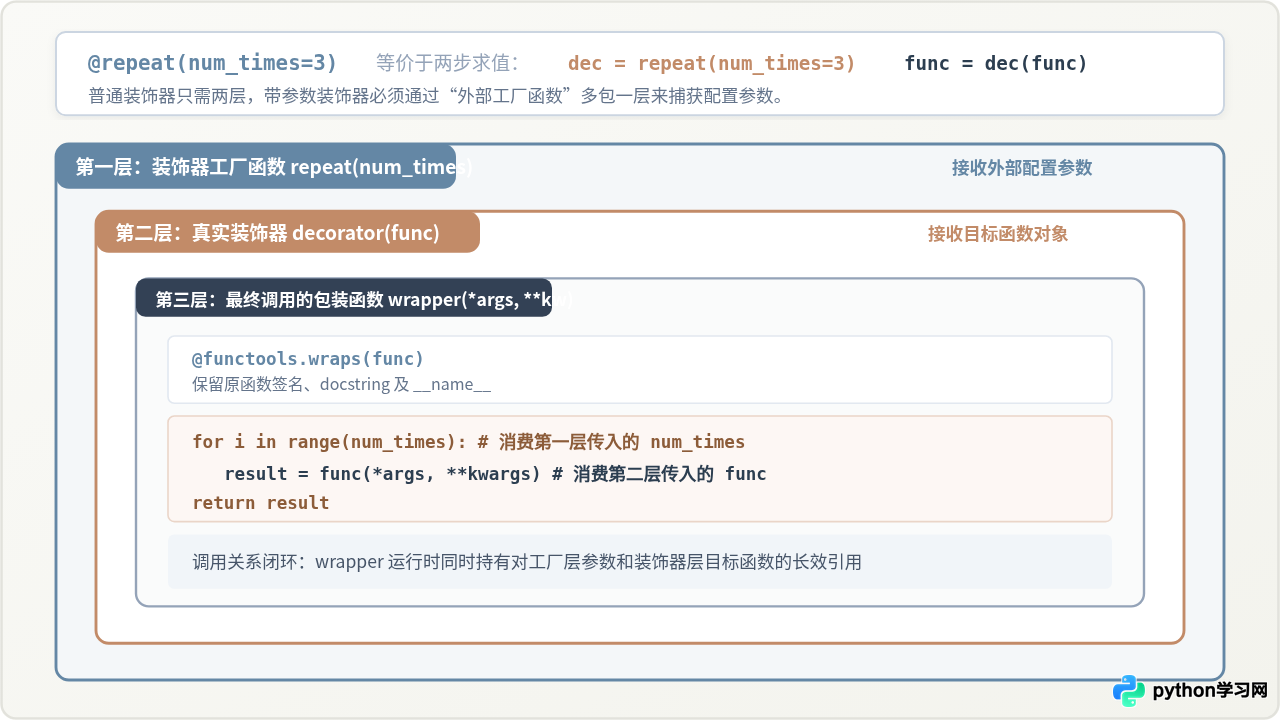
很多时候我们需要根据不同的运行环境调整装饰器的行为,例如指定重试次数、超时阈值或日志级别。形如 @retry(max_attempts=3) 的语法需要接收额外参数。
这种语法在底层同样是两步转换:先执行 retry(max_attempts=3),该调用必须返回一个“接收原函数作为参数的真正装饰器”,再由这个返回物完成对原函数的装配。因此,带参数装饰器必然需要三层嵌套结构:
import functools
import time

def retry(max_attempts: int = 3, delay_seconds: float = 0.5):
    """第一层:装饰器工厂函数,负责接收并捕获配置参数"""
    def decorator(func):
        """第二层:真正的装饰器,负责接收目标函数"""
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            """第三层:实际调用的包装函数,负责执行重试逻辑"""
            attempts = 0
            while attempts < max_attempts:
                try:
                    return func(*args, **kwargs)
                except Exception as err:
                    attempts += 1
                    if attempts >= max_attempts:
                        raise err
                    time.sleep(delay_seconds)
        return wrapper
    return decorator
2. 多个装饰器的堆叠执行规则
当一个函数同时被多个装饰器修饰时,理解其装配顺序与执行顺序至关重要:
@dec_a
@dec_b
@dec_c
def target_action():
    pass
该语法糖在 Python 解释器中的展开顺序为:
target_action = dec_a(dec_b(dec_c(target_action)))由此可见:
- 装配期(自底向上):距离原函数最近的
dec_c最先执行并完成第一次封装,随后是dec_b封装dec_c的结果,最后是dec_a封装最外层。 - 调用期(自顶向下):业务代码调用
target_action()时,最外层的dec_a前置逻辑最先触发;当dec_a内部调用func()时进入dec_b,以此类推直至执行真正的业务代码,随后后置逻辑按相反顺序逐层返回。这一执行模型与常见的“洋葱模型”(Onion Architecture)完全一致。
五、类装饰器与状态维护
除了使用函数闭包,Python 的类也可以作为装饰器使用。只要一个类实现了 __call__ 魔法方法,其实例就可以像普通函数一样被调用。
当装饰逻辑需要维护复杂的内部状态(例如统计调用次数、实现滑动窗口限流、或者管理缓存连接池)时,使用类装饰器往往比多层嵌套闭包具有更清晰的代码组织:
import functools

class CallCounter:
    def __init__(self, func):
        self.func = func
        self.count = 0
        functools.update_wrapper(self, func)

    def __call__(self, *args, **kwargs):
        self.count += 1
        print(f"[调用监控] 函数 {self.func.__name__} 已被累计调用 {self.count} 次")
        return self.func(*args, **kwargs)

@CallCounter
def process_task(task_name: str):
    return f"任务 {task_name} 处理完毕"

process_task("订单对账")  # 输出累计调用 1 次
process_task("发送邮件")  # 输出累计调用 2 次
print(f"最终统计值: {process_task.count}") # 直接访问装饰器实例状态self 到宿主类的实例上,直接使用上述结构会导致 self 错位。若需要装饰类实例方法,类装饰器必须额外实现描述符协议中的 __get__ 方法。
六、实战案例精讲
案例一:接口执行耗时监控与慢请求告警
在后端服务中,对核心计算或外部 I/O 接口进行执行时间度量是基础运维需求。本案例实现一个带阈值告警的高精度计时装饰器,当执行时间超过设定阈值时打印告警信息:
import time
import functools
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def monitor_latency(threshold_ms: float = 100.0):
    """
    性能度量装饰器
    :param threshold_ms: 耗时告警阈值(毫秒),超过则记录 WARNING
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            start_time = time.perf_counter()
            try:
                result = func(*args, **kwargs)
                return result
            finally:
                cost_ms = (time.perf_counter() - start_time) * 1000
                msg = f"函数 {func.__name__} 耗时: {cost_ms:.2f}ms"
                if cost_ms > threshold_ms:
                    logging.warning(f"[慢操作告警] {msg} (超过阈值 {threshold_ms}ms)")
                else:
                    logging.info(msg)
        return wrapper
    return decorator

# 使用示例
@monitor_latency(threshold_ms=50.0)
def sync_inventory_data():
    time.sleep(0.08)  # 模拟耗时 80ms 的外部调用
    return {"updated": 120}

sync_inventory_data()
案例二:函数结果哈希内存缓存器
对于无副作用的纯计算函数(相同输入必定产生相同输出),缓存计算结果可以显著提升性能。虽然标准库有 functools.lru_cache,但理解其手写实现有助于掌握装饰器内部的状态共享:
import functools

def memoize(func):
    """基于字典的函数结果缓存装饰器"""
    cache = {}

    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        # 将入参转换为可哈希的键元组
        kwargs_tuple = tuple(sorted(kwargs.items()))
        cache_key = (args, kwargs_tuple)

        if cache_key in cache:
            return cache[cache_key]

        # 缓存未命中时执行计算
        result = func(*args, **kwargs)
        cache[cache_key] = result
        return result

    # 暴露清空缓存的接口
    wrapper.clear_cache = lambda: cache.clear()
    return wrapper

# 使用示例:计算斐波那契数列
@memoize
def fibonacci(n: int) -> int:
    if n < 2:
        return n
    return fibonacci(n - 1) + fibonacci(n - 2)

print(fibonacci(35))  # 毫秒级返回结果,避免指数级递归重复计算
案例三:统一权限鉴权与角色校验拦截器
在 Web 应用服务中,常常需要拦截未授权的访问请求。利用装饰器可以在视图函数执行前完成权限提取与条件判定:
import functools

class AuthenticationError(Exception):
    """鉴权失败异常"""
    pass

def require_role(allowed_roles: set):
    """
    权限校验装饰器
    假设入参中通过 request 上下文携带用户身份信息
    """
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            # 从 kwargs 或 args 中提取上下文信息
            current_user = kwargs.get("user")
            if not current_user:
                raise AuthenticationError("未检测到登录用户上下文")

            user_role = current_user.get("role")
            if user_role not in allowed_roles:
                raise AuthenticationError(
                    f"用户权限不足,当前角色为 '{user_role}',要求角色包含在 {allowed_roles} 中"
                )

            return func(*args, **kwargs)
        return wrapper
    return decorator

# 使用示例
@require_role(allowed_roles={"admin", "maintainer"})
def delete_database_cluster(cluster_id: str, user: dict = None):
    return f"集群 {cluster_id} 销毁指令已执行"

# 正常调用(拥有 admin 角色)
print(delete_database_cluster("cluster-101", user={"name": "Bob", "role": "admin"}))
七、设计避坑与选型决策全景
在工程项目中应用装饰器时,应根据业务诉求选用恰当的技术结构。下表对三种主要形态的特点及选型依据进行了对比:
| 装饰器形态 | 嵌套层数 | 参数配置支持 | 状态持有方式 | 推荐应用场景 |
|---|---|---|---|---|
| 双层函数装饰器 | 2 层 (dec > wrapper) | 不支持额外参数 | 闭包自由变量 | 通用耗时统计、未捕获异常上报、打印入参日志 |
| 三层工厂装饰器 | 3 层 (factory > dec > wrapper) | 支持传入自定义参数 | 多级闭包作用域 | 动态重试次数、多级超时限制、特定角色鉴权 |
| 类装饰器 | 1 个类 (__init__ + __call__) | 构造函数或闭包支持 | 实例属性 (self.attr) | 需要对外暴露管理接口、维护容量淘汰或生命周期钩子 |
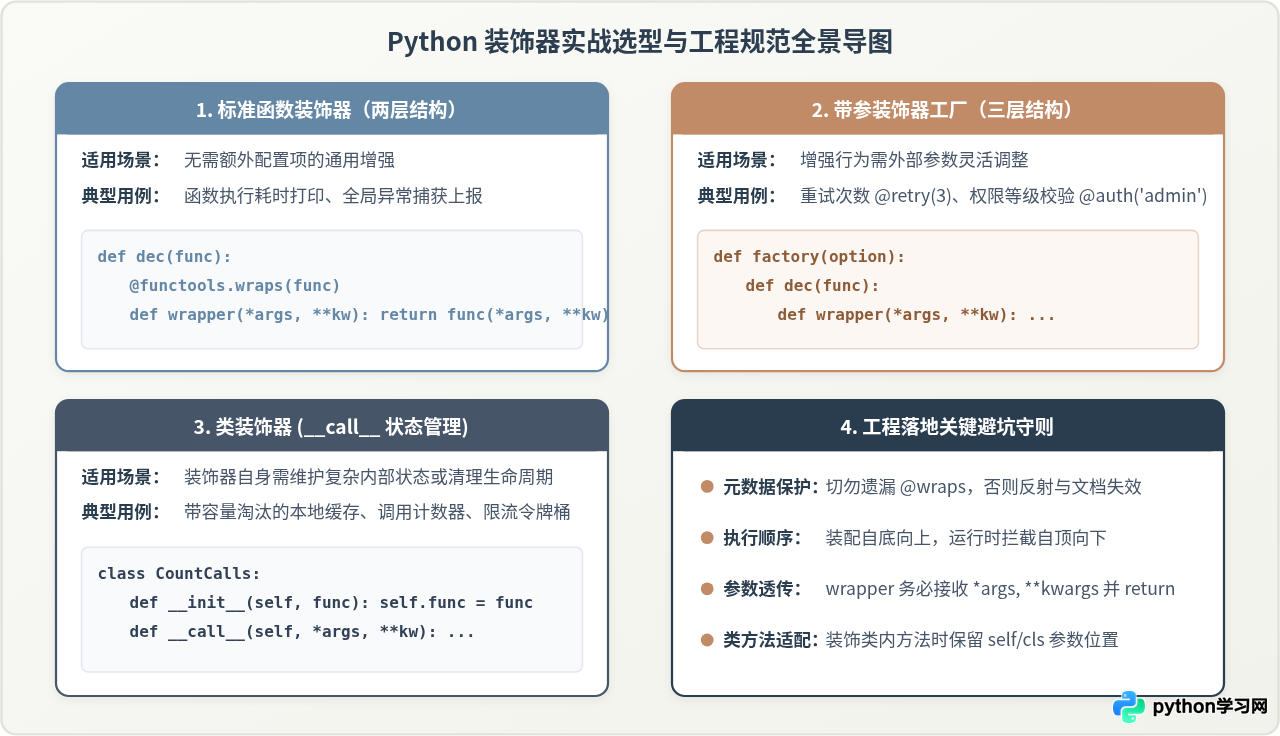
落实到具体编码时,请遵循以下四项原则:
- 永远使用
functools.wraps:确保反射机制、帮助文档及类型检测系统正常工作。 - 统一包装参数签名:包装函数使用
def wrapper(*args, **kwargs)并透传所有入参,不可擅自丢弃或硬编码特定参数。 - 必须显式透传返回值:除非是专门修改返回结果的装饰器,否则务必
return result,切忌因为漏写 return 导致原函数返回值变成None。 - 警惕并发下的闭包可变对象:如果在闭包中使用了字典、列表等可变对象记录状态,多线程环境下需要结合
threading.Lock保护,或者直接改用带锁机制的类装饰器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









