

Python新手必学的10个核心库:从Requests到Pandas入门指南

Python庞大的第三方生态是其最核心的生产力优势,但初学者面对数十万个功能各异的开源包,往往容易陷入不知从何学起的困境。掌握Python并不意味着要通读所有API,而是要建立一条从“数据获取”、“数据清洗计算”到“结果呈现与工程交付”的标准工具链。本文挑选出在实际开发、数据分析与日常自动化中高频出现的10个核心第三方库,系统梳理它们的核心职责、基本用法、典型代码与关键避坑要点,帮助初学者建立扎实、清晰的技能体系。
一、Python核心库的学习逻辑与协同流水线
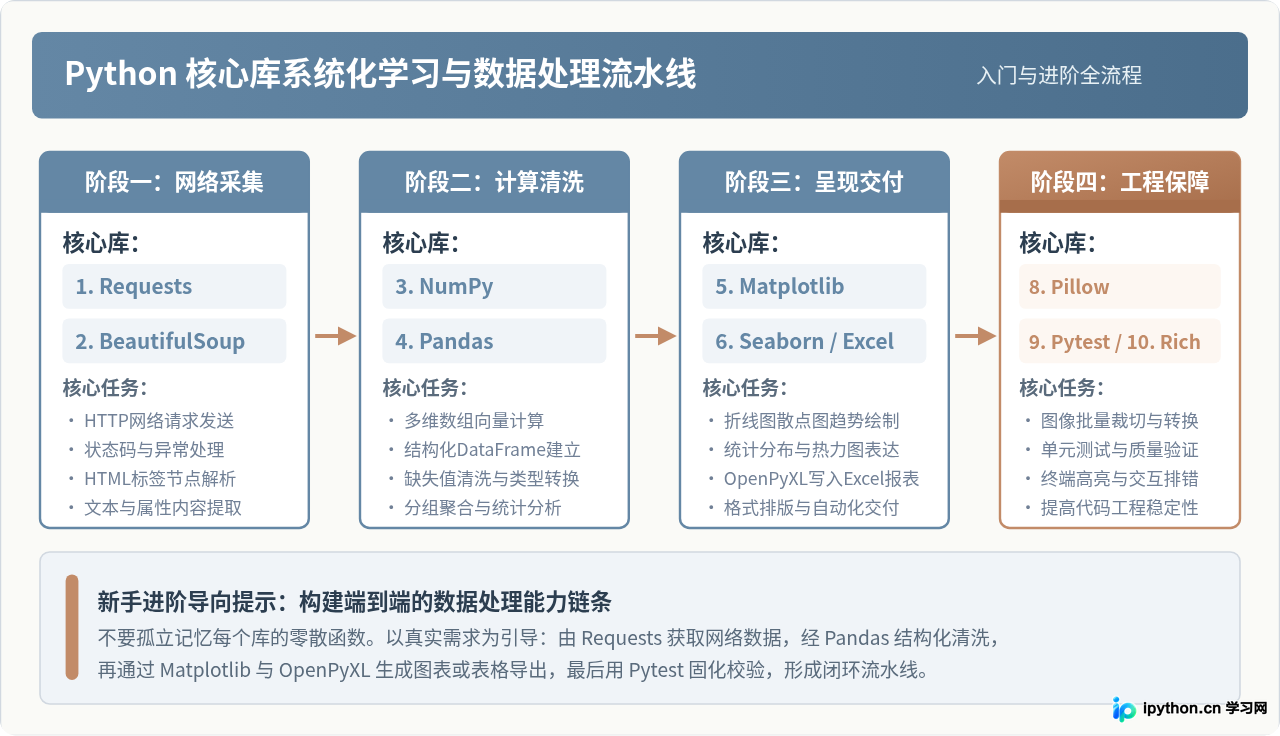
优秀的Python代码通常是多个核心库协同工作的结果。网络数据由网络库采集后,交给解析库抽取出纯净文本;接着通过数值与表格分析库进行矩阵运算和结构化聚合;随后由图表引擎或办公自动化工具导出报告;最后通过测试框架固化质量保障。将零散的库串联成流水线,是快速摆脱初学者阶段的关键。
二、网络交互与数据采集核心库
1. Requests:简洁优雅的HTTP客户端
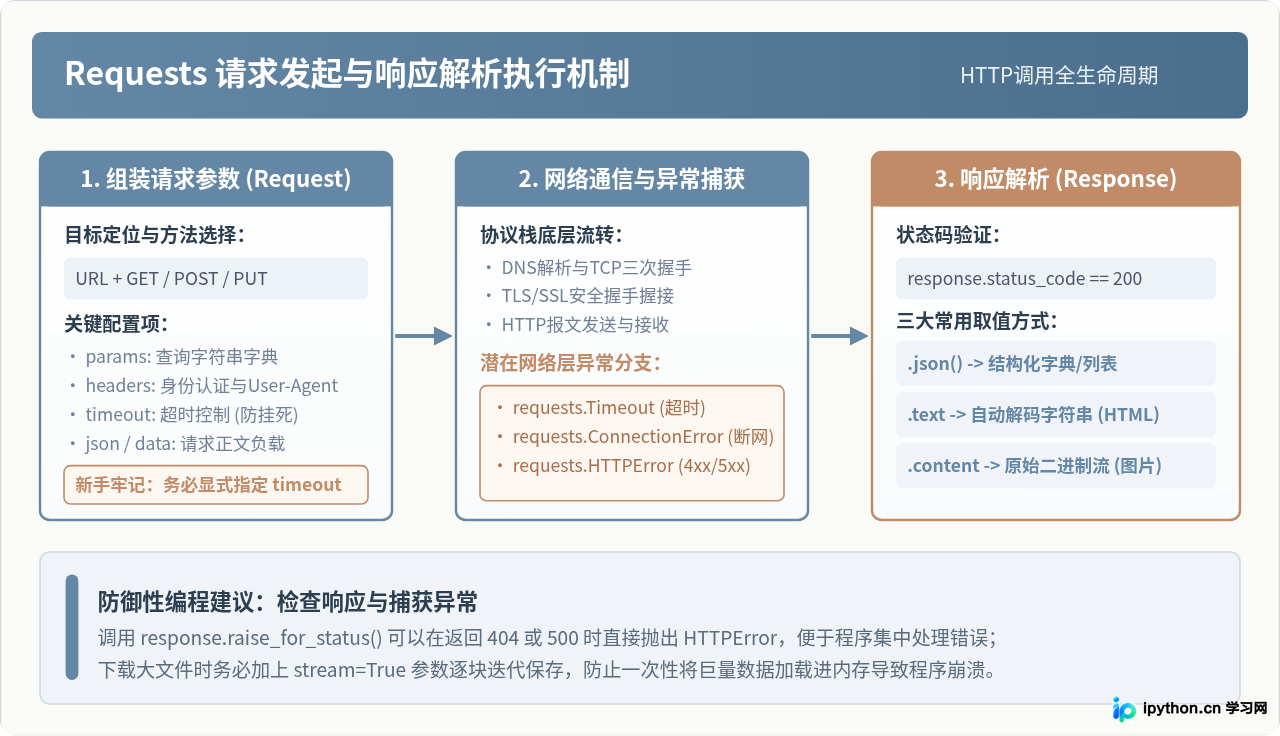
标准库中的urllib模块接口较为繁琐,而Requests库被誉为“人类可读的HTTP库”。它将底层的socket连接池、Cookie管理、重定向与编码识别全部封装为极简API,是与RESTful Web API通信及进行网络数据爬取的基础入口。
常见使用示例如下:
import requests

url = "https://api.github.com/events"
headers = {"User-Agent": "MyDemoApp/1.0"}
params = {"per_page": 5}

try:
    response = requests.get(url, headers=headers, params=params, timeout=10)
    response.raise_for_status()  # 状态码非200时抛出异常
    data = response.json()       # 自动解析JSON格式响应
    print(f"成功获取事件数量: {len(data)}")
except requests.exceptions.Timeout:
    print("网络请求超时,请检查连接")
except requests.exceptions.RequestException as err:
print(f"请求失败: {err}")1. 始终显式设置 timeout 参数。如果不指定超时时间,遇到对端挂起时进程将永久阻塞。
2. 注意区分 response.text(由编码自动猜测生成的字符串)与 response.content(原始字节流,常用于保存图片或二进制文件)。
2. BeautifulSoup4:网页HTML内容精准抽取
从网络获取的原始网页往往夹杂大量的HTML标签、脚本和样式。BeautifulSoup(bs4)可以将HTML字符串解析为树状对象,提供直观的节点搜索与CSS选择器支持,是结构化提取网页数据的重要工具。
基础解析示例如下:
from bs4 import BeautifulSoup

html_text = """
<div class="product-card">
  <h3 class="title">Python数据分析</h3>
  <span class="price">¥89.00</span>
</div>
"""

soup = BeautifulSoup(html_text, "html.parser")
title_node = soup.find("h3", class_="title")
price_node = soup.select_one(".product-card > .price")

if title_node and price_node:
    print("书名:", title_node.get_text(strip=True))
print("价格:", price_node.get_text(strip=True))当查询节点不存在时,find() 或 select_one() 会返回 None。必须进行空值判断后再调用 .get_text(),避免触发 AttributeError 异常终止爬取任务。
三、数值计算与数据分析核心库
3. NumPy:科学计算与多维数组的基础底座
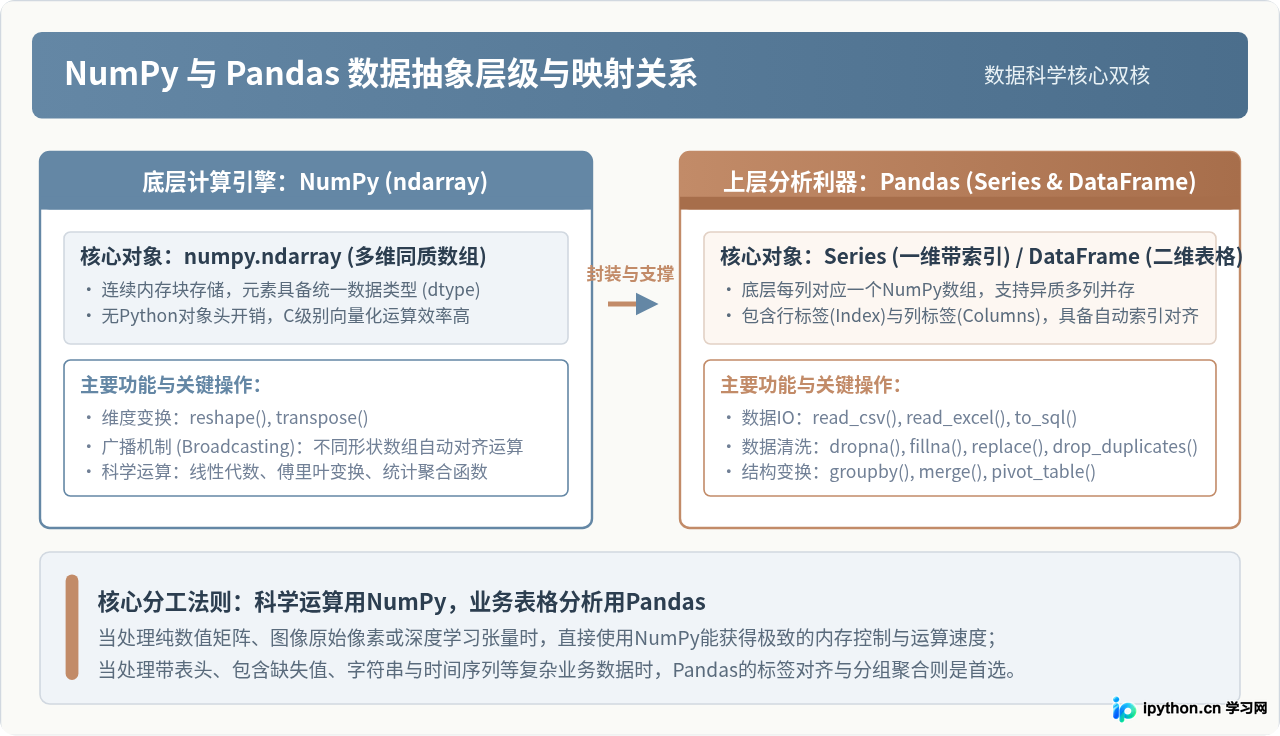
Python原生列表在存储数字时存在较大的指针开销与动态类型检查成本。NumPy通过C语言底层实现的 ndarray 对象,提供了连续内存存储与向量化运算能力。它是Pandas、Scipy等几乎所有数据科学库的共同依赖底座。
常用基础操作示例如下:
import numpy as np

# 创建连续向量与二维矩阵
scores = np.array([88.5, 92.0, 79.5, 95.0, 84.0])

# 向量化计算(不写Python显式for循环)
curved_scores = scores * 1.05

# 聚合统计分析
print("平均分:", np.mean(curved_scores))
print("最高分:", np.max(curved_scores))
print("标准差:", np.std(curved_scores))NumPy数组要求所有元素必须属于同一数据类型(dtype)。如果在一个数组中混合字符串与浮点数,NumPy会强制将所有数据转换为通用字符串类型,导致丢失数值计算能力。
4. Pandas:结构化表格数据清洗与分析利器
如果说NumPy解决了纯数字矩阵的高效计算,那么Pandas则解决了带表头、带索引、包含异质列(文字、数字、日期混合)的复杂业务数据处理。Pandas的核心抽象是一维序列 Series 与二维表格 DataFrame,支持高效的切片、合并、缺失值填补与分组聚合。
典型数据分析代码示例如下:
import pandas as pd

# 构建模拟业务数据
data = {
    "city": ["北京", "上海", "广州", "北京", "深圳"],
    "sales": [120, 150, 95, 130, 180],
    "category": ["A", "B", "A", "B", "A"]
}
df = pd.DataFrame(data)

# 条件过滤与分组聚合
high_sales = df[df["sales"] >= 120]
city_summary = df.groupby("city")["sales"].agg(["mean", "sum"])

print("高销售额记录:\n", high_sales)
print("\n城市汇总统计:\n", city_summary)1. 数据定位必须清晰区分基于标签的 .loc 与基于整数位置的 .iloc。
2. 对筛选出的子视图直接赋值时,常引发 SettingWithCopyWarning 警告。若需修改副本,应显式调用 .copy()。
四、数据可视化与统计呈现核心库
5. Matplotlib:高度可控的图表绘制底座
Matplotlib是Python可视化领域的基石。它提供了类似MATLAB的绘图控制接口,允许精确调整画布上的每一个像素点、坐标轴刻度、图例与标注,适合生成高分辨率的学术图表或业务折线图。
推荐使用面向对象风格进行绘图:
import matplotlib.pyplot as plt

months = ["1月", "2月", "3月", "4月"]
values = [120, 180, 160, 240]

fig, ax = plt.subplots(figsize=(7, 4))
ax.plot(months, values, marker="o", color="#6487A5", linewidth=2, label="月度活跃")
ax.set_title("季度业务趋势指标", fontsize=14)
ax.set_xlabel("时间周期")
ax.set_ylabel("指标数值")
ax.grid(True, linestyle="--", alpha=0.5)
ax.legend()

plt.tight_layout()
plt.savefig("metric_trend.png", dpi=200)Matplotlib默认不包含中文字体,直接绘制中文标签常导致方块乱码。可通过配置 plt.rcParams['font.sans-serif'] = ['SimHei', 'PingFang SC'] 指定系统支持的中文字体解决。
6. Seaborn:基于统计语义的高级可视化
Matplotlib虽然精细,但绘制复杂的统计分布图(如箱线图、小提琴图、热力图)代码量较大。Seaborn在Matplotlib之上做了高度封装,深度适配Pandas DataFrame,只需要几行代码即可生成美观的专业统计图形。
基础统计图表示例:
import seaborn as sns
import matplotlib.pyplot as plt

# 使用内置统计数据集
df = sns.load_dataset("tips")

fig, ax = plt.subplots(figsize=(7, 4))
sns.scatterplot(data=df, x="total_bill", y="tip", hue="time", palette="Set1", ax=ax)
ax.set_title("消费金额与小费相关性散点图")

plt.tight_layout()
plt.savefig("tips_scatter.png")Seaborn对“长格式数据”(Tidy Data)有较强的偏好。在调用多变量映射(如hue、style)前,最好先用Pandas整理好列格式。
五、自动化办公与媒体支持核心库
7. OpenPyXL:Excel电子表格的原生读写
在日常办公自动化中,Excel文件(.xlsx)是最频繁的交付格式。虽然Pandas提供简单读写,但保留复杂单元格样式、公式和多工作表格式化时,OpenPyXL是更细粒度且不需要依赖Windows Office运行时的独立纯Python方案。
典型操作代码如下:
import openpyxl

# 创建新工作簿并写入数据
wb = openpyxl.Workbook()
ws = wb.active
ws.title = "汇总看板"

ws.append(["部门", "员工数", "平均业绩"])
ws.append(["技术部", 28, 92.5])
ws.append(["市场部", 15, 88.0])

# 修改特定单元格与保存
ws["D1"] = "更新状态"
ws["D2"] = "已核对"

wb.save("department_report.xlsx")OpenPyXL中的行号和列号是从1开始索引的,而不是Python列表传统的从0开始,在编写循环范围时需注意下标差异。
8. Pillow:图像处理与格式转换必备
Pillow是广受欢迎的PIL(Python Imaging Library)现代分支,支持快速读取、裁剪、等比缩放、滤镜处理以及在图片上绘制水印文字,是批量多媒体处理的利器。
基础使用示例如下:
from PIL import Image

# 打开图片并生成等比例缩略图
with Image.open("input_photo.jpg") as img:
    # 转换为RGB以避免PNG透明通道保存为JPEG时的错误
    rgb_img = img.convert("RGB")
    rgb_img.thumbnail((400, 400))
rgb_img.save("thumbnail.jpg", quality=85)使用 thumbnail() 方法会保持宽高比就地修改对象,而不会拉伸变形;如果需要严格强制尺寸裁剪,应配合使用 crop() 或 resize()。
六、工程质量与排错交互核心库
9. Pytest:极简而强大的单元测试框架
新手编写脚本时往往依赖临时的 print() 语句排查错误,但随着逻辑变复杂,自动化测试是保障代码可靠性的唯一标准。Pytest彻底废弃了Java风格的样板代码,直接使用标准Python原生的 assert 表达式即可进行断言测试。
测试函数示例如下:
import pytest

def normalize_price(val):
    if val < 0:
        raise ValueError("价格不能为负数")
    return round(val, 2)

def test_normalize_price_valid():
    assert normalize_price(19.994) == 19.99
    assert normalize_price(10) == 10.0

def test_normalize_price_negative():
    with pytest.raises(ValueError):
normalize_price(-5)测试文件名通常命名为 test_*.py,测试函数以 test_ 开头,这样只需在命令行直接输入 pytest,框架即可自动发现并执行全部测试集。
10. Rich:现代化终端高亮与排查辅助
在控制台输出日志、排查数据结构或监控批量任务时,默认的纯文本输出难以快速抓住关键信息。Rich可以在终端中输出优雅的高亮色彩、格式化表格、进度条与语法高亮,极大提升了本地开发调试的舒适度。
终端表格与格式化输出示例:
from rich.console import Console
from rich.table import Table

console = Console()
table = Table(title="核心库学习进度看板")

table.add_column("库名称", style="cyan")
table.add_column("主要类别", style="magenta")
table.add_column("新手难度", style="green")

table.add_row("Requests", "网络采集", "入门友好 (★☆☆)")
table.add_row("Pandas", "结构化分析", "核心必修 (★★★)")
table.add_row("Pytest", "工程测试", "规范推荐 (★★☆)")

console.print(table)如果脚本执行结果重定向输出到了文件(如系统cron或后台重定向),Rich会自动降级为纯文本,避免将ANSI色彩转义字符混入文本日志中。
七、10个核心库全景分类与选型决策指南
将这10个库按照其在工程链路中的定位进行横向比较,可以清晰看到它们的边界与协作关系。初学者不必强求一次性全部精通,应先熟悉采集(Requests)与分析(Pandas)的核心概念,再按需扩展其他工具。
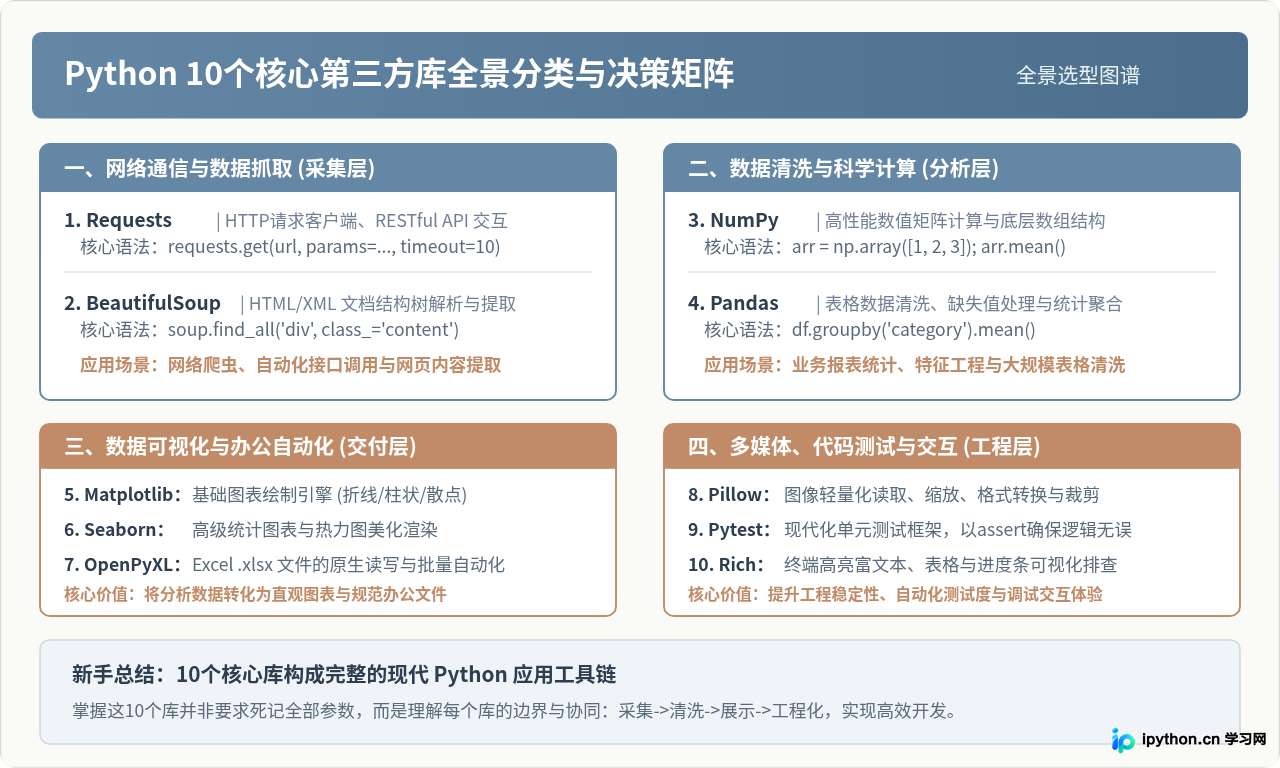
在实际进阶过程中,建议遵循以下三条准则:首先,以具体问题为导向,而非盲目背诵函数参数;其次,务必在独立的虚拟环境(如 venv)中进行依赖安装与隔离,避免全局包冲突;最后,养成阅读官方文档 Quickstart 章节的习惯,牢牢抓住每个库的核心数据结构抽象。通过将这10个核心库组合运用,初学者就能在数据采集、批量处理、报表交付与工程开发中从容应对绝大多数实际需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









