

Python爬虫工作原理:从发送请求到数据解析的完整流程
深入拆解Python网络爬虫的核心运作原理与全生命周期,从HTTP请求构造、网络连接与状态码判定,到DOM树构建与结构化数据解析,结合完整代码与架构流程图,掌握爬虫底层的执行机制与工程化落地方法。
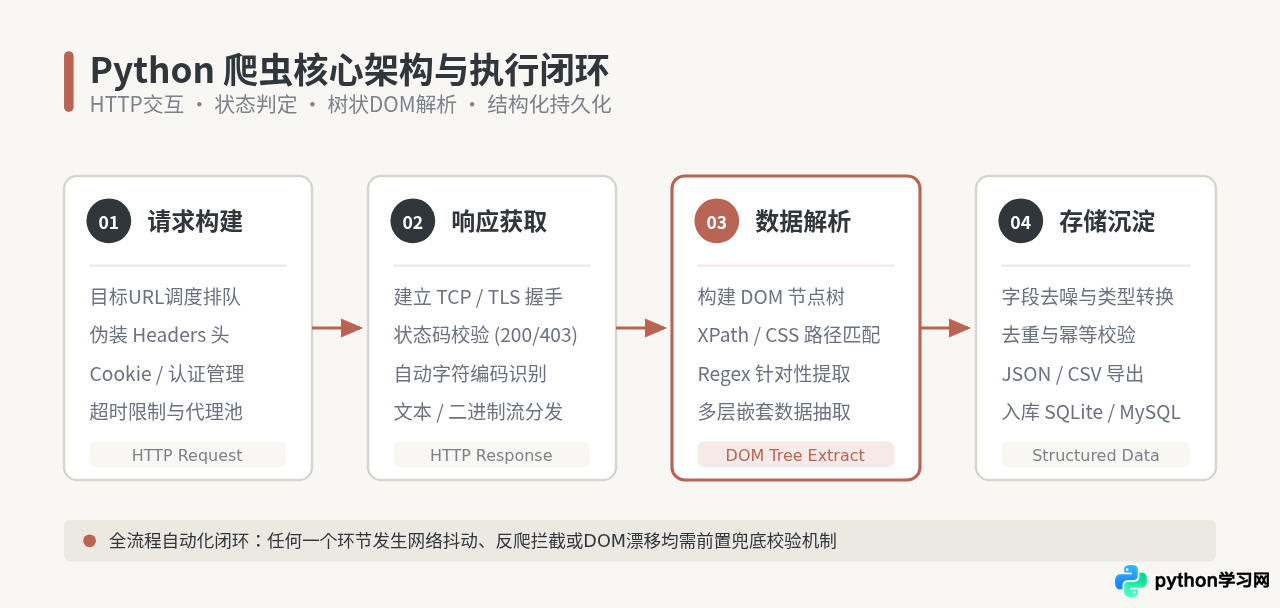
网络爬虫本质上是一段按照既定逻辑自动化模拟网络请求、接收远程资源并提取目标信息的程序。无论面对的是简单的静态内容展示站,还是具备多重鉴权防护的企业级应用,其底层的运转逻辑都遵循一个清晰的四步闭环:确定抓取目标并构造合规的 HTTP 请求、通过底层网络协议建立连接并获取服务端响应、利用模式匹配或树状解析器提取结构化数据,以及完成字段清洗后的数据持久化存储。理解这一完整过程,不仅有助于快速编写高效的数据抓取脚本,更是在遇到请求被拒、页面改版或乱码报错时定位根本原因的前提。
一、爬虫运转的基础模型:客户端与服务端的 HTTP 交互
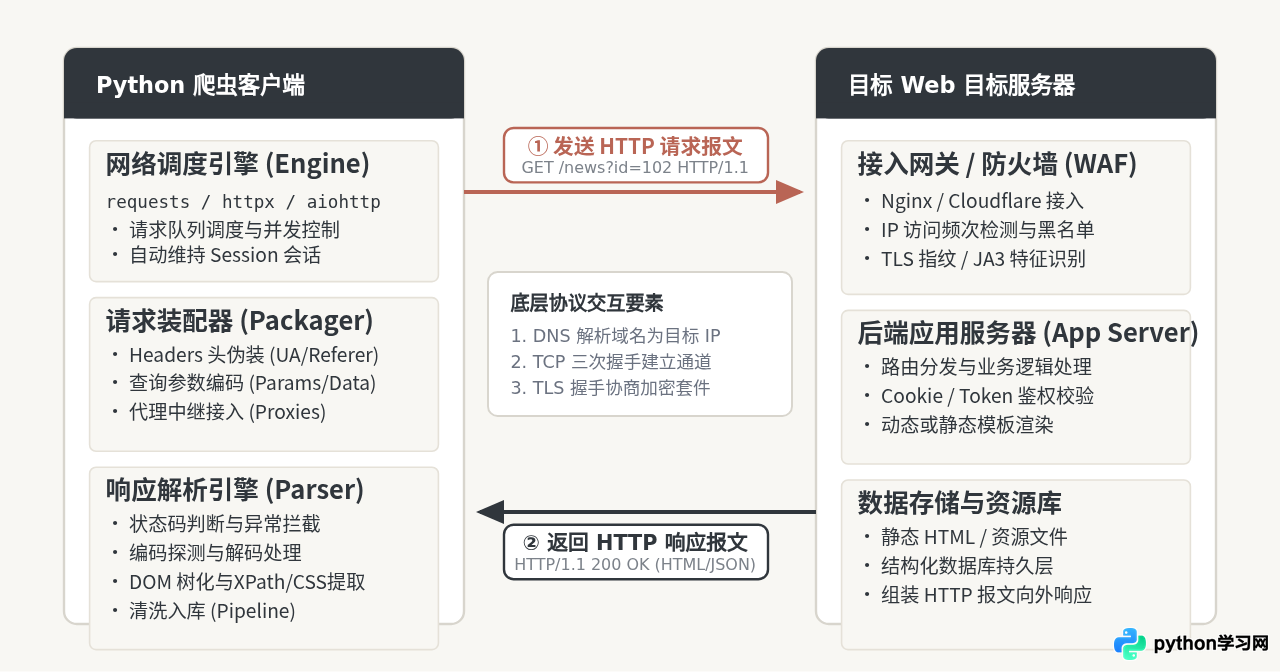
要透彻理解网络爬虫的工作原理,首先需要明确客户端与 Web 服务器之间的数据交换机制。我们在浏览器中输入网址浏览网页时,浏览器会在后台向服务器发送一次或多次标准格式的 HTTP 报文;网络爬虫的作用,正是通过代码模拟这一过程,从而取代人工的手动点击和浏览。
在底层协议体系中,网络爬虫作为客户端,会经历域名 DNS 解析、TCP 三次握手建立传输通道、以及可选的 TLS 握手协商加密套件。连接建立后,爬虫便会向目标主机发送格式严格的请求报文。服务器收到并解析报文后,执行业务逻辑,再以标准 HTTP 响应报文的形式返回状态码、响应头与主体数据(HTML、JSON 或二进制文件流)。
普通浏览器与轻量级 Python 爬虫之间存在一个至关重要的区别:浏览器是一个完整的渲染运行时,接收到初始 HTML 后,会自动并发下载 CSS、JavaScript 脚本与多媒体文件,并启动 JavaScript 引擎执行动态脚本渲染 DOM;而基础的 Python 爬虫(如基于 requests 或 urllib 编写的脚本)只负责接收网络响应的原始字节流,不会主动执行任何客户端 JavaScript 脚本。如果目标网页的数据是通过 AJAX 异步拉取并在前端动态渲染生成的,直接向页面 URL 发送请求只会得到一个空壳骨架,此时必须分析真实的异步接口地址,或引入无头浏览器渲染引擎。
二、核心步骤拆解:从构造请求到安全接收响应
一次标准的数据采集任务,在代码层面首先表现为请求的组装与发送。许多初学者写爬虫常遇到“一运行就报错 403 Forbidden”的问题,其核心诱因往往就在于请求报文缺少最基本的伪装标识。
1. 关键请求头的伪装与参数装配
当通过 Python 发出请求时,底层网络库默认会携带暴露脚本身份的标识(例如 requests 默认的 User-Agent: python-requests/2.x)。绝大多数网站的安全策略会直接封禁此类非浏览器特征的请求。因此,在构造请求时必须主动补齐以下关键头部:
- User-Agent(用户代理):告知服务端客户端的操作系统、浏览器版本及内核,是识别正常访问的第一道关卡。
- Referer(请求来源页):指明当前请求是从哪个页面跳转而来,许多图片防盗链或受保护的数据接口会强制校验此字段。
- Cookie / Authorization(身份凭证):携带用户的会话标识或 API Token,用于访问必须登录授权的受保护数据。
2. 请求发送与响应状态码判定
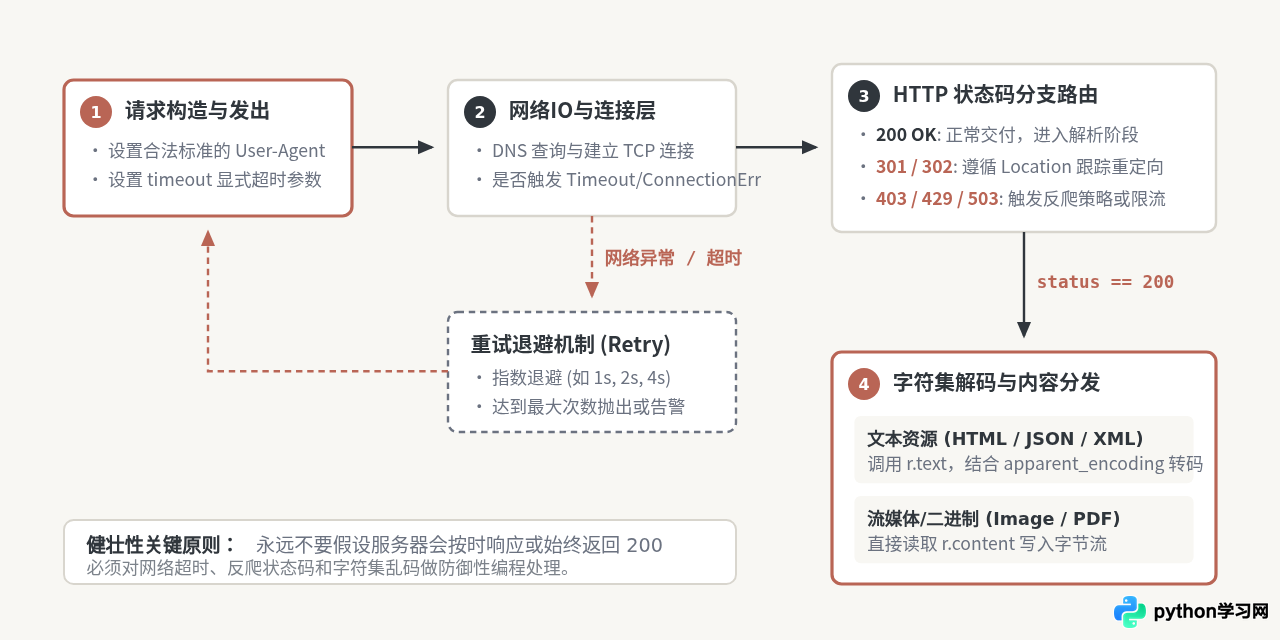
发送请求不能仅满足于“拿回数据”,还必须做好防御性编程。网络抖动可能导致阻塞,服务端的异常也必须妥善拦截。下面是一段标准的请求发送与状态校验示例代码:
import requests
from requests.exceptions import Timeout, RequestException

url = "https://example.com/data-list"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

try:
    # 显式设置 timeout,避免网络挂起无限期等待
    response = requests.get(url, headers=headers, timeout=10)

    # 判定 HTTP 响应状态码
    if response.status_code == 200:
        # 处理字符编码,避免中文乱码
        # r.encoding 读取的是响应头中的 Content-Type 声明
        # r.apparent_encoding 则是根据正文内容智能推导出的真实编码
        response.encoding = response.apparent_encoding
        html_text = response.text
        print("响应获取成功,进入数据解析阶段。")
    elif response.status_code in (301, 302):
        print(f"检测到重定向跳转,目标地址:{response.headers.get('Location')}")
    elif response.status_code == 403:
        print("访问被拒绝 (403 Forbidden),请检查 Headers 伪装、Cookie 或当前 IP 是否受限。")
    elif response.status_code == 429:
        print("触发频率限制 (429 Too Many Requests),需要降低并发并增加延时间隔。")
    else:
        print(f"异常状态码返回:{response.status_code}")

except Timeout:
    print("网络请求超时,触发告警或进入重试队列。")
except RequestException as e:
    print(f"底层网络通信异常:{e}")
注意:在读取响应内容时,针对文本类资源应使用 response.text;若抓取的目标是图片、PDF 或视频等二进制流,必须直接使用 response.content 写入字节文件,强行将其解码为字符串会导致数据损坏。
三、数据解析原理:从非结构化文本到精确数据提取
当爬虫成功接收到 response.text 之后,面对的是一段往往长达数万字节的原始 HTML 字符流。如果单纯将其视作长字符串进行遍历,代码将变得极其繁琐脆弱。数据解析的本质任务,就是将非结构化的标记文本重构成具备父子、兄弟关系的 DOM 节点树,再通过精确的路径或选择规则完成定位抽取。
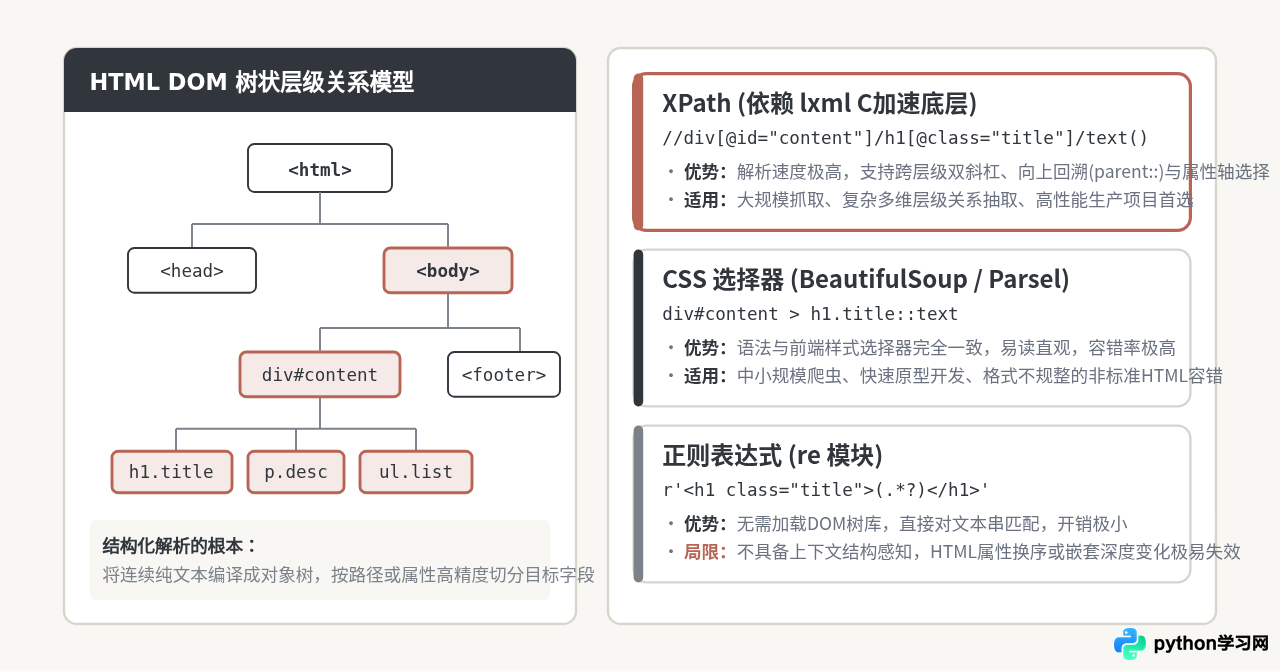
1. 三种解析策略的技术选型与差异
| 解析方案 | 底层依赖与原理 | 提取语法示例 | 主要优势 | 局限与易错点 |
|---|---|---|---|---|
| XPath | lxml 库,基于底层 C 语言解析引擎,将 HTML 转换为 XML 节点树 | //div[@id="main"]//h2/text() |
查询速度极快,支持向上回溯父级节点、多属性逻辑组合与轴语法 | 语法有一定上手学习成本,对路径层级变动要求准确 |
| CSS 选择器 | BeautifulSoup4 / Parsel,模拟浏览器前端样式定位逻辑 | div#main h2::text 或 select("div#main h2") |
语法与前端 CSS 规则完全一致,直观易读,容错率高 | 在纯 Python 实现下性能略低于底层 lxml,不支持向上查找父节点 |
| 正则表达式 | Python 内置 re 模块,直接在连续字符串中进行子串模式匹配 |
r'<h2 class="title">(.*?)</h2>' |
无需引入第三方解析库,匹配纯文本或内嵌 JSON 字符串极为轻快 | 无法感知 HTML 树状嵌套上下文,属性乱序或标签微调极易导致匹配失败 |
2. 实战解析对比代码:XPath 与 BeautifulSoup 的不同写法
假设我们抓取到的页面中包含如下典型的商品列表片段:
<div class="goods-item" id="item-2048">
    <h3 class="name">智能机械键盘</h3>
    <span class="price" data-currency="CNY">¥ 399.00</span>
    <a class="detail-link" href="/product/2048">查看详情</a>
</div>
采用 XPath (lxml) 进行定位时,我们通常使用双斜杠 // 表示任意后代,使用 @ 符号读取属性:
from lxml import etree

# 将 HTML 文本解析为元素树
html_tree = etree.HTML(html_text)

# 获取所有商品卡片节点
items = html_tree.xpath('//div[@class="goods-item"]')

for item in items:
    # 相对路径以 ./ 开头
    name = item.xpath('./h3[@class="name"]/text()')[0].strip()
    price = item.xpath('./span[@class="price"]/text()')[0].strip()
    link = item.xpath('./a[@class="detail-link"]/@href')[0].strip()

    print(f"[XPath提取] 名称: {name} | 价格: {price} | 链接: {link}")
同样的数据,若使用 BeautifulSoup 与 CSS 选择器进行提取,写法如下:
from bs4 import BeautifulSoup

soup = BeautifulSoup(html_text, "html.parser")
items = soup.select("div.goods-item")

for item in items:
    name = item.select_one("h3.name").get_text(strip=True)
    price = item.select_one("span.price").get_text(strip=True)
    link = item.select_one("a.detail-link")["href"].strip()

    print(f"[BS4提取] 名称: {name} | 价格: {price} | 链接: {link}")
在面对格式不规整、存在未闭合标签的恶劣 HTML 时,BeautifulSoup 的容错修补能力较强;而在需要处理数以万计的大规模页面抓取时,基于 C 底层的 lxml 的性能优势往往可以带来数倍的解析速度提升。
四、数据清洗、持久化与工业级异常应对闭环
完成数据提取并不意味着爬虫任务的结束。从网页上抓取下来的原始数据往往充斥着无意义的换行符、HTML 实体字符(如 )以及不规范的数据格式。必须经过统一的清洗加工,才能真正持久化入库。
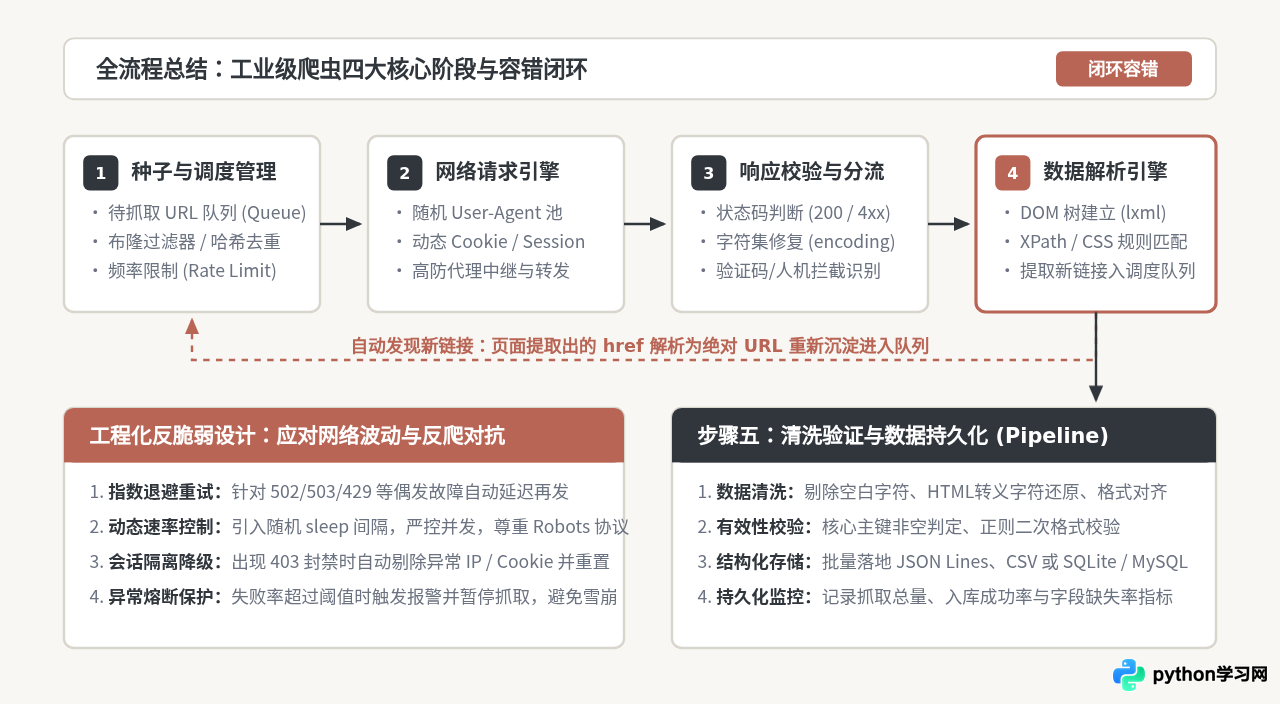
1. 字段清洗与规范化
清洗环节的核心操作包括:
- 去除杂质与格式化:清除多余的首尾空格、换行符(
html.unescape还原转义字符。 - 数值与类型转换:将字符串格式的价格(如
¥ 399.00)通过正则剥离符号并转换为浮点数(399.00),时间字符串规范化为标准 ISO 时间戳。 - 相对链接绝对化:抓取到的链接往往是相对路径(如
/product/2048),必须使用urllib.parse.urljoin(base_url, href)补齐为完整的可用 URL。
2. 结构化持久化
经过清洗的数据通常保存为 JSON Lines、CSV 文件或写入关系型数据库。以保存为逐行 JSON 文件的经典流程为例:
import json

record = {
    "title": "智能机械键盘",
    "price": 399.00,
    "url": "https://example.com/product/2048",
    "crawl_time": "2026-10-30T03:34:00"
}

# 使用 jsonlines 格式追加写入,支持断点续传且容错率高
with open("products.jsonl", "a", encoding="utf-8") as f:
    f.write(json.dumps(record, ensure_ascii=False) + "\n")
3. 提升爬虫健壮性的三大法则
在实际生产环境中,爬虫运行面临着网络抖动、目标站防爬升级或页面结构漂移等多重不确定性。要保证爬虫稳定长效运行,应在代码中落地以下三项工程化约束:
- 频率自律与礼貌抓取:无节制的高并发访问不仅会对目标服务器带来拒绝服务压力,也会迅速触发防爬网关的封禁。在循环请求间必须加入随机延时(如
time.sleep(random.uniform(1.0, 3.0))),并严格遵循目标站的robots.txt协议规则。 - 指数退避重试(Exponential Backoff):遇到 502/503 或网络连接超时时,避免盲目即时重试。采用间隔随重试次数递增的策略(例如重试间隔为 1s、2s、4s、8s),并在达到上限后写入失败日志。
- 解析字段断言与预警:解析逻辑应做好默认值兜底(例如
item.xpath(...) or ['']),避免单条数据的某个字段缺失导致整批任务崩溃退出;同时应监控空值字段比例,一旦空值率异常上升,通常意味着目标网站的前端改版或触发了验证码拦截。
总结
Python 爬虫的工作原理看似错综复杂,但归纳起来始终沿着“构造请求报文 ➔ 建立网络会话 ➔ 校验响应内容 ➔ DOM树化与定向抽取 ➔ 格式清洗入库”这一脉络演进。掌握了 HTTP 协议的基本交互规则与数据在节点树中的定位机制,便能从容应对绝大部分常见的数据抓取需求。在此基础上,保持合理的访问频率与合规边界,构建具备异常恢复与重试能力的工程化代码,是写出稳定、高效爬虫程序的关键所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









