

Python字符串与列表常用方法速查清单
一份结构化、实用的Python字符串与列表常用方法速查清单。涵盖字符串文本清洗、查找定位、拆分合并,以及列表增删改查、排序和就地修改机制,配备完整代码示例与四幅原理解析图。
在 Python 编程中,文本处理与序列组织几乎占据了大部分核心逻辑。字符串(str)和列表(list)作为最基础且高频的两种内置数据类型,分别承担着“字符文本序列”和“通用对象容器”的职责。掌握它们的高频内置方法、内部行为特性(尤其是不可变性与就地修改机制),是编写整洁、高效且无低级缺陷代码的核心基础。本文系统梳理这两大类型的常用方法、切片规则、转换技巧与排坑经验,便于日常开发随时速查。
一、核心认知:不可变字符串 vs 可变列表
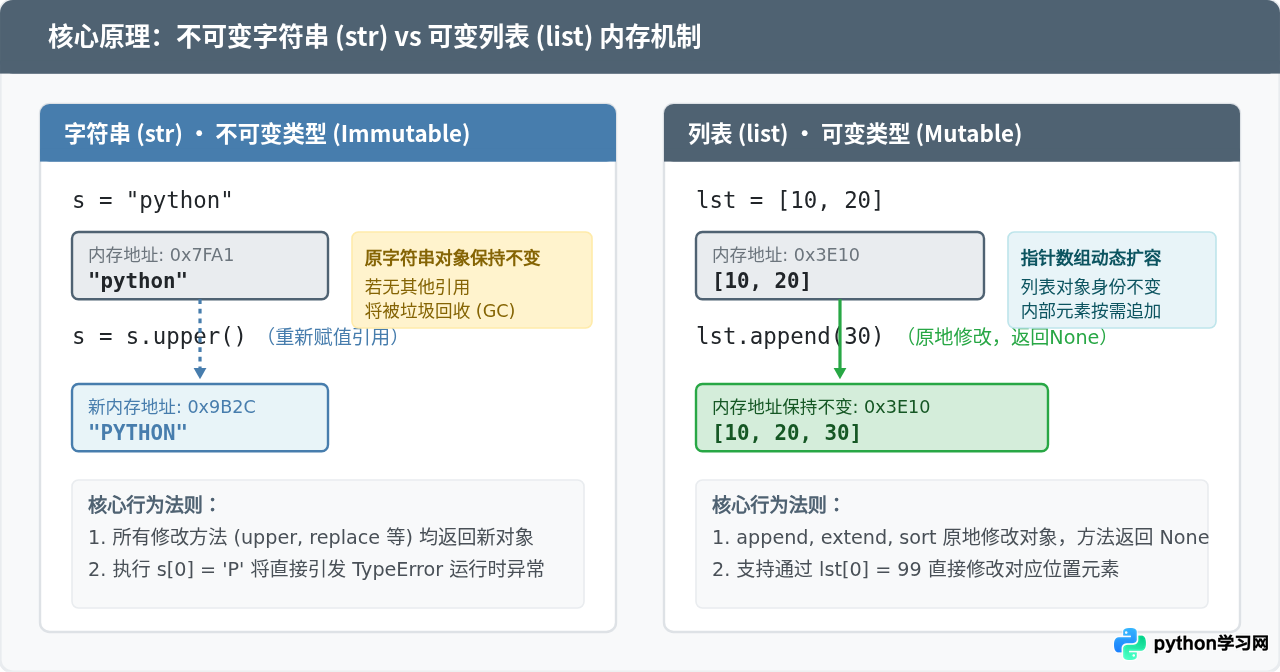
在使用字符串和列表的方法前,最关键的前提是理解两者的“内存可变性”差异。这个底层特征直接决定了调用方法后原变量是否改变,以及方法是否有有效返回值:
- 字符串是不可变对象(Immutable): 字符串一旦在内存中创建,其内容就无法被就地修改。所有对字符串执行的操作(如
upper()、replace()、strip())都不会改变原字符串,而是计算并分配一个全新的字符串对象返回。如果尝试通过索引直接赋值(例如s[0] = 'a'),Python 会立即抛出TypeError。 - 列表是可变对象(Mutable): 列表本质是一个动态引用数组。列表的方法(如
append()、extend()、sort()、reverse())绝大多数直接在原列表所在的内存空间进行原地修改(In-place),其执行后的返回值通常为None。同时,可以通过索引直接重写任意元素(如lst[0] = 99)。
切片通用语法与边界规则
字符串与列表都属于序列(Sequence),支持完全一致的切片语法:sequence[start:stop:step]。切片遵循“左闭右开”规则(包含 start,不包含 stop):
seq[1:4]:提取索引 1 到 3 的元素。seq[:3]:从开头提取到索引 2。seq[-3:]:提取倒数第 3 个到结尾的所有元素。seq[::-1]:步长为 -1,快速翻转字符串或列表。- 越界表现差异: 单独访问索引
seq[999]在超出范围时会抛出IndexError;而切片seq[0:999]具有自动容错机制,超出长度时自动截断,绝不报错。
二、字符串(str)常用方法速查
字符串方法主要用于文本清洗、模式定位、格式对齐以及与结构化数据的互转。由于字符串不可变,调用任何字符串方法都必须接收其返回值。
1. 文本清理与裁剪
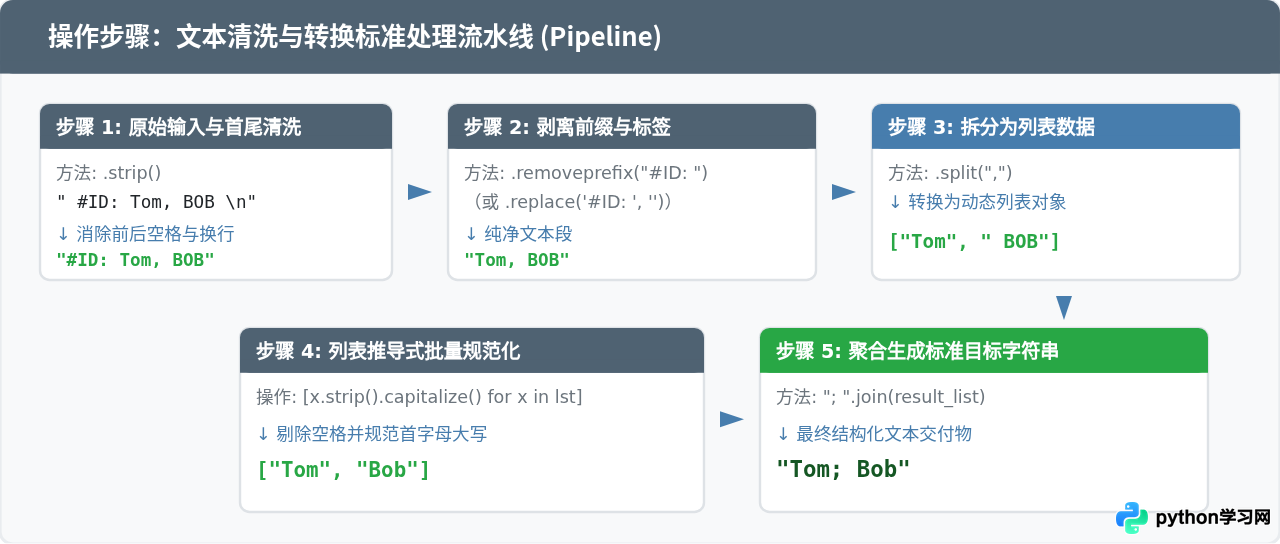
s.strip([chars]):去除字符串首尾指定的字符集合,默认去除所有空白符(空格、\t、\n、\r)。s.lstrip()/s.rstrip():分别仅去除左侧(开头)或右侧(结尾)的空白符。s.removeprefix(prefix)(Python 3.9+):精准移除指定前缀,比切片更清晰且不易越界。s.removesuffix(suffix)(Python 3.9+):精准移除指定后缀。
2. 查找、检验与定位
s.find(sub, [start, end]):从左向右查找子串,返回首次出现的索引。未找到返回 -1(安全查找)。s.rfind(sub):从右向左查找,返回子串最后一次出现的起始索引。未找到返回 -1。s.index(sub):功能同find(),但未找到时会直接抛出 ValueError 异常。s.count(sub):统计子串在整个字符串中非重叠出现的总次数。s.startswith(prefix):判断是否以指定前缀开头,支持传入元组批量匹配:s.startswith(('http:', 'https:'))。s.endswith(suffix):判断是否以指定后缀结尾,同样支持元组传参(常用于文件扩展名过滤)。
3. 替换与形态转换
s.replace(old, new, [count]):将字符串中的old替换为new。可选参数count限制最大替换次数。s.lower()/s.upper():全小写 / 全大写转换。s.title():每个单词首字母大写。s.capitalize():仅整个字符串的首个字符大写,其余全部变小写。
4. 拆分与重组(核心高频)
s.split(sep=None, maxsplit=-1):使用指定分隔符拆分成列表。当sep=None时,会自动将连续任意空格、制表符、换行符视作单一分隔符,并自动去除首尾空项。s.rsplit(sep, maxsplit=1):从右侧开始拆分,常配合maxsplit=1快速分离文件名与后缀。s.splitlines([keepends]):按行拆分,自动识别\n、\r\n等不同系统的换行标记。sep.join(iterable):以sep为间隔,将可迭代对象中的字符串元素拼接成单个字符串(注意调用主体是分隔符)。
5. 字符属性判断
raw = "20261024"
print(raw.isdigit())    # True: 纯数字字符检测
print("alpha".isalpha()) # True: 纯字母检测
print("a10".isalnum())   # True: 字母或数字检测
print("   \n".isspace()) # True: 纯空白字符检测
三、列表(list)常用方法速查
列表是最常用的动态容器类型。在调用列表方法时,必须清晰区分哪些方法是原地修改容器,哪些方法会返回新对象或查询结果。
1. 元素添加方法
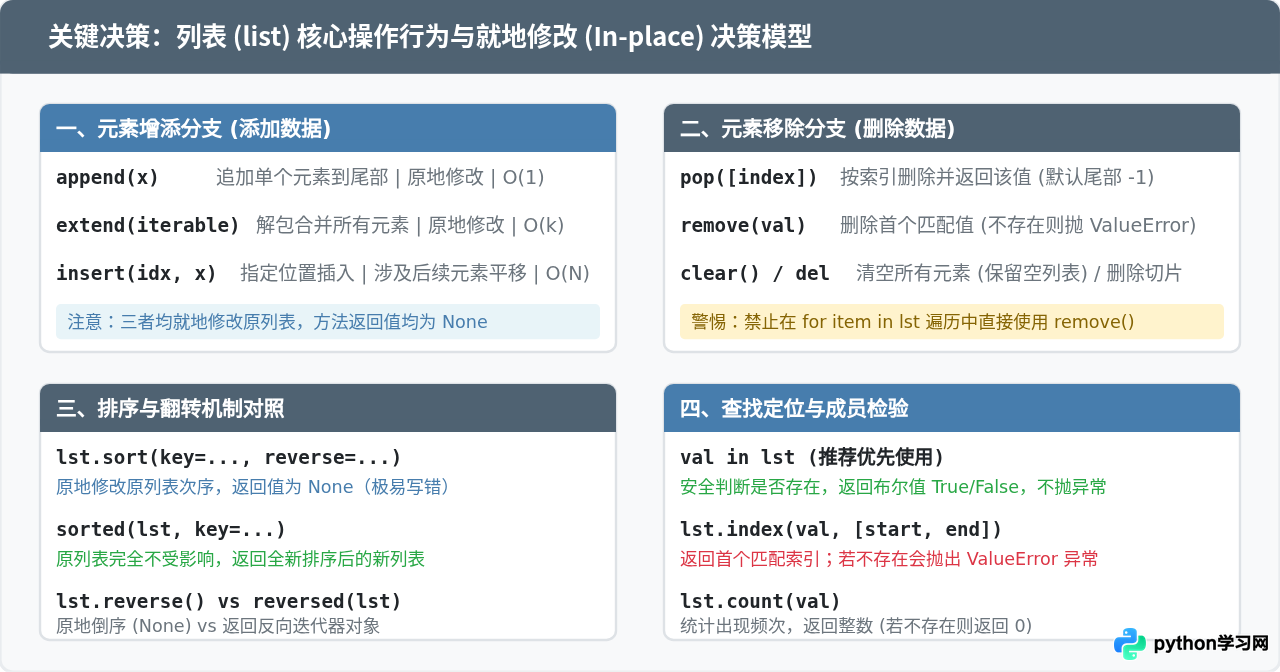
lst.append(x):将元素x作为一个完整项追加到列表尾部。平均时间复杂度为 $O(1)$。即使传入的是另一个列表,也会将整个子列表作为单个嵌套项存入。lst.extend(iterable):解包传入的可迭代对象,将其包含的所有元素逐个追加到原列表尾部。若希望将两个列表扁平合并,应使用extend()或+。lst.insert(index, x):在指定index位置插入元素x。插入位置之后的所有元素都会向后平移一位,时间复杂度为 $O(N)$,对于极长列表频繁执行前置插入(index=0)应考虑collections.deque。
2. 元素删除方法
lst.pop([index]):移除并返回指定索引处的元素。若不带参数,默认弹出最后一个元素(尾部出栈,复杂度 $O(1)$)。指定索引如pop(0)会导致后续元素前移(复杂度 $O(N)$)。索引越界会抛出IndexError。lst.remove(value):从左向右搜索并删除首个匹配指定值的元素。返回值为None。如果值在列表中不存在,会抛出ValueError。因此在调用前常配合if value in lst:保护。lst.clear():清空列表中的所有元素,列表对象本身依然保留(变为空列表[])。del lst[i]/del lst[1:3]:Python 内置语句,用于删除指定索引或切片范围内的元素。
3. 排序与反转(关键防错)
lst.sort(key=None, reverse=False):就地修改列表元素次序,执行后原列表顺序改变,返回值为 None。sorted(iterable, key=None, reverse=False):内置函数,不修改原列表,分配并返回一个排好序的全新列表。lst.reverse():就地反转原列表中的元素,返回值为None。
# 演示:sort 原地排序 vs sorted 全新副本
nums = [40, 10, 30, 20]

# 正确做法 1:原地排序
nums.sort()
print(nums)  # 输出: [10, 20, 30, 40]

# 正确做法 2:生成新列表,原数据不动
raw = [5, 2, 8]
ordered = sorted(raw, reverse=True)
print(ordered) # 输出: [8, 5, 2]
print(raw)     # 输出: [5, 2, 8] (保持原状)
四、字符串与列表的互转与组合实战
在实际业务中,数据往往以字符串形式输入,经由列表清洗加工后,再合并回格式化字符串输出。熟练运用二者的桥梁方法,能够大幅精简代码量。
1. 字符串转列表
- 按分隔符拆分为词项列表:
"apple,banana,cherry".split(",")$\to$['apple', 'banana', 'cherry']。 - 打散为单字符列表:
list("Hello")$\to$['H', 'e', 'l', 'l', 'o']。
2. 列表转字符串(严格注意元素类型)
join() 要求列表内的所有元素必须全部是字符串类型。如果列表中包含整型、浮点型或 None,直接执行 ",".join([1, 2, 3]) 会直接抛出 TypeError: sequence item 0: expected str instance, int found。
# 混合类型列表转字符串的安全写法:配合生成器表达式
data = [101, "Success", 200, True]
result = " | ".join(str(item) for item in data)
print(result) # 输出: 101 | Success | 200 | True
五、高频踩坑场景与避坑清单
避坑 1:在循环遍历列表时直接删除元素
当使用 for item in lst: 循环并调用 lst.remove(item) 时,底层索引计数器每次自增 1,但删除元素后后续元素立即左移,导致下一个紧挨着的元素被跳过漏判。解决方案: 使用列表推导式生成新列表(如 lst = [x for x in lst if not condition(x)]),或遍历其浅拷贝切片 for item in lst[:]:。
避坑 2:写出 lst = lst.sort() 导致变量变 None
因为 lst.sort() 是原地修改且返回 None,一旦将其重新赋值给原变量,原列表对象将被丢弃,变量变为 None。若要赋值,务必使用 lst = sorted(lst)。
避坑 3:在循环中频繁用 += 拼接超大字符串
由于字符串不可变,每次 s += chunk 都会重新申请内存并复制历史所有字符,时间复杂度为 $O(N^2)$。当数据量较大时,应先将数据追加进列表 chunks.append(chunk),循环结束后一次性调用 "".join(chunks)(时间复杂度 $O(N)$)。
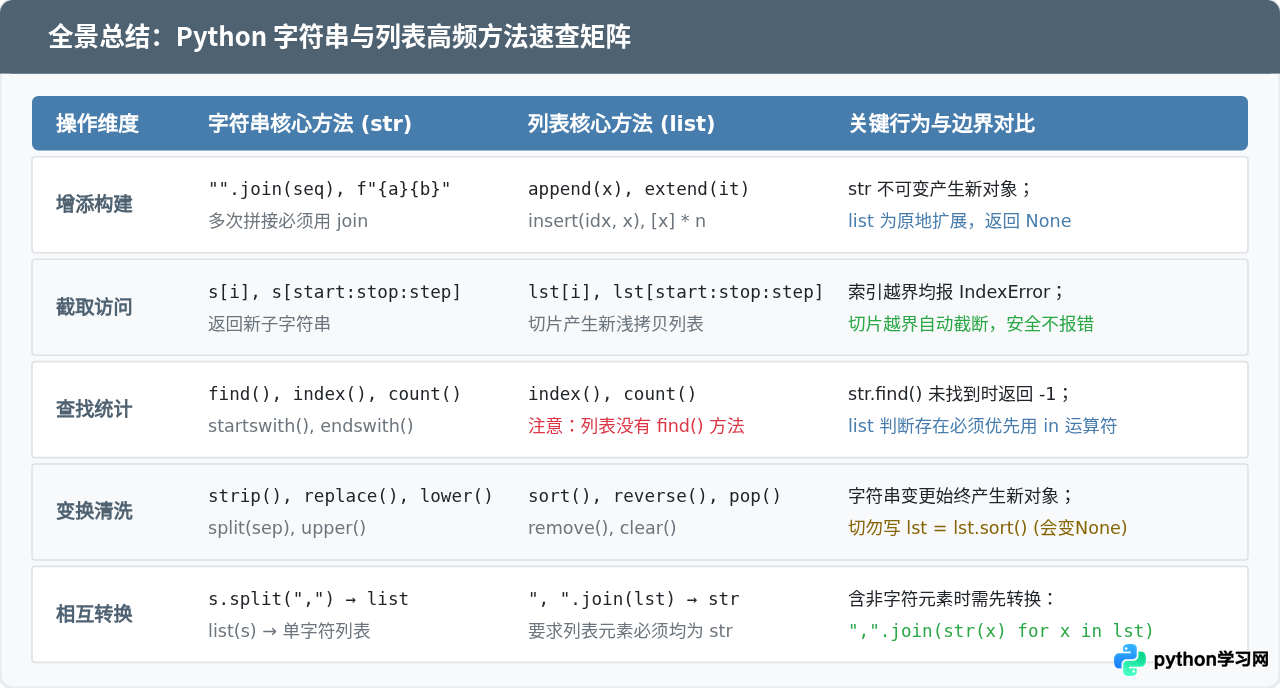
六、全景速查矩阵
最后,将字符串与列表最核心的操作维度、方法名、返回值与边界特性归纳为全景速查矩阵,便于日常编码对比查阅。
| 操作场景 | 推荐方法 / 表达式 | 返回值特性 | 典型时间复杂度 |
|---|---|---|---|
| 去除首尾空白 | s.strip() |
返回新字符串 | $O(N)$ |
| 子串安全检索 | s.find(sub) |
返回索引,不存在返回 -1 | $O(N)$ |
| 拆分与拼接 | s.split(sep) / sep.join(seq) |
返回列表 / 返回新字符串 | $O(N)$ |
| 列表尾部增删 | lst.append(x) / lst.pop() |
返回 None / 返回弹出项 | $O(1)$ |
| 列表排序 | lst.sort() / sorted(lst) |
原地修改为 None / 返回全新排序列 | $O(N \log N)$ |
| 列表成员检验 | val in lst |
返回布尔值 True / False | $O(N)$ |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









