

Python使用openpyxl读取含合并单元格的Excel数据
本文深入讲解在Python中使用openpyxl读取含合并单元格Excel文件的核心逻辑与实现方案。通过剖析Cell与MergedCell的底层存储机制,提供坐标映射反查、就地正向填充两种高复用代码实现,并指出只读模式限制与多维度避坑指南。
openpyxl 库遍历工作表时会发现:除了合并区域左上角的第一格能够正常读出数据外,其余从属单元格返回的数值全部是 None。本文将直击该现象背后的底层存储原理,提供两种即考即用的数据还原方案,并梳理工程落地中的关键避坑点。
一、底层原理:为什么直接读取会得到 None?
要解决合并单元格的读取问题,首先需要理解 Office OpenXML 标准以及 openpyxl 的内存管理机制。在 Excel 文件内部,合并单元格并非将多个物理网格融合成一个物理大网格,而是一种展示层的视图规则。
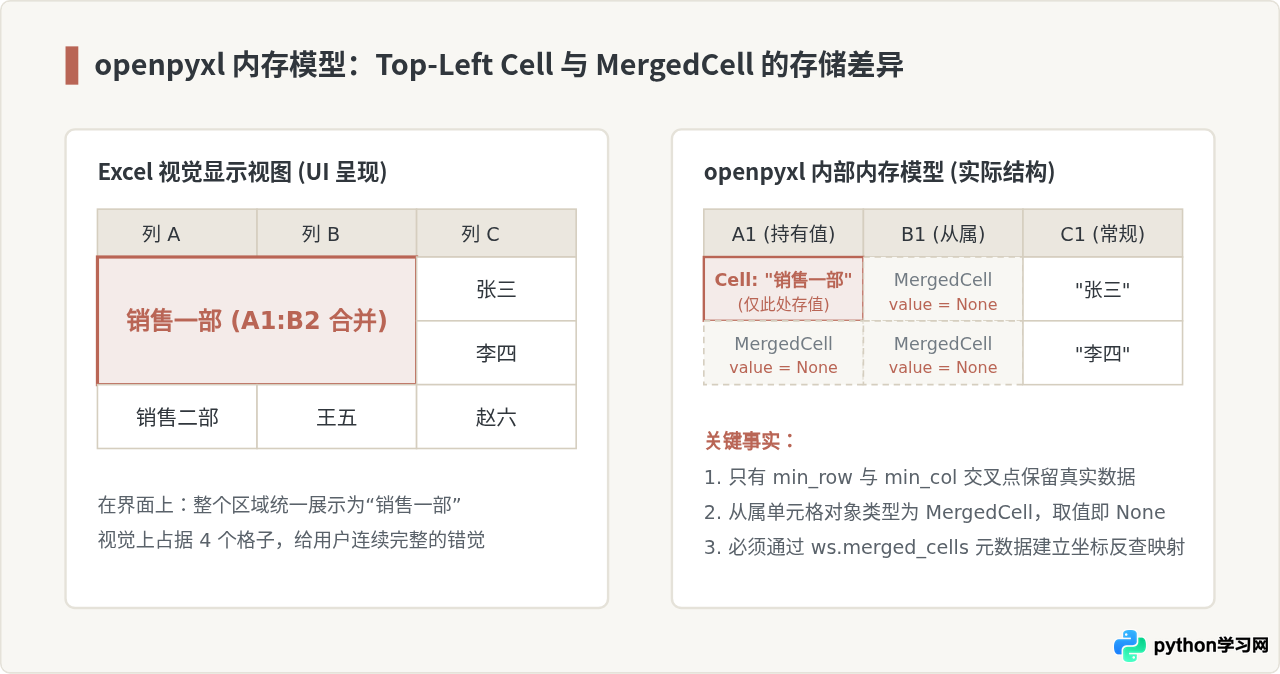
当你在 Excel 中将 A1:B2 四个单元格合并并填入文本“销售一部”时,底层 XML 文件的实际动作是:
- 仅在左上角坐标(Top-Left Cell,即
A1)的节点中写入值"销售一部"。 - 在工作表末尾追加一条合并区域声明
<mergeCell ref="A1:B2"/>。 - 其余被覆盖的从属单元格(
B1、A2、B2)在底层数据节点中没有独立的值内容。
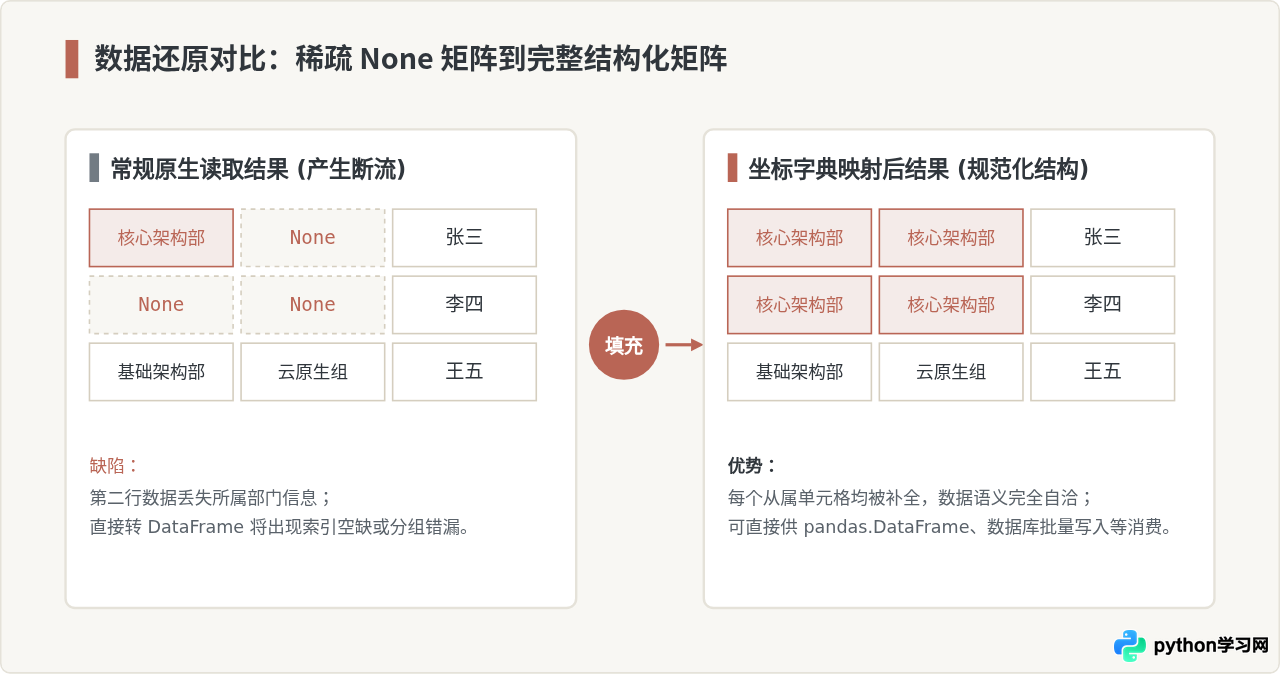
当 openpyxl 加载工作簿时,左上角的 A1 实例化为一个标准的 Cell 对象,其 value 属性持有该字符串;而 B1、A2、B2 在内存中则被标记为 MergedCell 实例。MergedCell 是一个特殊的只读占位对象,其 value 永远固定为 None。如果你直接按照普通的二维循环 ws.iter_rows(values_only=True) 读取,得到的将是一个充满 None 的稀疏矩阵,直接传递给下游的 Pandas 或入库脚本必然导致数据断流。
二、核心属性:ws.merged_cells 与 CellRange 对象
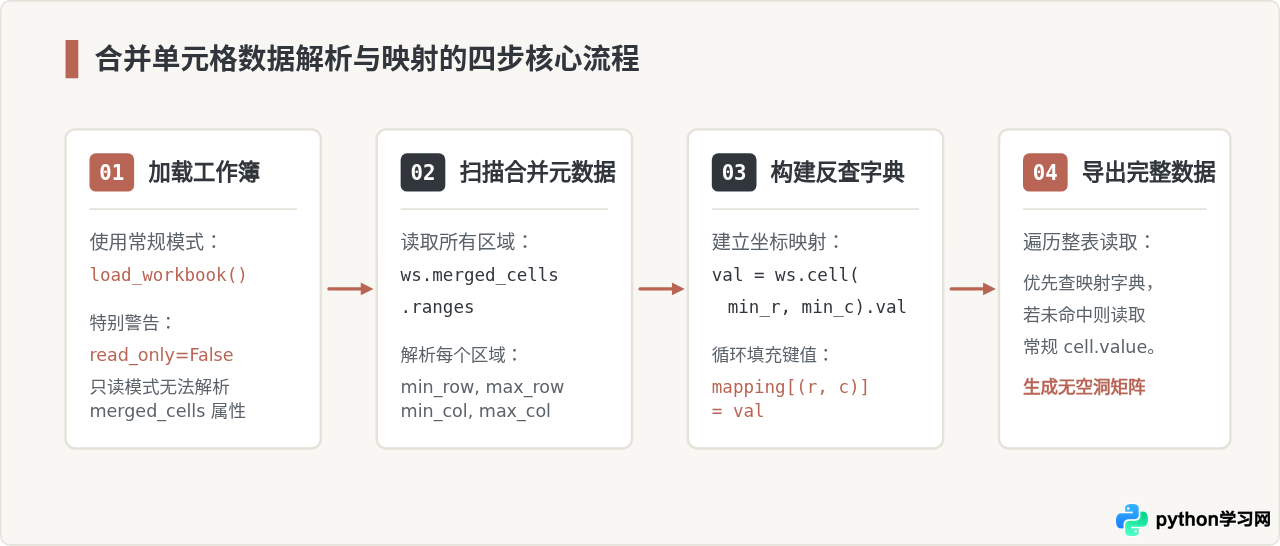
既然数据只在左上角,要完整还原表格,核心逻辑就是:只要定位到某个单元格处于合并区域内,就直接提取该合并区域左上角的值来代替当前的 None。
openpyxl 的 Worksheet 对象提供了一个属性:ws.merged_cells.ranges。它是一个包含所有合并区域的集合,其中每一个元素都是一个 openpyxl.worksheet.cell_range.CellRange 对象。
CellRange 具有几个极度关键的属性:
min_row/max_row:合并区域起始与结束的行号(从 1 开始计)。min_col/max_col:合并区域起始与结束的列号(从 1 开始计)。coord:字符串表示形式,如"A1:B2"。start_cell:左上角首个单元格的坐标标识,如"A1"。- 成员判断:
(row, col) in cell_range或cell in cell_range,支持快速判断指定坐标是否落在该区间内。
三、通用解决方案与完整代码实现
在工程实践中,推荐采用“预构建坐标映射字典”的方法。这种做法的时间复杂度为 $O(M + R \times C)$($M$ 为合并区域内的单元格总数,$R$ 与 $C$ 为表格行数与列数),可以在常数时间 $O(1)$ 内判断任一坐标是否属于合并单元格,并迅速完成值的替换。
完整实现代码(基于 openpyxl 3.0+)
import openpyxl
from typing import List, Any, Dict, Tuple

def get_merged_cells_value_map(sheet: openpyxl.worksheet.worksheet.Worksheet) -> Dict[Tuple[int, int], Any]:
    """
    预先扫描工作表的所有合并单元格,构建 (row, col) -> 对应真实值 的映射字典。
    注意:openpyxl 的行号与列号索引从 1 开始。
    """
    merged_value_map = {}

    # 遍历所有合并区域
    for cell_range in sheet.merged_cells.ranges:
        # 获取合并区域左上角的值
        top_left_value = sheet.cell(row=cell_range.min_row, column=cell_range.min_col).value

        # 将该合并区域内所有坐标(含左上角及所有从属单元格)绑定到该值
        for row in range(cell_range.min_row, cell_range.max_row + 1):
            for col in range(cell_range.min_col, cell_range.max_col + 1):
                merged_value_map[(row, col)] = top_left_value

    return merged_value_map

def read_excel_with_merged_cells(file_path: str, sheet_name: str = None) -> List[List[Any]]:
    """
    读取含合并单元格的 Excel 文件,并输出规整的二维嵌套列表数据。
    """
    # 严禁使用 read_only=True,否则无法获取 sheet.merged_cells
    wb = openpyxl.load_workbook(file_path, data_only=True)

    sheet = wb[sheet_name] if sheet_name else wb.active

    # 步骤 1:构建合并单元格坐标映射表
    merged_map = get_merged_cells_value_map(sheet)

    # 步骤 2:逐行逐列提取数据并填充
    result_data = []
    for row in range(1, sheet.max_row + 1):
        row_data = []
        for col in range(1, sheet.max_column + 1):
            if (row, col) in merged_map:
                # 命中合并单元格,使用左上角广播出来的真实值
                row_data.append(merged_map[(row, col)])
            else:
                # 普通独立单元格,直接读取自身数值
                row_data.append(sheet.cell(row=row, column=col).value)
        result_data.append(row_data)

    wb.close()
    return result_data

# ================= 示例演示 =================
if __name__ == "__main__":
    # 假设待读取的 Excel 路径为 "sample_data.xlsx"
    # 表格内容为:
    # A1:B2 合并,内容为 "核心架构部"
    # C1="张三", C2="李四"
    # A3="基础架构部", B3="云原生组", C3="王五"
    data = read_excel_with_merged_cells("sample_data.xlsx")

    print("【示例运行结果输出】:")
    for row in data:
        print(row)

    # 示例输出展示:
    # ['核心架构部', '核心架构部', '张三']
    # ['核心架构部', '核心架构部', '李四']
    # ['基础架构部', '云原生组', '王五']
在上面的代码中,load_workbook 传入了 data_only=True。这是一个非常实用的参数:如果合并单元格中的内容本身是由公式计算得出的,开启 data_only=True 可以直接读取出公式计算后的静态值,而不是返回公式字符串(如 =CONCATENATE(...))。
四、工程落地中的四大高频深坑
避坑核心提醒:处理 Excel 合并单元格不仅是写一个简单算法,还要注意 openpyxl 在特定模式下的特性缺失与性能瓶颈。
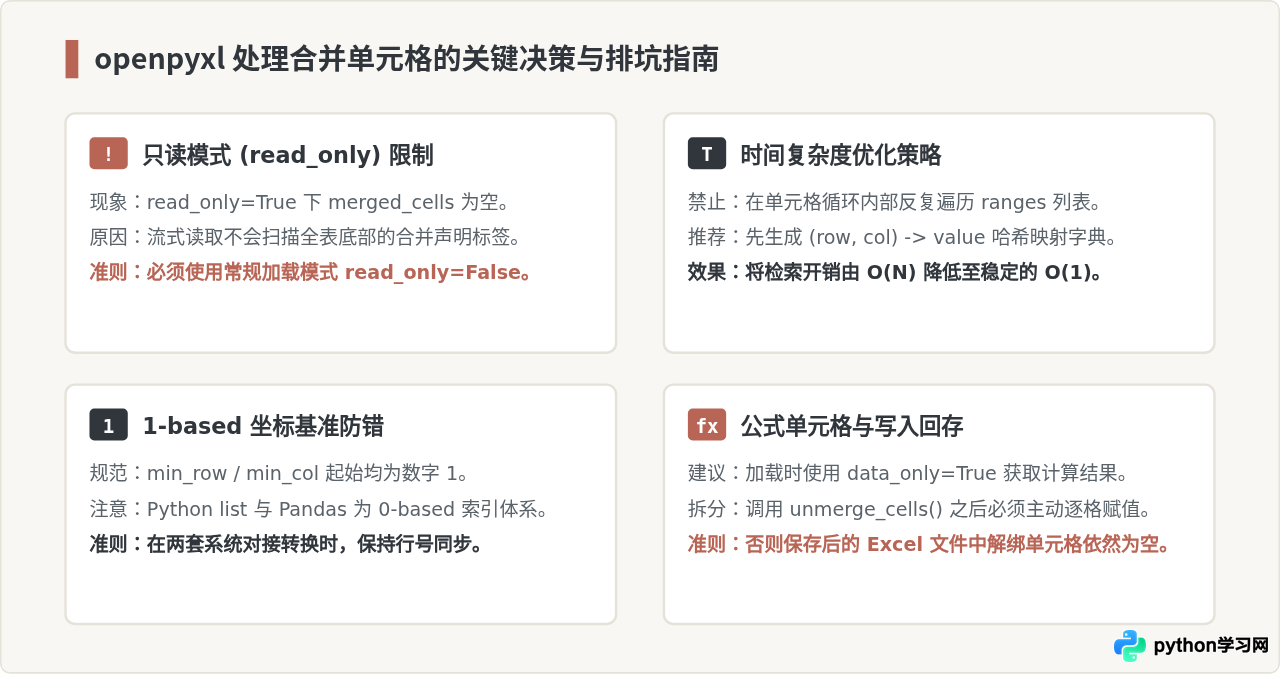
1. 致命限制:read_only 模式下 merged_cells 失效
面对几十兆的大文件时,很多工程师习惯传入 read_only=True 开启流式读取以减少内存占用。然而,在只读模式下,openpyxl 不会解析合并单元格的元数据!此时 sheet.merged_cells 要么返回空列表,要么直接抛出 AttributeError 或产生不可预期的行为。如果文件包含合并单元格且必须进行还原,必须保持 read_only=False,或采用解压缩底层 XML 文件的流式处理方案。
2. 性能陷阱:切勿在双层循环中进行线性扫描
初学者经常写出如下代码:
# 【反模式】:极度缓慢的 O(R * C * M) 实现
for row in sheet.iter_rows():
    for cell in row:
        for rng in sheet.merged_cells.ranges:
            if cell.coordinate in rng:
                # 这样做在包含几千行、数百个合并单元格的表格中会发生严重卡顿
                val = sheet.cell(rng.min_row, rng.min_col).value
上述写法的复杂度高达 $O(行数 \times 列数 \times 合并区数)$。必须像前文方案那样,在循环前单次遍历 sheet.merged_cells.ranges 构建哈希字典,将查找时间降为稳定的 $O(1)$。
3. 索引偏移:1-based 与 0-based 混淆
openpyxl 的坐标系统全部以 1 为起始(第 1 行、第 1 列)。而 Python 原生的 range(len(...))、列表切片以及 Pandas 均为 0 为起始。在计算坐标映射时,切记 min_row 到 max_row + 1 需要严格遵循 1-based 逻辑,切勿自行减 1 导致索引错位。
4. 反向操作:解绑单元格与写入保存
如果业务需求不仅是读取,还包括“将合并单元格拆分为普通单元格并回写 Excel”,则可以使用 sheet.unmerge_cells() 方法。需要注意的是:解绑后,原来的从属单元格依然是空的,必须显式地对解绑后的每个单元格执行赋值操作 sheet.cell(r, c).value = top_left_value,随后调用 wb.save(),才能确保在 Excel 软件打开时每个单元格都有独立数值。
五、总结与选择建议
| 场景需求 | 推荐处理方式 | 关键代码或注意事项 |
|---|---|---|
| 全量数据提取并转为表格 | 预建字典法,统一替换 None |
扫描 ws.merged_cells.ranges 构建 (row, col) 哈希表 |
| 特定单个单元格查询 | 直接判断所属 CellRange |
(row, col) in cell_range,命中了直接取其左上角 |
| 数据清洗后回写 Excel | 解绑合并区域并填充值 | ws.unmerge_cells() 后显式赋值,再调用 wb.save() |
| 大体量文件(几万行以上) | 权衡内存使用 | 不可盲目使用 read_only=True,建议按分表或批次加载 |
综上所述,Python 使用 openpyxl 读取合并单元格的核心不是去寻找“一个能够自动合并读取的特殊参数”,而是理解底层 OpenXML 规范对数据的分布设计,并通过 ws.merged_cells.ranges 元数据将从属单元格主动映射回其左上角的数据源。掌握这一机制后,无论面对跨行合并、跨列合并还是复杂的块状合并,都能以稳定高效的工程方式输出规整完整的数据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









