

Python怎么递归遍历嵌套字典提取深层数据
详细讲解在Python中使用递归遍历任意层级嵌套字典与列表结构的方法,涵盖键值提取、路径回溯、混合数据结构展开及循环引用防范。
在处理后端接口返回的复杂 JSON、解析配置文件或清洗抓取的半结构化数据时,常常会遇到层级深不可测、结构不规则的多层嵌套字典。如果直接使用 data['result']['items'][0]['detail']['target_key'] 这种硬编码链式键访问,不仅遇到某一层键缺失或格式变化时会抛出恼人的 KeyError 或 IndexError,而且面对动态层级更无从下手。解决此类问题的核心思路是编写递归函数:将字典视作一棵树,在每一层检查当前键值对,若值是子字典或列表则再次调用自身向深处延伸,若命中目标键或到达叶子节点则记录数据并返回。
一、理解嵌套字典的树形结构与递归基准
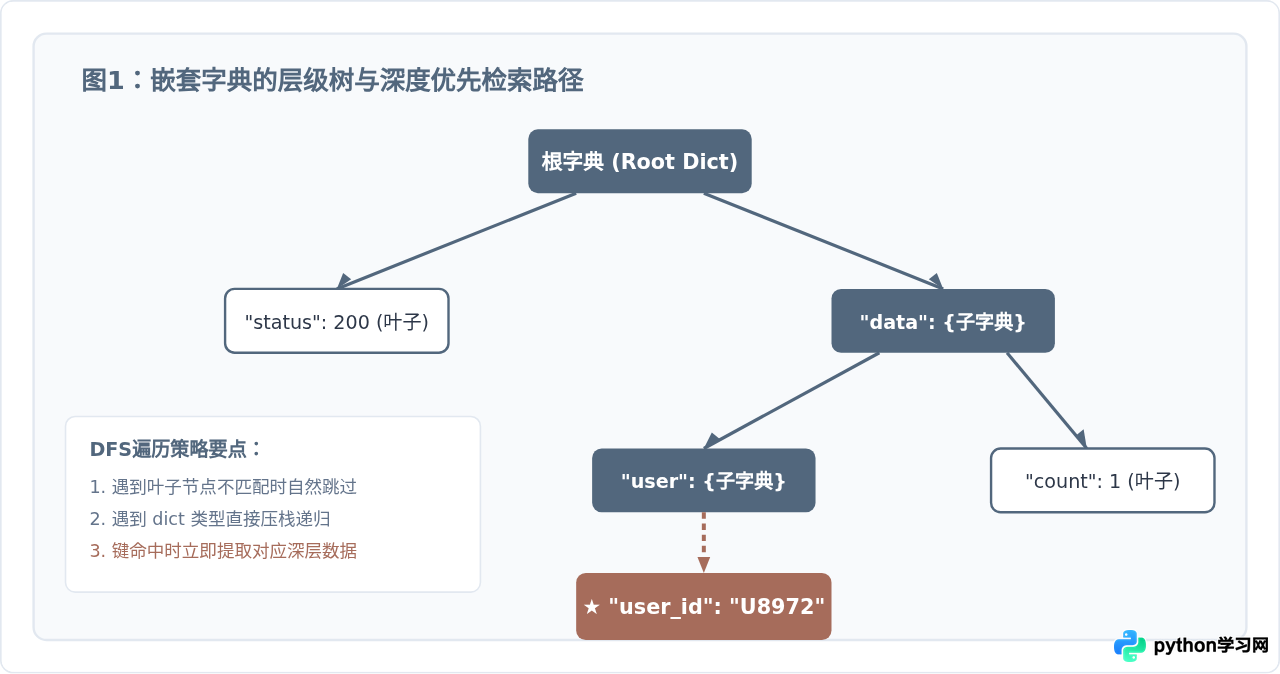
嵌套字典本质上是一种具有层次结构的有向无环图或树形结构。根节点是最外层的字典对象,中间节点是包含下级字典或列表的值,叶子节点则是字符串、整数、浮点数或布尔值等基本类型。当我们想要从中提取某个深层字段时,遍历过程实际上就是在进行树的“深度优先搜索(DFS)”。
一个标准的递归函数必须包含两个核心要素:基准条件(Base Case)和递归推进(Recursive Step)。在嵌套字典遍历中:
- 递归推进:当前对象依然是字典(
isinstance(obj, dict))时,调用.items()逐个检查键与值,并将下层子字典送入递归函数继续展开。 - 基准条件:检查当前键是否等于目标键。若匹配成功,则提取其值;若当前值已是基本数据类型且不再包含容器,则停止向下深入并自然返回。
下面是一个最直接、实用的基础递归实现,用于从任意深度的纯字典结构中提取所有与指定目标键匹配的值:
def find_values_in_dict(target_dict, target_key):
    """
    递归遍历纯字典结构,提取所有匹配 target_key 的深层数据
    """
    results = []

    # 遍历当前层级的每一个键值对
    for key, value in target_dict.items():
        # 如果命中目标键,加入结果列表
        if key == target_key:
            results.append(value)

        # 如果当前值依旧是字典,递归深入查找
        if isinstance(value, dict):
            sub_results = find_values_in_dict(value, target_key)
            results.extend(sub_results)

    return results

# 测试数据
nested_profile = {
    "organization": "OpenTech",
    "meta": {
        "creator": "admin",
        "details": {
            "user_id": "U1001",
            "contact": {
                "user_id": "U1002_BACKUP",
                "email": "dev@example.com"
            }
        }
    }
}

# 示例调用
matched_ids = find_values_in_dict(nested_profile, "user_id")
print("提取到的user_id列表:", matched_ids)
# 示例输出:['U1001', 'U1002_BACKUP']
二、递归执行流程与调用栈推进过程
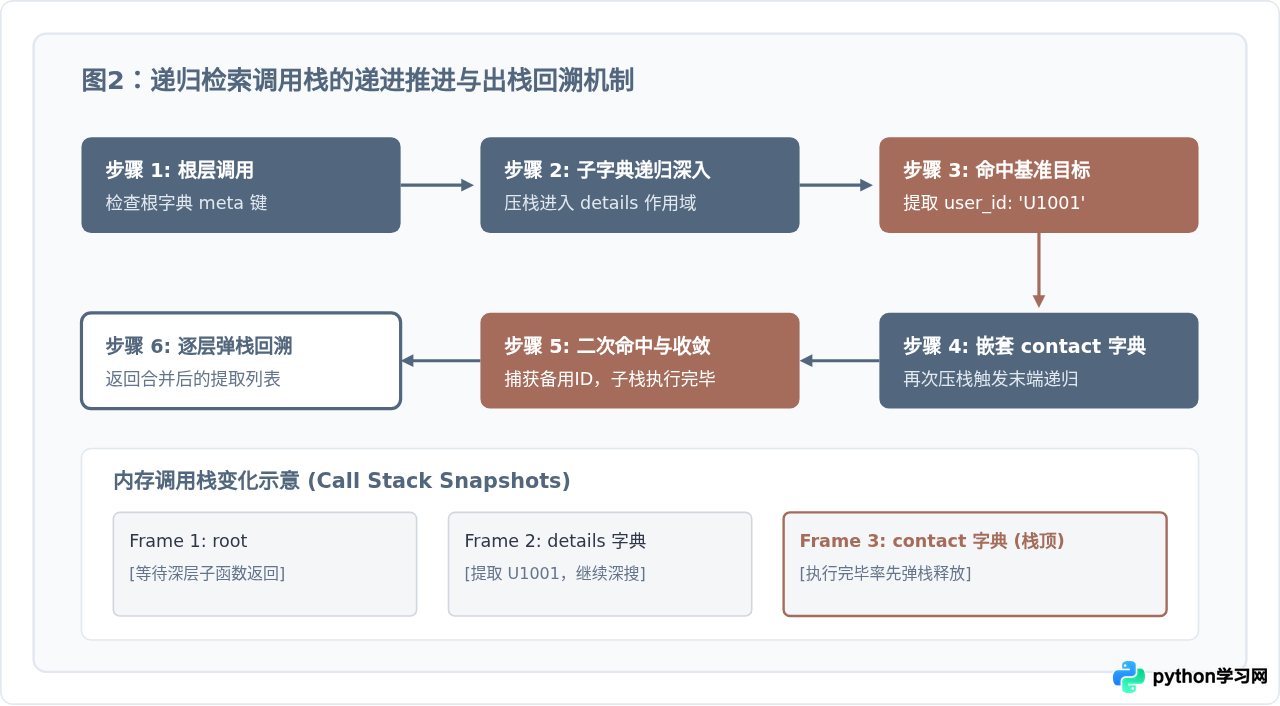
许多初学者在使用递归时容易感到困惑,关键在于对“函数调用栈(Call Stack)”与“回溯(Backtracking)”缺乏直观感知。当我们在顶层调用递归函数时,Python 解释器会为每次函数调用开辟一个栈帧(Stack Frame)。遇到子字典后,当前执行上下文被暂时保留在栈中,程序进入新的子栈帧;直到最内层的子字典遍历完毕,返回值才会逐层向上传递并合并。
在很多业务场景中,仅仅获取到值是不够的,我们通常还需要明确知道这个值处于哪一条嵌套路径上。利用递归的传参机制,我们可以非常优雅地维护一个路径元组(Path Tuple)或路径列表,随着递归向深层延伸而递增,回溯时自动恢复:
def find_keys_with_path(target_dict, target_key, current_path=()):
    """
    不仅提取值,同时返回完整深层访问路径的递归实现
    """
    results = []

    for key, value in target_dict.items():
        new_path = current_path + (key,)

        # 命中目标,同时记录当前路径与值
        if key == target_key:
            results.append({
                "path": " -> ".join(map(str, new_path)),
                "raw_path": new_path,
                "value": value
            })

        # 递归传递包含当前键的路径元组
        if isinstance(value, dict):
            sub_results = find_keys_with_path(value, target_key, new_path)
            results.extend(sub_results)

    return results

# 运行验证
path_results = find_keys_with_path(nested_profile, "user_id")
for item in path_results:
    print(f"路径: {item['path']} | 取值: {item['value']}")
# 示例输出:
# 路径: meta -> details -> user_id | 取值: U1001
# 路径: meta -> details -> contact -> user_id | 取值: U1002_BACKUP
三、应对复杂场景:混合嵌套列表与生成器优化
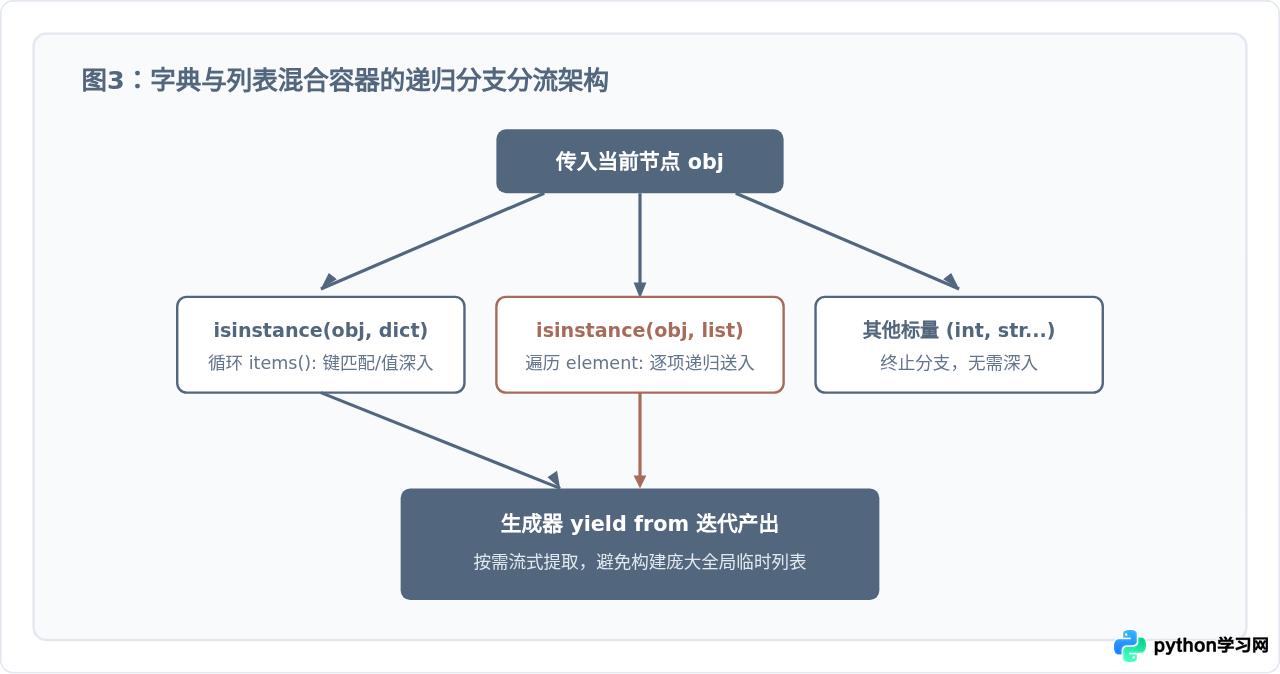
真实的生产数据往往不是单纯的“字典套字典”,绝大多数情况下是字典与列表深度穿插的混合结构。例如一个电商订单可能是一个字典,包含一个商品数组 "items": [...],每个数组元素又是一个包含规格参数的独立字典。如果递归函数只判断 isinstance(value, dict),那么一旦遇到列表,其内部的深层数据就会被直接漏掉。
为了构建健壮的提取逻辑,我们需要在递归分支中对 list / tuple 类型进行分流处理;同时,若数据集体量庞大,使用列表暂存容易占用过多内存,改用 Python 的 yield 与 yield from 语法可以实现惰性计算的生成器。
以下是具备工业级兼容性的通用提取函数。它不仅支持字典嵌套列表的任意组合,还通过生成器实现了内存友好的流式迭代:
def extract_deep_values(data, target_key):
    """
    通用生成器:支持任意嵌套深度的字典与列表混合数据提取
    """
    if isinstance(data, dict):
        for key, value in data.items():
            if key == target_key:
                yield value
            # 无论子项是字典还是列表,直接交由下级生成器展开
            if isinstance(value, (dict, list)):
                yield from extract_deep_values(value, target_key)

    elif isinstance(data, list):
        for element in data:
            if isinstance(element, (dict, list)):
                yield from extract_deep_values(element, target_key)

# 模拟真实的复杂混合 JSON 响应
api_response = {
    "status": "success",
    "payload": {
        "orders": [
            {
                "order_id": "ORD_001",
                "products": [
                    {"sku": "SKU-RED-S", "price": 49.9},
                    {"sku": "SKU-BLUE-M", "price": 59.9}
                ]
            },
            {
                "order_id": "ORD_002",
                "products": [
                    {"sku": "SKU-BLACK-L", "price": 99.0}
                ]
            }
        ]
    }
}

# 流式获取所有 sku
all_skus = list(extract_deep_values(api_response, "sku"))
print("提取到的全部SKU:", all_skus)
# 示例输出:['SKU-RED-S', 'SKU-BLUE-M', 'SKU-BLACK-L']
四、边界条件与性能防护
在编写递归代码时,有两个致命陷阱必须加以防范:无限循环引用与递归调用栈溢出。
- 循环引用(Circular Reference):如果 Python 对象的某个内层键引用了它自身或父级对象(例如
a['self'] = a),递归将陷入无休止的自我调用,直到抛出RecursionError: maximum recursion depth exceeded。防范手段是在递归过程中维护一个visited集合,记录已访问对象的id(obj)。 - 递归深度限制:Python 默认的最大递归调用深度一般为 1000(可通过
sys.getrecursionlimit()查看)。如果处理的是极其极端的极端深度数据,可以考虑改写为显式循环配合自定义栈(Stack)的广度优先或非递归深度优先算法。
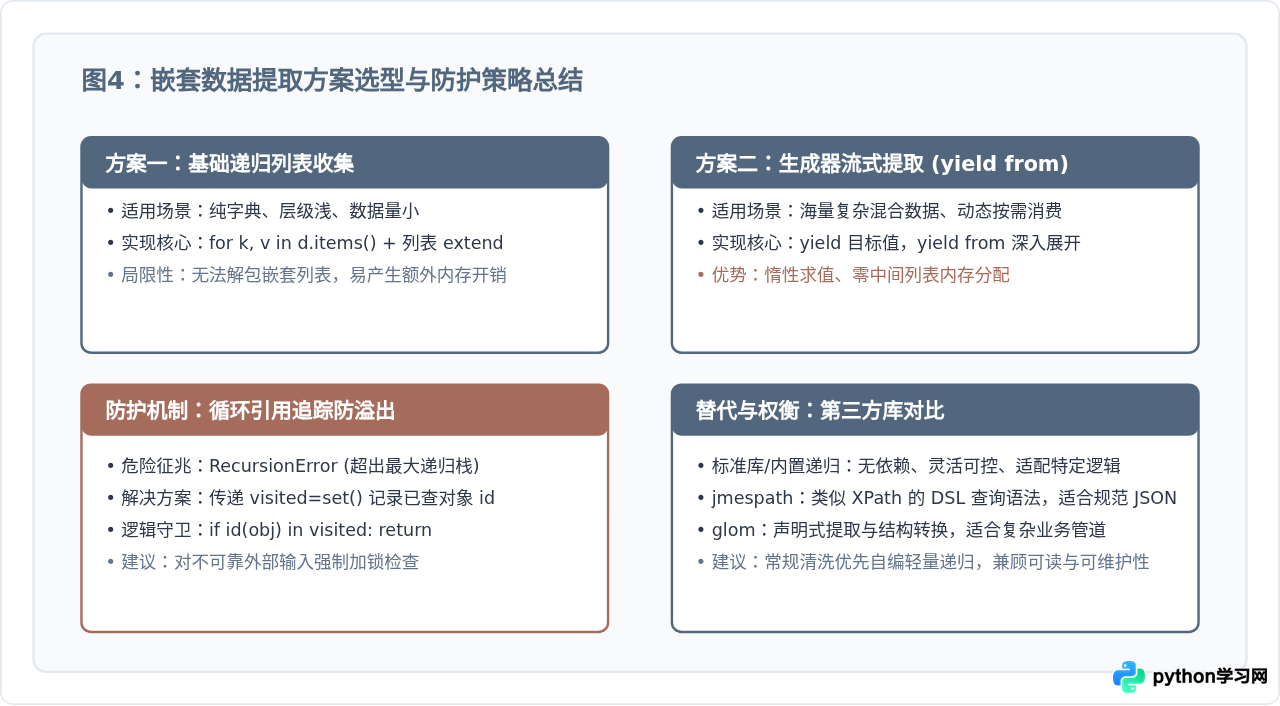
带循环引用防护的完整安全代码如下:
def safe_extract_values(data, target_key, visited=None):
    """
    带有循环引用防护的安全深层数据提取生成器
    """
    if visited is None:
        visited = set()

    obj_id = id(data)
    if obj_id in visited:
        return
    visited.add(obj_id)

    if isinstance(data, dict):
        for key, value in data.items():
            if key == target_key:
                yield value
            if isinstance(value, (dict, list)):
                yield from safe_extract_values(value, target_key, visited)

    elif isinstance(data, list):
        for item in data:
            if isinstance(item, (dict, list)):
                yield from safe_extract_values(item, target_key, visited)

# 构造一个包含自引用的危险字典
circular_dict = {"name": "node_A", "target": "FOUND_A"}
child_dict = {"name": "node_B", "target": "FOUND_B", "parent": circular_dict}
circular_dict["child"] = child_dict  # 制造循环引用

# 安全提取,不会崩溃死循环
results = list(safe_extract_values(circular_dict, "target"))
print("安全提取结果:", results)
# 示例输出:['FOUND_A', 'FOUND_B']
掌握了这一套自顶向下的递归遍历与容器分流机制后,无论面对十层还是百层的非标准嵌套结构,都能轻松、精确地提取出深层目标字段,让杂乱的数据解析工作变得清晰而稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









