

Python基础语法练习题集与标准答案
精选Python基础语法核心练习题集与标准答案,涵盖变量类型、控制流、函数定义与内置数据结构,配备详细代码解析与图解。
在掌握Python基础概念后,许多初学者会面临“看懂了教程却写不出程序”的困境。巩固语法的最佳途径不是死记规则,而是针对核心机制进行实操编码。本文梳理了变量与运算、流程控制、常用数据结构及函数封装四个维度的典型练习题,并附带规范实现与解析,帮助你在动手编写中夯实Python基础语法。
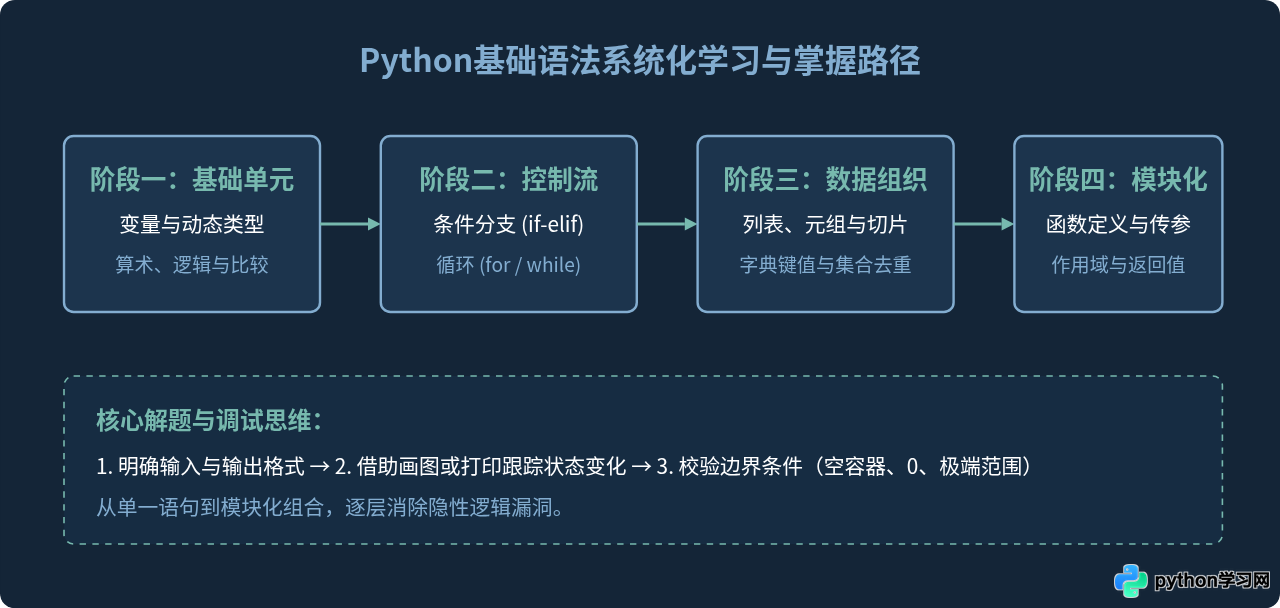
一、变量定义、类型转换与基本运算
在Python中,变量无需显式声明类型,赋值即绑定。理解基本数据类型(整数 int、浮点数 float、字符串 str、布尔值 bool)之间的转换与运算特性是编写可靠逻辑的前提。
练习题 1:温度单位换算与格式化输出
题目描述:编写一个程序,接收摄氏温度数值(浮点数),将其转换为华氏温度并输出。转换公式为:F = C * 1.8 + 32。输出结果需保留两位小数,并使用格式化字符串呈现。
标准答案:
# 标准实现
celsius = 26.5
fahrenheit = celsius * 1.8 + 32
print(f"摄氏度 {celsius:.2f}°C 对应华氏度为 {fahrenheit:.2f}°F")
示例输出:
摄氏度 26.50°C 对应华氏度为 79.70°F解析与注意点:使用 f-string(格式化字符串字面量)配合 :.2f 说明符可精确控制浮点数输出位数。直接进行算术运算时,Python会自动提升类型为浮点数。
练习题 2:商与余数的提取
题目描述:给定总秒数 total_seconds = 7384,计算其折合为多少小时、多少分钟及剩余秒数,分别存入变量 hours、minutes、seconds 并打印。
标准答案:
total_seconds = 7384

hours = total_seconds // 3600
remaining = total_seconds % 3600
minutes = remaining // 60
seconds = remaining % 60

print(f"{total_seconds} 秒等于 {hours} 小时 {minutes} 分钟 {seconds} 秒")解析与注意点:注意整除运算符 // 与求模运算符 % 的配合。也可以使用内置函数 divmod() 分步获取商和余数:hours, remaining = divmod(total_seconds, 3600)。
二、流程控制:条件判断与循环结构
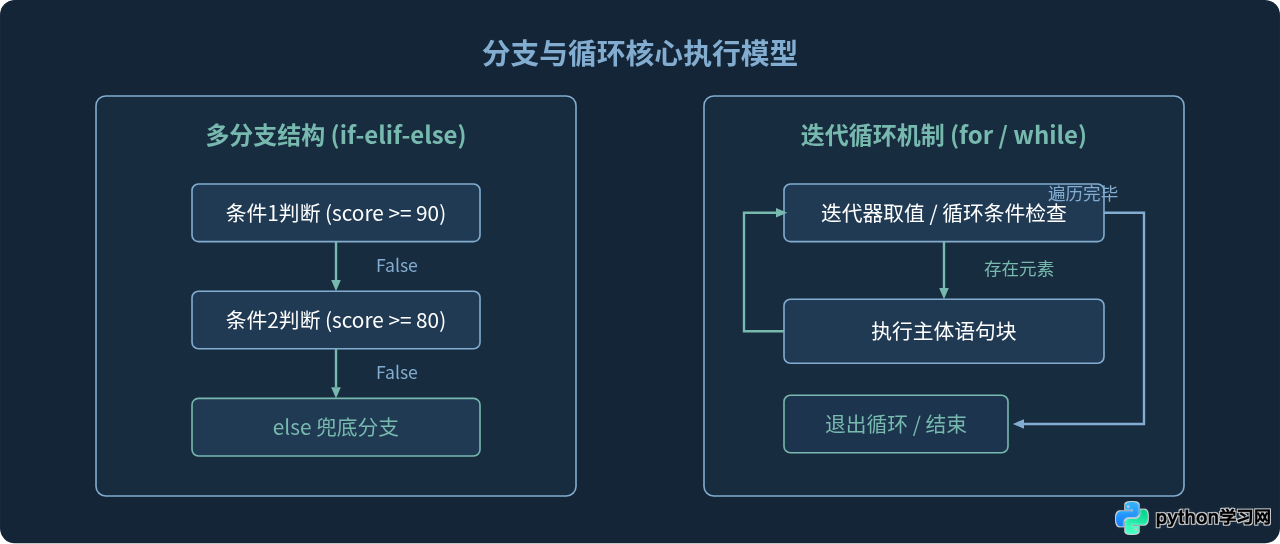
条件分支负责根据不同状态导向不同分支,循环结构负责重复处理相同范式的数据。初学者常在缩进、多分支判定优先级以及循环跳出条件上产生偏差。
练习题 3:多条件成绩评级系统
题目描述:根据输入的整数分数(0到100),输出对应的评级。规则如下:90分及以上为"A",80到89分为"B",70到79分为"C",60到69分为"D",60分以下为"F"。若输入超出0到100的范围,输出"无效分数"。
标准答案:
def evaluate_grade(score):
    if not (0 <= score <= 100):
        return "无效分数"
    elif score >= 90:
        return "A"
    elif score >= 80:
        return "B"
    elif score >= 70:
        return "C"
    elif score >= 60:
        return "D"
    else:
        return "F"

# 验证测试
test_scores = [95, 82, 60, 45, 105]
for s in test_scores:
    print(f"分数 {s}: {evaluate_grade(s)}")
示例输出:
分数 95: A
分数 82: B
分数 60: D
分数 45: F
分数 105: 无效分数
练习题 4:累加与条件过滤(FizzBuzz变体)
题目描述:计算1到100(包含100)之间所有既能被3整除又能被5整除的正整数之和,并统计这类数字的个数。
标准答案:
total_sum = 0
count = 0

for num in range(1, 101):
    if num % 3 == 0 and num % 5 == 0:
        total_sum += num
        count += 1

print(f"符合条件的数量: {count}, 累加和: {total_sum}")
示例输出:
符合条件的数量: 6, 累加和: 315三、内置数据结构:列表、字典与集合
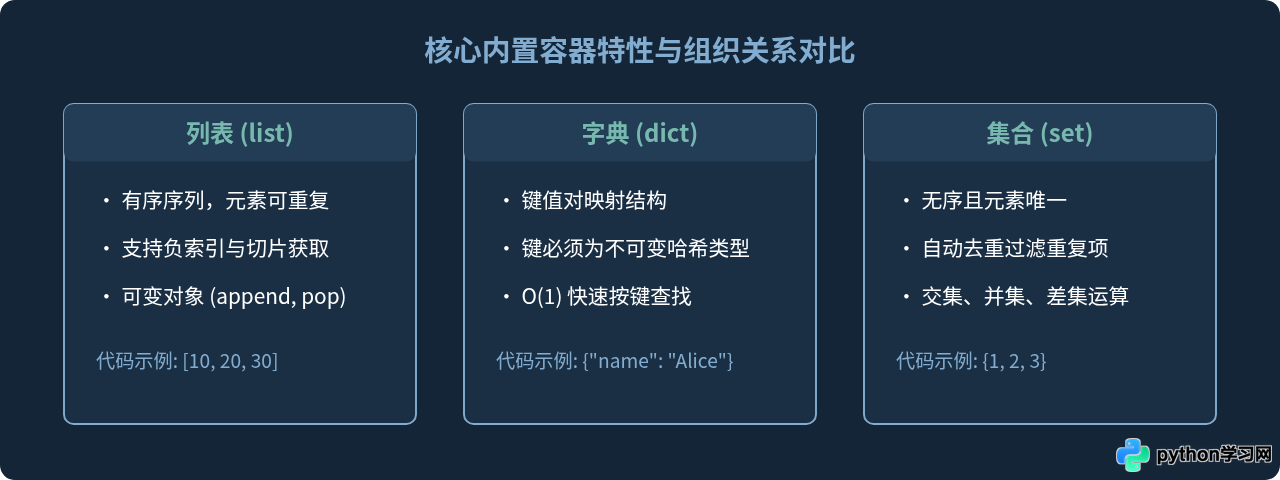
Python强大的内置容器是处理各类复合数据的基础。列表擅长有序排列与动态修改,字典支持高效的键值映射,集合则天然具备元素唯一性。
练习题 5:列表去重并保留原始顺序
题目描述:给定一个包含重复元素的列表 data = [3, 1, 2, 3, 4, 1, 5, 2],生成一个去除重复项的新列表,并保证元素首次出现的先后顺序不被破坏。
标准答案:
data = [3, 1, 2, 3, 4, 1, 5, 2]

# 方法一:利用辅助集合与列表推导
seen = set()
unique_data = []
for item in data:
    if item not in seen:
        seen.add(item)
        unique_data.append(item)

print("保留顺序去重结果:", unique_data)
示例输出:
保留顺序去重结果: [3, 1, 2, 4, 5]解析与注意点:直接使用 list(set(data)) 虽然能去重,但集合是无序的,会打乱原本的序列顺序。使用辅助集合 seen 进行成员检查(复杂度为 O(1))既保证了高效性,又保留了先后顺序。在 Python 3.7+ 中,也可以直接利用字典保序特性:list(dict.fromkeys(data))。
练习题 6:词频统计与字典映射
题目描述:统计英文短句 "apple banana apple orange banana apple" 中每个单词出现的频次,输出为一个字典。
标准答案:
sentence = "apple banana apple orange banana apple"
words = sentence.split()

frequency = {}
for word in words:
    frequency[word] = frequency.get(word, 0) + 1

print("词频统计结果:", frequency)
示例输出:
词频统计结果: {'apple': 3, 'banana': 2, 'orange': 1}解析与注意点:dict.get(key, default) 方法在键不存在时返回默认值 0,避免了抛出 KeyError 异常,是构建计数器最优雅的标准语法。
四、函数封装与参数传递
函数是将一段具有独立功能的代码块组织在一起的基本方式。编写函数时应注重参数默认值、可变参数以及明确的返回值规范。
练习题 7:回文串判断函数
题目描述:编写一个名为 is_palindrome(text) 的函数,判断输入的字符串是否为回文(正读和反读完全相同)。忽略大小写及空格,如果是回文返回 True,否则返回 False。
标准答案:
def is_palindrome(text: str) -> bool:
    # 统一转为小写并剔除空格
    cleaned = "".join(text.lower().split())
    # 利用切片反转对比
    return cleaned == cleaned[::-1]

# 测试用例
print("Madam:", is_palindrome("Madam"))
print("nurses run:", is_palindrome("nurses run"))
print("python:", is_palindrome("python"))
示例输出:
Madam: True
nurses run: True
python: False解析与注意点:字符串切片语法 [::-1] 表示步长为 -1,即整体逆序排列。通过 "".join(text.lower().split()) 可以在不引入正则表达式的前提下过滤所有空白字符并完成小写转换。
五、练习方法与避坑总结
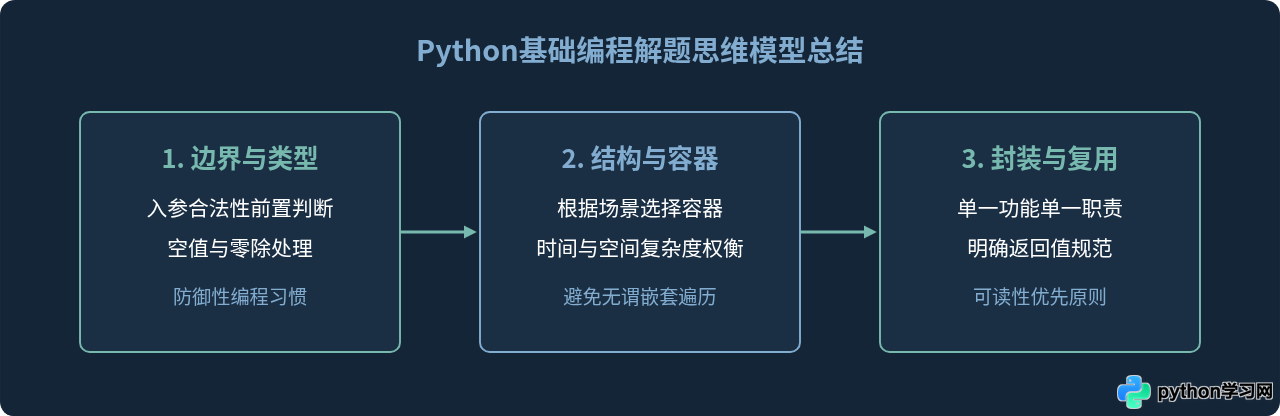
在解答基础语法题目的过程中,养成良好的调试习惯比单纯记忆代码更为重要。以下是解题时需要建立的三项核查准则:
- 边界防御:处理容器时,随时考虑输入为空列表
[]、空字典{}或字符串为空的情况;处理数值时,注意被除数为 0 的异常判断。 - 对象可变性辨析:列表与字典属于可变对象,切忌在作为函数形参时使用可变对象作为默认参数(如
def func(x=[])),应统一使用None作为占位符并在函数体内部初始化。 - 优先使用原生迭代机制:多利用
for item in iterable或enumerate(),尽量避免显式维护自增变量i += 1进行下标访问,降低越界与代码冗余风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









