

Python csv模块与pandas读取CSV性能对比

在 Python 中读取 CSV 文件时,内置的 csv 模块与第三方数据分析库 pandas(通过 read_csv 函数)是最常用的两种方案。核心的性能差异体现在:pandas 依托底层的 C 语言解析引擎与连续内存分配,在批量载入、类型推断与向量化处理时速度更快,但会占用数倍于原始文件大小的内存;而内置 csv 模块采用流式按行生成器模式,内存开销恒定且极低,但在执行全量数据类型转换或复杂分析时处理耗时较长。理解两者的底层差异与性能边界,是根据数据规模与计算需求做出正确选型的关键。
一、底层解析机制与执行路径差异
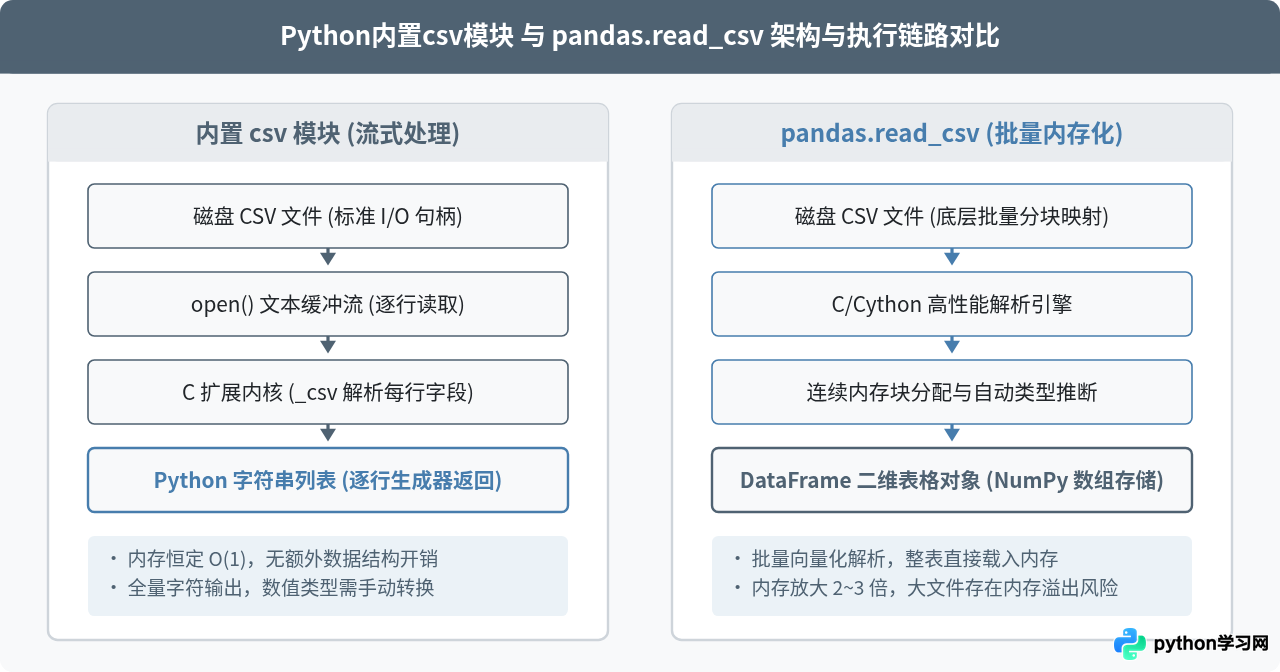
两者的性能差异并非仅是语法层面的区别,而是源于底层架构设计与数据目标结构的根本不同。内置 csv 模块的目标是通用流式文本解析,而 pandas.read_csv 的目标是构建高性能的二维结构化数据集。
使用内置 csv.reader 时,Python 打开系统文件句柄后,调用 _csv C 扩展对文本逐字符扫描。每解析完一行,它便在 Python 堆中动态创建一个新的 list 对象,其中的每个单元格均为独立的 Python 字符串(str)。这种模式下,解析器不需要推断数据类型,也不把整个文件载入内存,迭代器只维护当前行的上下文,因此空间复杂度保持在 O(1)。
与此相对,pandas.read_csv 在调用后会使用经过高度优化的 C/Cython 引擎。引擎在读取数据块(Chunk)的同时进行列类型推断(例如自动将数字字符转为 64 位整数或浮点数),并预先分配连续的 NumPy 数组内存块填充数据,最终封装为包含行索引(Index)与列名(Columns)的 DataFrame。这种批量内存化机制免去了 Python 层面的循环和大量对象分配开销,但代价是必须将整张表及其元数据常驻内存。
二、性能基准测试的设计与实施步骤
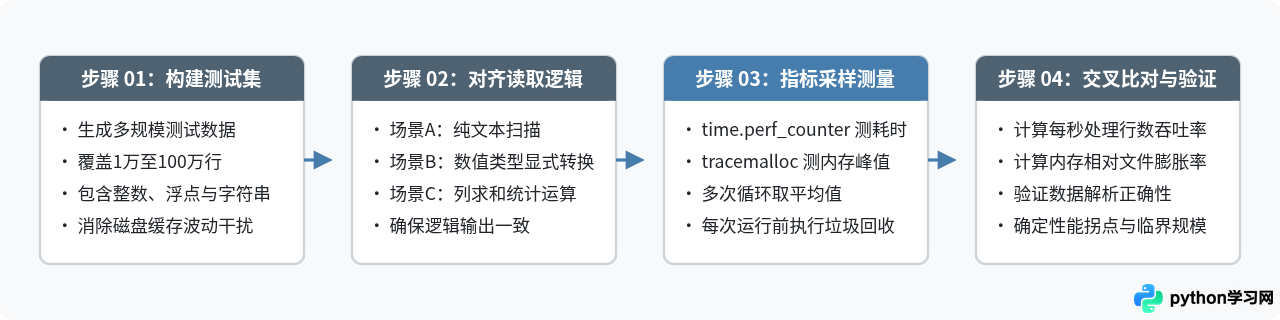
为了获得具备实际参考价值的性能数据,必须在相同的软硬件环境与标准化数据下进行对照测试。评估流程包含生成数据、设计同等业务逻辑、采样耗时与内存峰值四个步骤。
1. 基准测试代码示例
以下代码展示了用于采集两种读取方式耗时与内存峰值的完整脚本,适用于 Python 3.8+ 环境:
import csv
import gc
import time
import tracemalloc
import pandas as pd

def benchmark_csv_module(file_path):
    gc.collect()
    tracemalloc.start()
    start_time = time.perf_counter()

    total_val = 0.0
    with open(file_path, mode="r", encoding="utf-8") as f:
        reader = csv.reader(f)
        header = next(reader)
        for row in reader:
            # 模拟业务操作:提取第3列浮点数并累加
            total_val += float(row[2])

    elapsed = time.perf_counter() - start_time
    _, peak_memory = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return elapsed, peak_memory / (1024 * 1024), total_val

def benchmark_pandas(file_path):
    gc.collect()
    tracemalloc.start()
    start_time = time.perf_counter()

    # 模拟业务操作:读取文件并对第3列求和
    df = pd.read_csv(file_path)
    total_val = float(df.iloc[:, 2].sum())

    elapsed = time.perf_counter() - start_time
    _, peak_memory = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return elapsed, peak_memory / (1024 * 1024), total_val
三、执行时间与内存开销实测对比
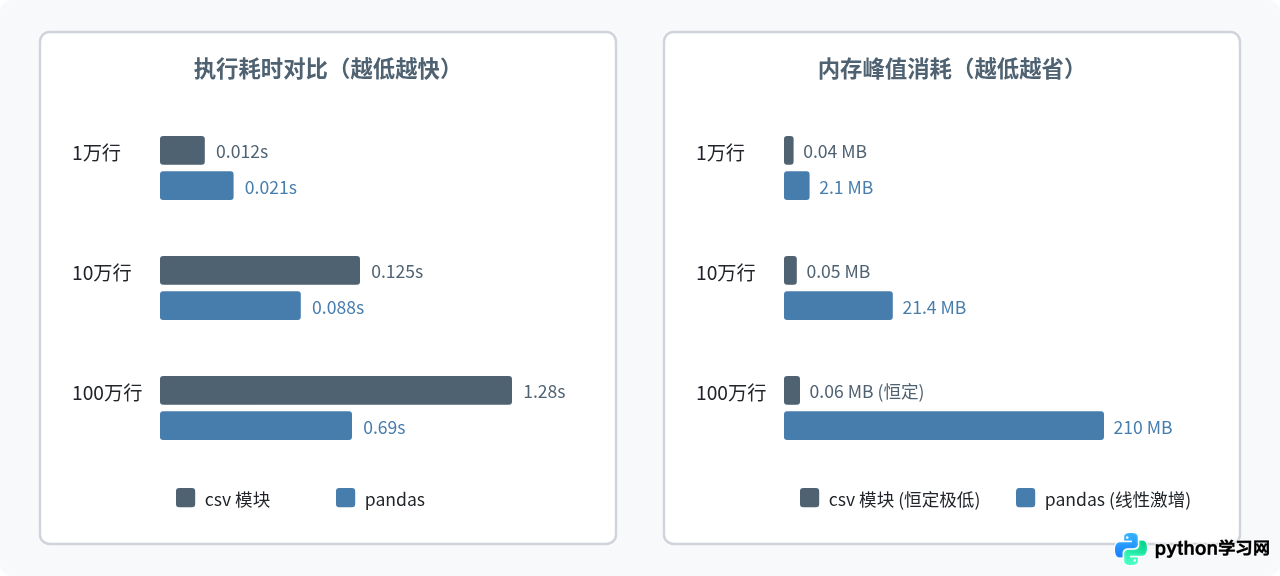
我们采用包含 5 列数据(2 列整数、2 列浮点数、1 列中等长度字符串)的标准 CSV 文件作为测试对象,分别在 1 万行(约 0.6 MB)、10 万行(约 6.2 MB)和 100 万行(约 62 MB)三种规模下进行实测。以下为代表性的基准参考数据(示例数据基于标准 x86_64 环境单核测试):
| 数据规模(行数 / 文件体积) | 方案 | 执行耗时(秒) | 内存峰值(MB) | 内存膨胀比(相比原文件) |
|---|---|---|---|---|
| 10,000 行 (~0.6 MB) | 内置 csv 模块 | 0.012 | 0.04 | < 0.1x |
| pandas.read_csv | 0.021 | 2.10 | 3.5x | |
| 100,000 行 (~6.2 MB) | 内置 csv 模块 | 0.125 | 0.05 | < 0.01x |
| pandas.read_csv | 0.088 | 21.40 | 3.45x | |
| 1,000,000 行 (~62 MB) | 内置 csv 模块 | 1.280 | 0.06 | < 0.001x |
| pandas.read_csv | 0.690 | 210.00 | 3.38x |
四、性能差异的核心归因与边界分析
通过上述测试数据,可以提炼出影响两者性能对比的几个决定性因素:
1. 启动开销与临界规模
在小文件(如几百行至 1 万行)场景下,内置 csv 模块的耗时往往低于 pandas。这是因为 pandas.read_csv 具备更高的前置开销:需要初始化内部状态机、动态分配类型推断缓冲区、构建 DataFrame 容器以及加载 NumPy 相关元数据。当文件行数达到 10 万行以上时,C 语言底层批量解析的高吞吐量优势显现,能够迅速拉平并超越这部分固定开销。
2. 类型转换的开销位置
内置 csv.reader 读取出的数据全部为原始字符串。如果业务需要执行数值计算(如 float(val)、求平均值),这些转换操作必须在 Python 解释器内通过 for 循环逐个执行。Python 的解释器循环和动态类型装箱成本极高,这正是内置模块在 100 万行测试中总耗时落后的主要原因。而 pandas 的类型转换完全发生在底层的 C 语言解析循环中,直接将二进制数据写入连续内存,因此整体处理速度更快。
3. 内存膨胀比与 OOM 风险
内置 csv 模块的内存占用几乎与数据规模无关。无论是 10 万行还是 1 亿行,只要以生成器方式按行遍历,内存中只保存当前行的字符串列表,峰值内存始终保持在几十 KB。相反,pandas 默认将整表载入内存,且由于内存对齐、字符串对象指针及额外索引开销,其实际内存占用通常是磁盘 CSV 文件体积的 2.5 到 4 倍。当文件体积达到数 GB 时,若物理内存不足,pandas 会直接触发 MemoryError(OOM 崩溃)。
五、场景选型决策指南
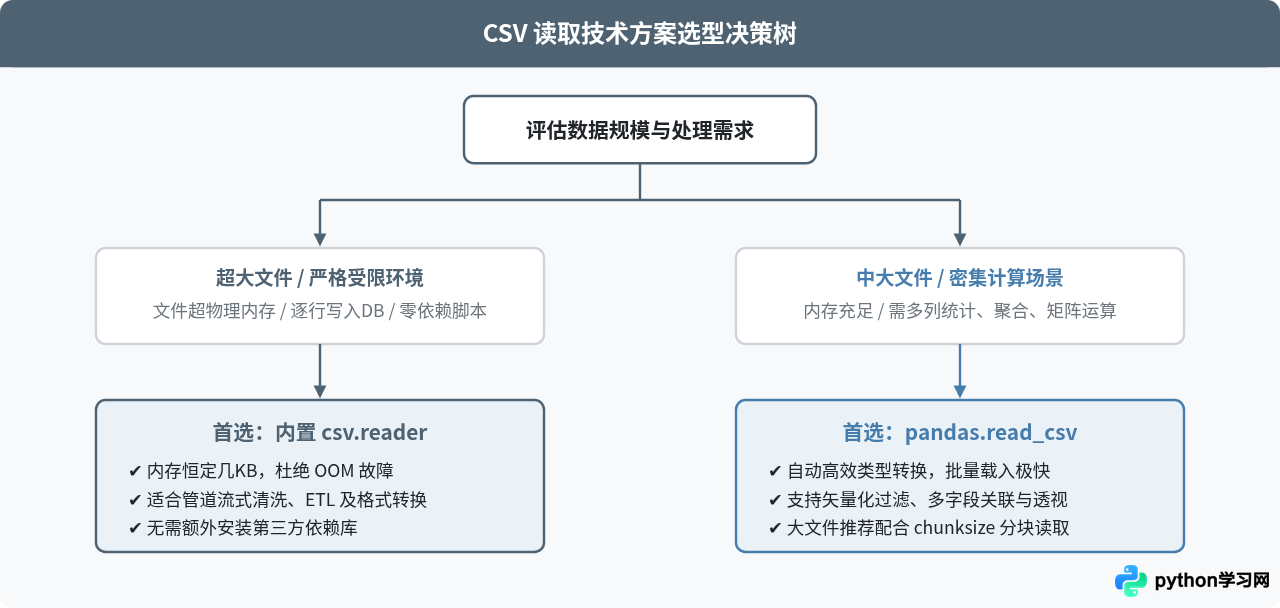
在实际工程中,不能单纯依据“谁的速度快”或“谁的内存省”来做出决断,而应围绕数据规模、服务器资源限制以及后续业务计算逻辑来匹配最佳方案。
1. 适合内置 csv 模块的典型场景
- 资源极度受限环境:在轻量级 Docker 容器、AWS Lambda 等 Serverless 无服务架构或低配云服务器上运行,内存预算紧张。
- 流式数据管道(ETL):从上游 CSV 读取数据,简单校验或清洗后逐行流式写入外部数据库(如 PostgreSQL、MySQL)或消息队列,无需常驻内存。
- 标准库零依赖诉求:分发独立的 Python 运维工具或单文件自动化脚本,要求在不安装任何第三方依赖(pip 安装受限或脱机环境)的情况下开箱即用。
2. 适合 pandas.read_csv 的典型场景
- 探索性数据分析(EDA)与建模:需要对数据表执行分组汇总(
groupby)、多表关联(merge)、缺失值插值或矩阵运算。 - 多类型宽表快速加载:表格包含数十列且各列数据类型复杂(数值、日期、布尔等),依赖
pandas自动推断可省去大量类型转换样板代码。 - 单机内存充裕的数据处理:文件在几百兆以内且宿主机内存充足(如 16GB 以上),追求最高执行吞吐量。
六、常见问题与实用优化建议
1. 使用 pandas 读取超大文件时如何避免内存溢出?
如果业务逻辑强依赖 pandas 的 DataFrame 特性,但文件体积超过可用物理内存,可采用 chunksize 参数实现分块迭代,结合两者长处:
# 以 100,000 行为一组分块流式处理,兼顾内存可控与向量化速度
for chunk in pd.read_csv("large_dataset.csv", chunksize=100000):
    # 对当前分块进行向量化计算
    chunk_result = chunk[chunk["status"] == "active"]["amount"].sum()
    # 汇总各块结果,处理完后当前 chunk 自动释放
2. 如何进一步提升 pandas.read_csv 的载入速度与内存效率?
默认情况下,pandas 会扫描全量列并使用 64 位类型存储。通过在调用时显式指定 usecols(仅加载必要字段)和 dtype(例如将 float64 压缩为 float32,将高基数类别列设为 category),可以将加载耗时降低 40% 以上,并减少 60% 左右的内存消耗:
# 显式指定加载字段与紧凑数据类型
dtypes = {"id": "int32", "score": "float32", "category": "category"}
df = pd.read_csv("data.csv", usecols=["id", "score", "category"], dtype=dtypes)
3. 使用内置 csv 模块时有哪些容易忽略的细节?
在 Windows 环境下使用 Python 3 打开 CSV 文件时,必须在 open() 函数中显式声明 newline=""。如果不指定,Python 的通用换行符机制可能会将字段内包含的嵌入换行解析为双重换行,从而导致数据错位或解析异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









