

Python怎么用负数索引快速截取字符串末尾字符
深入讲解Python中利用负数索引快速截取字符串末尾字符的完整方法与核心原理,涵盖基础语法、边界避坑、左闭右开区间解析及常见实战应用。
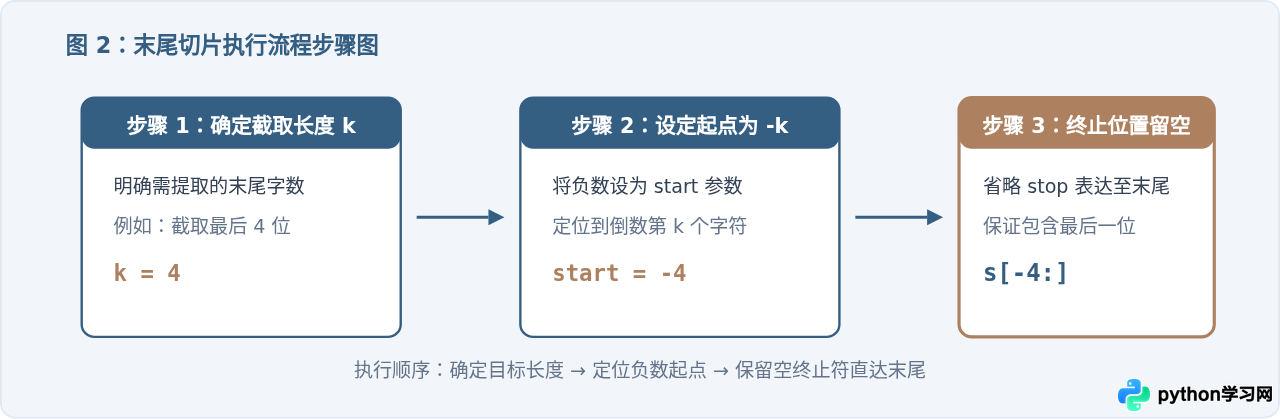
s[-k:] 即可快速截取字符串末尾的 k 个字符。在该表达式中,-k 表示从倒数第 k 个字符开始,而省略冒号后的终止位置则表示一直截取到字符串的最末尾。
处理字符串时,提取特定后缀、获取文件扩展名或读取文本最后几位数据是非常普遍的需求。很多初学者习惯用 len(s) - k 换算正向索引,这种方式不仅书写冗长,还容易因下标偏差引发错误。Python 原生支持负数索引机制,借助反向计数和灵活的切片语法,一行代码即可优雅完成末尾截取。
一、负数索引的双向定位机制
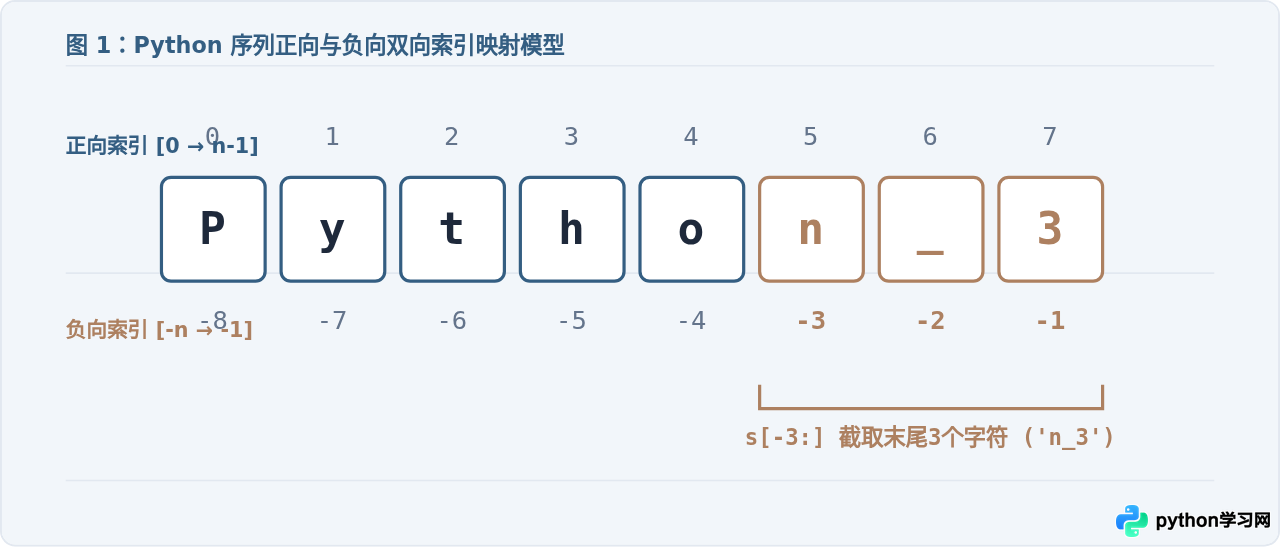
理解末尾截取的前提是掌握 Python 的双向索引机制。在 Python 中,字符串属于不可变序列类型,系统为序列中的每个字符分配了正向与负向两个维度的坐标系统:
- 正向索引:从字符串起始位置由左向右计数,第一个字符的索引为
0,随后逐位自增1。 - 负数索引:从字符串末尾位置由右向左计数,最末尾字符的索引为
-1,前一位为-2,以此类推向左递减。
为什么末尾字符的负数索引是 -1 而不是 -0?因为在数学和计算机中 0 与 -0 等价,0 已经被保留用于标识序列的第一个元素。因此,反向计数天然从 -1 启步,这为反向寻址提供了明确且唯一的坐标基准。
二、使用切片快速截取末尾字符的操作步骤
Python 切片语法的完整格式为 sequence[start:stop:step]。在执行“截取末尾字符”任务时,通常遵循三个核心步骤:
代码示例:截取固定长度的末尾字符
以下示例展示在交互式终端或脚本中截取末尾字符的标准代码:
# 示例字符串
text = "Python_Programming_2026"

# 1. 截取最后 1 个字符(取单个字符可以用索引,也可以用切片保持字符串切片特性)
last_char = text[-1]
last_char_slice = text[-1:]

# 2. 快速截取末尾 4 个字符
last_4_chars = text[-4:]

# 3. 快速截取末尾 11 个字符
last_11_chars = text[-11:]

print("末尾 1 个字符 (索引):", last_char)
print("末尾 1 个字符 (切片):", last_char_slice)
print("末尾 4 个字符:", last_4_chars)
print("末尾 11 个字符:", last_11_chars)末尾 1 个字符 (索引): 6
末尾 1 个字符 (切片): 6
末尾 4 个字符: 2026
末尾 11 个字符: _2026 (注意长度与包含字符)
三、左闭右开区间与常见避坑要点
很多初学者在编写末尾截取时,容易写出类似于 s[-3:-1] 的代码,以为这样就能“从倒数第 3 位截取到倒数第 1 位”。然而运行结果往往与预期不符,导致最后一个字符离奇丢失。
1. 为什么不能写 stop = -1?
Python 切片严格遵循左闭右开原则:即区间包含起始位置 start,但不包含终止位置 stop(数学记法为 [start, stop))。
当执行 s[-3:-1] 时,切片从索引 -3 开始取值,取到 -2 结束;而终止坐标 -1 所对应的末尾字符按规则被排除在外。要想把最后一个字符包含进来,终止位置必须留空(写作 s[-3:]),此时解释器会将切片终止边界自动扩展至序列的真正物理尽头。
2. 切片越界与单个索引越界的区别
s[-99]),若超出实际长度,Python 会抛出 IndexError: string index out of range 异常;但切片操作(例如 s[-99:])具备极高的容错性,即使截取长度大于字符串实际长度,也不会报错,而是优雅地返回整个字符串副本。
s = "hi"

# 单个索引越界会报错
try:
    char = s[-5]
except IndexError as e:
    print("单字符索引越界错误:", e)

# 切片超出长度时安全处理
result = s[-5:]
print("超长负数切片返回:", repr(result)) # 安全返回 'hi'单字符索引越界错误: string index out of range
超长负数切片返回: 'hi'
四、实际业务中的典型应用场景
掌握了负数索引的基础语法后,我们可以在日常编码中解决以下几种典型需求:
场景 1:提取文件扩展名或文件名后缀
在已知固定格式或截取固定末尾标记时,负数切片极为简便:
filename = "report_2026_final.pdf"

# 截取末尾 4 个字符以判断或提取扩展名
extension = filename[-4:]
print("文件后缀:", extension)  # 输出: .pdf
场景 2:数据脱敏与尾号留存
在处理手机号、银行卡号等隐私数据时,经常需要对前面字符打码,仅保留后 4 位数字:
phone_number = "13800138000"

# 提取末尾 4 位并结合占位符
masked_phone = "*" * (len(phone_number) - 4) + phone_number[-4:]
print("脱敏后手机号:", masked_phone)  # 输出: *******8000
场景 3:剔除末尾多余字符(反向截断)
如果需求是“去掉末尾的固定字符”,切片位置正好相反——将负数索引放在 stop 位置,即 s[:-k]:
path_with_slash = "https://example.com/api/v1/"

# 去除末尾最后一个斜杠
cleaned_path = path_with_slash[:-1]
print("剔除末尾斜杠:", cleaned_path)  # 输出: https://example.com/api/v1
五、常见负数切片模式总结速查
为了便于在实际开发中快速对比与调用,下表总结了常用的负数切片模式:
| 语法模式 | 含义解释 | 示例代码 (s = "ABCDEFG") | 输出结果 |
|---|---|---|---|
s[-1] |
获取末尾单个字符(单字符类型) | s[-1] |
'G' |
s[-k:] |
截取末尾 k 个字符(包含最后一位) | s[-3:] |
'EFG' |
s[:-k] |
保留前面所有内容,剔除末尾 k 个字符 | s[:-2] |
'ABCDE' |
s[-m:-n] |
截取倒数第 m 到倒数第 n+1 位之间的区间 | s[-4:-1] |
'DEF' |
s[::-1] |
字符串整体翻转(负数步长) | s[::-1] |
'GFEDCBA' |
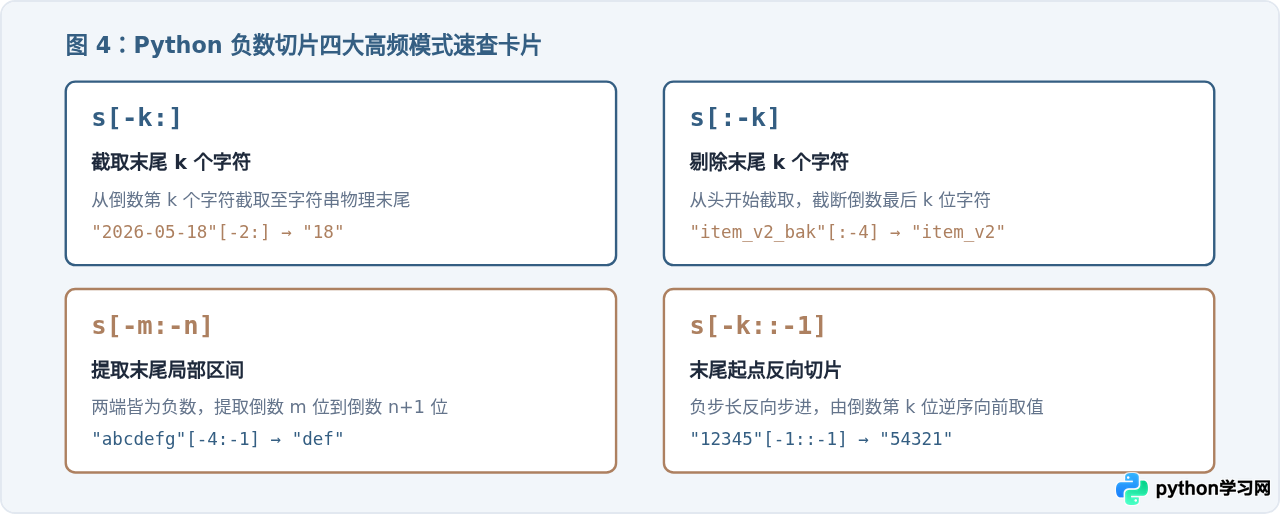
总结来说,使用负数索引快速截取字符串末尾字符的秘诀在于牢记 -k 起点与冒号留空原则。利用 s[-k:] 不仅能保证逻辑的直观与代码的极简,更能依赖底层切片的容错性规避潜在的下标越界异常,是编写地道 Python 代码的必备基本功。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









