

Python读取CSV文件出现中文乱码怎么解决

encoding 参数:Windows默认保存的中文文件通常指定为 encoding='gbk' 或 encoding='gb18030';微软Excel另存的UTF-8文件若首列异常则指定为 encoding='utf-8-sig';标准UTF-8文件指定为 encoding='utf-8'。本文将系统梳理乱码成因、四种典型场景的解决方案以及未知编码文件的排查步骤。
一、为什么Python读取CSV会产生中文乱码
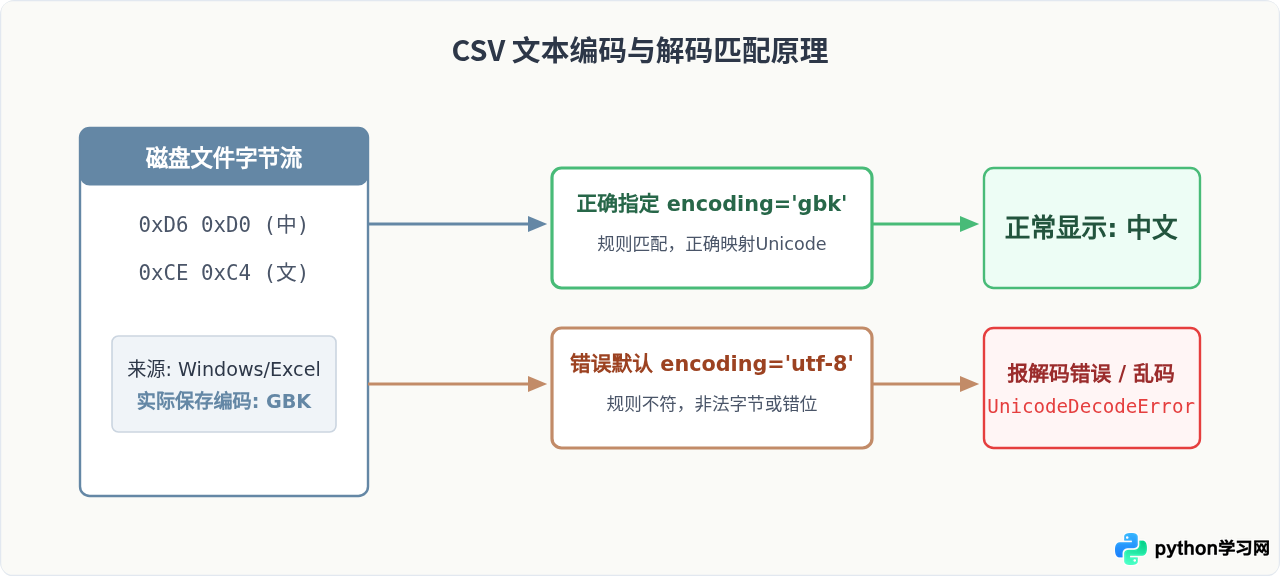
CSV本质上是纯文本文件。计算机在存储文本时,必须将汉字等字符按照某种规则(如GBK、UTF-8)转化为底层的二进制字节;而在读取文件时,程序必须使用完全相同的规则把这些字节反向还原为文字。
Python 3中的 open() 函数在未显式传入 encoding 参数时,默认采用操作系统当前的本地化编码设置。在简体中文Windows系统中,系统默认编码通常为 cp936(即GBK);而在macOS与多数Linux发行版中,默认编码为 utf-8。这种隐式默认行为常常导致两类典型冲突:
- GBK编码的CSV使用UTF-8模式读取:程序解析到不合规的字节序列,直接抛出
UnicodeDecodeError: 'utf-8' codec can't decode byte...报错。 - UTF-8编码的CSV在Windows下默认读取:虽然不一定报错,但每个汉字的3字节会被强行按2字节拆分识别,在界面上显示为连串怪异字符或问号。
二、四种典型场景与标准解决方法
在实际开发中,中文乱码主要集中在以下四种情况。根据文件来源与错误特征,采用对应的编码参数即可顺利读取。
场景 1:Windows系统下由Excel导出的普通CSV(GBK / GB18030)
如果在Windows系统的Excel中直接“另存为”CSV(逗号分隔),默认生成的文件通常遵循ANSI编码规范(简体中文环境下即为GBK)。当使用标准库 csv 或 pandas 读取并报错时,显式传入 encoding='gbk'。
# 使用内置 csv 模块
import csv

with open('data.csv', mode='r', encoding='gbk') as f:
    reader = csv.reader(f)
    for row in reader:
        print(row)

# 使用 pandas 模块
import pandas as pd

df = pd.read_csv('data.csv', encoding='gbk')
print(df.head())encoding='gb18030',它完全向后兼容GBK与GB2312。
场景 2:Excel保存的“UTF-8 CSV”出现首列列名乱码(UTF-8-SIG)
用户在较新版本的Excel中选择“CSV UTF-8(逗号分隔)(*.csv)”进行保存时,Excel会在文件开头的第一个字节之前自动写入3个隐藏的字节标记(0xEF 0xBB 0xBF),即BOM(Byte Order Mark,字节顺序标记)。
若使用普通 encoding='utf-8' 读取,Python不会过滤这3个字节,而是将其解析为零宽无中断空格 \ufeff,导致第一列的字段名变成了 \ufeffid 或 \ufeff姓名,从而引发字段无法匹配的异常。
# 针对带 BOM 的 UTF-8 文件,指定 'utf-8-sig' 自动忽略 BOM 标记
import pandas as pd

df = pd.read_csv('data_excel_utf8.csv', encoding='utf-8-sig')
print(df.columns)  # 输出正常的列名,如 ['姓名', '年龄'],不会出现 \ufeff
场景 3:现代数据接口或跨平台生成的标准UTF-8文件
由爬虫、数据库导出工具、或者macOS/Linux系统生成的CSV通常为无BOM的标准UTF-8。如果代码在Windows环境下运行且未传递encoding,Windows会尝试用GBK去解构UTF-8的3字节汉字,出现乱码。此时只需显式声明 encoding='utf-8' 即可:
import pandas as pd

df = pd.read_csv('api_export.csv', encoding='utf-8')
print(df.head())
场景 4:混杂损坏字节的历史文件(容错模式)
有时CSV在多平台传输或拼接过程中,混入了个别无法解析的损坏字节。在业务上若允许跳过或替换损坏字符,可在标准库 open() 中搭配 errors 参数使用:
# 遇到损坏字符使用问号代替,防止整个程序中断
with open('legacy_corrupted.csv', mode='r', encoding='gb18030', errors='replace') as f:
    for line in f:
        # 处理正常解析及替换后的行
        pass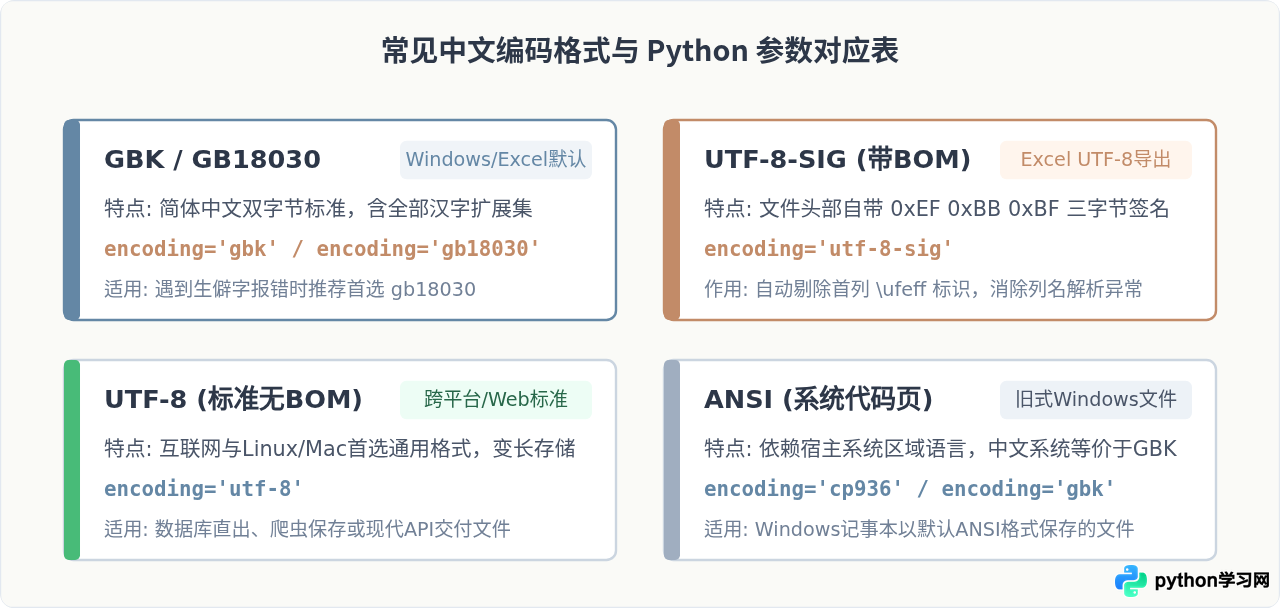
三、准确定位未知 CSV 文件编码的四步排查法
当接收到一个来源不明、在尝试常规参数仍无法读取的文件时,不需要盲目猜测。按照以下四个步骤可以快速排查出文件的真实编码并验证修复。
步骤 1:分析控制台报错特征
错误信息往往直接揭示了编码冲突的方向:
- 如果使用
encoding='utf-8'读取时出现UnicodeDecodeError: 'utf-8' codec can't decode byte 0x...,说明文件绝对不是纯粹的UTF-8,大概率为GBK、GB18030或含有损坏字节。 - 如果使用
encoding='gbk'读取时出现UnicodeDecodeError: 'gbk' codec can't decode byte 0x... in position...: incomplete multibyte sequence,说明该文件很可能是UTF-8格式。 - 如果代码无报错正常运行,但打印出的列名列表第一项形如
['\ufeffname', 'age'],说明是带BOM的UTF-8。
步骤 2:利用 Python 代码自动探查(推荐 chardet 库)
无需整文件读取,只需以二进制('rb')模式读取前数千字节作为样本,利用第三方库 chardet 进行统计学概率探测:
import chardet

# 读取前 10KB 字节进行探测,速度快且准确率高
with open('unknown_data.csv', 'rb') as f:
    raw_sample = f.read(10240)
    result = chardet.detect(raw_sample)

detected_encoding = result['encoding']
confidence = result['confidence']

print(f"探测结果: {detected_encoding},可信度: {confidence}")
# 输出示例: 探测结果: GB2312,可信度: 0.99
# 注:若检测为 GB2312,实际传参时推荐指定为其超集 'gb18030'
步骤 3:文本编辑器核验
在图形界面下,可使用 VS Code 或 Notepad++ 打开该 CSV 文件:
- 在 VS Code 右下角状态栏直接查看当前检测编码(如
UTF-8、UTF-8 with BOM或GBK)。 - 点击该编码项,选择“通过编码重新打开”(Reopen with Encoding),依次切换测试,直到中文内容显示完全清晰无乱码,此时右下角显示的名称即为目标编码。
步骤 4:在代码中验证与首行字段核对
确定编码后,建议编写两行测试代码,分别检验首行字段与包含中文的数据行:
import pandas as pd

# 验证读取
df = pd.read_csv('unknown_data.csv', encoding='gb18030', nrows=5)
print("列名列表:", list(df.columns))
print("首行样例:\n", df.iloc[0])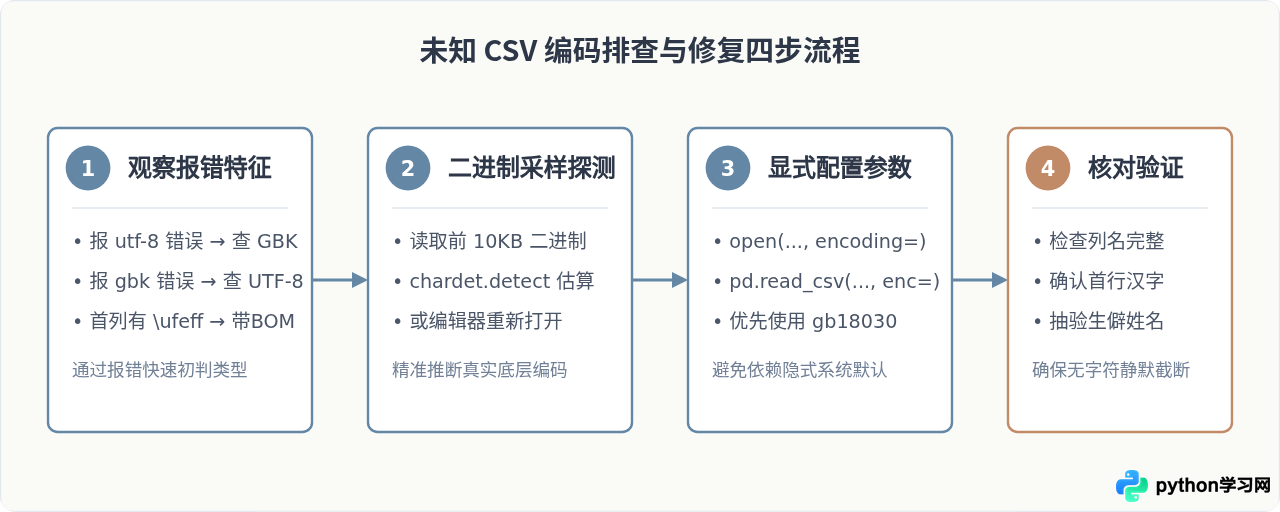
四、在生成与导出 CSV 时防止他人乱码的最佳实践
除了读取他人提供的文件,当自己编写Python程序向外输出CSV供其他团队成员(尤其是非技术人员使用Excel打开)时,若不注意编码格式,对方双击打开常常就是乱码。以下是兼顾各方环境的最佳实践:
- 推荐输出格式
utf-8-sig:在to_csv()时显式设定encoding='utf-8-sig'。这样不仅能让现代Python脚本正常读取,还能让Windows下的Excel在双击打开时自动识别BOM头,直接以UTF-8渲染中文,避免出现乱码。 - 标准库保存示例:
import csv data = [["工号", "姓名", "部门"], [101, "张伟", "数据部"], [102, "李娜", "运营部"]] with open('export.csv', 'w', newline='', encoding='utf-8-sig') as f: writer = csv.writer(f) writer.writerows(data) - Pandas 保存示例:
df.to_csv('export.csv', index=False, encoding='utf-8-sig')
五、乱码问题速查决策指南
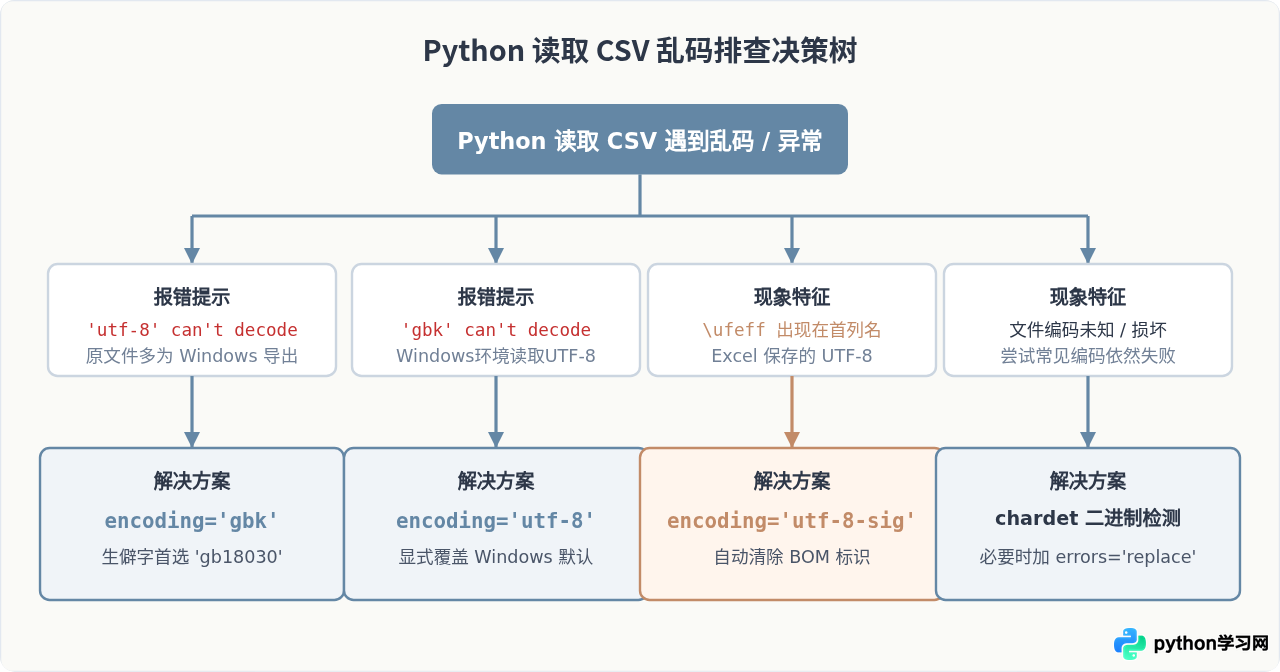
遇到乱码时,按照以下对照表与决策树可实现一步到位的精准处理:
| 现象 / 报错信息 | 根本原因 | 直接解决代码 |
|---|---|---|
'utf-8' codec can't decode byte... |
文件为GBK/GB18030(如Excel导出),但代码按UTF-8读取 | encoding='gb18030' |
'gbk' codec can't decode byte... |
Windows系统默认按GBK读取了UTF-8文件 | encoding='utf-8' |
| 读出中文为乱码(如“试æ”),但未报错 | 编码解析错位(如将UTF-8字节流强行按ISO-8859-1等单字节读取) | 显式传入正确编码(通常为 utf-8 或 gbk) |
首列字段名含有 \ufeff(如 \ufeff姓名) |
文件包含UTF-8 BOM头,未被普通utf-8过滤 | encoding='utf-8-sig' |
| 普通汉字正常,遇到生僻字报错中断 | 使用了字库较小的 GB2312 或基础 GBK | 升级为 encoding='gb18030' |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









