

Python能做什么:数据分析、爬虫与自动化办公应用

一、自动化办公:批量消除机械式桌面操作
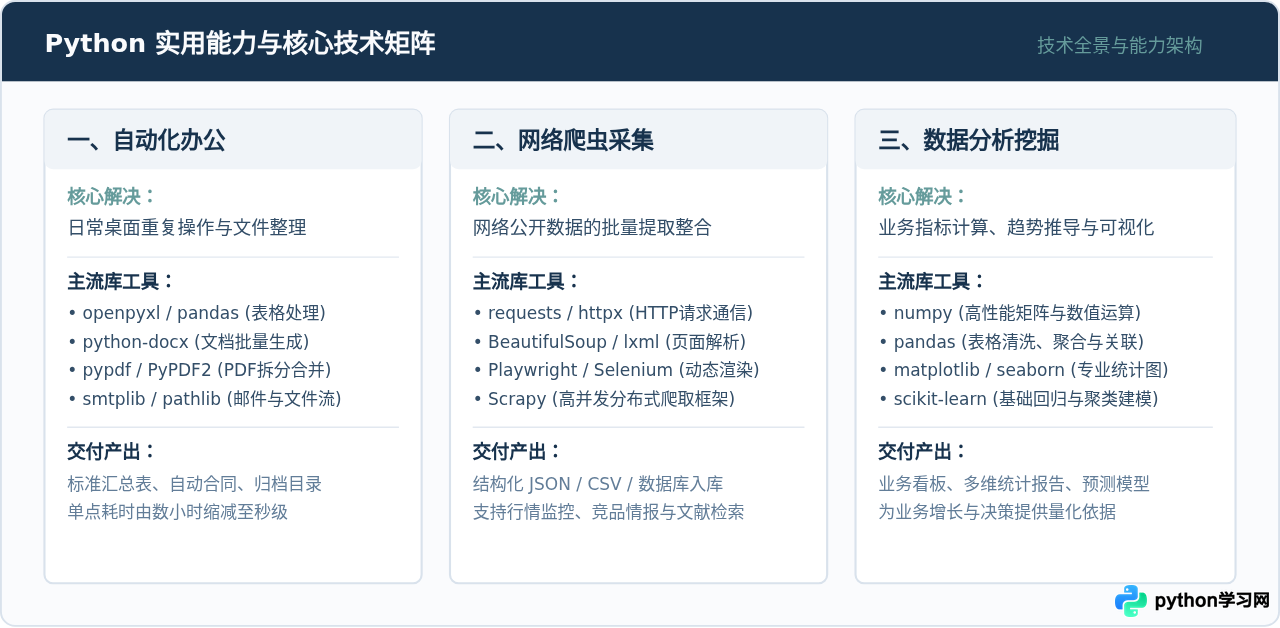
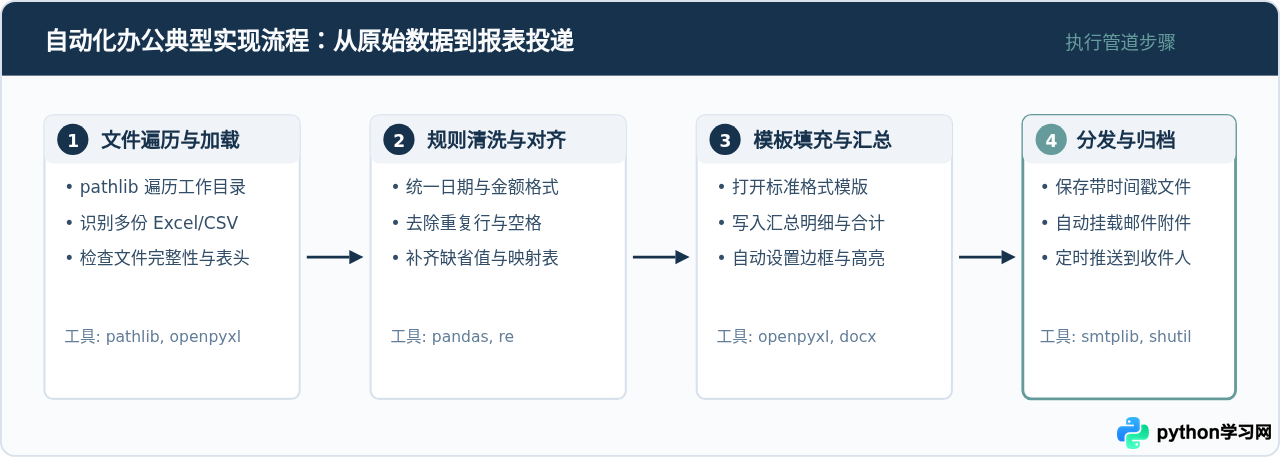
在日常办公中,最消耗时间的往往不是复杂的逻辑思考,而是大量规律明确的重复动作:例如将几十个部门提交的格式相同的 Excel 报表合并为一张总表、依据员工信息批量生成上百份劳动合同 Word 文档、拆分与重命名扫描件 PDF、或者每天定时发送提醒邮件。
Python 对操作系统的底层文件系统和常见办公软件格式提供了完善的支持库,无需启动图形界面即可在内存中直接修改二进制文档结构:
- 电子表格处理(openpyxl 与 pandas):读取、修改、写入
.xlsx文件,设置单元格公式、字体颜色、边框和条件格式,支持多工作表批量遍历。 - 文本文档生成(python-docx):读取 Word 模板,通过占位符替换客户姓名、金额等字段,批量输出格式统一的正式文档。
- PDF 文件批处理(pypdf):实现多页 PDF 的合并、指定页面提取、旋转页面以及基于文字层的内容抽检。
- 文件与目录调度(pathlib 与 shutil):根据日期、文件后缀或内容命名规则,对成百上千个本地文件进行自动归类、重命名与移动。
实战场景:多门店销售数据自动合并
假设某零售企业每周需要将来自 5 个分店的 .xlsx 销售明细合并为一份汇总表,并自动计算全店销售总额。使用原生 Python 配合 openpyxl 可通过如下简洁脚本完成:
from pathlib import Path
import openpyxl

data_folder = Path("./sales_reports")
summary_wb = openpyxl.Workbook()
summary_ws = summary_wb.active
summary_ws.title = "全店销售汇总"

# 写入表头
headers = ["门店名称", "销售日期", "商品名称", "销售数量", "金额(元)"]
summary_ws.append(headers)

# 遍历目录下所有门店 Excel 文件并合并数据
for file_path in data_folder.glob("*.xlsx"):
    wb = openpyxl.load_workbook(file_path, data_only=True)
    sheet = wb.active
    # 跳过原表的第一行表头,从第2行开始读取
    for row in sheet.iter_rows(min_row=2, values_only=True):
        if row[0] is not None:
            summary_ws.append(list(row))

# 在末尾添加总计行
total_row_idx = summary_ws.max_row + 1
summary_ws.cell(row=total_row_idx, column=1, value="合计销售额")
summary_ws.cell(row=total_row_idx, column=5, value=f"=SUM(E2:E{total_row_idx - 1})")

output_path = Path("./summary_result.xlsx")
summary_wb.save(output_path)
print(f"合并完成,总计记录 {summary_ws.max_row - 2} 条,已保存至 {output_path}")
openpyxl.load_workbook 时,如果目标表格中包含 Excel 公式且需要读取上次计算的值,必须显式传递参数 data_only=True;若需要保留公式本身则设为 False。此外,操作路径时推荐统一使用 pathlib.Path,避免在 Windows 与 macOS/Linux 之间由于斜杠格式不一致导致程序崩溃。
二、网络数据采集:自动化汇聚公开信息
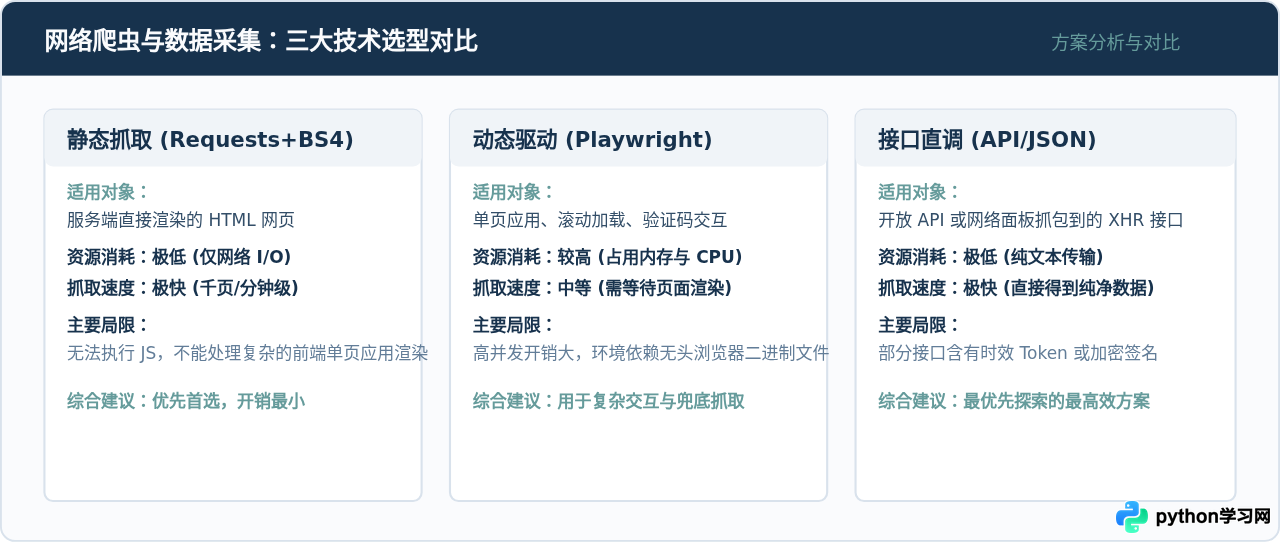
网络爬虫的本质是模拟客户端向 Web 服务器发送网络请求,接收响应内容后解析出需要的结构化数据。在日常研究和业务分析中,公开的商品价格、行业招投标公告、宏观经济指数、学术文献及竞品参数等,都可以通过自动化程序高效采集,彻底解决人工翻页查找复制的问题。
实战场景:静态网页标准结构化抓取
以抓取公开资讯列表为例,通过 requests 库发送带有伪装请求头的 GET 请求,并借助 BeautifulSoup 提取文章标题、发布日期及链接:
import requests
from bs4 import BeautifulSoup
import time

url = "https://example.com/news/archive"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()  # 检查 HTTP 状态码是否为 200
    response.encoding = response.apparent_encoding

    soup = BeautifulSoup(response.text, "html.parser")
    article_items = soup.find_all("div", class_="article-item")

    articles = []
    for item in article_items:
        title_tag = item.find("h2", class_="title")
        date_tag = item.find("span", class_="publish-date")
        link_tag = item.find("a")

        if title_tag and date_tag and link_tag:
            articles.append({
                "title": title_tag.get_text(strip=True),
                "date": date_tag.get_text(strip=True),
                "url": link_tag.get("href", "")
            })

    print(f"成功抓取 {len(articles)} 条文章信息。")
except requests.exceptions.RequestException as e:
    print(f"请求失败: {e}")
robots.txt 协议;不要对未授权的敏感个人信息、付费壁垒内容进行爬取;在批量请求时务必加入合理的等待间隔(例如 time.sleep(1)),避免因突发高并发请求影响目标服务器的正常运行。
三、数据分析:从海量数据到业务决策
当数据量超过数十万行,或者需要进行多表模糊匹配、复杂分组统计与透视运算时,传统表格软件极易卡顿崩溃。Python 拥有被公认为业界标准的数据科学技术栈:
- Pandas:核心数据结构
DataFrame提供类似数据库与电子表格的二维表格抽象,内置了强大的数据过滤、行列重塑、缺失值填充与时间序列处理能力。 - NumPy:提供连续内存的高维数组(ndarray),底层由 C/Fortran 优化编写,支持极速向量化运算,避免低效的 Python 原生 for 循环。
- Matplotlib 与 Seaborn:提供高度定制化的绘图接口,支持绘制分布直方图、箱线图、时间趋势图、多维度相关性热力图等出版级学术与商业图表。
实战场景:销售数据清洗、聚合与指标计算
以下代码演示如何加载原始订单数据,处理缺失值与异常退款订单,并快速计算各品类的月度销售总额及客单价:
import pandas as pd

# 读取原始数据集
df = pd.read_csv("raw_orders.csv")

# 1. 数据清洗:去除重复订单号,过滤退款订单(金额小于或等于0的异常数据)
df.drop_duplicates(subset=["order_id"], inplace=True)
df = df[df["amount"] > 0]

# 2. 类型对齐:将日期字符串解析为标准日期时间对象
df["order_time"] = pd.to_datetime(df["order_time"])
df["month"] = df["order_time"].dt.to_period("M")

# 3. 多维聚合计算:按月份和商品品类统计订单量与总金额
analysis_result = df.groupby(["month", "category"]).agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count")
).reset_index()

# 4. 派生关键业务指标:客单价
analysis_result["avg_order_value"] = (analysis_result["total_sales"] / analysis_result["order_count"]).round(2)

print("清洗与聚合后的前 5 行指标结果:")
print(analysis_result.head())
四、综合应用:打通闭环与学习选型建议
在实际生产环境中,这三项能力很少孤立存在。最典型的业务提效往往是将它们串联成一个全自动化的数据闭环:
例如,设定一个每天清晨运行的定时任务:首先通过网络爬虫抓取竞品在各大电商平台的实时定价与库存变动;接着调用 Pandas 对比自家库存系统的数据库记录,计算价差与竞争指数;随后使用 openpyxl 把分析表格与预警标记填入规范的汇报模板中;最后利用 smtplib 将报表作为邮件附件自动发送给运营团队。
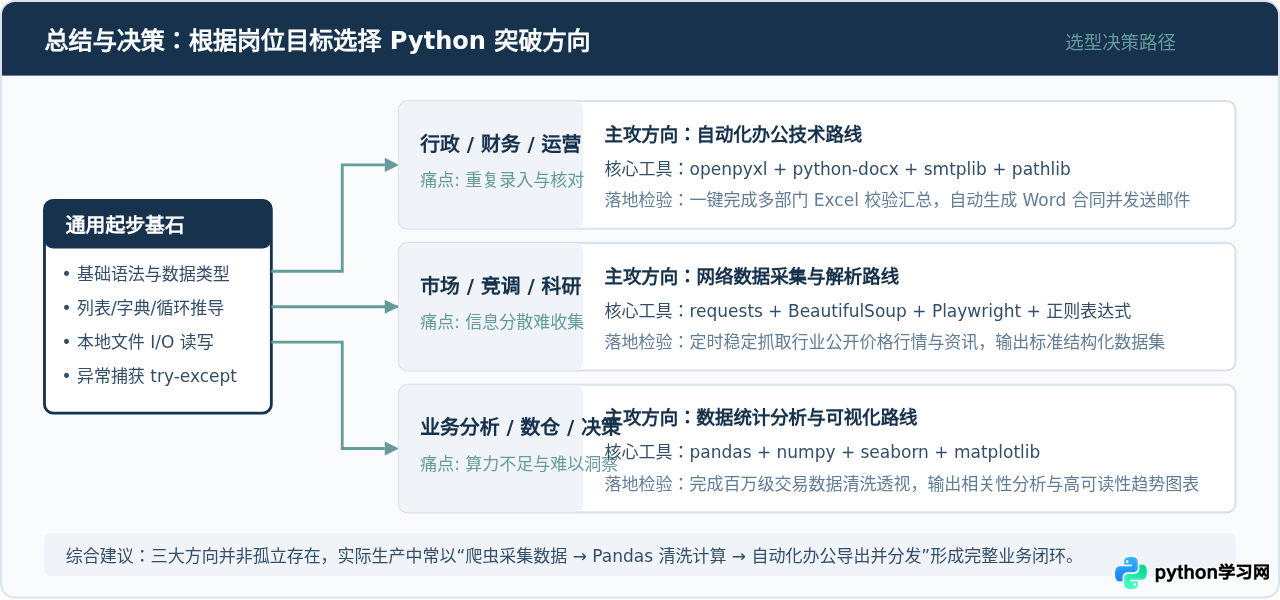
初学者或希望通过 Python 提升效率的读者,建议不要试图一次性掌握所有库,而是应根据当前工作中最突出的痛点优先突破:从最常见的单点繁琐任务起步,建立正向反馈后,再逐步横向串联其他能力模块。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









