

Python wordcloud库入门:生成第一张英文词云图
从环境安装、基础代码实现到核心参数解析与排查要点,系统讲解如何使用 Python wordcloud 库快速生成第一张高质量英文词云图。
wordcloud 库,从零搭建运行环境、编写核心代码,并生成第一张结构完整、视觉清晰的英文词云图。通过逐步拆解文本解析机制、核心参数配置与常见排查要点,帮助读者掌握从字符串输入到图像保存的全流程方法。
一、准备运行环境与安装依赖
在 Python 中生成词云,核心依赖是 wordcloud 库。为了便于在本地运行脚本时直接预览结果并进行格式保存,通常还会配合科学绘图库 matplotlib 一同使用。
在终端或命令行工具中,执行以下 pip 命令即可完成两个核心依赖的安装:
pip install wordcloud matplotlib
安装过程中,pip 会自动下载并安装底层的图像处理库 Pillow 与数值计算库 numpy。在 Windows 平台下,若使用的是官方纯源码包,有时可能会提示需要 C++ 编译环境;直接使用预编译好的标准 wheel 包或 Anaconda 环境可以避免此类底层编译问题。
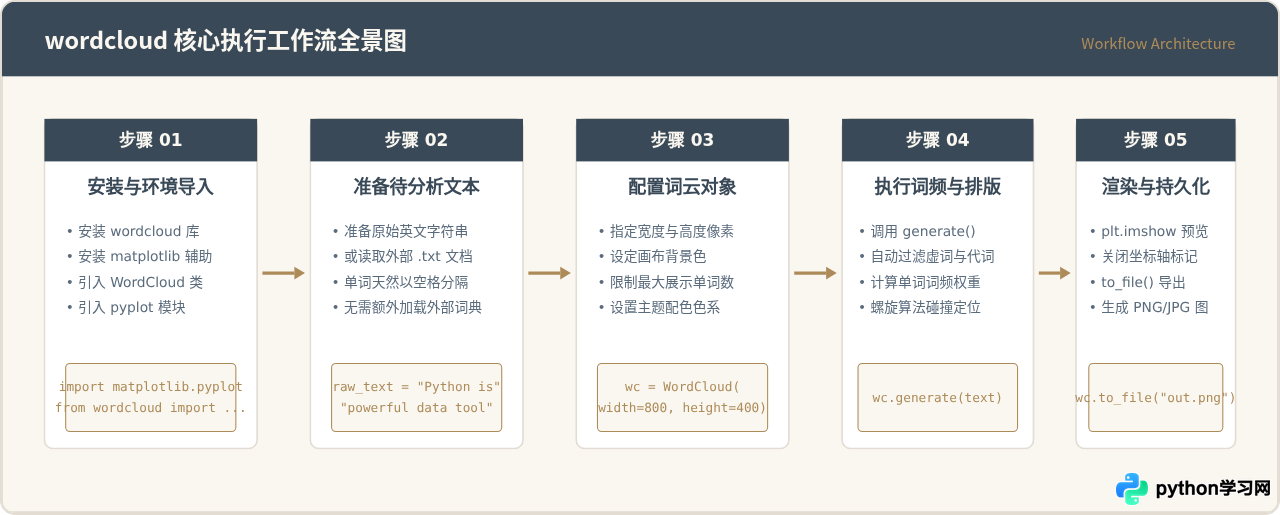
二、核心示例:五行代码生成第一张英文词云
英文语言的天然特性是以空格作为词与词的分界符,因此在处理纯英文文本时,无需引入像 jieba 这样的中文分词器。我们可以直接通过字符串输入,配合 WordCloud.generate() 方法完成词云的构建。
下面是一个可以直接保存并运行的完整示例脚本:
from wordcloud import WordCloud
import matplotlib.pyplot as plt

# 1. 准备一段英文样本文本
text = """
Python is an easy to learn, powerful programming language. It has efficient
high-level data structures and a simple but effective approach to object-oriented
programming. Python elegant syntax and dynamic typing, together with its
interpreted nature, make it an ideal language for scripting and rapid application
development in many areas on most platforms. Data analysis, machine learning,
and web development are widely powered by Python.
"""

# 2. 实例化词云对象并指定画布大小与背景色
wc = WordCloud(
    width=800,
    height=400,
    background_color="white"
)

# 3. 将文本载入词云对象并计算生成
wc.generate(text)

# 4. 使用 matplotlib 进行屏幕渲染展示
plt.figure(figsize=(10, 5))
plt.imshow(wc, interpolation="bilinear")
plt.axis("off")  # 隐藏坐标轴
plt.tight_layout(pad=0)
plt.show()

# 5. 直接持久化保存为独立图片文件
wc.to_file("first_wordcloud.png")
运行上述脚本后,程序会弹出窗口展示生成的词云图,同时在当前工作目录下保存名为 first_wordcloud.png 的图片文件。在图像中,“Python”、“programming”、“language” 等高频词汇会以较大的字号显眼地排列在视觉中心区域。
三、WordCloud 内部工作机制拆解
初学者在使用 wc.generate(text) 时,往往以为该方法只是简单地计算字符串中单词的出现次数。实际上,wordcloud 库在底层执行了三个紧密衔接的处理阶段:文本规范化、停用词清洗以及空间布局碰撞检测。
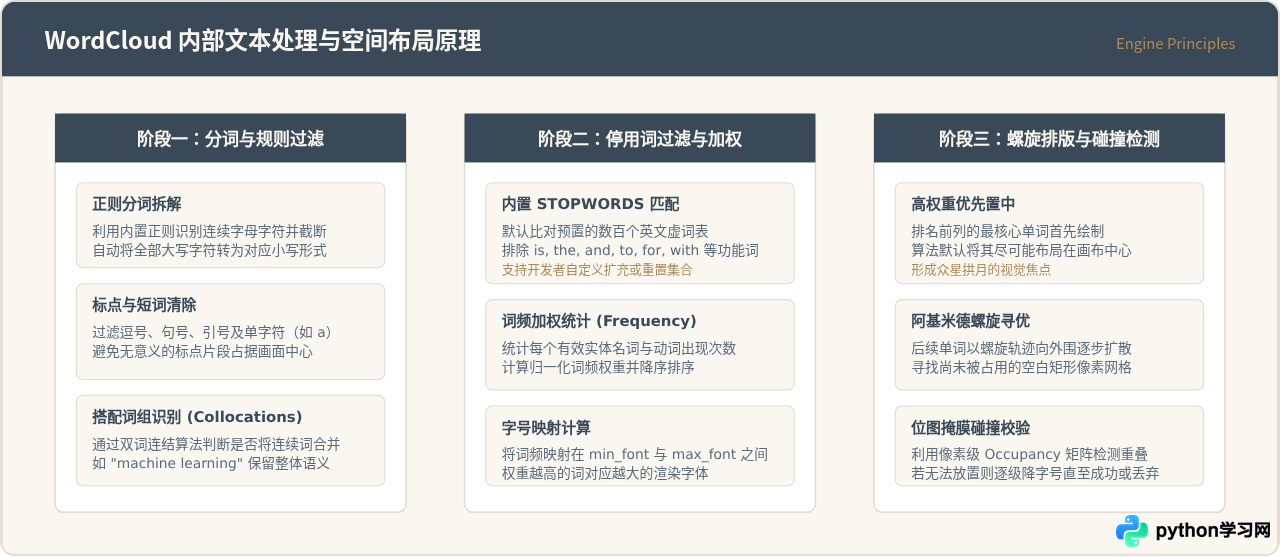
了解这一机制后,读者就能明确两点核心原则:
- 英文停用词的自动化处理:库中已预设了包含
is、the、and等高频连词与介词的集合。因此即使原文中反复出现这些词,也不会污染生成的词云画面。 - 短语连词合并(collocations):默认情况下
collocations=True,WordCloud 会尝试把频繁紧邻的词当作搭配短语保留(例如“machine learning”),如果希望纯粹按单个单词展示,可以将其显式设置为False。
四、核心参数详解与视觉效果调优
在创建 WordCloud 实例时,通过配置构造函数的不同参数,可以精准把控输出图片的分辨率、配色、容量及排版紧密程度。下表梳理了初学者必须掌握的八个关键参数:
| 参数名 | 数据类型 | 默认值 | 功能与使用建议 |
|---|---|---|---|
width / height |
int | 400 / 200 | 画布的像素宽度与高度。建议提升为 1200 与 600,保证生成高清大图。 |
background_color |
str | "black" | 背景颜色。默认为黑色,通常打印或报告中设置为 "white" 更易阅读。 |
max_words |
int | 200 | 词云容纳的最大单词数量。文本较短时可设为 50-80,避免词汇过度拥挤。 |
colormap |
str | "viridis" | matplotlib 色系名称。常用包括 "plasma"、"inferno"、"coolwarm" 等。 |
stopwords |
set | STOPWORDS | 停用词集合。可在预设集合上使用 .add() 追加需要排除的业务无效词。 |
collocations |
bool | True | 是否统计双词搭配。若出现奇怪的复合词组,建议设为 False。 |
margin |
int | 2 | 单词与画布边缘以及相互之间的留白像素间距。 |
random_state |
int | None | 随机种子。设定固定整数后,相同文本每次生成的排版位置保持一致。 |
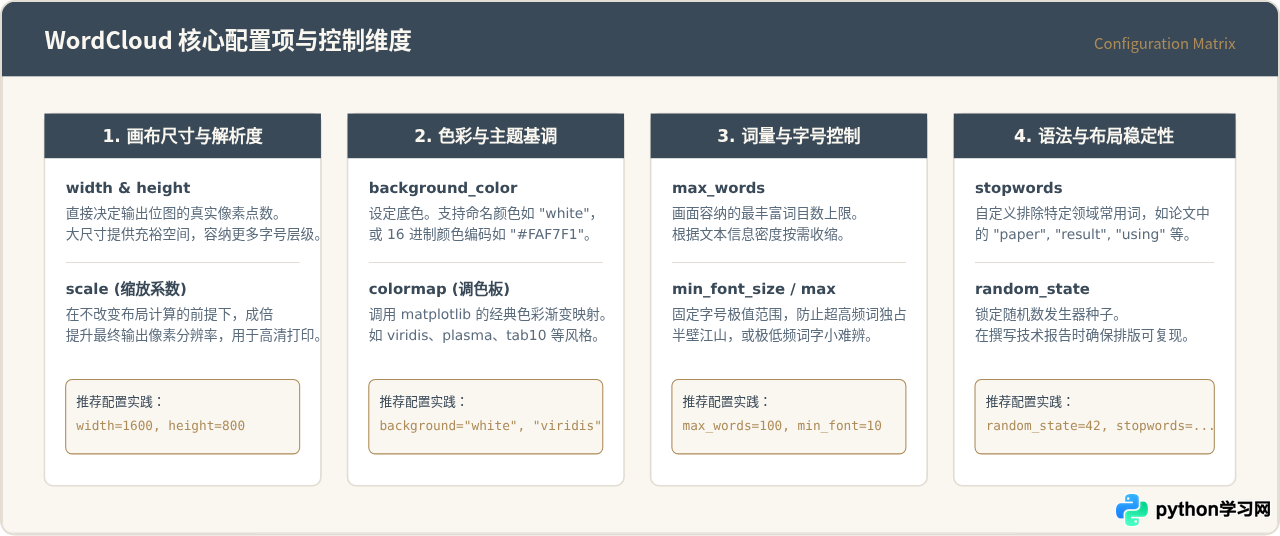
五、从外部文本文件读取并自定义停用词
在实际生产与科研场景中,需要生成词云的文本通常保存在外部的 .txt 纯文本文件中。同时,原始文本中经常夹杂着一些特定领域的无意义高频词(例如论文正文中的“paper”、“section”、“figure”或代码中的“def”、“return”),需要予以过滤。
以下代码演示了完整的端到端实战流程:读取外部英文文件、自定义扩展停用词库,并输出定制化的高清词云:
import os
from wordcloud import WordCloud, STOPWORDS
import matplotlib.pyplot as plt

# 1. 安全读取本地英文文本文件
file_path = "sample_article.txt"

# 若本地无测试文件,快速写入一个示例文件供运行演示
if not os.path.exists(file_path):
    with open(file_path, "w", encoding="utf-8") as f:
        f.write(
            "Artificial intelligence and deep learning represent the modern frontier of computer science. "
            "In this paper, we discuss deep learning models and neural networks. "
            "The experimental results demonstrate that deep learning achieves state-of-the-art accuracy. "
            "Future research should focus on explainable intelligence and efficiency."
        )

with open(file_path, "r", encoding="utf-8") as f:
    text_content = f.read()

# 2. 定制停用词集合:复制默认集合并追加业务词
custom_stopwords = set(STOPWORDS)
custom_stopwords.update(["paper", "discuss", "results", "demonstrate"])

# 3. 构造词云实例
wc = WordCloud(
    width=1200,
    height=600,
    background_color="#FAF7F1",  # 优雅的奶油白背景
    colormap="viridis",          # 经典调色板
    stopwords=custom_stopwords,  # 使用定制停用词
    max_words=100,               # 控制展示词量
    collocations=False,          # 仅统计单个独立单词
    random_state=42              # 固定排版结果
)

# 4. 生成图像
wc.generate(text_content)

# 5. 保存结果
wc.to_file("custom_wordcloud.png")
print("词云图已成功生成并保存为 custom_wordcloud.png")
set(STOPWORDS) 来建立副本。由于 STOPWORDS 在 Python 内存中是一个标准的 Python 集合对象(set),我们可以使用 .add("word") 或 .update(["word1", "word2"]) 灵活扩充需要剔除的干扰词汇。
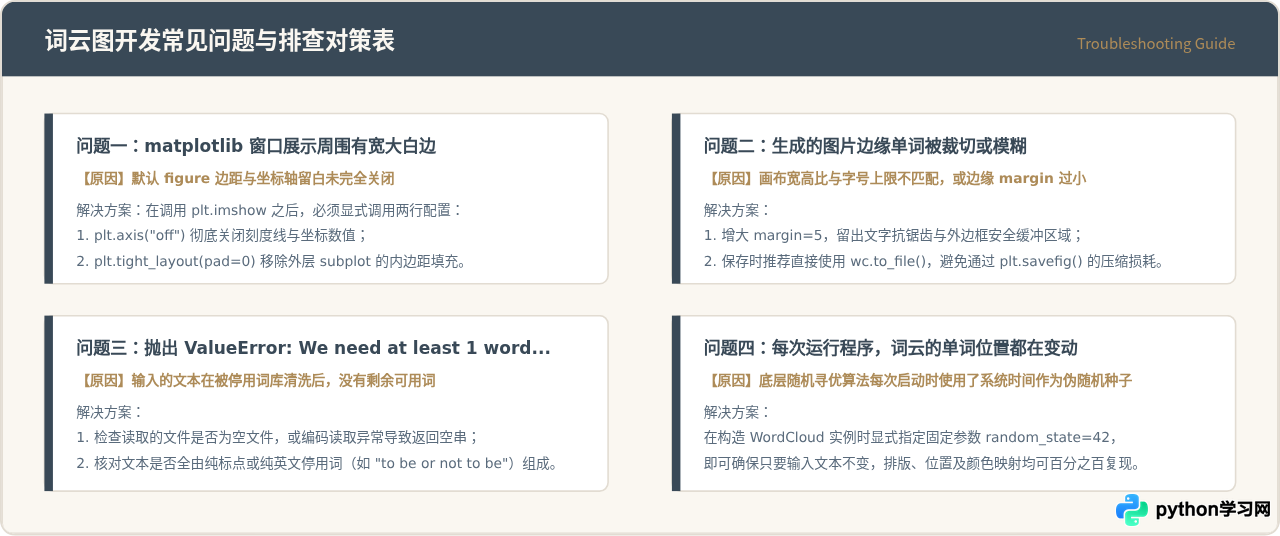
六、常见问题诊断与排查清单
在生成第一张词云图的过程中,开发者最常遇到的往往不是语法错误,而是显示与布局层面的细节问题。下表列出四类典型状况的成因与标准排查路径:
七、总结
本文系统梳理了使用 Python wordcloud 库生成英文词云图的标准流程。由于英文文本具备基于空格分词的天然特性,我们只需完成以下几个核心动作,即可获得规范的高清词云产物:
- 通过
pip install wordcloud matplotlib快速构建基础运行依赖; - 通过
WordCloud(width, height, background_color, ...)实例化对象,精确指定画布规格与视觉风格; - 调用
generate(text)触发底层的分词、停用词清洗与螺旋碰撞排版计算; - 使用
to_file()规避中间转换损耗,直接持久化导出清晰的图像文件。
掌握了英文词云的生成范式后,后续若需要进一步处理中文文本,只需额外引入中文分词工具(如 jieba)并显式指定中文字体路径(font_path),即可将这一套可视化能力无缝迁移到更多语种的文本分析实践中。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









