

Python asyncio实现高并发IO操作教程
本教程详细讲解如何使用 Python asyncio 标准库实现高并发 I/O 操作,涵盖事件循环机制、异步任务编排、并发量控制及常见异常处理。
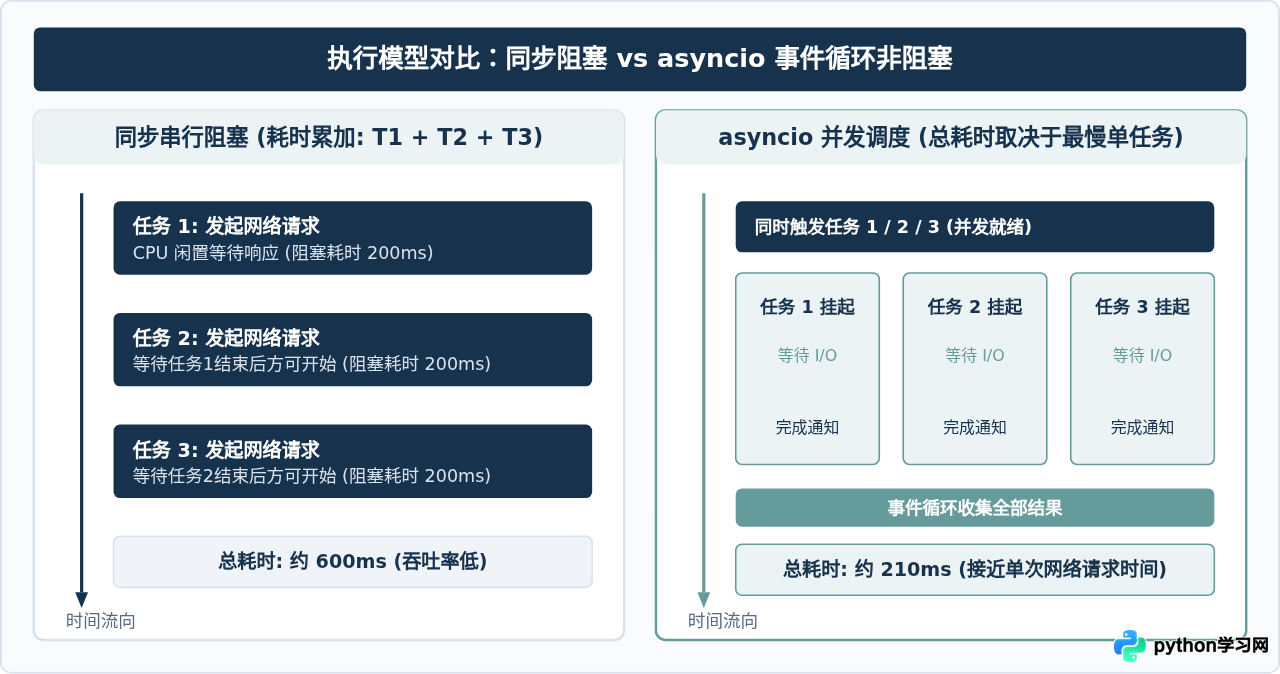
在处理大量网络抓取、API 聚合或磁盘文件读写等 I/O 密集型任务时,传统同步代码会因为等待网络响应而长时间处于阻塞挂起状态,导致执行耗时线性叠加。Python 内置的 asyncio 标准库通过协作式协程(Coroutine)和单线程事件循环(Event Loop),在任务等待外部 I/O 响应时主动出让 CPU 资源给其他任务,从而在单一线程中低成本实现成百上千个 I/O 操作的高并发并发执行。本文将从运行原理、核心编码流程、网络请求实战到并发量调控与常见错误排查,完整介绍如何落地高效稳定的高并发 I/O 程序。
一、为什么高并发 I/O 适合用 asyncio
计算机程序的运行耗时通常分为两类:一是占用处理器计算资源的 CPU 密集型任务,二是等待网络返回、数据库响应或磁盘读写的 I/O 密集型任务。高并发场景绝大多数属于后者。在 I/O 密集场景中,CPU 实际用于处理数据的时间通常不足总时长的 1%,其余 99% 的时间都在等待对端数据包到达。
在多线程方案中,每个线程通常独占操作系统分配的数兆字节栈空间,创建数千个线程会带来显著的内存开销与昂贵的内核态上下文切换成本。而 asyncio 运行在用户态,每个协程的内存占用仅在千字节级别。当某个协程发起网络读取后,它会记录当前暂停状态并主动让出事件循环,事件循环立即转去驱动其他准备好数据的协程,直到数据准备就绪再唤醒原协程恢复执行。
二、编写 asyncio 程序的操作步骤
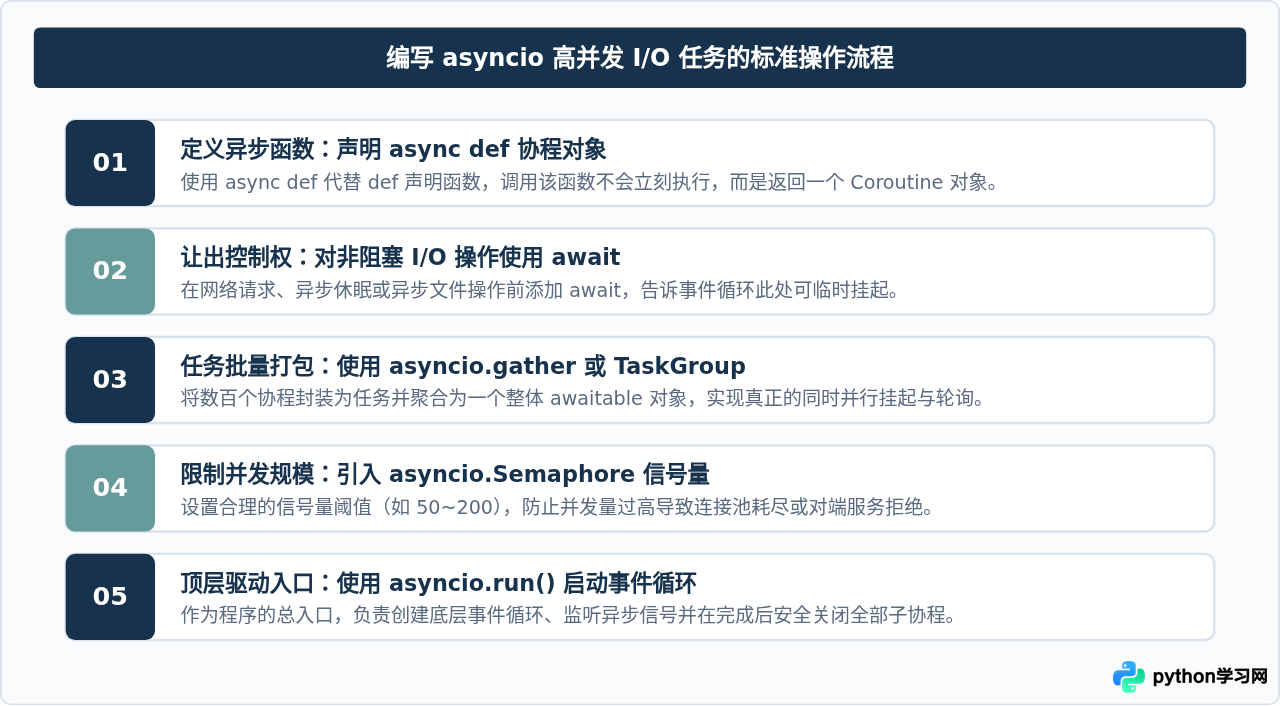
编写一个标准的高并发 I/O 模块,通常需要遵循五个规范步骤。很多初学者遇到的“代码写了 async 但依然是串行执行”问题,大多数是因为缺少了任务封装或错误地在协程内部调用了阻塞方法。
1. 协程基础骨架示例
以下为一个基础的异步等待演示代码,使用 asyncio.sleep() 模拟非阻塞网络等待:
import asyncio
import time

async def fetch_item(item_id: int):
    # 模拟等待网络响应 0.5 秒,此时出让 CPU
    await asyncio.sleep(0.5)
    return f"Data_{item_id}"

async def main():
    start = time.perf_counter()
    # 同时调度 10 个协程
    tasks = [fetch_item(i) for i in range(10)]
    results = await asyncio.gather(*tasks)
    elapsed = time.perf_counter() - start
    print(f"获取到 {len(results)} 条数据,总耗时: {elapsed:.2f} 秒")

if __name__ == "__main__":
    asyncio.run(main())
示例输出:
获取到 10 条数据,总耗时: 0.51 秒如果使用同步的 time.sleep(0.5),获取 10 条数据需要 5 秒;而在 asyncio 调度下,10 个任务几乎同时被挂起等待,总时间仅为单次等待的 0.5 秒加上极短的调度开销。
三、实战:使用 aiohttp 实现批量并发网络请求
在实际高并发网络抓取或批量调用微服务接口时,切勿在 async def 中使用 requests 库。因为 requests 是基于同步阻塞套接字构建的,调用它会卡死当前主线程的整个事件循环,导致其他所有正在等待的异步任务均无法获得调度。
对于真正的异步 HTTP 通信,应搭配 aiohttp 或 httpx 等原生支持异步套接字的客户端。在开始前,可通过终端安装该库:
pip install aiohttp高并发请求完整代码(带信号量限流与错误隔离)
在发起数千次请求时,如果无节制地瞬间发送,很容易触发操作系统的 Too many open files(打开文件句柄超限)错误,或者被目标服务器拉黑。因此,通过 asyncio.Semaphore 限制同时处于活跃状态的连接数量是工程实践中的标配。
import asyncio
import aiohttp
from typing import List, Optional

# 定义目标抓取函数,接收共享 Session 和信号量
async def fetch_url(url: str, session: aiohttp.ClientSession, semaphore: asyncio.Semaphore) -> Optional[dict]:
    async with semaphore:  # 控制并发计数器
        try:
            # 设置单个请求的超时限制(连接 5 秒,总读取 10 秒)
            timeout = aiohttp.ClientTimeout(total=10, connect=5)
            async with session.get(url, timeout=timeout) as response:
                if response.status == 200:
                    text_content = await response.text()
                    return {"url": url, "status": 200, "length": len(text_content)}
                else:
                    return {"url": url, "status": response.status, "length": 0}
        except Exception as err:
            # 捕获单点异常,防止单个请求失败导致整体任务中断
            return {"url": url, "status": -1, "error": str(err)}

async def run_batch_requests(urls: List[str], max_concurrency: int = 20):
    # 限制同时并发的请求不超过 20 个
    semaphore = asyncio.Semaphore(max_concurrency)

    # 复用同一个 ClientSession 以利用底层 TCP 连接池,提高复用率
    connector = aiohttp.TCPConnector(limit=100, ssl=False)
    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = [fetch_url(url, session, semaphore) for url in urls]
        # return_exceptions=True 确保个别未捕获异常以异常对象形式返回,不终止其它任务
        results = await asyncio.gather(*tasks, return_exceptions=True)
        return results

async def main():
    # 构造待抓取的目标 URL 列表示例
    test_urls = [f"https://httpbin.org/delay/1" for _ in range(30)]
    print(f"开始批量请求 {len(test_urls)} 个 URL,最大并发数限制为 20...")

    start_time = asyncio.get_event_loop().time()
    results = await run_batch_requests(test_urls, max_concurrency=20)
    total_time = asyncio.get_event_loop().time() - start_time

    success_count = sum(1 for r in results if isinstance(r, dict) and r.get("status") == 200)
    print(f"执行完成!成功: {success_count}/{len(test_urls)}, 耗时: {total_time:.2f} 秒")

if __name__ == "__main__":
    asyncio.run(main())
关键设计说明:aiohttp.ClientSession 必须在协程上下文中使用,且应当在所有请求间复用同一个实例。不要在每次循环或每次 fetch_url 中重复创建和销毁 session,否则会丢失底层 TCP Keep-Alive 连接池复用带来的吞吐提升。
四、asyncio 核心对象的协作关系
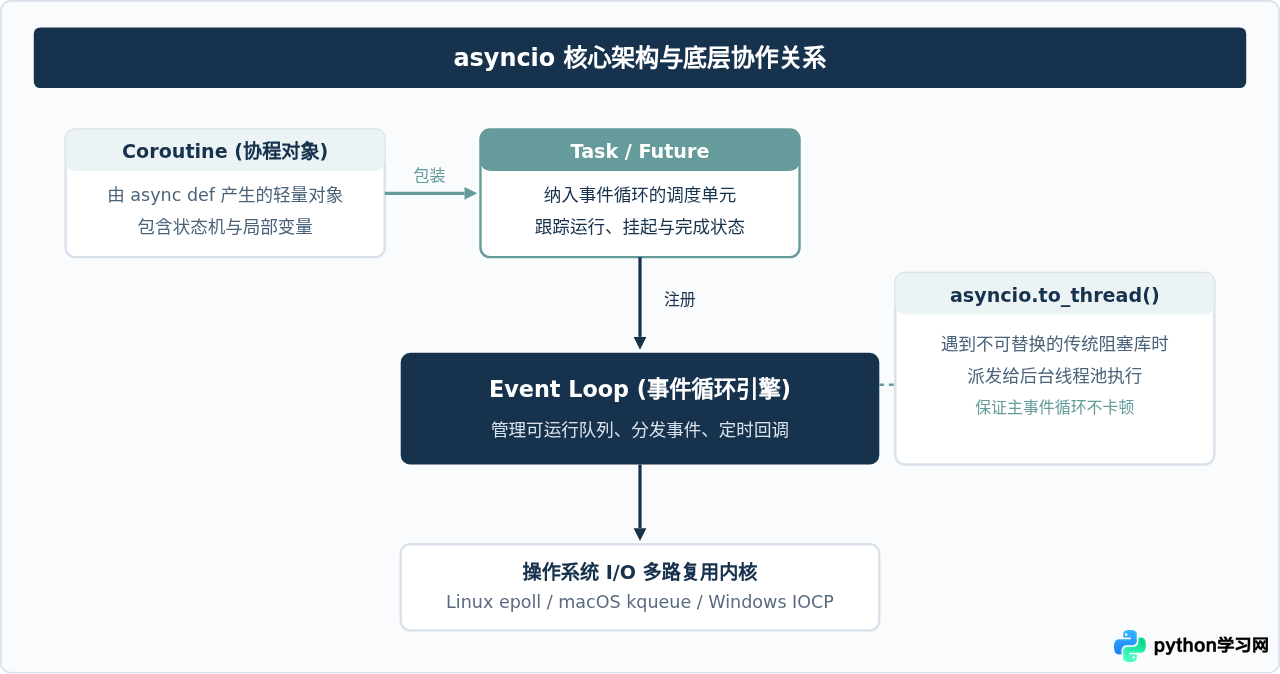
为了在遇到问题时具备排查能力,需要清晰掌握 asyncio 内部主要模块与组件的角色定位:
处理无法避免的同步阻塞库
如果项目中必须使用未提供异步接口的第三方库(例如某些遗留硬件 SDK、专有数据库驱动或繁重的本地图像解码),可以使用 Python 3.9+ 提供的 asyncio.to_thread()。该函数会将阻塞操作丢给内置的线程池执行,并在执行完毕后将结果封装为 Future 返回事件循环,避免了主事件循环被单点阻塞:
import asyncio
import time

def legacy_blocking_task(n: int) -> str:
    # 模拟某个无法改造为 async 的陈旧阻塞函数
    time.sleep(1)
    return f"Done: {n}"

async def main():
    # 借助 to_thread 将同步调用放入后台线程池
    result = await asyncio.to_thread(legacy_blocking_task, 42)
    print(result)

if __name__ == "__main__":
    asyncio.run(main())
五、高并发 I/O 常见误区与避坑方案
在高并发实际部署与运行过程中,有四个极易出现的问题需要特别注意:
| 常见问题表现 | 根本原因 | 推荐解决方案 |
|---|---|---|
| 代码写了 async 但总耗时未降低 | 在协程内调用了 time.sleep 或 requests.get 等同步阻塞函数,阻塞了整个事件循环线程。 |
全面替换为 asyncio.sleep 和 aiohttp/httpx;无法替换的放进 asyncio.to_thread。 |
| 运行中报错 Too many open files | 一次性创建上万个任务并发建立 TCP 连接,耗尽了操作系统分配的文件描述符上限。 | 使用 asyncio.Semaphore(100) 控制最大并发峰值,复用 ClientSession 连接池。 |
| 单个任务出错导致所有抓取中断 | 直接 await asyncio.gather(*tasks),默认遇到首个未处理异常立即抛出终止。 |
设置 gather(..., return_exceptions=True),或使用 Python 3.11+ 的 asyncio.TaskGroup 进行结构化异常捕获。 |
| 程序退出时报 Task was destroyed but it is pending | 主函数提前 return,事件循环直接关闭,留下了未执行完的后台子任务。 | 确保所有创建的 Task 都经过 await 等待完成,或在关闭前显式 cancel 并等待其清理。 |
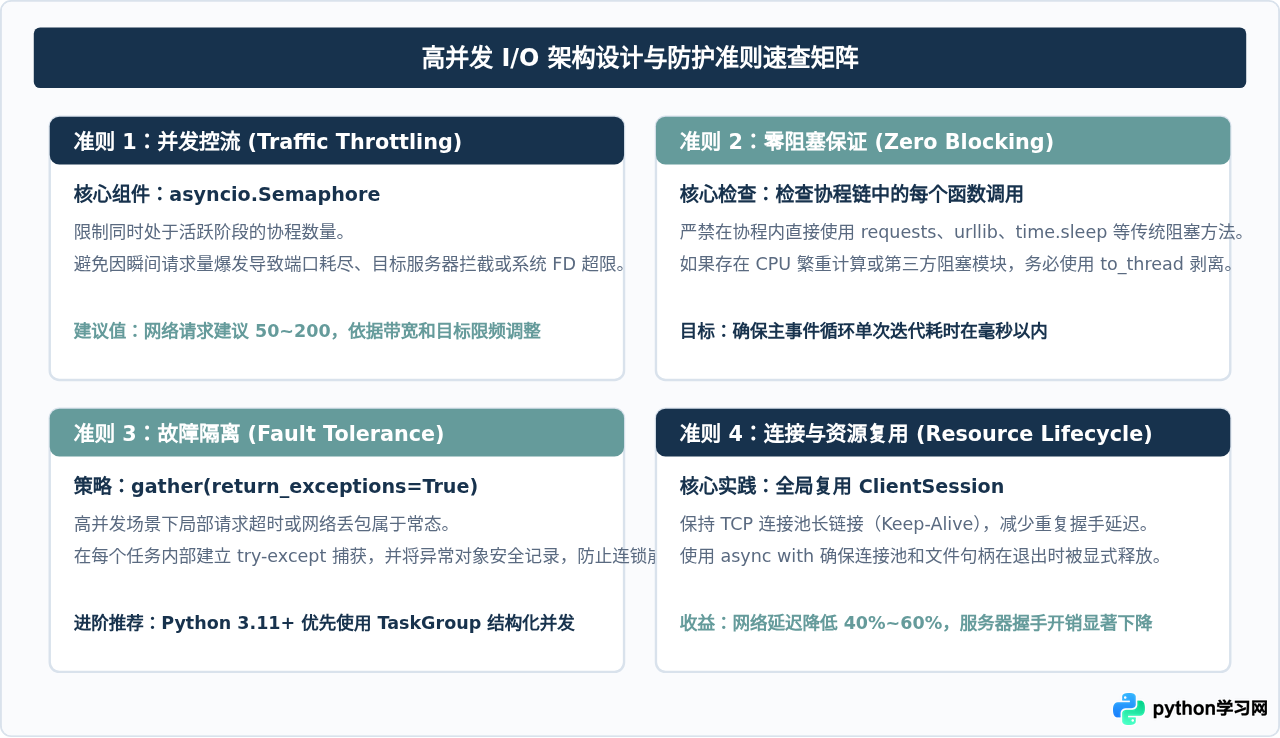
六、总结
使用 Python 的 asyncio 实现高并发 I/O 操作的核心并不复杂:通过 async def 定义任务逻辑,在每个 I/O 节点用 await 挂起让出执行权,利用 asyncio.gather 批量推进任务执行,并借助 asyncio.Semaphore 设定合理的并发吞吐上限。只要严格杜绝在协程中混入同步阻塞方法,并做好单点异常捕获与连接池复用,就能以极低的系统资源消耗构建出稳健、高效的高并发程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









