

Python正则验证表单输入是否仅含中文汉字
在用户注册、实名认证、发票抬头填写或收件人姓名等业务表单中,服务端经常需要校验输入内容是否为纯中文汉字。如果用户误填了英文字母、数字、标点符号或混杂了不可见空格,未加限制的数据直接入库就会引发后续检索混乱、凭证打印异常或接口调用报错。验证此需求最标准且高效的方法是借助 Python 内置的 re 模块,搭配 Unicode 汉字编码区间正则 ^[\u4e00-\u9fa5]+$ 进行全匹配判定。
一、核心解决方案与执行流程
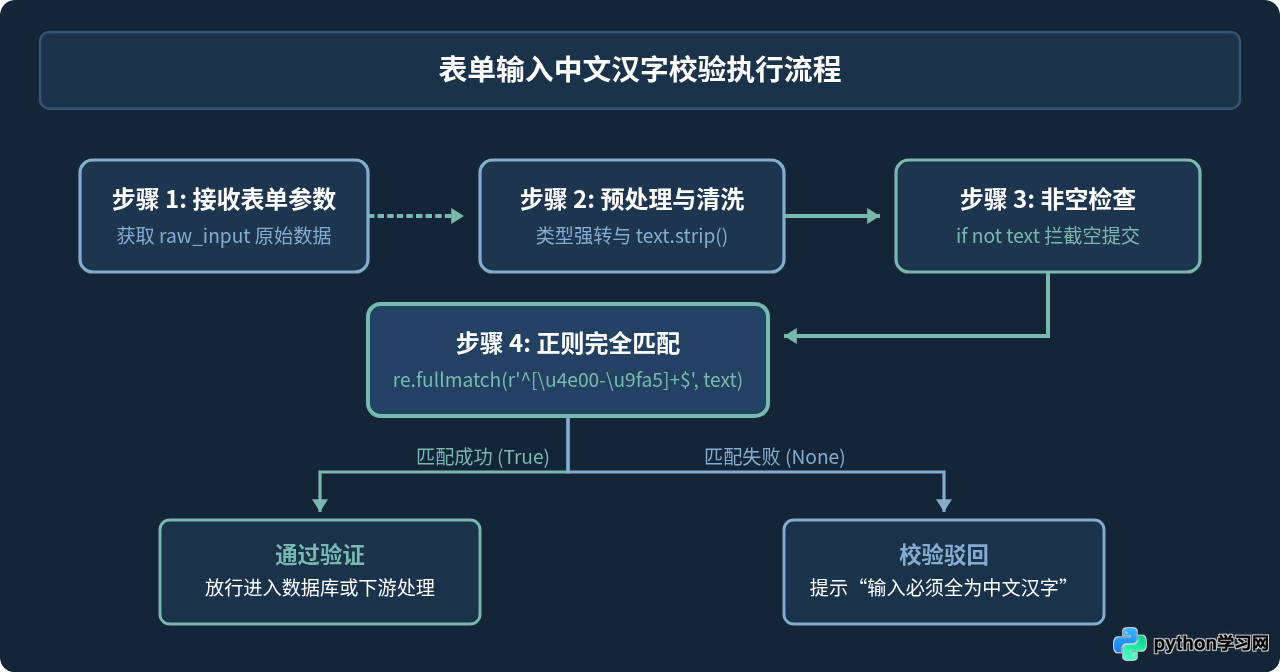
要确认一个字符串“仅包含中文汉字”,需同时满足三个约束:字符串非空、起始到结束的所有字符均位于 Unicode 的 CJK 统一表意文字基本区(4E00 至 9FA5)、不含有任何空白字符或标点。标准的处理链条包含:表单数据类型防御、空白字符修剪(Strip)、非空检查以及正则表达式完全匹配。
二、正则表达式语法与 Unicode 汉字范围拆解
用来验证仅含汉字的表达式为:^[\u4e00-\u9fa5]+$。很多初学者常因误解元字符的含义,导致部分包含汉字的混合字符串被误判为通过。理解该表达式必须逐个构件拆分:
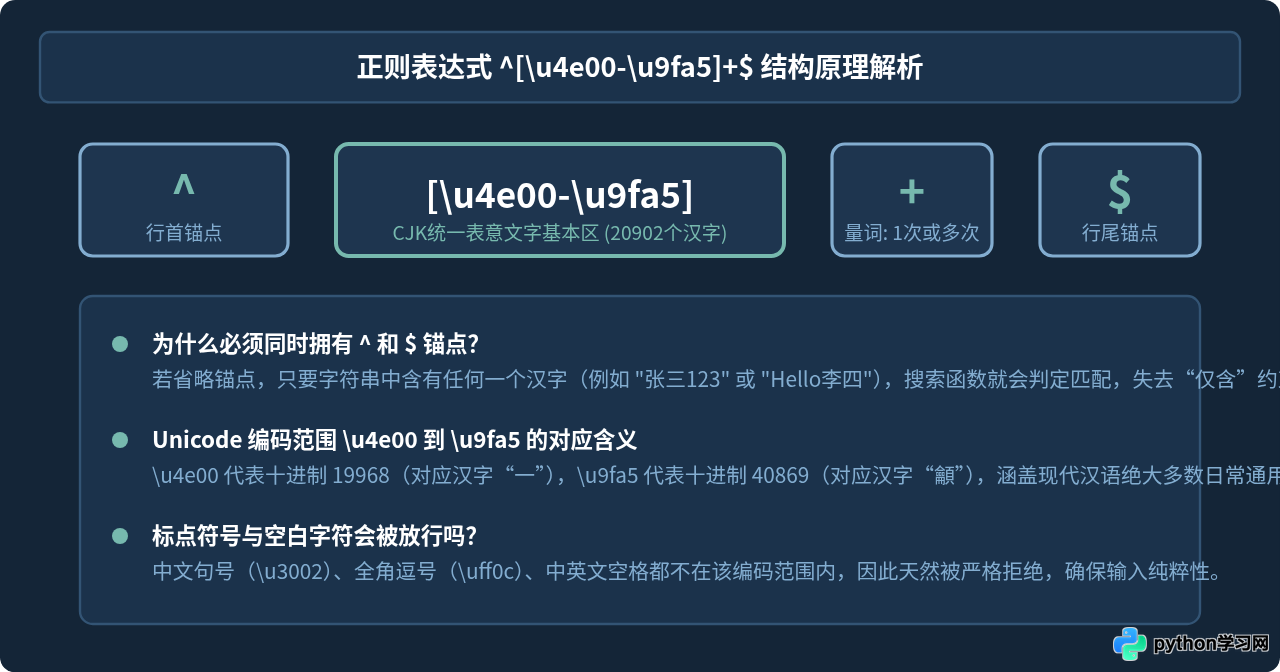
值得注意的是,在现代 Unicode 扩充规范中,CJK 统一表意文字扩展区涵盖了更多的古籍生僻字(如扩展 A 区 \u3400-\u4dbf 等)。但在常规商业表单(如人名、普通地址填报)中,\u4e00-\u9fa5 已覆盖 20902 个基本汉字,满足绝大多数生产环境的需求。如需兼容最新扩展汉字,可扩大范围至 \u4e00-\u9fff。
三、Python 代码实现与函数封装
在 Python 中,建议使用 re.compile() 对正则表达式进行预编译,尤其是在 Web 后端高并发接收表单的场景下,可以避免重复编译正则模式,降低 CPU 开销。此外,Python 3.4+ 提供了专门的 re.fullmatch() 方法,相比传统的 re.match(),它的语义更清晰,专用于整段字符串的全量匹配。
import re

# 1. 预编译纯汉字正则表达式模式
CHINESE_PATTERN = re.compile(r'^[\u4e00-\u9fa5]+$')

def is_pure_chinese(input_val: str, strip_spaces: bool = True) -> bool:
    """
    验证输入内容是否为纯中文汉字
    :param input_val: 待验证的输入值(允许接收字符串或表单对象)
    :param strip_spaces: 是否自动修剪首尾空白字符
    :return: 验证通过返回 True,否则返回 False
    """
    # 防御非字符串类型输入(如前端传入的 None, int, dict 等)
    if not isinstance(input_val, str):
        return False

    # 依据业务设定清洗首尾空格
    target = input_val.strip() if strip_spaces else input_val

    # 拦截清洗后的空字符串(表单只填空格的情况)
    if not target:
        return False

    # 使用 fullmatch 确保从首到尾完全符合模式
    return bool(CHINESE_PATTERN.fullmatch(target))


# --- 验证测试用例 ---
if __name__ == "__main__":
    test_cases = [
        ("张三", True),
        ("王小明", True),
        (" 李四 ", True),       # 经过 strip 处理后为纯汉字
        ("John", False),        # 纯英文字符
        ("王5", False),          # 汉字夹带数字
        ("张·三", False),       # 夹带少数民族姓名间隔符或标点
        ("李,四", False),      # 夹带中文全角标点
        ("   ", False),         # 纯空白字符
        ("", False),            # 空串
        (None, False),          # 非字符串对象
    ]

    for raw, expected in test_cases:
        res = is_pure_chinese(raw)
        assert res == expected, f"测试未通过: {raw} -> 结果: {res}, 期望: {expected}"

    print("所有测试用例校验完毕,结果符合预期!")
四、输入场景用例对比与判定矩阵
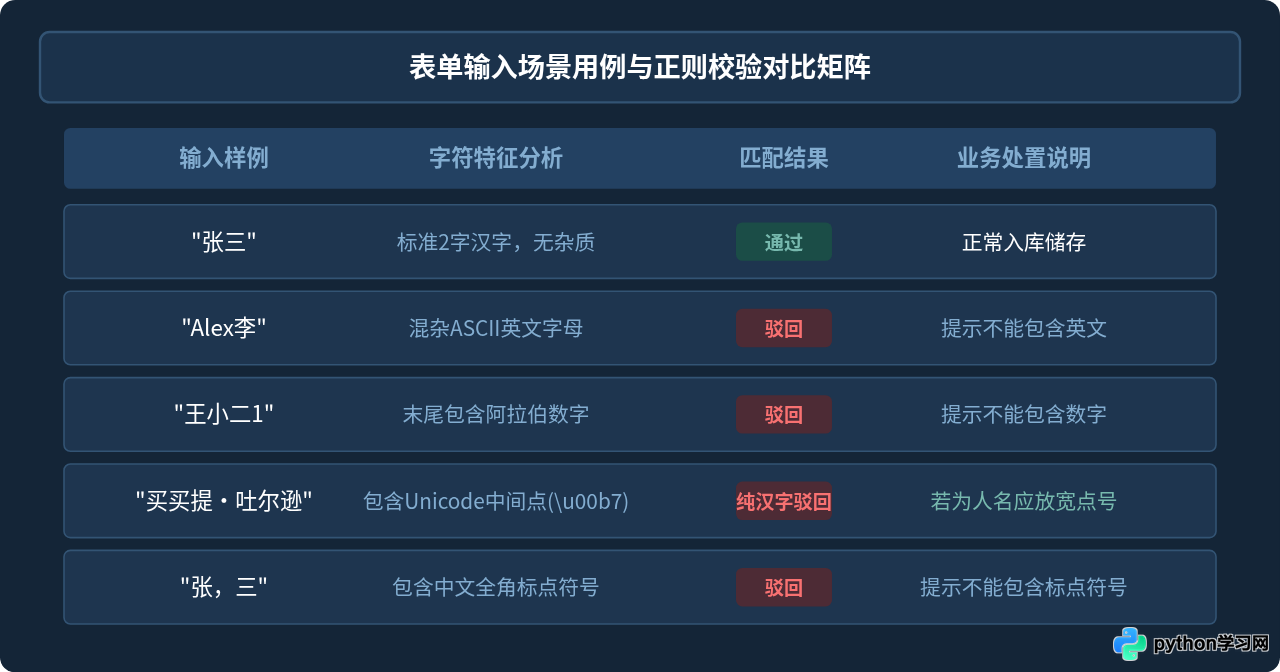
在实际运营中,用户输入具有多样性。表单接收端必须明确了解不同输入在正则下的判定结果,避免因业务规则模糊引发纠纷:
业务提醒:人名场景下的“点号”特殊情况
如果表单字段是“真实姓名”,维吾尔族、蒙古族、哈萨克族等同胞的姓名中通常含有间隔号“·”(Unicode 为 \u00b7 或 \u30fb)。纯汉字正则会将其判定为非法。如果业务为实名姓名输入,建议改用兼顾间隔号的规则:^[\u4e00-\u9fa5]+(·[\u4e00-\u9fa5]+)*$;如果业务严格要求全为汉字(如特定编号的中文大写金额、汉字词语默写等),则坚决保留 ^[\u4e00-\u9fa5]+$。
五、Web 框架表单验证实战(以 Flask 为例)
在真实的 Web 项目中,校验通常集成在控制器(Controller)或视图函数中。以下展示如何在 Flask API 中接收表单 JSON 数据并完成汉字验证:
from flask import Flask, request, jsonify
import re

app = Flask(__name__)

# 预编译正则模式
PURE_CHINESE_PATTERN = re.compile(r'^[\u4e00-\u9fa5]+$')

@app.route('/api/submit_profile', methods=['POST'])
def submit_profile():
    data = request.get_json(silent=True) or {}

    # 提取表单中的中文籍贯字段
    native_place = data.get('native_place')

    # 1. 基础存在性校验
    if native_place is None:
        return jsonify({"code": 400, "message": "籍贯字段不能为空"}), 400

    if not isinstance(native_place, str):
        return jsonify({"code": 400, "message": "籍贯参数类型非法"}), 400

    cleaned_place = native_place.strip()

    # 2. 长度校验(例如限制在 2 到 20 个字之间)
    if len(cleaned_place) < 2 or len(cleaned_place) > 20:
        return jsonify({"code": 400, "message": "籍贯长度需在2至20个字之间"}), 400

    # 3. 纯汉字正则校验
    if not PURE_CHINESE_PATTERN.fullmatch(cleaned_place):
        return jsonify({
            "code": 422,
            "message": "籍贯只能包含中文汉字,不能含有数字、英文、空格或标点"
        }), 422

    # 校验全部通过,执行后续逻辑
    return jsonify({
        "code": 200,
        "message": "校验通过",
        "data": {"native_place": cleaned_place}
    })
六、工程实践避坑与最佳实践总结
要在生产系统中稳定运行中文表单校验,开发者应遵循以下四项核心实践原则:
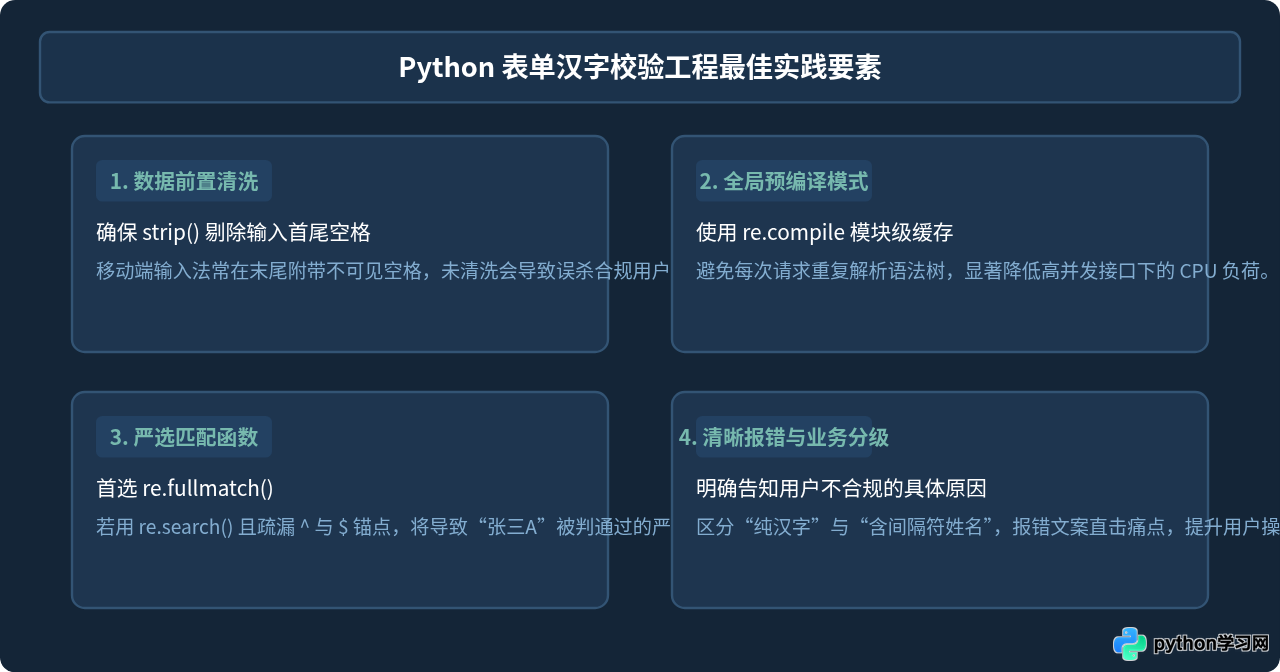
总结而言,验证表单输入是否仅含中文汉字,核心在于采用 re.compile(r'^[\u4e00-\u9fa5]+$') 搭配 fullmatch 方法,并在判定前落实 strip() 过滤空白和类型防御。遵循这套标准流程,既能准确保障数据合规性,又能避免由于边界情况造成的用户体验受损。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









