

Python多线程常见陷阱:死锁成因分析与排查方法
faulthandler 和 py-spy 工具提取假死线程的真实堆栈,并在代码层面建立严格的加锁顺序与超时控制机制。
一、死锁产生的本质与四大必要条件
Python 的全局解释器锁(GIL)确保了同一时刻只有一个原生线程在执行 Python 字节码,但这仅保证了解释器内部数据结构的线程安全,并不防止用户代码级别的互斥锁竞争问题。当多线程通过 threading.Lock 保护关键数据时,逻辑设计不当依然会触发标准操作系统级别的死锁。
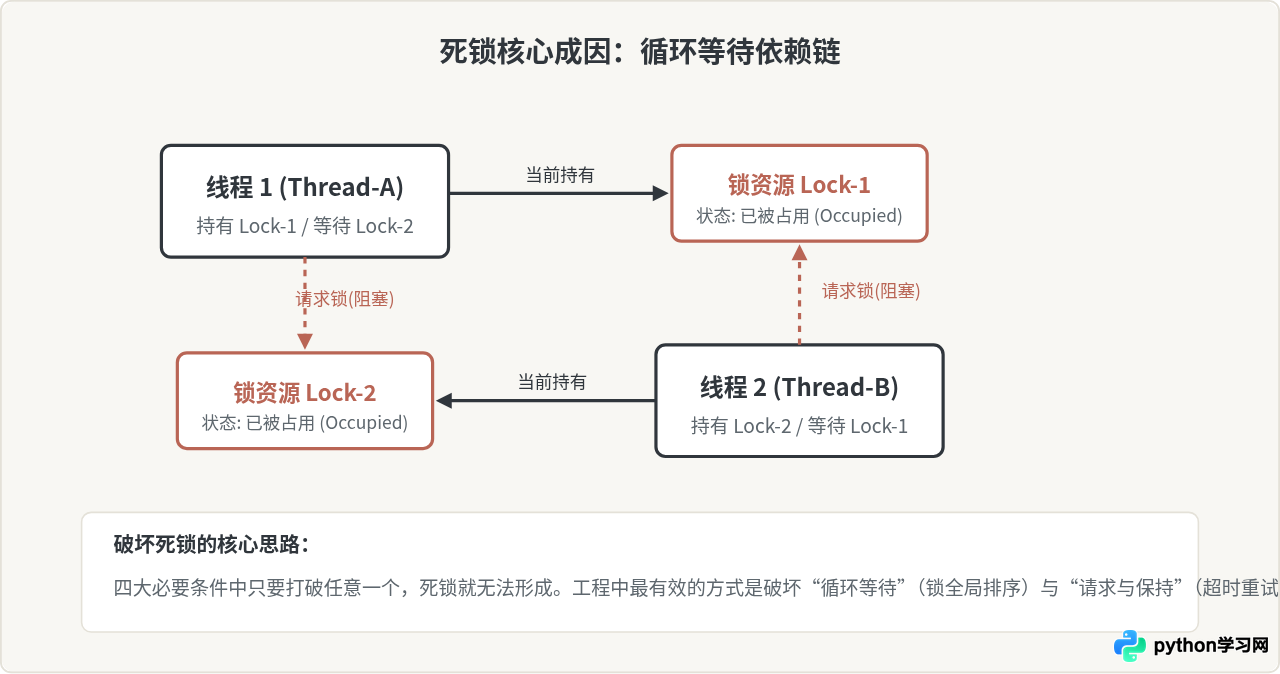
计算机科学理论指出,死锁只有在以下四个条件同时满足时才会发生:
- 互斥条件(Mutual Exclusion):资源具有独占性,一个互斥锁在同一时刻只能被一个线程持有。
- 请求与保持条件(Hold and Wait):一个线程已持有了至少一个锁,但在未释放既有锁的前提下,又发起了对新锁的获取请求。
- 不剥夺条件(No Preemption):线程已获得的锁资源不能被操作系统或其他线程强制剥夺,只能由持有它的线程显式释放。
- 循环等待条件(Circular Wait):存在一个线程等待环路,例如线程 1 等待线程 2 持有的锁,而线程 2 也在等待线程 1 持有的锁。
二、Python 多线程三大典型死锁场景剖析
在日常业务开发中,死锁极少以简单显式的方式出现,往往隐藏在复杂的业务调用链、重入调用或异常分支中。以下是三种最常见的高危场景:
场景 1:相反加锁顺序导致交叉互锁(AB-BA 死锁)
这是最普遍的死锁形式。两个不同的线程都需要获取两个锁,但代码中获取锁的先后次序不一致:
import threading
import time

lock_a = threading.Lock()
lock_b = threading.Lock()

def worker_one():
    with lock_a:
        time.sleep(0.1)  # 模拟执行耗时,增加冲突窗口
        with lock_b:
            print("Worker 1 完成任务")

def worker_two():
    with lock_b:
        time.sleep(0.1)
        with lock_a:
            print("Worker 2 完成任务")

# 启动后,两个线程各自持有一把锁,并无限等待对方释放另一把锁
t1 = threading.Thread(target=worker_one)
t2 = threading.Thread(target=worker_two)
t1.start()
t2.start()
t1.join()
t2.join()成因分析:worker_one 已经锁定了 lock_a 并请求 lock_b,而 worker_two 锁定了 lock_b 并请求 lock_a。由于两把锁均处于占用状态且不释放,满足全部四个必要条件,进程彻底卡死。
场景 2:不可重入锁引起的自我死锁
Python 标准库的 threading.Lock 是不可重入互斥锁。如果同一个线程在未释放该锁的情况下再次尝试获取该锁,就会发生自我死锁:
import threading

mutex = threading.Lock()

def inner_operation():
    with mutex:
        print("执行内部敏感操作")

def outer_operation():
    with mutex:
        print("外部流程开始")
        inner_operation()  # 再次获取同一把锁,导致自身永久阻塞

outer_operation()成因分析:同一线程再次调用 mutex.acquire() 时,底层计数器无法重入,当前线程被置入该锁的等待队列并挂起,由于挂起者正是持有者,锁永远得不到释放。
场景 3:异常分支未正确释放锁资源
未使用上下文管理器(with lock:)而显式调用 acquire() 与 release() 时,若中间代码抛出未捕获异常,将导致锁遗失释放机会:
import threading

data_lock = threading.Lock()

def faulty_process():
    data_lock.acquire()
    # 模拟在释放前抛出意外错误
    result = 10 / 0
    data_lock.release()  # 永远不会被执行
后继线程一旦尝试调用 data_lock.acquire(),就会无休止阻塞。
三、现场排查实操:多线程假死定位四步法
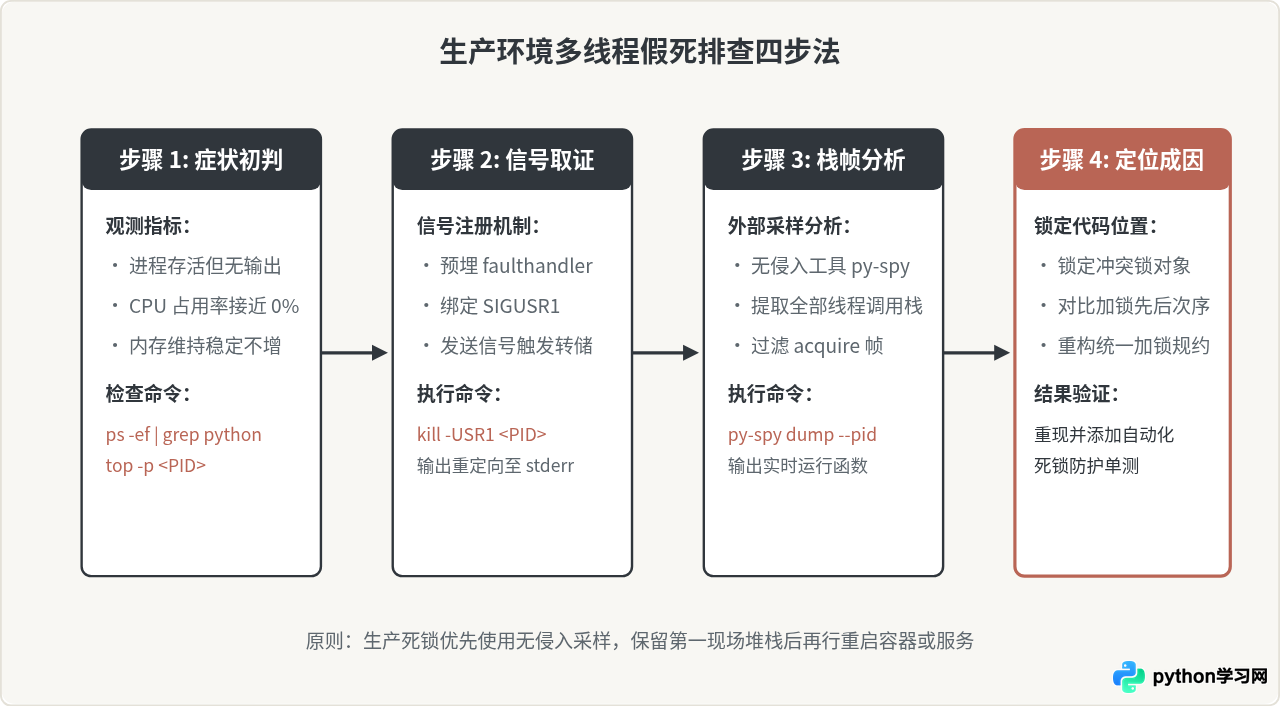
当服务运行在生产环境中出现假死(CPU 占用降为 0、接口无响应、日志停滞)时,严禁盲目重启。必须先抓取现场线程调用栈,定位死锁发生的具体文件与行号。
方法一:通过内置 faulthandler 模块注册信号转储
Python 3.3+ 自带 faulthandler 模块,允许我们向运行中的进程发送操作系统信号(Linux/macOS 下支持 SIGUSR1),直接将所有活动线程的当前执行栈打印到标准错误或指定文件。
import faulthandler
import signal
import sys

# 服务启动时预先注册信号监听
def enable_deadlock_dump():
    # 将所有线程堆栈输出至标准错误输出
    faulthandler.register(signal.SIGUSR1, file=sys.stderr, all_threads=True)

# 业务启动主入口调用
enable_deadlock_dump()
当服务发生假死时,在宿主机或容器内直接执行命令触发转储:
# 获取假死进程 PID 并发送 USR1 信号
kill -USR1 <PID>
此时控制台或日志文件将输出类似于以下的堆栈追踪(示例):
Current thread 0x000070000a1bc000 (most recent call first):
  File "app/service.py", line 45 in worker_two
    lock_a.acquire()
  File "/usr/local/lib/python3.10/threading.py", line 1015 in run
  File "/usr/local/lib/python3.10/threading.py", line 1078 in _bootstrap_inner

Current thread 0x00007000099b9000 (most recent call first):
  File "app/service.py", line 32 in worker_one
    lock_b.acquire()
  File "/usr/local/lib/python3.10/threading.py", line 1015 in run
  File "/usr/local/lib/python3.10/threading.py", line 1078 in _bootstrap_inner
只要发现两个或多个线程的顶层堆栈都停在 acquire() 且互相关联的锁资源在彼此的作用域内部,即可精准定位到死锁的代码行号。
方法二:使用外部无侵入工具 py-spy 现场采样
如果现有服务没有预先配置 faulthandler,不能为了调试而重启服务。此时推荐使用 Rust 编写的无侵入式分析工具 py-spy。它通过检查目标进程的内存段,实时读取 Python 解释器的执行状态,无需修改被测程序代码:
# 1. 安装 py-spy 工具(可在运维宿主机上安装)
pip install py-spy

# 2. 直接对处于假死状态的 PID 生成即时线程调用栈 dump
py-spy dump --pid <PID>
py-spy dump 会列出当前所有线程的活跃函数、行号以及局部调用栈。寻找所有处于 acquire() 状态的线程即可迅速厘清阻塞点。
四、死锁的工程规避方案与最佳实践
定位并修复一个既有死锁只是应急措施,在并发系统架构设计中,必须通过规范杜绝死锁的生存空间。
规程 1:始终保持全局一致的加锁次序(Lock Ordering)
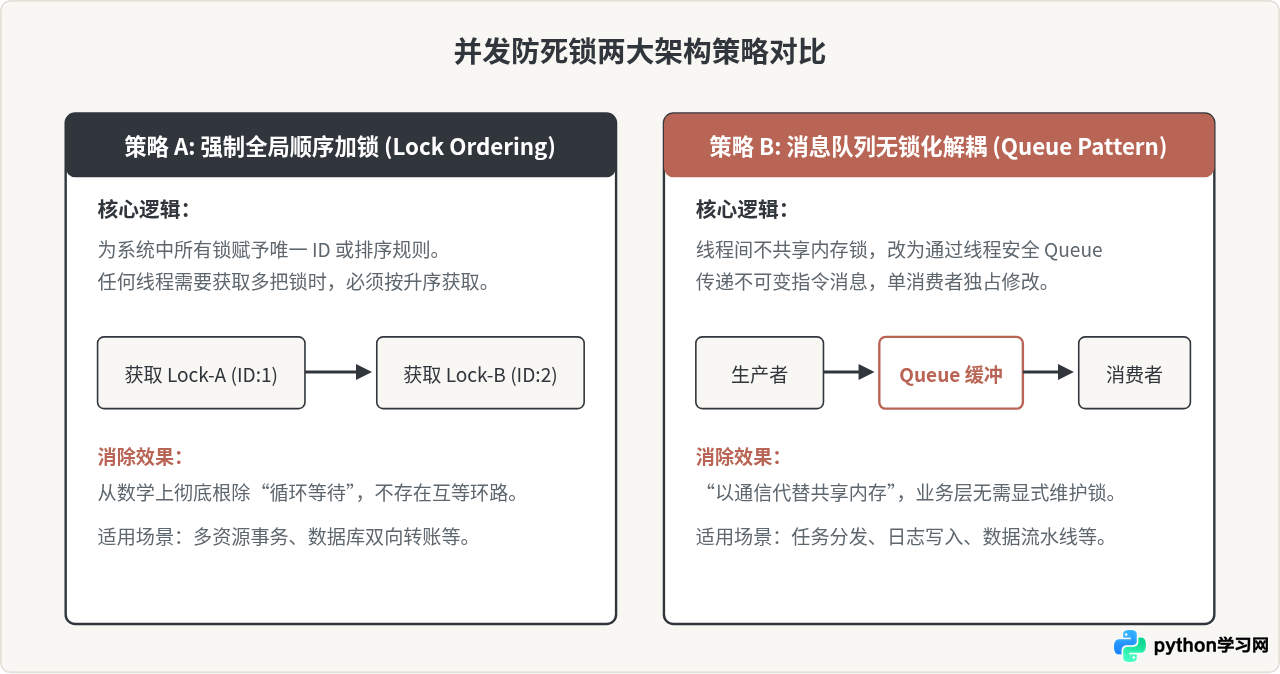
以经典的银行转账为例,如果每个线程根据“源账户 -> 目标账户”加锁,当账户 A 转账给账户 B,同时账户 B 转账给账户 A 时,就会形成 AB-BA 死锁。规避方法是根据账户的唯一标识符(如账户 ID)进行排序后再加锁:
from contextlib import contextmanager

def transfer(account_from, account_to, amount):
    # 强制按照 ID 升序排列加锁次序
    first_lock = account_from.lock if account_from.id < account_to.id else account_to.lock
    second_lock = account_to.lock if account_from.id < account_to.id else account_from.lock

    with first_lock:
        with second_lock:
            account_from.balance -= amount
            account_to.balance += amount
所有线程无论调用顺序如何,都必须按相同的物理顺序获取锁,从根本上打破“循环等待”条件。
规程 2:为不可确定耗时的加锁加入超时机制(Timeout)
严禁在可能出现死锁的复杂业务路径中使用无期限的 acquire()。通过传入超时时间,可以在发生死锁风险时让线程主动回退,释放已持有锁后重试:
import threading
import time

def acquire_multiple_locks_with_timeout(locks, timeout=3.0):
    deadline = time.time() + timeout
    acquired_locks = []
    try:
        for lock in locks:
            remaining_time = deadline - time.time()
            if remaining_time <= 0 or not lock.acquire(timeout=remaining_time):
                # 获取锁超时,触发快速失败与全面回退
                return False
            acquired_locks.append(lock)
        return True
    finally:
        # 如果中途失败,必须倒序释放已成功获取的所有锁
        if len(acquired_locks) != len(locks):
            for lock in reversed(acquired_locks):
                lock.release()
规程 3:合理使用可重入锁 threading.RLock
如果模块内的公共方法需要加锁,且这些方法可能在持有锁的情况下被其他带有相同锁的方法调用,应将 threading.Lock 替换为 threading.RLock。RLock 内部维护了持有线程所有者 ID 和嵌套深度计数器,同一个线程多次获取不会发生阻塞,只需确保 acquire() 与 release() 次数配对即可。
五、总结与排查决策速查
解决多线程并发问题,预防的工程价值远高于事后排查。下表汇总了常见死锁风险点、对应表现与预防手段:
| 场景类型 | 典型触发特征 | 排查优先工具 | 工程修复建议 |
|---|---|---|---|
| 交叉竞争死锁 | 多线程加锁次序不固定,偶发卡死 | py-spy dump / faulthandler |
强制按对象全局唯一 ID 排序加锁 |
| 嵌套自我死锁 | 同一函数链内反复调用受锁保护方法 | 查看当前线程单一栈帧内重复锁入口 | 重构为 threading.RLock 或剥离内部无锁方法 |
| 异常遗漏释放 | 某次报错后,后续任务全线挂起 | 日志中出现未捕获异常,随后线程池枯竭 | 严格使用 with lock: 上下文管理器 |
| 长事务持锁竞争 | 锁内部包含外部 HTTP 请求或大磁盘读写 | 线程大量堆积在等待队列,并发吞吐暴跌 | 缩小临界区范围,网络 IO 严禁放入锁内 |
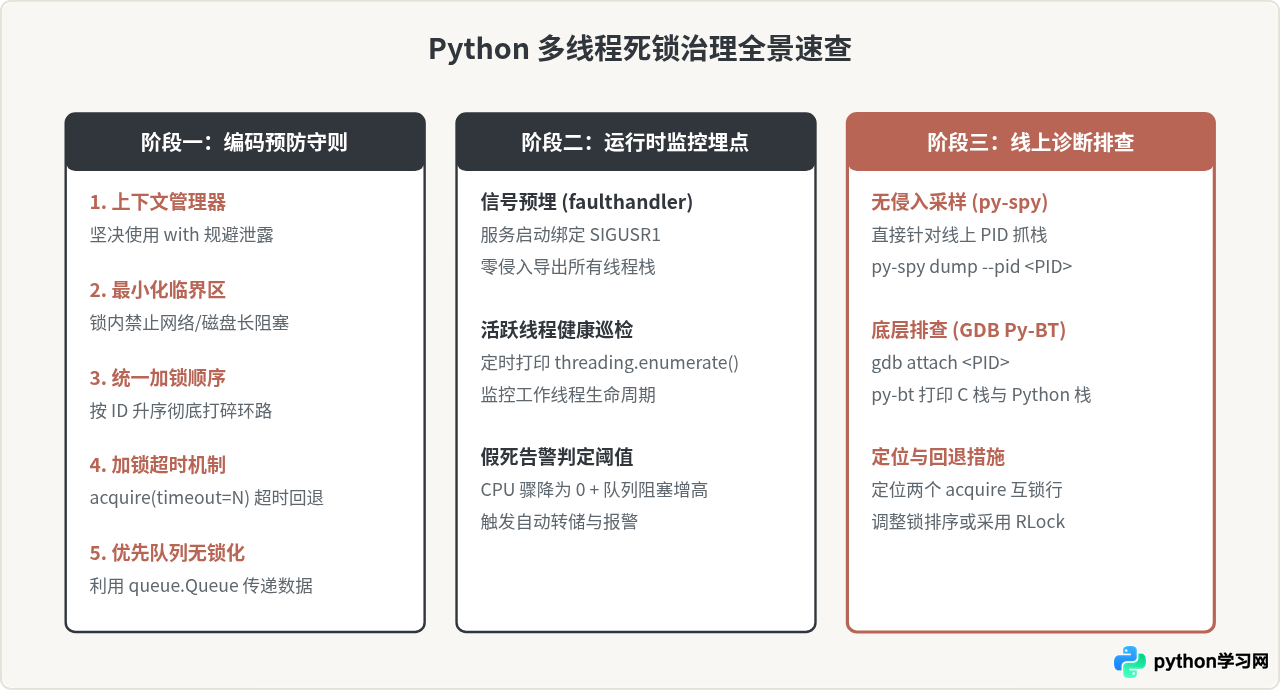
在编写多线程代码时,应时刻对持锁状态保持警惕。优先考虑数据流水线和消息队列解耦;必须使用锁时,严格落实“全局有序加锁”、“上下文管理器释放”以及“超时回退”,即可在工程实践中彻底规避死锁陷阱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









