

Python机器学习入门:环境搭建与第一个模型实战
在本地搭建一套干净隔离的 Python 机器学习开发环境,并运行一个能够根据规律做出预测的基线模型,是进入机器学习实践领域最直接的起点。本文将介绍如何使用 Python 自带的 venv 工具构建独立的虚拟环境,规范安装 NumPy、Pandas 与 Scikit-Learn 等基础科学计算依赖,并通过经典的有监督学习任务,完整实现数据切分、模型拟合、预测输出与性能评估全流程。
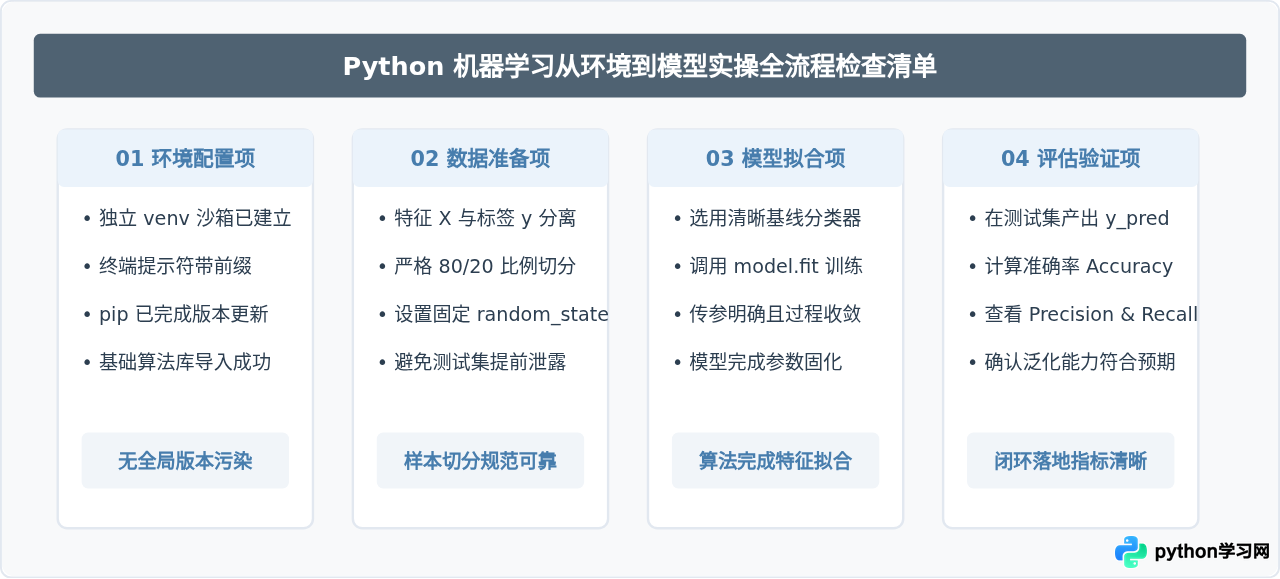
准备独立的 Python 虚拟开发环境
不同机器学习项目往往依赖不同版本的算法库与底层编译组件。直接在系统全局 Python 环境中安装第三方库,容易引发包版本冲突并导致难以排查的运行报错。使用虚拟环境可以在项目根目录下创建相互隔离的 Python 运行时环境,保持系统环境的清洁与依赖版本的可复现性。
首先打开系统终端(Windows 平台推荐使用 PowerShell 或命令提示符,macOS 与 Linux 用户使用原生终端),确认系统已安装 3.8 及以上版本的 Python:
python3 --version确认解释器正常后,进入你的代码工程工作目录,执行内置模块 venv 创建名为 ml_env 的虚拟环境:
python3 -m venv ml_env创建完成后,目录中会出现一个包含独立 Python 二进制文件与基础标准库的文件夹。在进行任何包安装操作之前,必须先将其激活:
# macOS / Linux 平台执行:
source ml_env/bin/activate

# Windows 平台执行:
ml_env\Scripts\activate
终端提示符前出现 (ml_env) 前缀即表明虚拟环境激活成功。接着更新包管理器 pip,并安装机器学习入门所需的核心第三方依赖:
pip install --upgrade pip
pip install numpy pandas scikit-learn matplotlib
安装完成后,可通过一行简短的测试命令验证各库是否能被 Python 正确导入并打印版本:
python -c "import numpy as np, pandas as pd, sklearn; print('NumPy:', np.__version__); print('Pandas:', pd.__version__); print('Scikit-Learn:', sklearn.__version__)"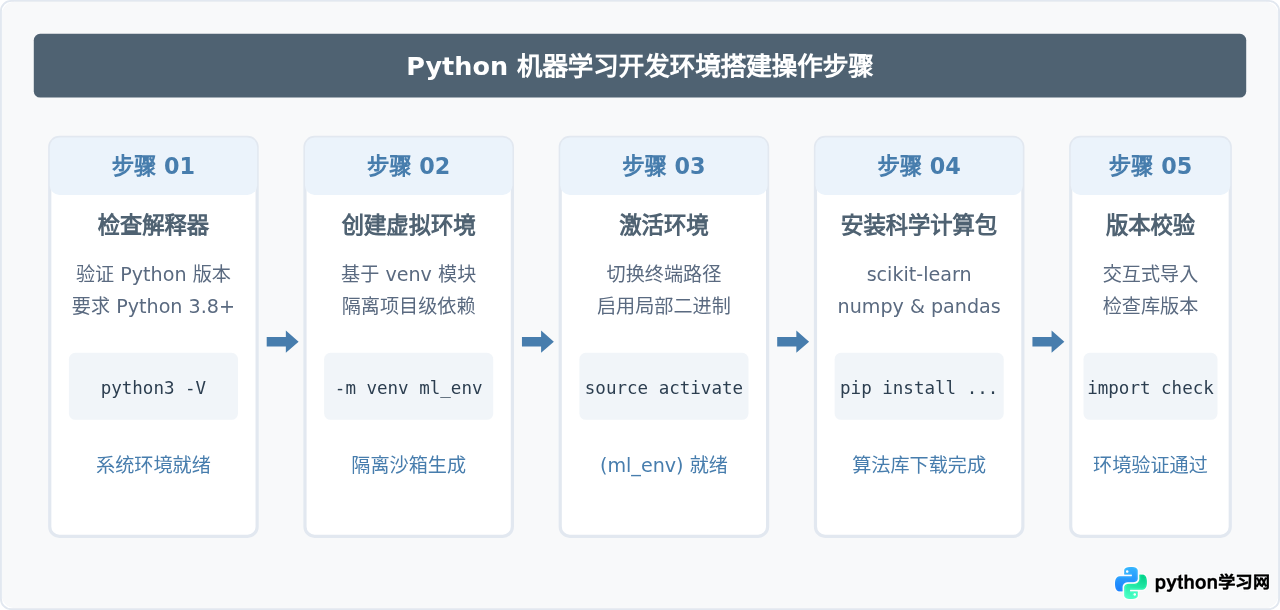
理解机器学习的核心解决范式
传统软件工程通过人工编写确定性逻辑(即 输入 + 规则 = 输出)来处理业务。而机器学习面对的大多是规则极其复杂、难以穷举表达的问题(例如图像中物体的识别或根据多种属性预测房价)。
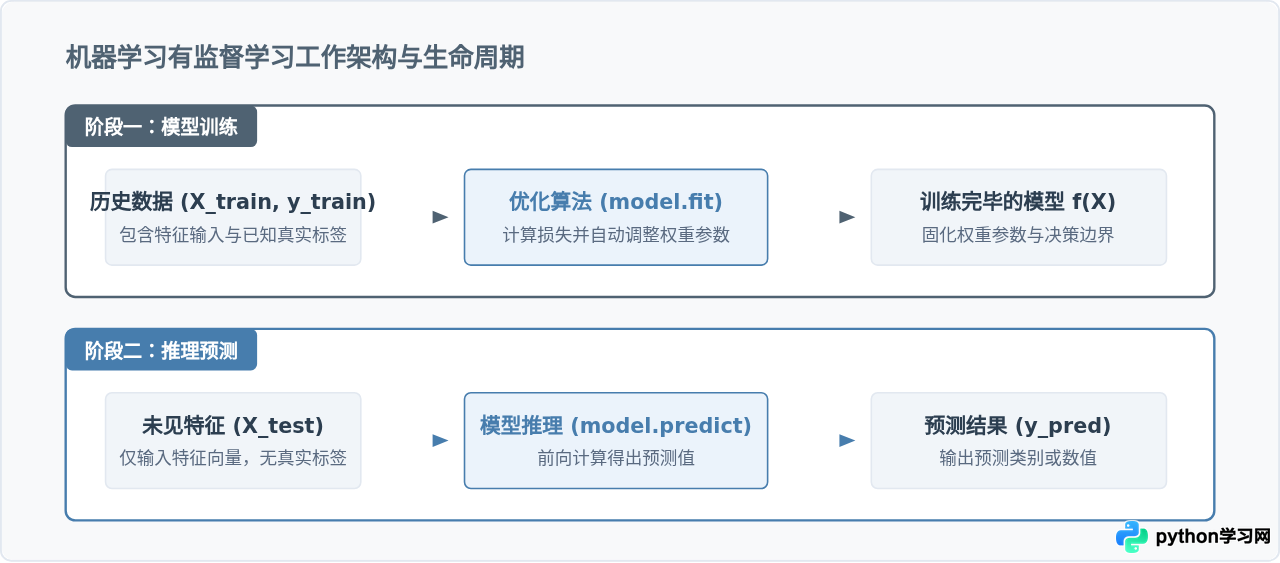
机器学习的核心思路是利用算法自动从已有数据中学习规律,即 输入数据 + 期望输出 = 映射规则模型。在最经典的有监督学习(Supervised Learning)中:
- 特征矩阵(X):描述观察对象的各项维度数据(如花瓣长度、面积、房屋居室数)。
- 标签向量(y):目标预测结果(如花朵类别或房屋销售价格)。
- 模型拟合(Fit):算法根据 X 与 y 自动调整自身内部参数,使得模型输出与真实标签之间的误差最小化。
- 推理预测(Predict):当输入模型未见过的全新特征时,模型依据学到的参数输出预测标签。
第一个机器学习模型实战:鸢尾花分类
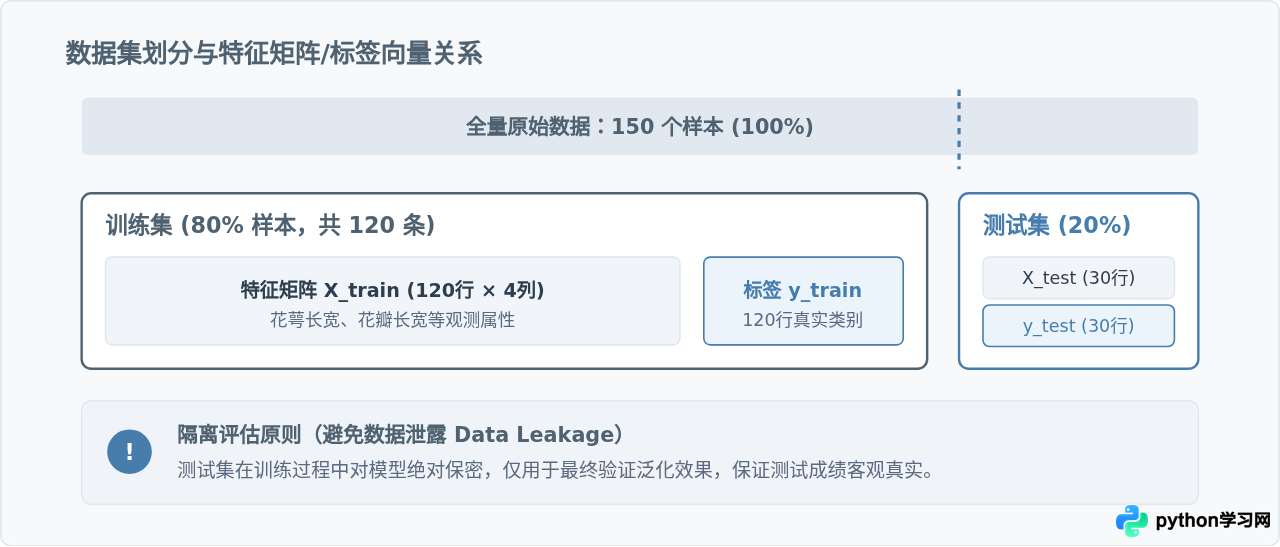
初学者上手机器学习时,推荐使用 Scikit-Learn 内置的经典鸢尾花(Iris)数据集。该数据集包含了 150 个样本,每个样本测量了花萼长度、花萼宽度、花瓣长度与花瓣宽度 4 个特征,分别对应 3 种不同品种的鸢尾花(山鸢尾、变色鸢尾、维吉尼亚鸢尾)。由于数据量适中且结构规整,非常适合用于掌握机器学习的标准流程。
数据切分与特征隔离
在将数据输入模型之前,必须将总样本划分为“训练集”和“测试集”。训练集用来让模型拟合参数,测试集则作为完全隔离的模拟考题,用于客观评估模型在未见数据上的泛化性能。如果将全部数据都用于训练,模型可能会直接记住样本细节,产生所谓的过拟合问题。
编写模型训练与评估完整代码
在已激活虚拟环境的项目目录下,新建文件 first_model.py,输入以下完整的 Python 代码:
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score, classification_report

# 1. 加载数据集
iris = load_iris()
X = iris.data
y = iris.target

print(f"特征矩阵形态: {X.shape} (样本数, 特征数)")
print(f"类别名称: {iris.target_names.tolist()}")

# 2. 划分训练集与测试集 (80% 训练,20% 测试,固定随机种子保证复现)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 实例化机器学习模型 (以经典的 K近邻分类器 为例,设定近邻数为 3)
model = KNeighborsClassifier(n_neighbors=3)

# 4. 执行模型训练 (在训练集特征与标签上拟合参数)
model.fit(X_train, y_train)

# 5. 在未参与训练的测试集上进行预测
y_pred = model.predict(X_test)

# 6. 计算并输出评估指标
accuracy = accuracy_score(y_test, y_pred)
print(f"\n测试集预测准确率 (Accuracy): {accuracy:.4f}")

# 7. 打印精细化分类评估报告
print("\n分类指标明细报告:")
print(classification_report(y_test, y_pred, target_names=iris.target_names))
在终端中直接运行该脚本:
python first_model.py从输出可以看到,模型在 30 个测试样本中准确率达到了约 96.7%。其中分类报告列出了三个核心指标:
- 精确率(Precision):被模型预测为某一类别的样本中,真正属于该类别的比例。
- 召回率(Recall):实际属于某一类别的样本中,被模型正确找出的比例。
- F1-Score:精确率与召回率的调和平均值,综合反映分类器在各类别上的平衡表现。
入门常见问题与避坑要点
初学者在完成环境配置与首次模型编写时,最容易在以下三个细节处遇到阻碍:
- 虚拟环境执行策略限制(Windows):在 Windows PowerShell 中执行
activate脚本时,若报错提示“无法加载脚本,因为系统禁止运行脚本”,只需以管理员身份打开 PowerShell 并执行Set-ExecutionPolicy -Scope CurrentUser -ExecutionPolicy RemoteSigned即可放开限制。 - 数据泄露(Data Leakage):如果后续需要对特征进行标准化缩放(如 StandardScaler),必须先调用
train_test_split拆分,然后仅在训练集上执行scaler.fit_transform(X_train),测试集必须使用训练集计算出的均值和方差执行scaler.transform(X_test)。绝对不能在切分前对全量数据直接统一做标准化。 - 过拟合与欠拟合的甄别:如果模型在训练集上准确率达到 100%,但在测试集上准确率只有 70% 甚至更低,说明模型学习了过多的训练噪声(过拟合);反之若在训练集和测试集上表现都很差,则说明模型复杂度不足或特征质量欠佳(欠拟合)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









