

Python栈方法与正则表达式匹配括号的对比

一、核心机制:自动机层面的本质差异
很多开发者在初次遇到嵌套括号解析时,直觉会尝试编写复杂的正则表达式。然而,从计算理论与编译原理来看,这是两种完全不同级别的计算模型所决定的。
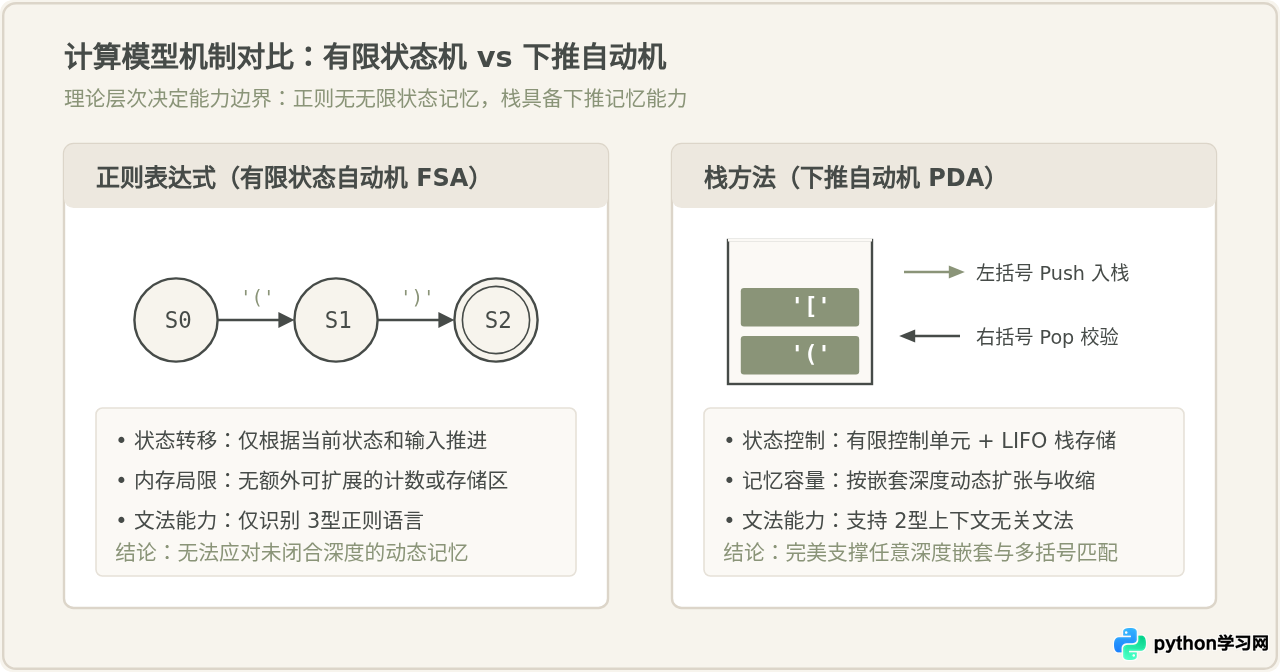
Python 原生内置的 re 模块基于有限状态自动机(FSA)。有限状态自动机的核心特征在于其内部状态数是固定且有限的。它在扫描文本时,只能通过当前状态和读取的字符跳转到下一个状态,无法动态维护一个可以无限增长的计数器,因此只能识别乔姆斯基文法分类中的“3型文法(正则文法)”。
相对而言,嵌套括号语言(数学上称为迪克语言,Dyck Language)属于“2型文法(上下文无关文法)”。要识别嵌套平衡,必须依赖具备下推存储能力的下推自动机(PDA)。在 Python 中,通过列表(List)或 collections.deque 实现的栈结构,正好提供了这种后进先出的记忆能力。
二、认知辨析:正则表达式真的完全不能匹配嵌套吗?
社区中时常有人提出类似这样的观点:“谁说正则不能匹配嵌套括号?我写一个包含了内层括号分支的正则就能匹配!”这种说法看似合理,且在特定受限条件下确实能跑通测试用例,但其成立是有严苛前提的。
例如,针对形如 (a + (b * c)) 这样最多只嵌套一层的表达式,确实可以构造出如下人工展开的正则表达式:
import re

# 匹配最多嵌套一层的括号内容
pattern = re.compile(r'\((?:[^()]|\([^()]*\))*\)')
text = "result = (10 + (2 * 3)) + (5 - 1)"
print(pattern.findall(text))
# 示例输出: ['(10 + (2 * 3))', '(5 - 1)']
上述正则之所以能工作,是因为程序员在编写模式时,人为把“内层至多只有一层括号”这一上限硬编码进了有限状态的跳转逻辑中。然而一旦面对任意层级的嵌套:
- 状态爆炸与不可维护性:若要支持至多 3 层的嵌套,正则表达式需要层层递归展开,字符长度将急剧膨胀,可读性彻底丧失;
- 无限嵌套的绝对不可达:若嵌套层数未知或可能无限(如复杂的抽象语法树或深层逻辑表达式),传统正则在数学上已证明无法匹配;
- 性能隐患:多分支嵌套的正则在面对不平衡字符串时,极易诱发灾难性回溯(Catastrophic Backtracking),导致 Python 解释器卡死甚至内存耗尽。
因此,这一做法的合理边界仅限于“已知嵌套深度严格不超过 1 层且格式非常规律”的特殊文本提取。在通用场景下,用正则挑战嵌套属于削足适履。
三、栈方法的实现方案与推导演示
使用栈匹配括号的过程十分纯粹,遵循后进先出(LIFO)逻辑。以验证多种成对括号 ()、[]、{} 是否合法的经典算法为例,执行步骤如下:
- 建立右括号到左括号的映射字典,用于常数时间
O(1)查询配对关系; - 从左到右线性遍历目标字符串中的每一个字符;
- 遇到左括号时,直接将其压入栈顶;
- 遇到右括号时,检查当前栈是否为空:若栈为空,说明该右括号没有对应的左括号,校验失败;若栈非空,弹出栈顶元素,与期望的左括号比对,若不匹配则校验失败;
- 遍历完毕后,检查栈是否为空:若为空,说明全部左括号均已得到合法闭合;若仍有残留,说明存在未闭合括号,校验失败。
def is_brackets_valid(text: str) -> bool:
    """
    使用栈结构校验字符串中括号的合法性
    支持 (), [], {} 任意深度嵌套与交错校验
    时间复杂度: O(N),空间复杂度: O(N)
    """
    mapping = {')': '(', ']': '[', '}': '{'}
    stack = []

    for char in text:
        if char in mapping.values():
            # 遇到左括号,入栈
            stack.append(char)
        elif char in mapping:
            # 遇到右括号,出栈并校验
            if not stack or stack[-1] != mapping[char]:
                return False
            stack.pop()

    # 栈完全为空表示括号全部正确匹配
    return len(stack) == 0

# 验证测试用例
test_valid = "data[(user.id + 1) * {offset: 2}]"
test_invalid = "data[(user.id + 1) * {offset: 2)]"

print("测试合规字符串:", is_brackets_valid(test_valid))      # 示例输出: True
print("测试交叉错误字符串:", is_brackets_valid(test_invalid))  # 示例输出: False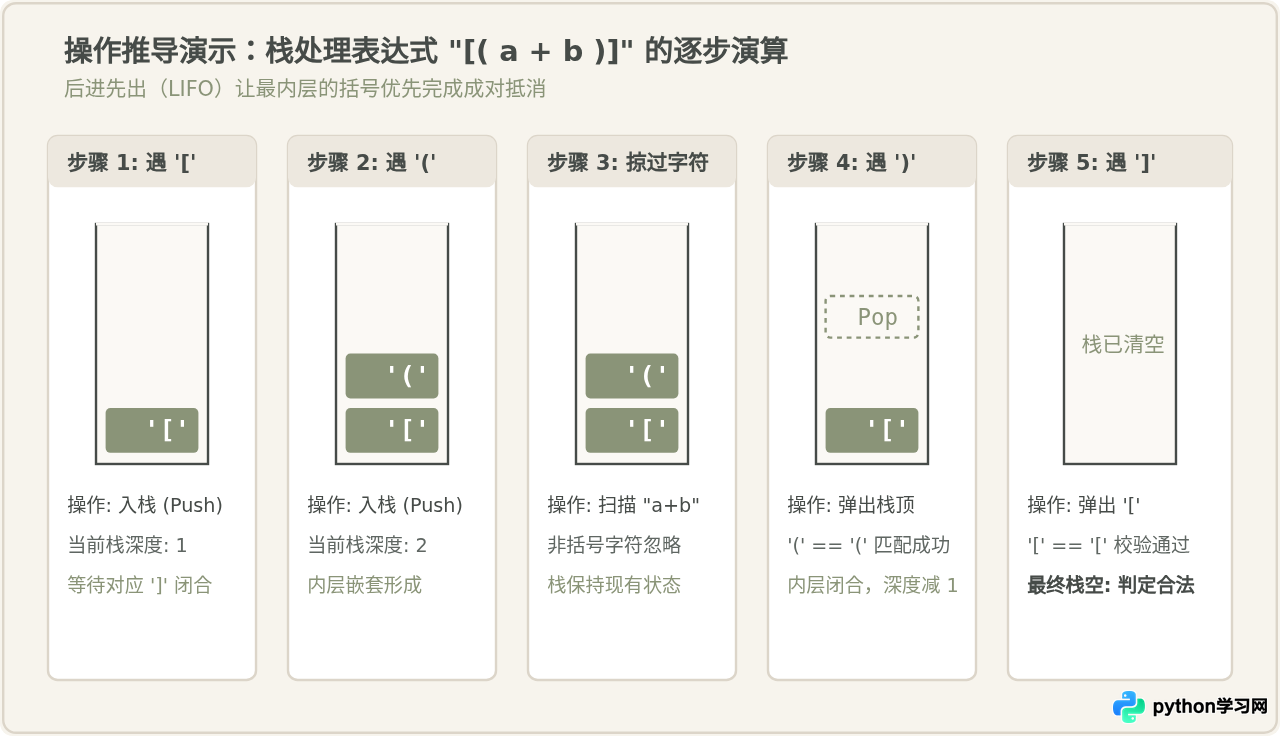
四、正则表达式的真正优势与避坑写法
既然栈能完美处理嵌套,正则表达式在括号匹配中是否一无是处?答案是否定的。正则表达式的真正价值在于:结构扁平、无嵌套层级的快速模式提取与文本替换。
在数据清洗、日志过滤或简单标记替换中,我们经常遇到类似 [INFO] 2026-10-19: (user_8891) login 这种固定结构的单层文本。若为此编写栈解析器,代码显得冗长琐碎,而正则只需单行即可完成。
1. 贪婪与非贪婪的常见陷阱
初学者在用正则提取括号时,极易写出 r'\(.*\)'。贪婪模式会一路匹配到文本中最后一个闭括号,导致多个同级括号被合并成一个整体:
import re

text = "函数调用 foo(1, 2) 与 bar(3, 4) 发生冲突"

# 错误写法 1: 贪婪匹配
bad_greedy = re.findall(r'\(.*\)', text)
# 得到: ['(1, 2) 与 bar(3, 4)'] (跨越了多个括号)

# 存在缺陷写法 2: 简单非贪婪匹配
lazy = re.findall(r'\(.*?\)', text)
# 针对单层正确: ['(1, 2)', '(3, 4)']
# 但如果遇到未闭合括号 "(abc 缺陷文本",非贪婪模式会继续向后吞噬
2. 推荐的标准否定字符集写法
在提取单层括号内容时,最严谨、最高效的正则表达式是使用否定字符集 [^()]*,明确禁止匹配包含其他括号的字符。这种模式不仅彻底杜绝了跨括号误吞的问题,而且杜绝了回溯消耗:
import re

# 规范写法:严格限定括号内部不包含任何开闭括号
safe_pattern = re.compile(r'\(([^()]*)\)')

text = "计算 A=(x + y) 和 B=(z - w)"
matches = safe_pattern.findall(text)
print("提取到的参数内容:", matches)
# 示例输出: ['x + y', 'z - w']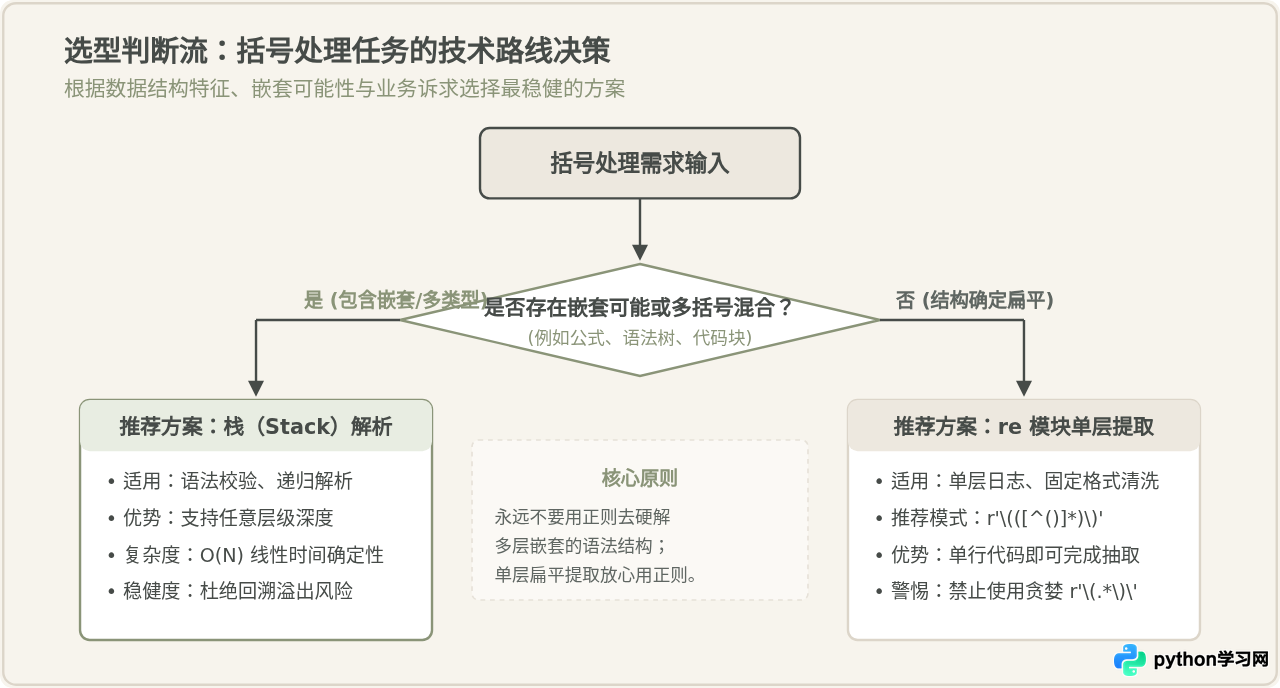
五、全维度技术特性对比
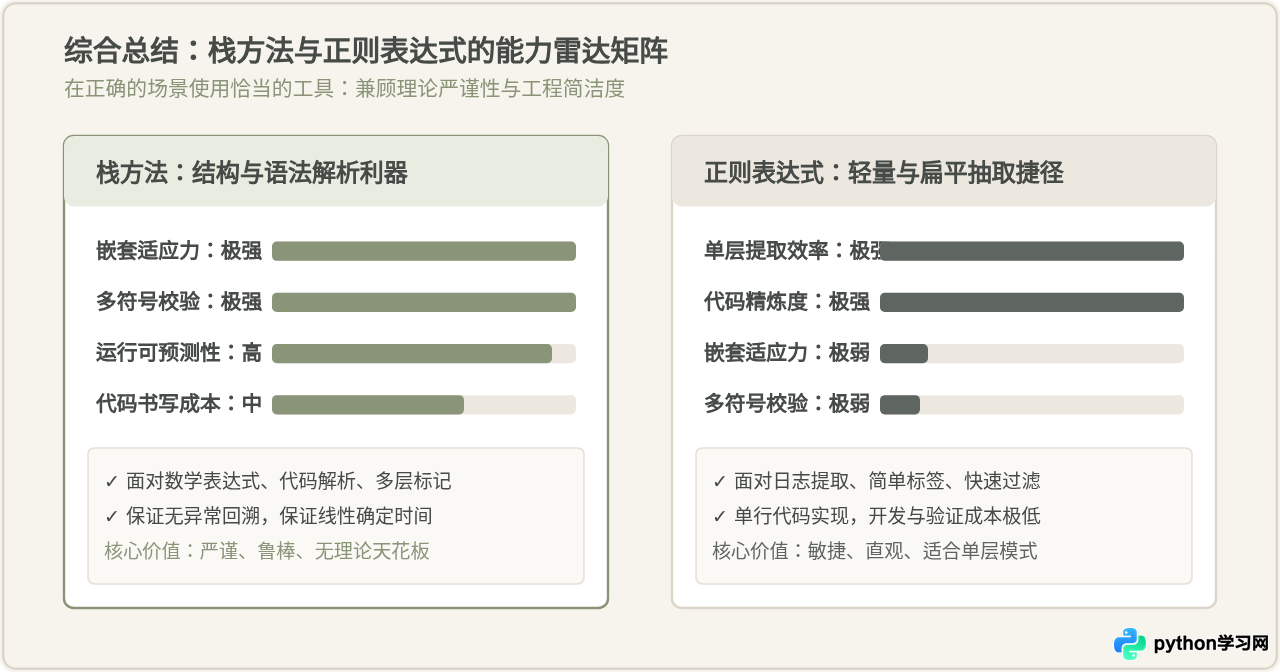
为了帮助读者在不同业务场景下快速定位技术选型,下表从语法支持、复杂度、内存开销及工程维护等多个维度进行综合横向对比:
| 对比维度 | 栈方法(Stack / deque) | 正则表达式(re 模块) |
|---|---|---|
| 支持文法类型 | 上下文无关文法(2型文法),天然支持嵌套 | 正则文法(3型文法),仅支持有限状态 |
| 嵌套括号支持 | 支持任意深度嵌套(仅受可用内存限制) | 理论不支持;硬编码仅支持极浅固定深度 |
| 多种括号混合 | 天然支持多种括号成对配对与交叉错位检测 | 极难实现多种括号同时合法配对校验 |
| 时间复杂度 | 稳定 O(N) 线性遍历,无回溯风险 | 简单模式 O(N);嵌套分支易退化至指数级 |
| 空间复杂度 | 最坏情况 O(N),取决于最大未闭合深度 | 编译后固定 DFA 状态表,空间极小 |
| 代码复杂度 | 约 10~20 行 Python 循环与判断逻辑 | 单行 re.findall(...) 即可解决扁平问题 |
| 适用典型场景 | JSON/XML解析、编译器语法分析、公式计算器 | 日志解析、URL路由参数提取、单层标签清洗 |
六、常见工程问题与注意事项
在真实的程序源代码或 SQL 脚本中,括号可能出现在字符串内(如 "hello (world)")或注释内(如 # (todo))。此时无论单纯使用栈还是单纯使用正则,都会产生误判。工业级做法是将词法分析与语法分析解耦:先通过状态机或词法分析器(Lexer)剥离注释和字符串 Token,再将过滤后的纯净 Token 流交给栈进行配对校验。
Python 标准库的 re 模块不支持递归匹配,但通过 pip install regex 引入的第三方 regex 模块支持类似 PCRE 的递归语法(如 \((?>[^()]+|(?R))*\))。需要注意,引入第三方模块会增加外部依赖和维护开销,且递归正则的调试和可读性门槛极高。在团队协作项目中,手写 15 行通俗易懂的栈方法通常是远优于引入黑魔法递归正则的选择。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









