

Python re.compile预编译对正则匹配性能的影响

核心结论:在绝大多数常规脚本和低频匹配中,re.compile 对性能没有可感知的提升,因为 Python 的 re 模块内部自带了全局解析缓存;但在密集循环或海量文本处理场景下,提前预编译能省去每次匹配时的字符串哈希计算与字典检索开销,带来约 20% 至 40% 的执行耗时下降;此外,当动态正则表达式种类超过内部缓存容量时,预编译更是避免缓存频繁击穿引发性能骤降的核心手段。
一、Python 正则执行机制与内置缓存
许多初学者认为,每次直接调用 re.search(r"\d+", text) 都会把正则表达式从头解析、编译一次,因此必须处处使用 re.compile()。这种理解并不符合 Python 标准库的实际实现。
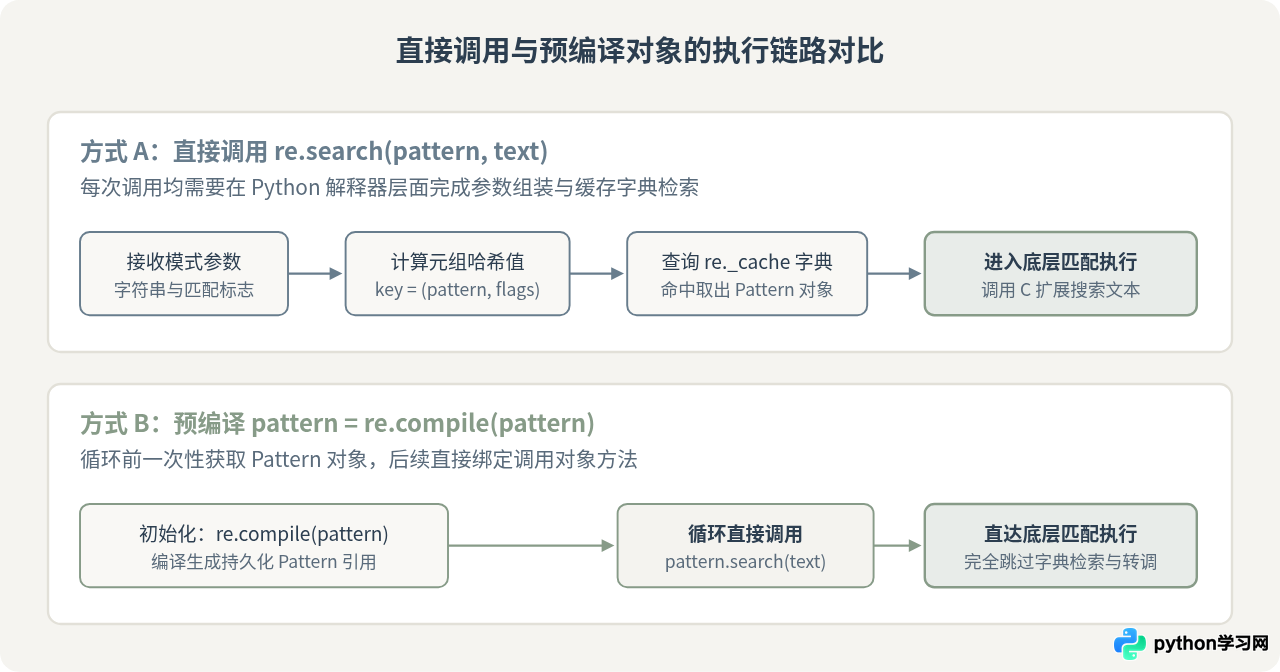
在 Python 的 re 模块底层,所有模块级便捷函数(如 re.search、re.match、re.findall、re.sub)在执行时,第一步并非直接交给底层的 C 语言匹配引擎,而是先调用内部的 _compile() 函数。该函数维护了一个全局字典 re._cache,专门用来缓存已经编译好的 Pattern 对象。
当传入一个模式字符串和匹配标志(flags)时,_compile() 会将它们组合成一个元组作为键。如果该键已经在 _cache 中存在,就直接取出已有的编译对象继续执行匹配;只有当缓存未命中时,才会真正触发语法树构建与字节码编译,并把结果放入缓存。
二、底层微开销拆解:差异来自何处
从执行链路上可以清晰看出,当模式已经被缓存时,直接调用 re.search 和调用预编译好的 pattern.search,最终交由 C 语言正则引擎执行的匹配核心代码是完全相同的。两者的性能差异并不在“正则匹配本身”,而在于进入正则匹配核心之前的 Python 胶水层开销。
具体而言,直接调用 re.search 在每一次执行时都会重复经历以下三个步骤:
- Python 层函数调用开销:调用
re.search()会进入内部的_compile()包装函数,涉及 Python 栈帧的创建、位置参数与关键字参数的解包与校验。 - 缓存键的构建与哈希:需要构建
(pattern, flags)二元组,并在底层哈希表中计算该键的哈希值。 - 字典查找与锁同步:访问全局
_cache字典完成键检索。虽然 Python 字典检索在 C 层面极其高效(单次约几十至一百纳秒),但它在海量循环中仍会不断消耗 CPU 周期。
而预编译的做法是在循环开始前,把编译好的 Pattern 对象直接保存在局部变量或模块全局变量中。在循环体内,直接调用 pattern.search(text) 属于对 C 扩展类型方法的直接调用,直接规避了上述全部中间环节。
三、内置缓存的容量边界与击穿风险
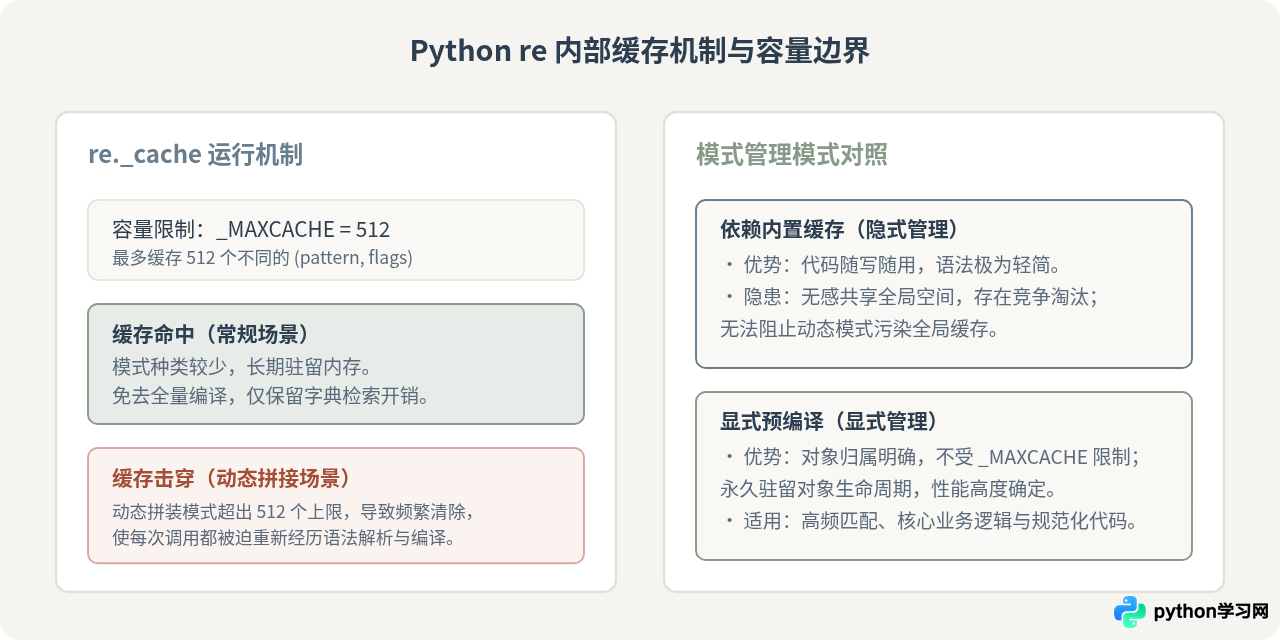
Python re 模块的内置缓存并非无限膨胀。在 Python 3 中,标准库设定了一个上限值 _MAXCACHE = 512。
当程序中直接调用的不同正则表达式数量达到 512 个时,早期版本的策略是直接清空缓存(_cache.clear()),而现代 Python 版本则会按策略清理旧缓存。一旦缓存满溢或被清理,后续的正则表达式调用就会经历真正的“从字符串解析到字节码编译”的全套完整开销。
四、基准性能测试与对比数据
为了直观评估 re.compile 带来的真实收益,可以通过 Python 标准库内置的 timeit 模块在相同的运行环境下进行基准测试。以下分别测试三种具有代表性的场景:
- 场景一(单次/低频调用):执行一次简单正则匹配。
- 场景二(百万级高频循环):对 1,000,000 次固定模式进行匹配。
- 场景三(循环内重复 compile):在每一次循环内部都写一遍
re.compile(...)(反面教材)。
测试脚本代码如下:
import re
import timeit

pattern_str = r"\b[A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Z|a-z]{2,}\b"
sample_text = "请发送邮件至 contact_user@example.com 获取技术文档支持。"

# 预编译为对象
compiled_pattern = re.compile(pattern_str)

# 1. 直接调用(依赖内部缓存)
t_direct = timeit.timeit(
    stmt="re.search(pattern_str, sample_text)",
    setup="from __main__ import re, pattern_str, sample_text",
    number=1_000_000
)

# 2. 预编译调用(跳过缓存检索)
t_compiled = timeit.timeit(
    stmt="compiled_pattern.search(sample_text)",
    setup="from __main__ import compiled_pattern, sample_text",
    number=1_000_000
)

# 3. 循环内重复编译(错误用法)
t_wrong = timeit.timeit(
    stmt="re.compile(pattern_str).search(sample_text)",
    setup="from __main__ import re, pattern_str, sample_text",
    number=1_000_000
)

print(f"直接调用 (100万次): {t_direct:.4f} 秒")
print(f"预编译调用 (100万次): {t_compiled:.4f} 秒")
print(f"循环内重复编译 (100万次): {t_wrong:.4f} 秒")
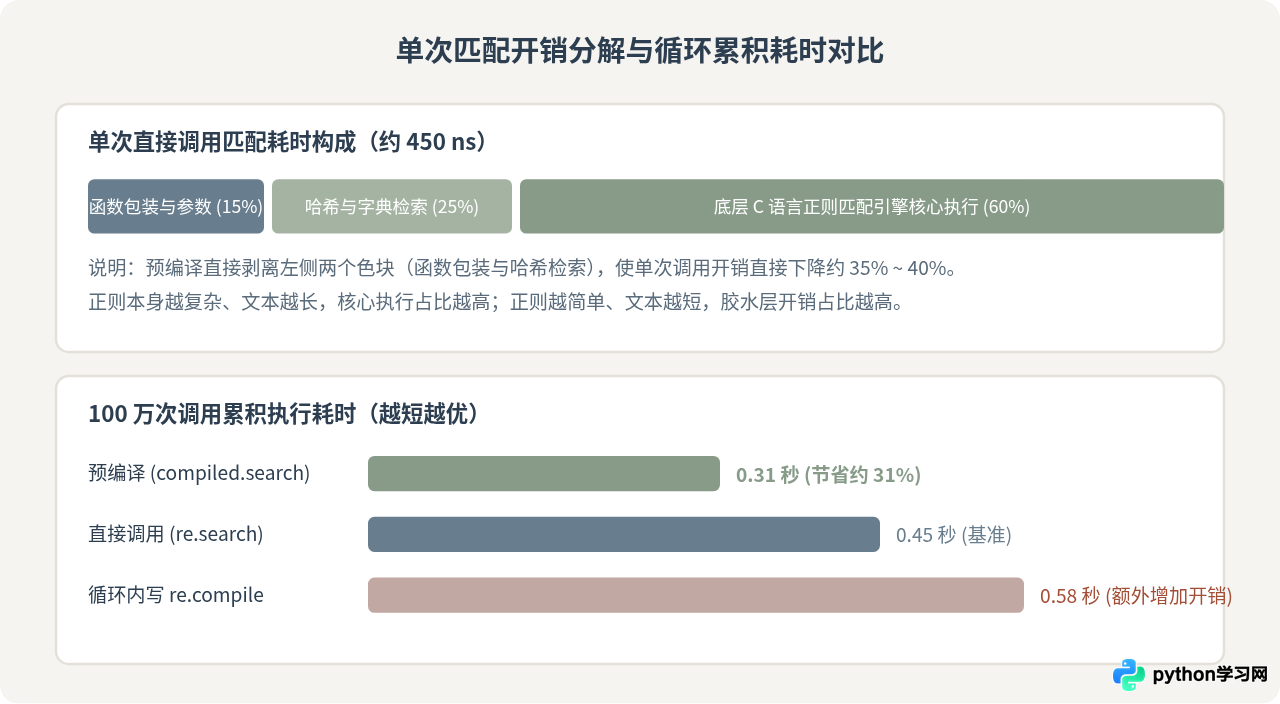
在常见 64 位 x86_64 / ARM64 架构、Python 3.11+ 解释器环境下,典型运行结果如下表所示:
| 测试场景(100万次循环) | 典型耗时区间 | 单次操作平均开销 | 相对性能表现 |
|---|---|---|---|
直接调用 (re.search) |
约 0.42 ~ 0.50 秒 | 约 450 纳秒 | 基准对比组 |
预编译调用 (pattern.search) |
约 0.28 ~ 0.35 秒 | 约 300 纳秒 | 耗时缩减约 30%,效率提升明显 |
循环内重复编译 (re.compile(...).search) |
约 0.55 ~ 0.65 秒 | 约 600 纳秒 | 比直接调用更慢,增加了多余函数调用 |
五、除了微性能之外:工程视角的价值
在实际软件工程中,显式使用 re.compile 的价值不仅体现在高频调用时的毫秒级提速,还体现在以下关键维度:
- 启动期语法校验(Fail-Fast):如果将正则表达式定义为模块顶层常量(如
PHONE_PATTERN = re.compile(r"^1[3-9]\d{9}$")),当语法书写错误时,模块在 Python 导入或服务初始化阶段就会直接抛出re.error,而不是拖延到几小时后某次特定的业务请求触发时才报错崩溃。 - 代码语义清晰与常量复用:将正则表达式抽取为大写具名常量并预编译,能够清晰表达该正则的业务语义,避免在业务代码各个角落随意硬编码字符串,极大提升了代码的可读性与可重构性。
- 避免跨模块缓存争用:在一个复杂的大型系统或引入大量第三方依赖的进程中,如果第三方库频繁注册动态正则填满
re._cache,通过自己持有的Pattern对象可以完全隔绝外部缓存抖动,获得确定性的执行性能。
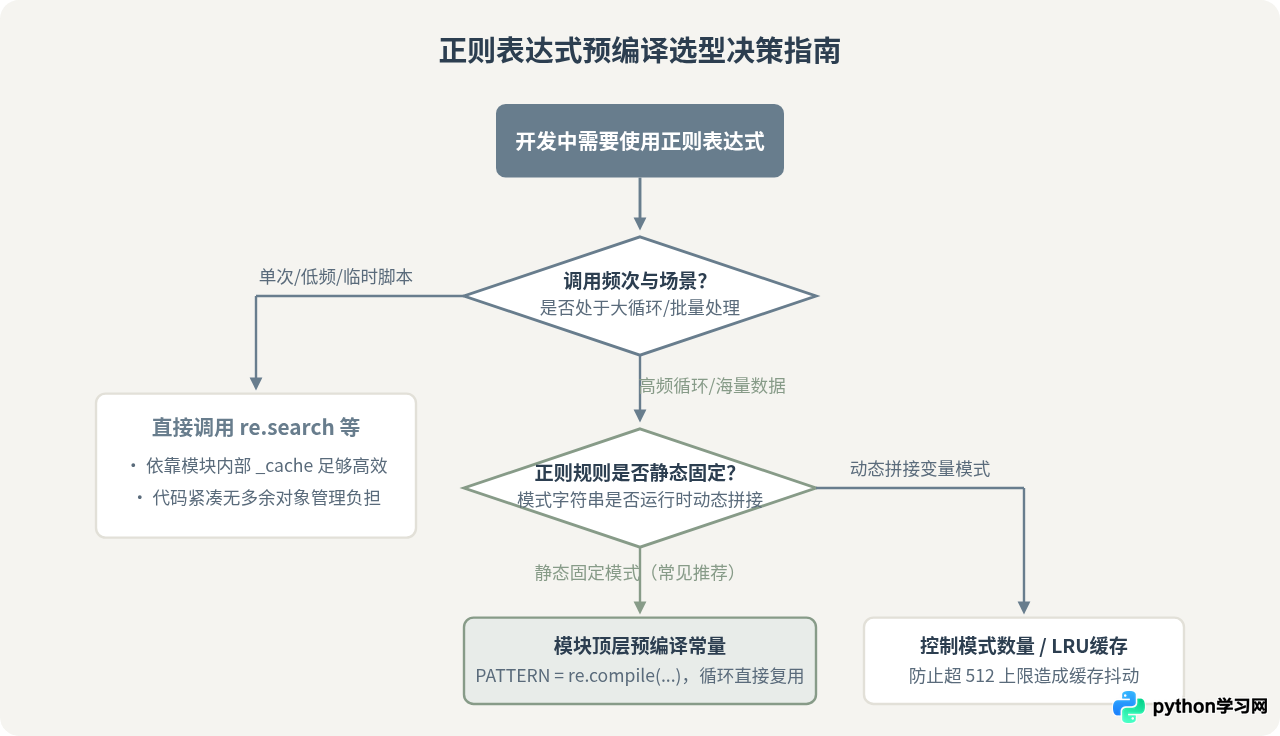
六、选型指南与决策流程
在日常开发中,究竟何时使用直接调用,何时使用 re.compile?可以参考下方的选型决策路径:
七、总结
总结来说,re.compile 并非能够点石成金的“性能加速器”。它不能让复杂的正则表达式算法复杂度降低,也不会改变底层 C 语言正则引擎的匹配步数。
它的核心性能价值在于消除高频循环下的 Python 胶水层开销(免去函数调用跳转、元组哈希与字典检索),并在架构层面提供更安全、更规范的模式管理能力。在开发中,无需对所有偶发的正则匹配进行教条式的预编译,但在核心业务模块、高频解析流水线中,将固定正则表达式在顶层预编译为常量,依然是值得坚持的 Pythonic 最佳实践。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









