

Python生成不重复随机数列表的实现方法
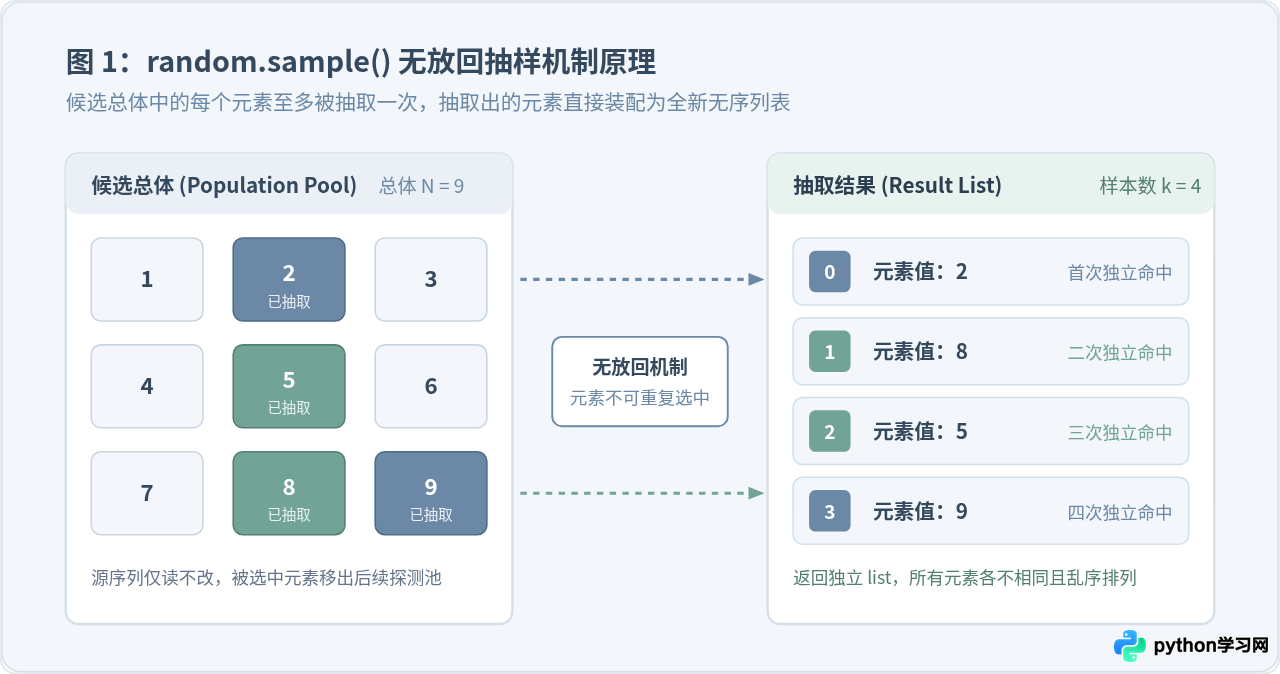
random.sample() 函数。该函数采用“无放回抽样”(Sampling without Replacement)机制,天然保证了输出列表内元素的唯一性。本文将系统讲解 random.sample() 的使用规则、边界约束与错误防御,结合实际场景探讨全排列洗牌及高并发环境下的替代方案,并通过执行机制对比阐明初学者常见的集合循环陷阱。
一、标准推荐解法:random.sample() 核心用法
Python 官方标准库 random 模块提供的 random.sample(population, k) 是生成不重复随机数序列的首选工具。其中参数 population 代表候选总体(可以是一个列表、元组、集合或 range 对象),参数 k 代表希望抽取的元素个数。
当需要生成指定数值范围内的若干不重复整数时,最经典的做法是将 range() 对象作为总体传入。例如,在区间 [1, 100] 中随机挑选 10 个互不相同的整数:
import random

# 在 1 到 100 的整数范围内(包含1与100),生成 10 个不重复的随机整数
result = random.sample(range(1, 101), 10)

print(result)
# 示例输出:[73, 14, 88, 3, 52, 91, 26, 40, 67, 18]
print(type(result))
# 输出结果直接为原生 list 类型
该方法的优势在于完全不需要开发者手动进行查重、去重或循环校验。底层算法依据抽取规模自适应选择跟踪机制,直接在内部完成不放回随机选择,返回由抽取元素构成的全新独立列表,原有的候选总体数据不会受到任何修改。
二、标准调用流程与边界异常防御
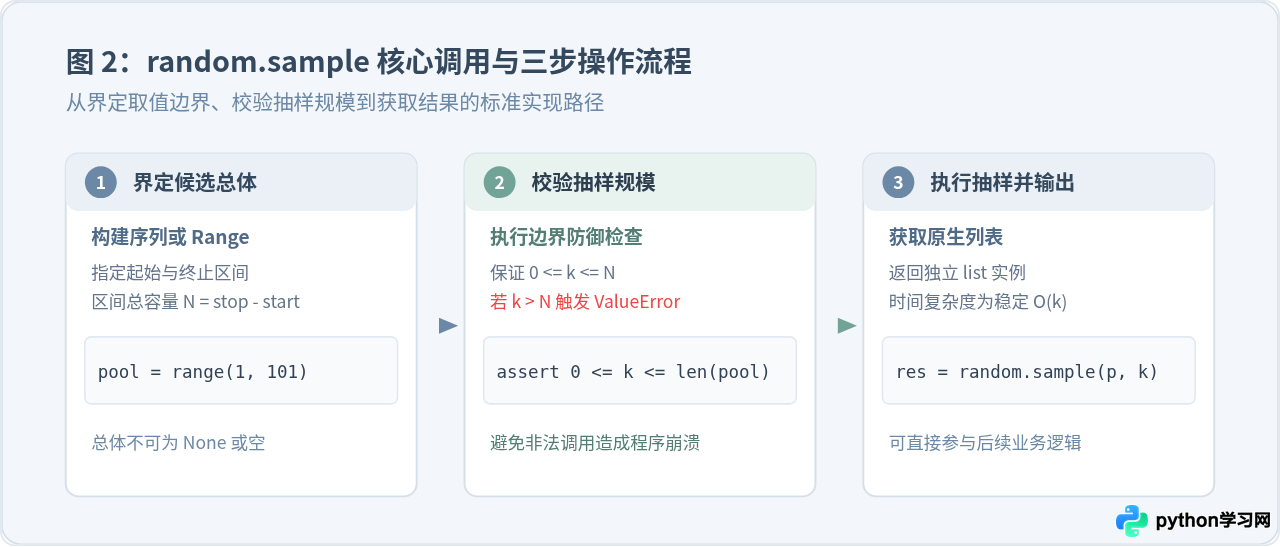
虽然 random.sample() 调用非常简洁,但在实际工程代码中,必须严格处理其数学边界条件。该函数最基本的前提假设是:抽取样本数量 k 不能大于总体容量 N,且 k 必须是非负整数。
1. 典型边界错误:ValueError 分析
如果要求从包含 5 个候选数的总体中抽取 10 个互不相同的数,由于“不重复”的前提无法满足,Python 解释器将直接抛出异常:
import random

try:
    # 总体中只有 5 个元素:[0, 1, 2, 3, 4]
    # 试图抽取 10 个不重复数
    nums = random.sample(range(5), 10)
except ValueError as e:
    print(f"捕获异常:{e}")
# 示例输出:捕获异常:Sample larger than population or is negativek <= len(population),防止由于外部传入越界参数导致服务异常中断。
2. 封装健壮的业务函数
在实际项目中,建议对该操作进行简单封装,增加参数安全校验与默认值回退逻辑:
import random
from typing import List

def generate_unique_random_numbers(start: int, stop: int, count: int) -> List[int]:
    """
    在指定区间 [start, stop] 内生成 count 个不重复的随机整数
    :param start: 区间起始值(包含)
    :param stop: 区间结束值(包含)
    :param count: 抽取数量
    :return: 包含不重复整数的列表
    """
    if start > stop:
        raise ValueError(f"起始值 start({start}) 不能大于结束值 stop({stop})")

    total_available = stop - start + 1
    if count < 0:
        raise ValueError("抽取数量 count 不能为负数")
    if count > total_available:
        raise ValueError(
            f"请求数量 ({count}) 超出区间所含唯一数值总量 ({total_available})"
        )

    # range 右边界不包含,故需要 stop + 1
    return random.sample(range(start, stop + 1), count)

# 示例验证:从 10 到 50 抽取 5 个数
numbers = generate_unique_random_numbers(10, 50, 5)
print(numbers)
# 示例输出:[21, 45, 12, 38, 49]
三、常见替代方案与性能陷阱对比
除了 random.sample() 之外,根据不同的实际业务场景,还可以选择就地洗牌切片或 NumPy 矢量化采样;同时,也应当避免使用低效的集合去重循环法。
方案 1:全量元素打乱——random.shuffle()
如果已经存在一个现成的列表对象,且需要将其中的全部元素打乱顺序,或者需要取出的随机数数量接近总规模,使用 random.shuffle() 是极为直接的选择。该函数会直接就地修改原列表:
import random

items = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
# 就地打乱列表顺序,返回值为 None
random.shuffle(items)

# 打乱后截取前 5 个,即得到 5 个不重复随机数
sample_items = items[:5]
print("打乱后的切片:", sample_items)
方案 2:大数据科学计算——numpy.random.choice()
在数据分析、机器学习或需要生成大规模随机数组时,标准库的 random.sample() 会产生 Python 对象的封装开销。此时采用 NumPy 库的无放回抽样(设置 replace=False)性能更佳:
import numpy as np

# 从 0 到 999999 中无放回抽取 10000 个不重复整数
# replace=False 表示不重复抽取
arr = np.random.choice(1000000, size=10000, replace=False)

# 若需要转为 Python 原生 list
result_list = arr.tolist()
方案 3:避坑警告——基于 set + while 循环的性能陷阱
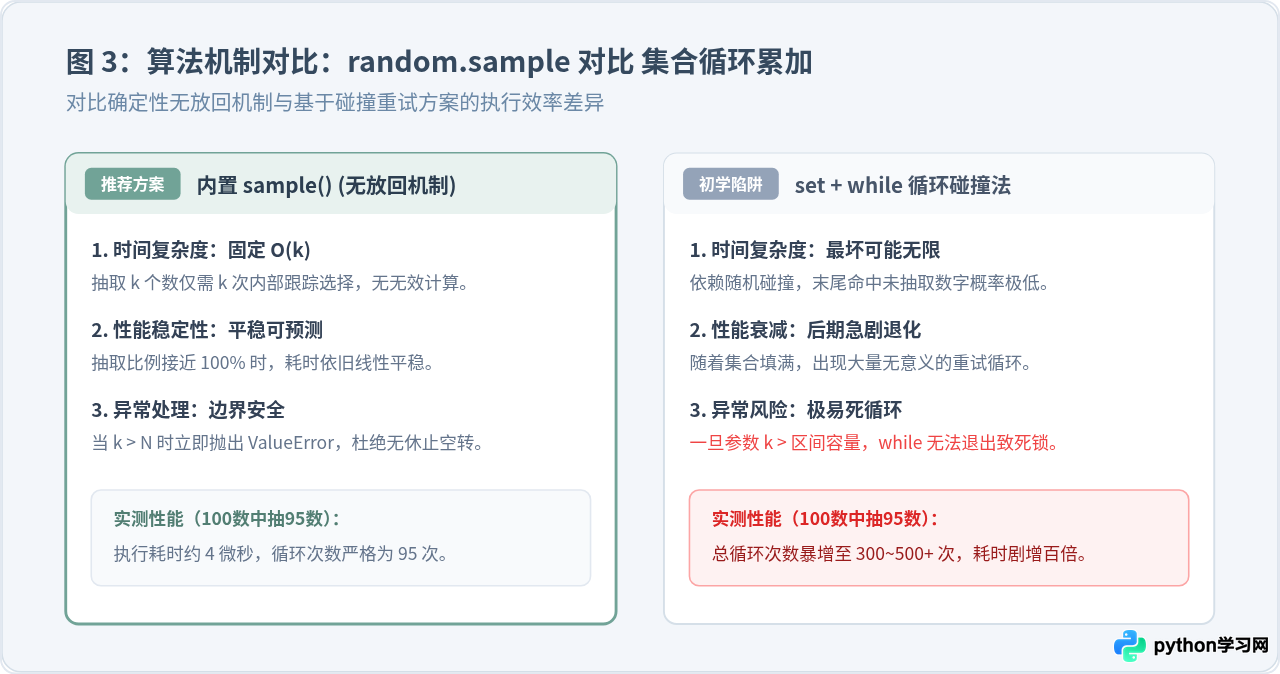
不少初学者倾向于使用如下代码来生成不重复序列:通过 while 循环不断调用 random.randint(),将生成的数字塞入 set 集合,直到集合大小达到目标要求。
# 存在严重性能陷阱的写法(不推荐)
import random

def bad_unique_random(start, stop, count):
    res = set()
    while len(res) < count:
        # 每次循环生成一个数,依赖集合去重
        res.add(random.randint(start, stop))
    return list(res)
这种写法在 count 较小且区间非常大时表现尚可,但在抽取数量接近总体容量时,性能会产生灾难性的断崖式下跌:
- 碰撞概率指数级上升:当集合中已有 95 个数字(总体为 100)时,下一次生成数字不发生重复的概率仅剩 5%。程序平均需要重试 20 次循环才能成功插入一个新数字。
- 时间复杂度失控:由于重复产生的无效计算急剧增加,算法从期望的 \(O(k)\) 迅速恶化;在极端或有边界疏漏时(如
count > total),更会导致程序陷入彻底死循环。
四、常见易混淆问题与避坑指南
1. 警惕名称陷阱:random.sample() 与 random.choices() 的区别
Python 3.6 引入了 random.choices()(注意末尾带有 s)。这两者在功能上有本质区别:
random.sample():无放回抽样,结果列表中绝不包含重复元素(前提是原序列本身元素唯一)。random.choices():有放回抽样,每次抽取后元素立即归还,因此结果列表中很可能会出现重复元素。
import random

data = [1, 2, 3, 4, 5]

# sample: 绝不重复
print("sample:", random.sample(data, 3))
# 示例:[4, 1, 5]

# choices: 允许重复
print("choices:", random.choices(data, k=3))
# 示例:[2, 5, 2] (数字 2 重复出现)
2. 如何保证随机结果可复现?
在单元测试、实验对比或仿真模拟中,通常需要让每次执行程序时生成的“不重复随机数列表”完全一致。此时只需通过 random.seed() 固定随机数生成器的初始种子:
import random

# 固定随机种子
random.seed(42)
list_a = random.sample(range(100), 5)

# 重置为相同的种子
random.seed(42)
list_b = random.sample(range(100), 5)

print(list_a == list_b)
# 输出:True,两次生成的随机列表完全相同
五、方法选型总结
在实际开发中,根据数据来源形式、样本规模以及所处技术栈环境,可参考以下技术选型决策图快速确立最优实现方案:
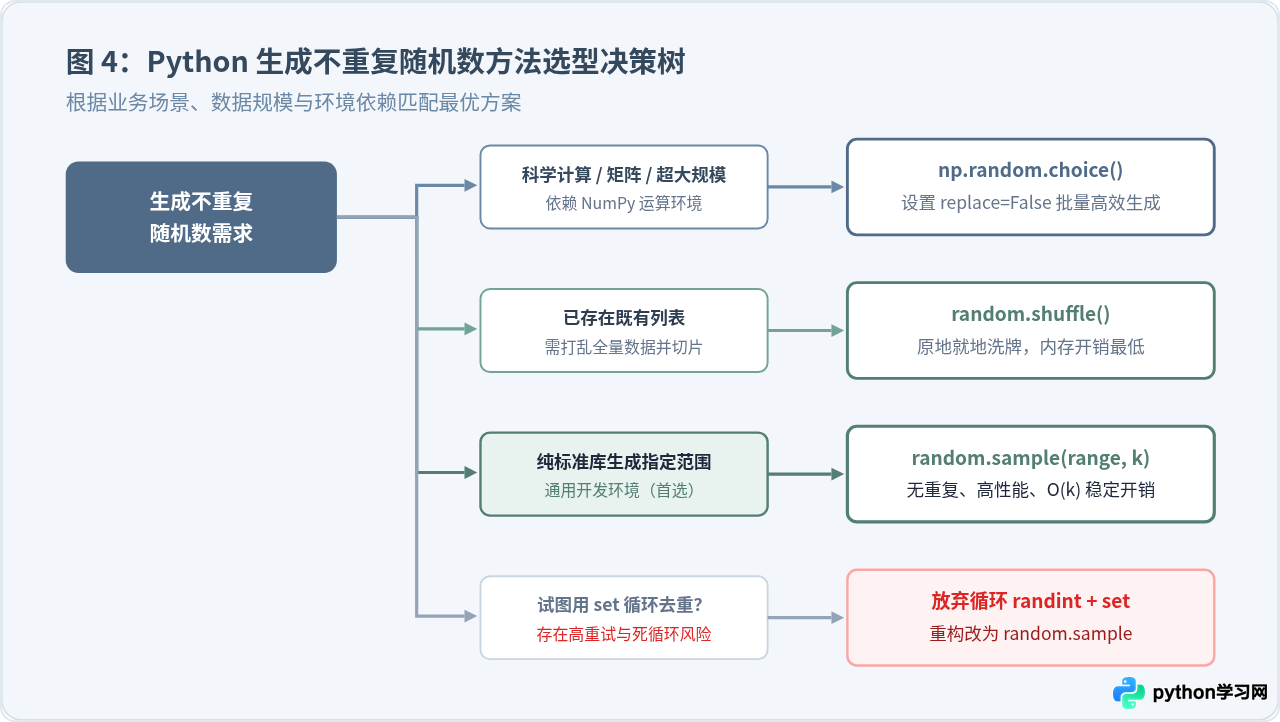
| 实现方法 | 所属模块 | 时间复杂度 | 适用场景 | 主要注意事项 |
|---|---|---|---|---|
random.sample(range(..), k) |
内置 random |
\(O(k)\) | 绝大多数通用业务,生成指定数值区间的唯一列表 | 必须满足 \(k \le N\),否则抛出 ValueError |
random.shuffle(list) |
内置 random |
\(O(N)\) | 已有一个完整序列,需要随机打乱其排列顺序 | 原地就地修改对象,会破坏原列表的原有顺序 |
np.random.choice(.., replace=False) |
第三方 numpy |
接近底层 C 效率 | 科学计算、数据挖掘、大规模多维矩阵采样 | 引入额外第三方依赖,返回类型为 ndarray |
while len(s) < k 循环添加 |
手写逻辑 | 最坏无限 | 不推荐使用任何生产环境 | 在抽样率高时性能急剧下降,易产生死循环 |
综上所述,在 Python 中生成不重复随机数列表,始终应当以内置的 random.sample() 作为默认首选;在涉及外部参数输入时做好区间大小与抽取数量的合法性校验,即可实现简洁、优雅且稳健的代码逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









