

Python深拷贝和浅拷贝的区别:内存引用与数据隔离解析
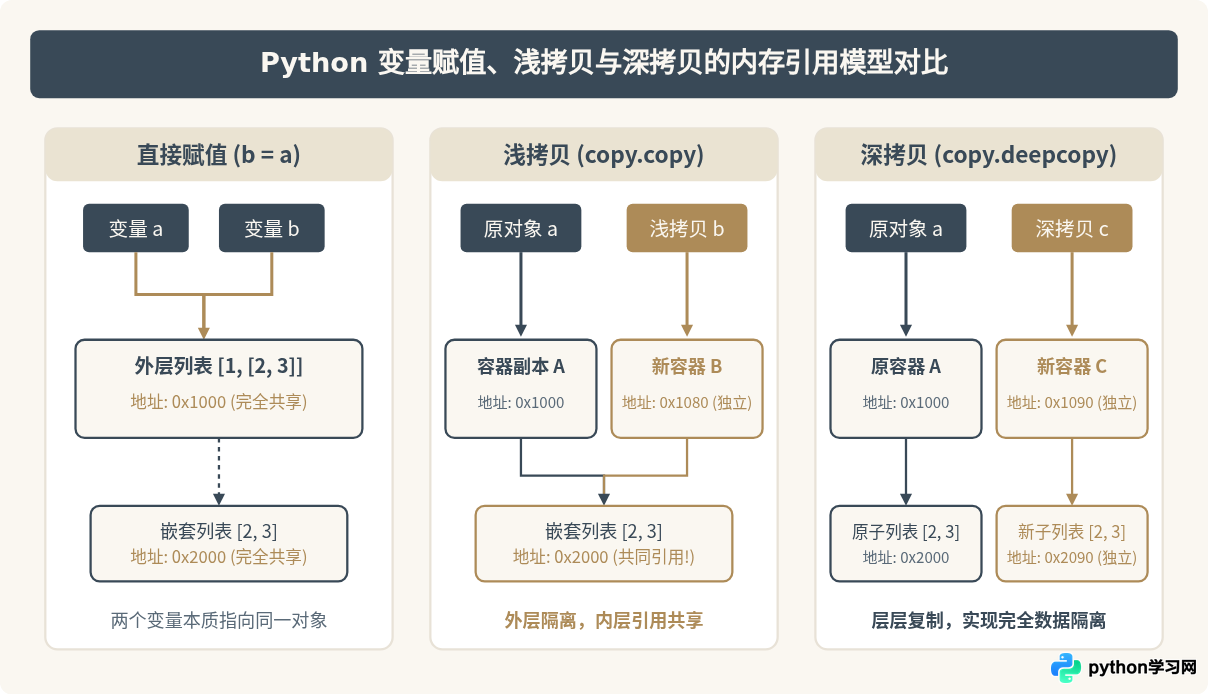
=)、浅拷贝(copy.copy())与深拷贝(copy.deepcopy())的核心区别在于对内存对象的引用传递深度。直接赋值仅创建新变量名并绑定到同一内存地址;浅拷贝只复制最外层的容器对象,其内部元素依然指向原内存引用;而深拷贝则会递归遍历并复制容器内所有层级的对象,构建完全独立的副本。理解这一机制是避免多层嵌套数据被意外篡改、确保数据隔离的关键。
一、核心机制:变量绑定、浅拷贝与深拷贝的本质区别
Python 中的变量本质上是指向内存对象的标签(引用),而非存储具体数据的物理槽位。当执行赋值操作 b = a 时,Python 并没有开辟任何新的内存空间来复制数据,仅仅是将变量名 b 也指向了 a 当前所指向的对象内存地址。因此,通过其中任意一个变量修改对象内容,另一个变量看到的结果都会同步发生改变。
当程序需要独立的数据副本时,就需要使用拷贝机制。浅拷贝(Shallow Copy)会在堆内存中创建一个新的外层容器对象,但容器内部所存放的元素指针,仍然直接引用原容器中各元素的地址。如果被拷贝的对象仅包含整数、字符串等不可变类型,或者没有嵌套的可变结构,浅拷贝足以实现数据修改的隔离;但只要容器内部嵌套了列表、字典等可变子对象,外层对象虽然独立,内部子对象的引用却依然是共享的。
深拷贝(Deep Copy)则彻底消除了这种共享依赖。它不仅新建最外层的容器对象,还会深入内部结构,递归检查并为每一个可变子元素创建全新内存块。深拷贝完成后,新对象与原对象在内存拓扑结构上呈现完全镜像,但二者之间没有任何共享的内存地址,从而达成了真正意义上的完整数据隔离。
二、内存引用的微观验证:id() 函数与对象地址观察
验证 Python 内部对象引用最直接的方法是调用内置函数 id()。在 CPython 实现中,id(obj) 返回的就是该对象在内存中的虚拟地址整数表示。我们可以编写一段针对嵌套列表的操作,直观观察内存地址的变化。
import copy

# 创建一个含有嵌套可变对象的列表
original = [100, [200, 300]]

# 1. 直接赋值
assigned = original

# 2. 浅拷贝
shallow = copy.copy(original)

# 3. 深拷贝
deep = copy.deepcopy(original)

print(f"原对象外层 id: {id(original)}, 内层列表 id: {id(original[1])}")
print(f"赋值对象外层 id: {id(assigned)}, 内层列表 id: {id(assigned[1])}")
print(f"浅拷贝外层 id: {id(shallow)}, 内层列表 id: {id(shallow[1])}")
print(f"深拷贝外层 id: {id(deep)}, 内层列表 id: {id(deep[1])}")
在标准 CPython 3.x 环境下执行上述代码,得到的示例输出如下:
# 示例输出(具体十六进制/整型数值因单次运行分配而异)
原对象外层 id: 4352123456, 内层列表 id: 4352124544
赋值对象外层 id: 4352123456, 内层列表 id: 4352124544
浅拷贝外层 id: 4352198720, 内层列表 id: 4352124544
深拷贝外层 id: 4352199808, 内层列表 id: 4352200192
对比输出数据可以清晰地得出三条结论:
- 赋值对象:外层
id和内层id与原对象完全一致,两者实质是同一个对象的别名。 - 浅拷贝对象:外层
id分配了新的内存(4352198720),说明顶层容器确实被新建了;但内层列表的id依然是4352124544,原封不动地继承了原列表内部的指针。 - 深拷贝对象:外层
id(4352199808)和内层id(4352200192)均已变成全新的地址,表明整个结构链条都被克隆了一遍。
三、浅拷贝的产生途径与修改传导过程
在 Python 日常编码中,浅拷贝不仅通过 copy.copy() 产生,许多内置类型的方法或常用切片操作本质上也是浅拷贝。例如:
- 列表的切片操作:
new_list = old_list[:] - 列表的内置拷贝方法:
new_list = old_list.copy() - 工厂函数实例化:
new_list = list(old_list)、new_dict = dict(old_dict) - 字典的拷贝方法:
new_dict = old_dict.copy()
很多开发者容易在含有嵌套结构的数据处理中陷入误区。当对浅拷贝对象进行修改时,修改行为会因为操作对象的层级不同而产生截然不同的效果。
为了加深理解,我们运行下面的具体测试代码:
raw = ['apple', [10, 20]]
sc = raw.copy()

# 操作 1: 修改外层不可变元素
sc[0] = 'banana'
print("外层修改后:")
print(f"原对象 raw: {raw}")
print(f"浅拷贝 sc : {sc}")

# 操作 2: 修改内层嵌套可变对象
sc[1].append(30)
print("\n内层修改后:")
print(f"原对象 raw: {raw}")
print(f"浅拷贝 sc : {sc}")
运行结果展示如下:
外层修改后:
原对象 raw: ['apple', [10, 20]]
浅拷贝 sc : ['banana', [10, 20]]

内层修改后:
原对象 raw: ['apple', [10, 20, 30]]
浅拷贝 sc : ['banana', [10, 20, 30]]关键注意点:浅拷贝的“浅”指且仅指顶层容器本身的新建。只要包含可变嵌套对象,并对该嵌套对象执行就地修改(如 append()、pop()、dict[key] = value),所有浅拷贝副本都会受到污染。
四、深拷贝的工作原理:递归复制与 Memo 字典机制
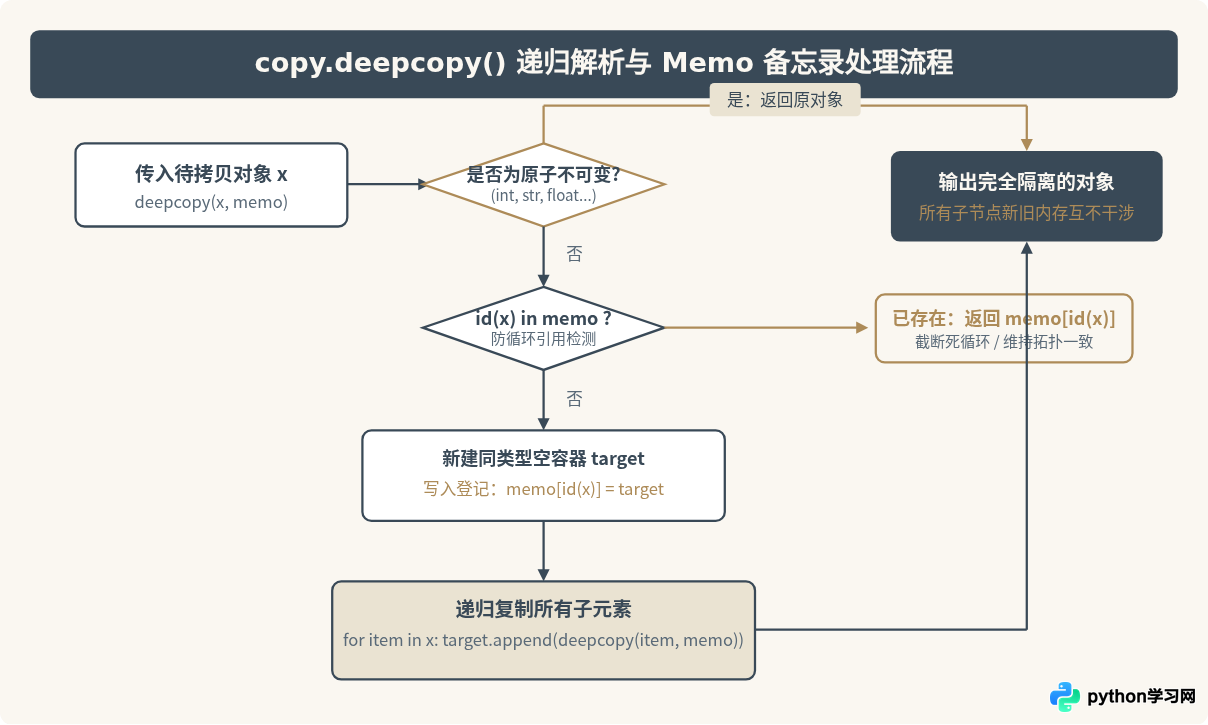
标准库 copy.deepcopy() 是解决嵌套修改污染的直接工具。然而,深拷贝并不是简单地做个死循环复制。在复杂的业务实体中,对象之间常常存在复杂的网状引用,甚至是“自己引用自己”的循环引用(Circular Reference)。如果深拷贝盲目递归,程序将很快因调用栈溢出(RecursionError)而崩溃。
为了解决这一问题,copy.deepcopy() 在底层实现中引入了一个核心机制:备忘录字典(memo)。
在进入递归拷贝时,deepcopy(x, memo=None) 内部维护着一个以对象 id(x) 为键、新创建对象副本为值的字典。其递归逻辑可分为以下明确的执行链条:
- 不可变原子对象短路:对于整数、浮点数、字符串、不可变空元组等类型,Python 不会创建副本,而是直接返回原对象,避免多余开销。
- 查阅 memo 备忘录:在尝试复制一个对象前,先检查该对象的
id是否已存在于memo字典中。如果存在,说明该对象已被复制过(或正在被复制),直接返回memo中记录的副本引用,立即截断潜在的循环引用。 - 创建新骨架并登记:如果
memo中没有记录,先为新对象分配空容器,并立刻在memo中登记映射关系:memo[id(x)] = new_container。 - 递归子元素:遍历原容器内的每个子元素,递归调用
deepcopy(child, memo),将返回的新引用依次填充进new_container。 - 返回最终副本:整棵引用树构建完成后,返回最外层的新对象。
为了验证循环引用的场景,我们可以构造一个自我引用的列表:
# 构造包含循环引用的复杂对象
node = ["root"]
node.append(node)  # node 的第二个元素引用了自身

# 进行深拷贝
cloned_node = copy.deepcopy(node)

print(f"原对象外层 id: {id(node)}, 循环引用指向的 id: {id(node[1])}")
print(f"克隆对象外层 id: {id(cloned_node)}, 循环引用指向的 id: {id(cloned_node[1])}")
print(f"新旧对象是否完全隔离: {id(node) != id(cloned_node)}")
print(f"新对象的循环关系是否自洽: {id(cloned_node) == id(cloned_node[1])}")
# 示例输出
原对象外层 id: 4352567296, 循环引用指向的 id: 4352567296
克隆对象外层 id: 4352568448, 循环引用指向的 id: 4352568448
新旧对象是否完全隔离: True
新对象的循环关系是否自洽: True
测试结果清楚地证明:deepcopy 不仅保证了新旧对象内存地址的绝对隔离,而且借助 memo 正确重构了对象内部的自指拓扑关系,没有陷入死循环。
五、工程场景选型:决策依据与性能权衡
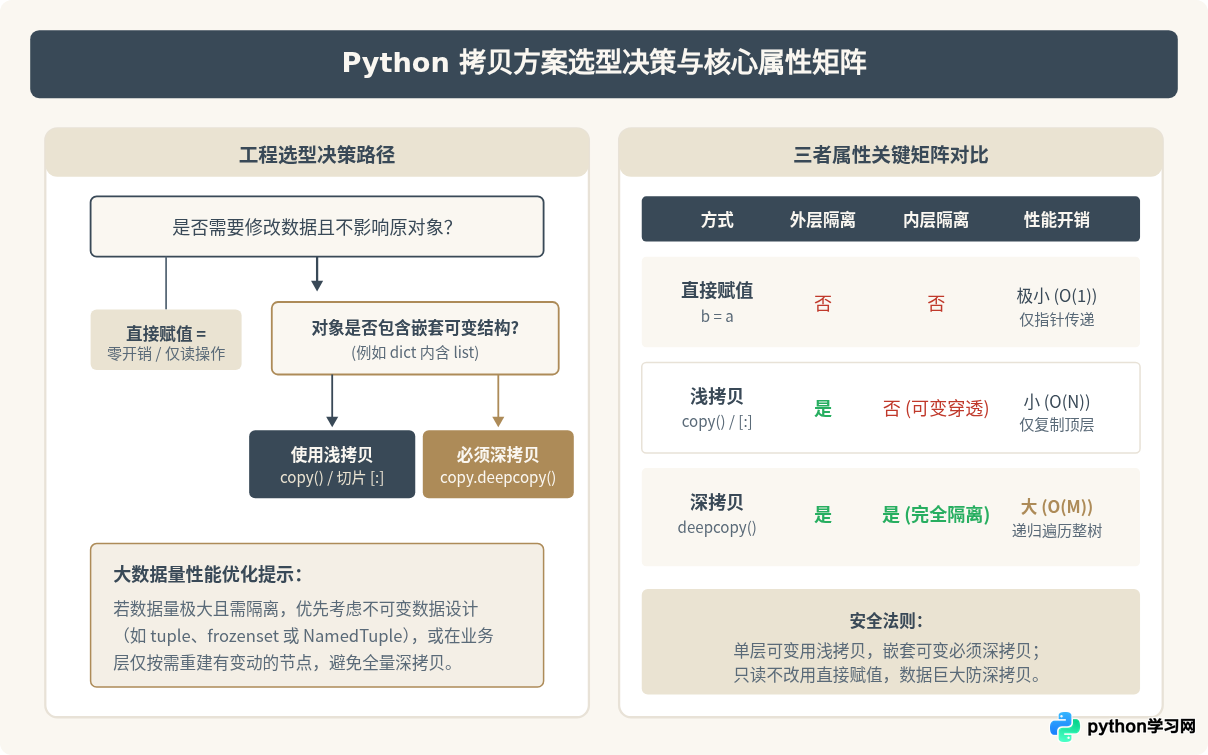
虽然深拷贝提供了最彻底的数据隔离,但在实际生产项目中,盲目滥用深拷贝会带来显著的性能负荷与内存浪费。
因为 deepcopy 需要通过 Python 层的运行时检查、遍历树状属性、读写备忘字典以及动态创建大量零散的小对象,在处理包含上万条记录的复杂字典或嵌套模型时,其耗时往往比浅拷贝慢 10 倍甚至数十倍。在高并发接口或数据密集型场景下,这种开销尤为致命。
六、总结与实践建议
掌握 Python 中深浅拷贝的差异,关键在于建立清晰的内存引用视角。直接赋值并没有产生新对象,只是增加了别名;浅拷贝构建了一个新的外层壳体,但内部所有槽位依然指向原有对象的地址;只有深拷贝通过递归遍历与 memo 备忘录机制,为内部所有可变子节点开辟了全新的内存空间,达成了真正独立的数据隔离。
在日常开发中,应结合数据结构的复杂度做出合理权衡:对一维纯数值列表或平铺配置字典,切片和 copy() 能够以最小的开销提供足够的安全保证;而处理复杂嵌套树形结构、跨模块传递可变载荷或包含反向引用的图数据时,必须坚决使用 copy.deepcopy(),以杜绝难以排查的隐式数据篡改与脏状态隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









