

在线运行Python代码遇到超时或内存限制怎么办?

一、辨识报错特征:区分超时与内存超限
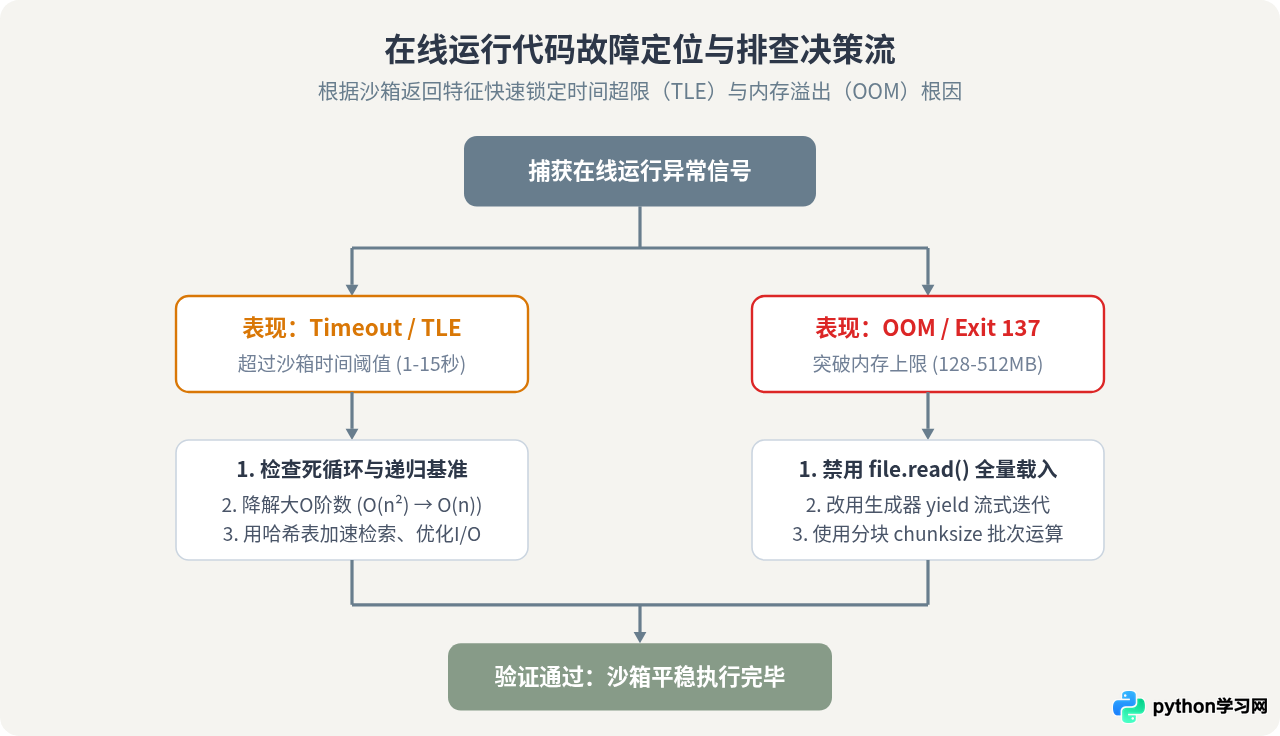
在线运行平台为了保证多租户环境的平稳与安全,通常利用 Linux 容器与 cgroups 控制组为每个用户的执行进程分配有限资源。例如,单次执行通常限定 CPU 运行时间在 1 至 15 秒之内,物理内存上限设定在 128MB 至 512MB。当代码触碰边界时,系统会采取强制截断机制。明确具体的异常表现是展开针对性排查的前提。
1. 执行超时(Time Limit Exceeded / Timeout)
超时通常表现为界面直接提示 Time Limit Exceeded (TLE)、Execution Timed Out 或 Python 标准库的 TimeoutError。在底层机制中,当进程占用的 CPU 周期累计达到设定上限时,操作系统内核或沙箱监控守护进程会向 Python 解释器发送 SIGXCPU 或 SIGKILL 信号,强制中断执行。该现象通常由无限循环、递归缺少有效终止条件、高阶时间复杂度(如嵌套双重或三重循环)或高频控制台 I/O 引起。
2. 内存超限(Memory Limit Exceeded / OOM)
内存超限的表现分为显式与隐式两种形态:
- 显式报错:Python 解释器向系统申请内存空间失败,直接抛出
MemoryError。 - 隐式静默退出:进程没有留下任何 Python 回溯信息,容器直接退出,返回状态码
137(即 128 + 9,表示被系统信号 9 SIGKILL 强制杀灭)。这是典型的 Linux 内核 OOM-Killer(Out of Memory Killer)保护行为,说明进程物理内存(RSS)突破了 cgroup 设定的硬阈值。
二、超时问题排查与优化方案
解决超时的核心不是微观语法调优,而是对算法时间复杂度的降阶与冗余操作的裁剪。
1. 排查逻辑陷阱:死循环与未剪枝递归
首先检查所有 while 循环与递归函数的边界:
- 确认
while内部的指针或状态更新变量确实在每一轮循环中向退出条件推进。 - 检查递归深度。Python 默认最大递归深度一般为 1000(可通过
sys.getrecursionlimit()查看)。若递归无终止基线,程序将在短时间内耗尽调用栈或超时。若确实需要深度遍历,应改写为显式维护列表的迭代栈模式。
2. 降低大 O 阶数:利用哈希表加速查找
许多初学者在处理集合元素匹配时习惯使用列表(List),导致单次检索为 \(O(n)\),整体为 \(O(n^2)\)。在在线沙箱处理十万级数据时,\(O(n^2)\) 需要进行百亿次比较,必然触发超时;而将其转换为集合(Set)或字典(Dict)后,查找耗时降为 \(O(1)\),整体为 \(O(n)\),通常仅需数十毫秒。
# 低效写法:列表包含性检索,总体时间复杂度 O(n * m),极易超时
def find_common_slow(list_a, list_b):
    common = []
    for item in list_a:
        if item in list_b:  # 列表的 in 操作每次需线性扫描 O(m)
            common.append(item)
    return common

# 优化写法:将目标集合转换为哈希集合,总体时间复杂度降为 O(n + m)
def find_common_fast(list_a, list_b):
    set_b = set(list_b)    # 一次性构建哈希表,耗时 O(m)
return [item for item in list_a if item in set_b] # 哈希查找平均 O(1)print()。在线平台的控制台输出通常通过重定向管道捕获,高频标准 I/O 会引起频繁的用户态与内核态切换及缓冲区刷新,极大拉长执行耗时。若需批量输出结果,应先用列表收集字符串,最后使用 '\n'.join(...) 一次性输出。
三、突破内存限制的核心重构:生成器与分块处理
当数据量较大时,全量对象载入往往瞬间耗尽 256MB 或 512MB 的沙箱内存。解决内存瓶颈的本质是改变数据驻留方式,将“全量装载”重构为“按需计算”。
1. 列表推导式与生成器表达式的选型
列表推导式 [x for x in data] 会在内存中立即分配一片连续空间,并完整实例化所有元素对象;而生成器表达式 (x for x in data) 或带有 yield 的函数只保存计算逻辑与当前指针状态,在每次迭代时仅在内存中维护当前单一对象。
# 内存暴涨写法:立即生成一千万个整数并存储在列表中
# 在 64 位 Python 下该列表占用约 80MB 内存,后续计算极易突破沙箱上限
def get_squares_list(n):
    return [i * i for i in range(n)]

# 极致轻量写法:使用生成器 yield,空间复杂度降为恒定的 O(1)
# 无论 n 是一万还是一亿,内存占用始终保持在几百字节级别
def get_squares_generator(n):
    for i in range(n):
        yield i * i
2. 文件与批量数据的分块流式加载
在处理在线测试提供的大型文本或日志输入时,切忌使用 f.read() 或 f.readlines() 将几百兆的数据全部装载入内存。应利用 Python 文件对象的原生迭代器逐行处理,或使用分块(Chunking)机制:
# 避免:一次性读取全部文件内容导致 MemoryError
# with open('large_dataset.txt', 'r', encoding='utf-8') as f:
#     content = f.read()

# 推荐:逐行迭代流式处理,内存占用始终仅为当前单行大小
def process_large_file(file_path):
    total_valid_rows = 0
    with open(file_path, 'r', encoding='utf-8') as f:
        for line in f:  # 文件对象支持惰性迭代
            cleaned = line.strip()
            if cleaned and not cleaned.startswith('#'):
                total_valid_rows += 1
    return total_valid_rows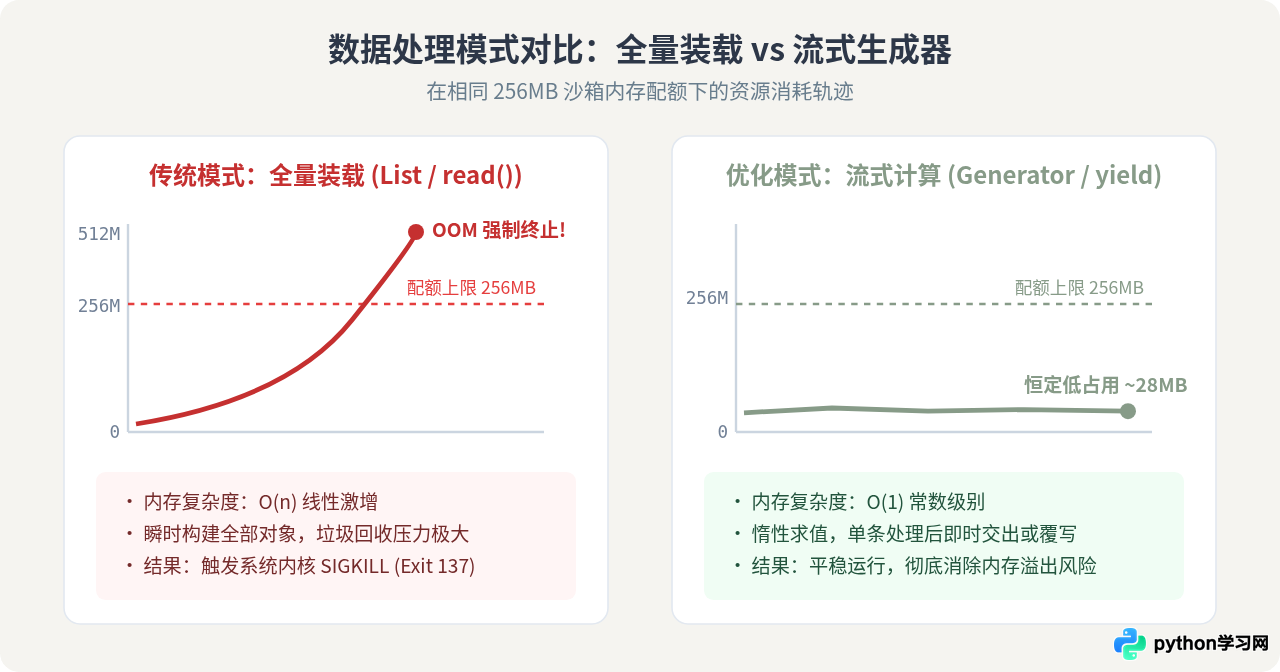
四、机制解析:在线沙箱的资源隔离与拦截机制
为了准确预测代码在云端的行为,有必要了解在线代码沙箱的底层管控逻辑。大部分在线评测系统与云端编程环境均采用类似如下的分层架构:
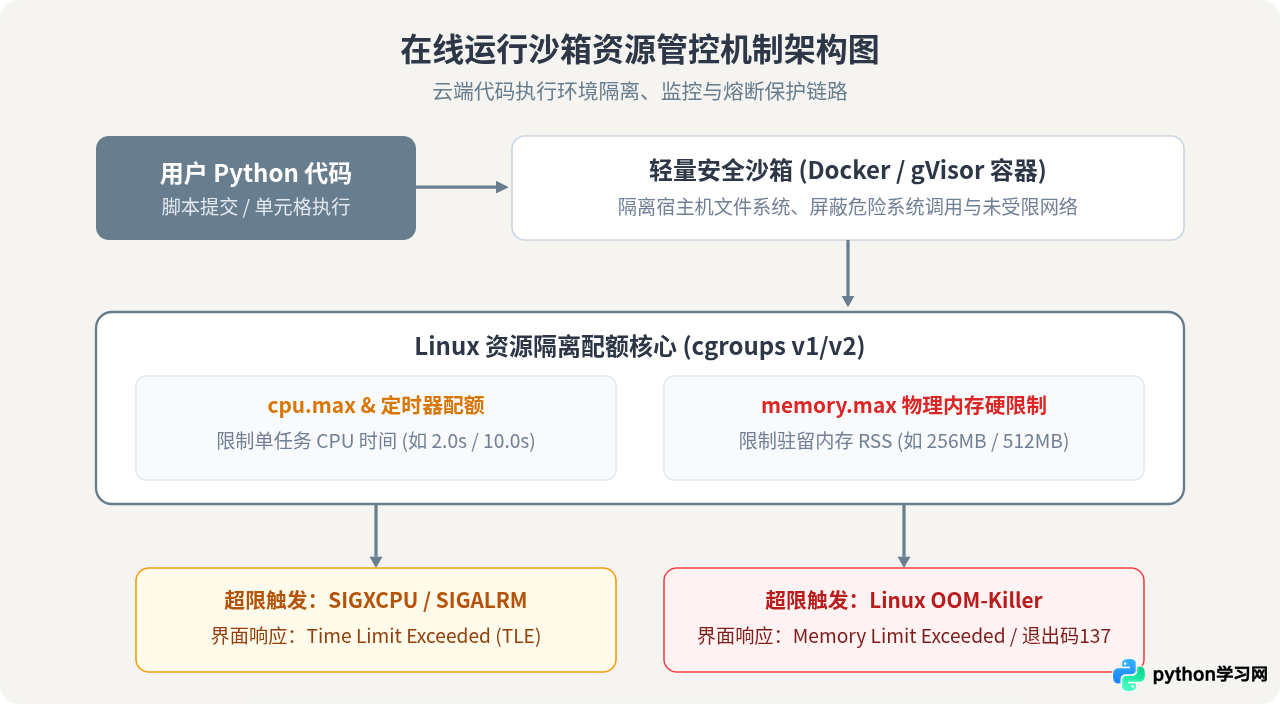
当代码运行在受限环境时,Linux 内核每隔若干毫秒更新 cgroup 的记账信息。这意味着:
- CPU 配额具有累计性:如果是多核系统,有些沙箱只分配单核算力(如
cpu.max = 100000 100000),多线程无法通过并行突破单核时间限制,反而可能因为 GIL 锁竞争与线程上下文切换增加总 CPU 消耗。 - 内存上限是硬拦截:Python 的对象管理机制在向操作系统索取内存后,即使内部通过
del删除了变量,由于底层pymalloc内存池和操作系统的分页策略,已分配的物理页(RSS)往往不会立即释放还给 OS。因此,循环内大量创建并废弃大对象也会引起内存驻留峰值不断推高,最终撞上memory.max边界。
五、本地基准测试与提交前自测方法
在向在线沙箱提交代码之前,建立本地测试脚手架能够提前发现性能与空间缺陷,避免反复盲目试错。Python 标准库自带了高精度的性能与内存剖析工具:
import time
import tracemalloc

def solve(data_stream):
    # 核心算法处理逻辑示例
    result = sum(x for x in data_stream if x % 2 == 0)
    return result

def run_benchmark():
    # 模拟构建大规模边界测试数据 (例如 50 万条)
    raw_data = range(500000)

    # 启动内存跟踪
    tracemalloc.start()
    start_time = time.perf_counter()

    # 执行核心逻辑
    ans = solve(raw_data)

    end_time = time.perf_counter()
    current_mem, peak_mem = tracemalloc.get_traced_memory()
    tracemalloc.stop()

    elapsed = end_time - start_time
    print(f"执行结果: {ans}")
    print(f"核心耗时: {elapsed:.4f} 秒")
    print(f"当前内存: {current_mem / (1024 * 1024):.2f} MB")
    print(f"内存峰值: {peak_mem / (1024 * 1024):.2f} MB")

    # 判定基准线:本地耗时超过 0.5s 或峰值超过 50MB 需警惕在线超时与超限
    if elapsed > 1.0 or peak_mem / (1024 * 1024) > 100:
        print("[警告] 资源消耗较高,提交至受限沙箱存在超时或超限风险!")
    else:
        print("[正常] 资源占用在安全阈值之内。")

if __name__ == "__main__":
    run_benchmark()
借助 time.perf_counter() 与 tracemalloc.get_traced_memory(),开发者可以在本地清晰获知算法的耗时精确到毫秒、内存峰值精确到字节。若本地在 50 万数据规模下的内存峰值即可控制在 10MB 以内、耗时在 0.2 秒以内,则上线后基本不会遇到资源限制截断。
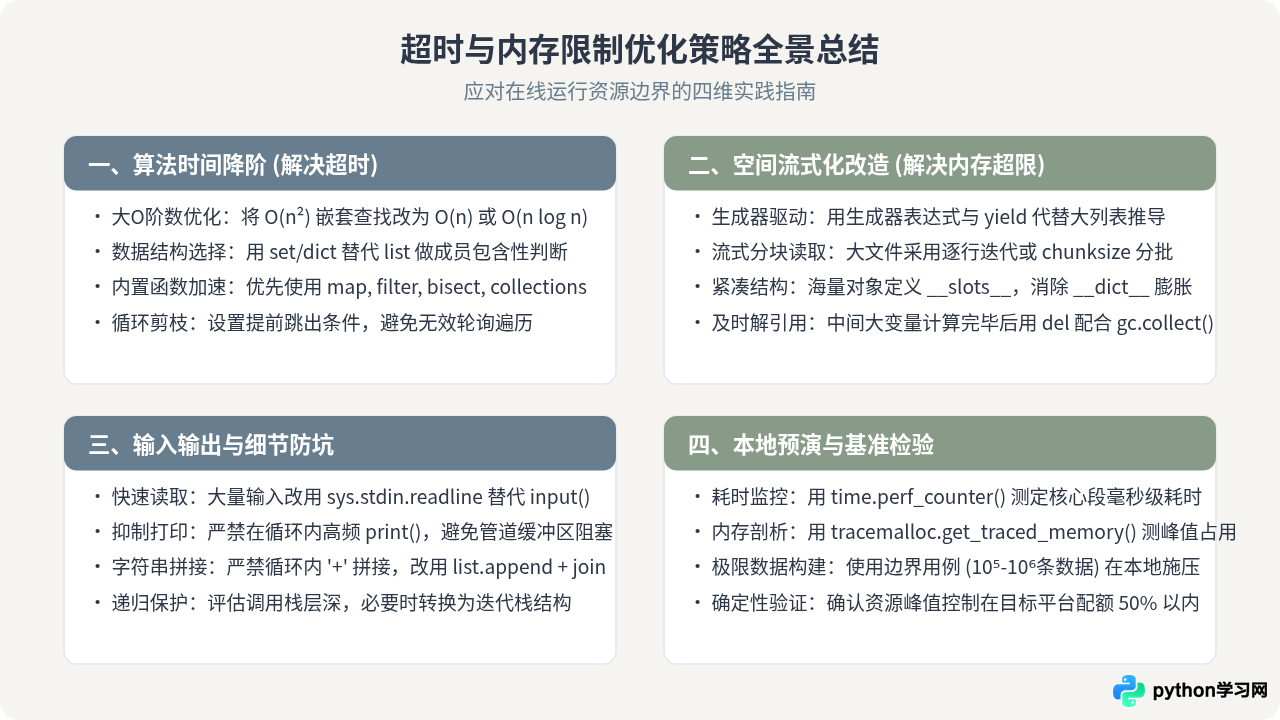
六、排查速查与优化总结
遇到在线资源超限时,可以按照下表的对照关系迅速执行诊断与重构:
| 异常现象 | 典型报错 / 退出状态 | 主要引发原因 | 推荐重构手段 |
|---|---|---|---|
| 执行超时 | TimeoutError / Time Limit Exceeded |
循环内 \(O(n)\) 线性查找、递归无基线条件、大阶数嵌套循环 | 改用 set/dict 哈希表、双指针、二分查找将算法降至 \(O(n)\) 或 \(O(n \log n)\) |
| I/O 阻塞延时 | 执行时间异常拉长直至超时 | 循环内高频 print()、频繁调用标准输入 |
使用 sys.stdin.readline 批量读入,列表收集后一次性输出 |
| 显式内存溢出 | MemoryError |
一次性载入大文件、超大全局矩阵实例化 | 改用文件原生流式迭代、yield 生成器、分块批处理 |
| 隐式被杀截断 | 进程静默退出、退出码 137 |
物理内存 RSS 突破容器 cgroup 限制,触发 Linux OOM-Killer | 避免列表推导式全量构建,使用 __slots__ 缩减对象字典,及时解除引用 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









