

Python join方法怎么高效合并列表为字符串?
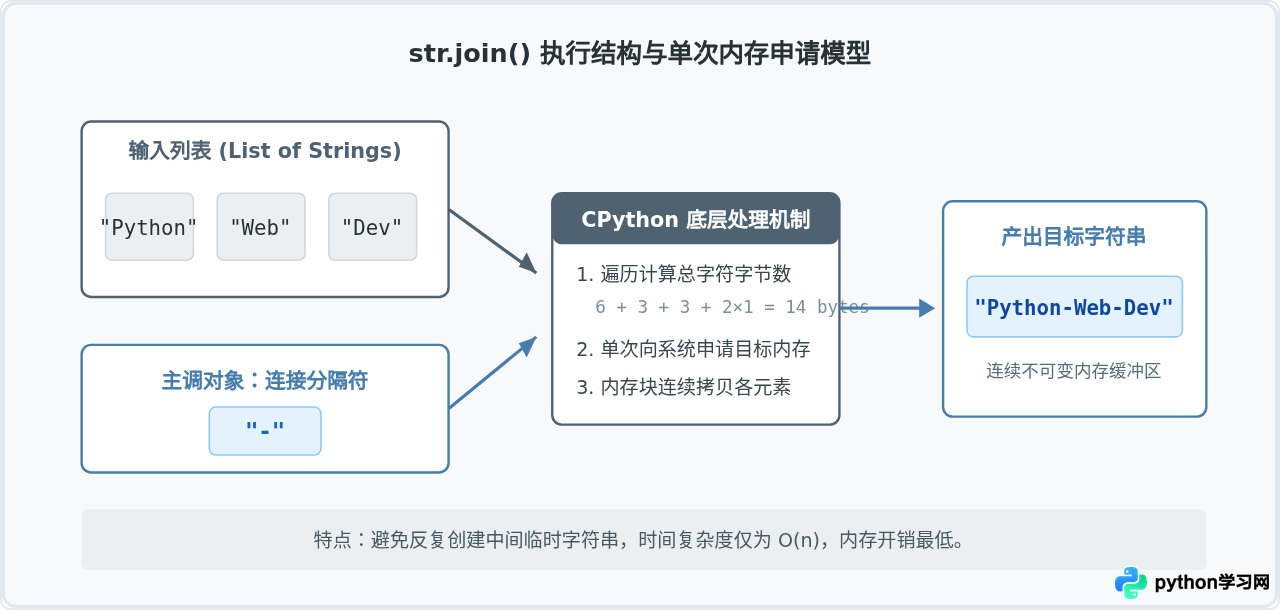
separator.join(list)。与使用循环结合 += 逐个累加不同,str.join() 由底层 CPython 解释器预先计算出最终字符串的总字节数,仅进行一次内存分配便完成所有元素的拷贝,时间复杂度仅为 \(O(n)\)。
一、为什么是由分隔符调用 join 方法?
初学 Python 的开发者常常困惑为什么不是 list.join(separator),而是 separator.join(list)。这种设计的核心原因在于通用性:join 是字符串对象提供的方法,它不仅支持列表(list),还可以接受元组(tuple)、集合(set)、生成器(generator)等任何包含字符串的可迭代对象。
当调用 separator.join(iterable) 时,Python 会以 separator 作为元素之间的连接符,将可迭代对象中的各项拼合在一起。如果不需要任何分隔符,只需要使用空字符串 "".join(iterable) 即可。
二、基础代码示例与核心用法
根据具体业务需求,开发者通常会根据不同场景选用不同的分隔符。以下是三种最常见的使用场景:
1. 无缝合并(空字符串拼接)
当需要将字符碎片还原为完整单词或文本时,直接使用空字符串 "" 作为连接符:
chars = ['H', 'e', 'l', 'l', 'o', ' ', 'W', 'o', 'r', 'l', 'd']
result = "".join(chars)
print(result)
# 输出结果:Hello World
2. 符号连接(逗号、下划线与中划线)
在生成 CSV 格式数据、参数字符串或可读标识符时,指定相应的标点符号:
tags = ['python', 'backend', 'performance']
csv_row = ", ".join(tags)
slug = "-".join(tags)

print(csv_row)  # 输出结果:python, backend, performance
print(slug)     # 输出结果:python-backend-performance
3. 换行连接(多行日志与配置项)
将多行文本行列表拼接为包含系统换行符的多行文档:
lines = ["第 1 阶段:环境检查完毕", "第 2 阶段:数据加载成功", "第 3 阶段:模型推演完成"]
document = "\n".join(lines)
print(document)
三、包含非字符串元素的列表怎么处理?
在使用 join() 方法时,最常见的运行时报错是 TypeError:
ids = [101, 102, 103]
result = ",".join(ids)
# 抛出异常:TypeError: sequence item 0: expected str instance, int found
join() 严格要求可迭代对象中的每一个元素都必须是 str 实例。若列表中含有整数、浮点数或布尔值,必须先将元素转换为字符串。常用的转换方式有两种:
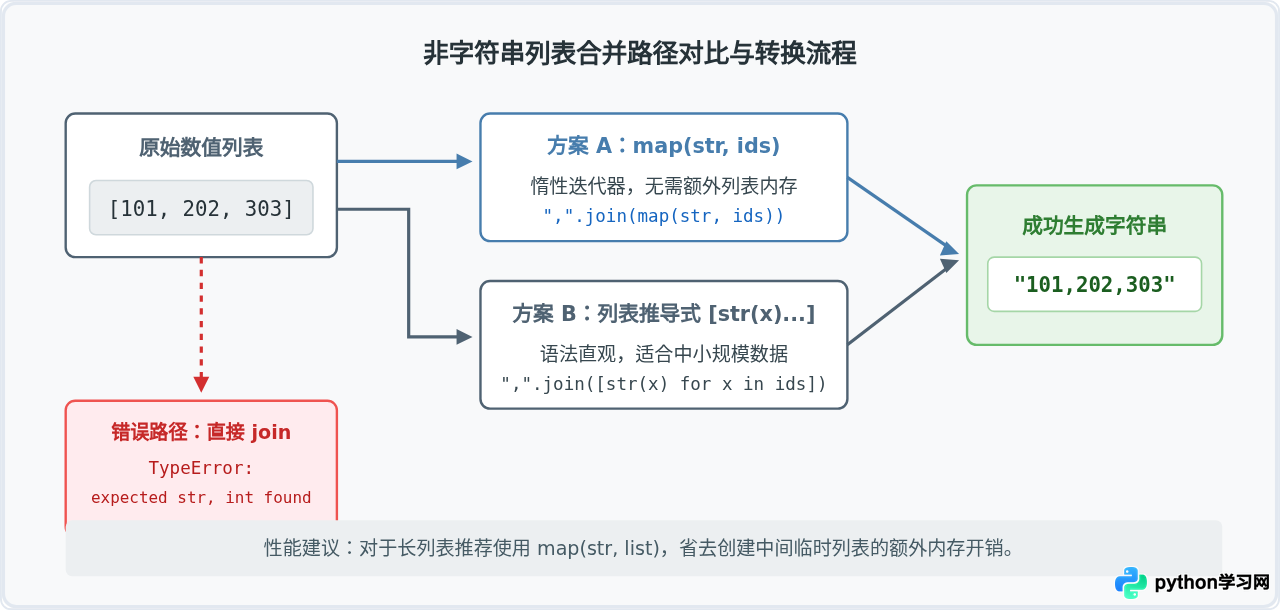
方式一:使用 map(str, iterable)(内存效率最高)
numbers = [1, 2, 3, 4, 5]
# map 返回一个迭代器,不会一次性生成整个中间列表
result = "-".join(map(str, numbers))
print(result)  # 输出结果:1-2-3-4-5
方式二:列表推导式或生成器表达式
values = [10.5, 20.8, 30.1]
# 生成器表达式写法:省内存
result_gen = ", ".join(f"{v:.1f}" for v in values)

# 列表推导式写法:执行速度略微偏快,但会分配中间列表
result_list = ", ".join([str(v) for v in values])
四、为什么 join 比用 += 循环拼接快得多?
在许多初学者编写的代码中,经常能看到如下的循环拼接实现:
# 低效写法:反模式
items = ["data"] * 100000
result = ""
for item in items:
    result += item  # 每次都会触发新对象的创建与内存拷贝
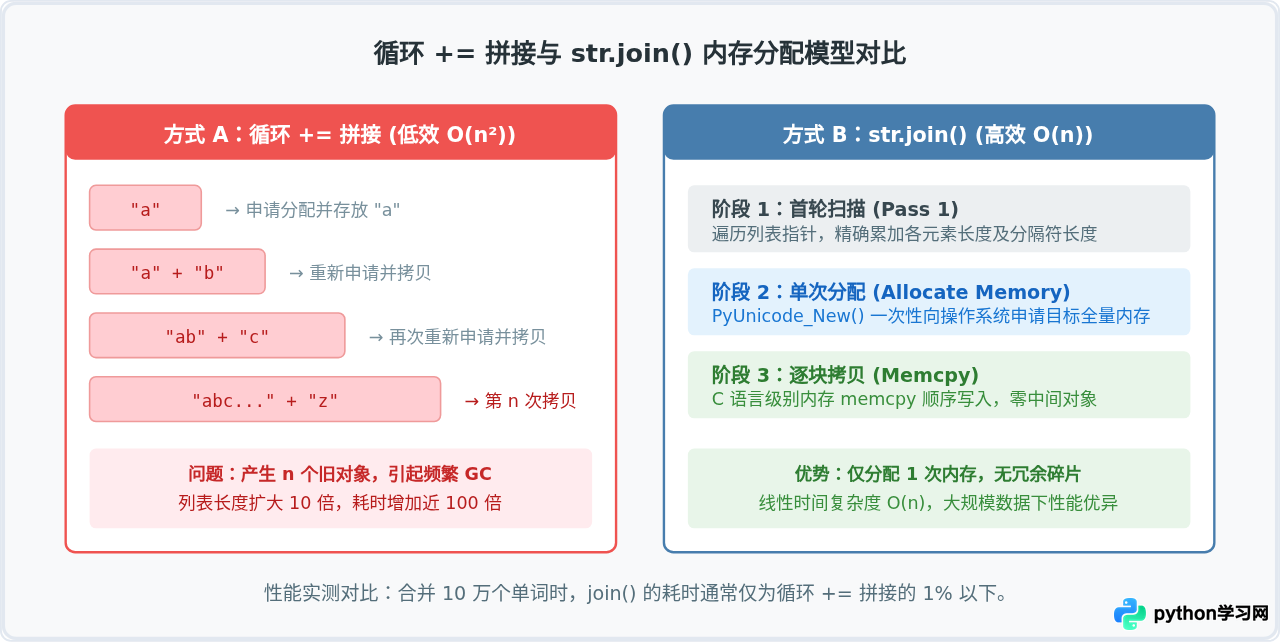
在 Python 中,字符串是不可变对象(Immutable Object)。这意味着一旦创建,其在内存中的内容就不能被修改。每次执行 result += item 时,Python 虚拟机都必须完成以下三步操作:
- 申请一块足以容纳
len(result) + len(item)的新内存空间; - 将原
result的全部数据拷贝到新内存中; - 将
item的内容追加到新内存末尾,并释放原有的旧字符串内存。
如果列表中有 \(n\) 个元素,这种逐次累加的总拷贝字符次数大致为:
总开销 \(\approx 1 + 2 + 3 + \dots + n = \frac{n(n + 1)}{2} = O(n^2)\)
当列表长度达到数万甚至数十万时,程序会产生剧烈的内存抖动与大量的垃圾回收(GC)负担。相比之下,join() 先扫描一次获取所有元素长度并进行单次分配,时间复杂度仅为严格的 \(O(n)\)。
五、开发中必须注意的细节与边界条件
1. 空列表与单元素列表的处理
join() 对边界输入非常友好:
- 空列表:
"-".join([])会安全返回空字符串"",不会抛出越界异常。 - 单元素列表:
"-".join(["Python"])会直接返回"Python",分隔符不会被添加在开头或结尾。
2. 包含 None 值的过滤
如果列表中可能混入 None,直接调用会触发 TypeError。可以使用条件生成器过滤掉空值:
raw_data = ["admin", None, "editor", None, "guest"]
# 过滤掉 None 后再合并
clean_str = ", ".join(item for item in raw_data if item is not None)
print(clean_str)  # 输出结果:admin, editor, guest
3. 超大型数据的流式合并与写入
如果需要合并的数据量达到数千万行(几百兆乃至数吉字节),将整个字符串完整拼合在内存中可能会导致内存占用过高(OOM)。在文件写入或网络传输场景中,优先使用文件的 writelines() 方法直接流式输出:
# 针对超大规模数据的推荐做法:流式写入文件
with open("output.log", "w", encoding="utf-8") as f:
    # 假设 generate_huge_lines() 是一个生成器
    for line in generate_huge_lines():
        f.write(line + "\n")
六、字符串拼接选型指南
在 Python 日常开发中,并非所有字符串拼接都必须使用 join()。合理选型能够兼顾代码可读性与执行性能:
| 拼接场景 | 推荐方法 | 代码示例 | 适用原因 |
|---|---|---|---|
| 少量固定字符串(2~4个) | f-string 格式化 | f"{first}_{second}" |
语法最简洁直观,在解释器层面有专用优化。 |
| 动态数量的字符串列表 | separator.join(list) |
"-".join(tags) |
单次内存分配,避免 \(O(n^2)\) 二次方增长。 |
| 非字符串类型的混合列表 | join 配合 map |
",".join(map(str, nums)) |
避免类型错误,惰性迭代降低额外内存消耗。 |
| 超大文件或日志批量输出 | 流式写入 writelines |
file.writelines(lines) |
直接走缓冲区刷入磁盘,避免超大对象常驻内存。 |
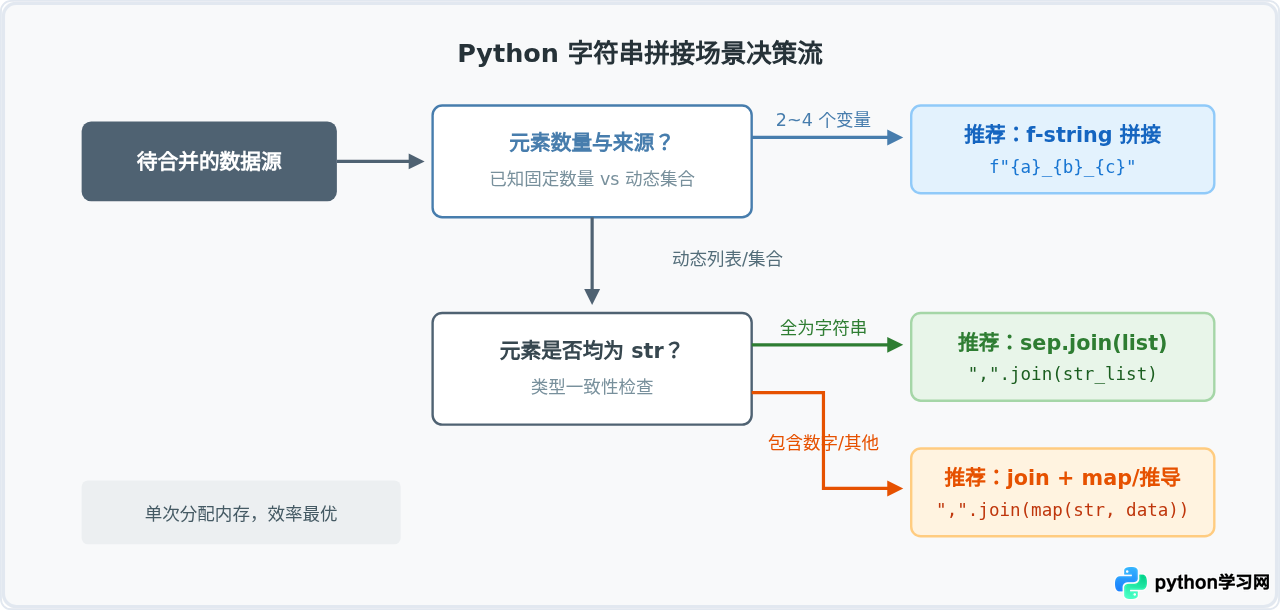
在 Python 中将列表合并为字符串,请始终优先选择 separator.join(list)。它的核心优势来自于 CPython 解释器的底层实现机制:预先计算长度、单次申请内存以及高效率连续内存拷贝,彻底避免了不可变对象反复创建销毁带来的时间与空间性能损耗。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









